

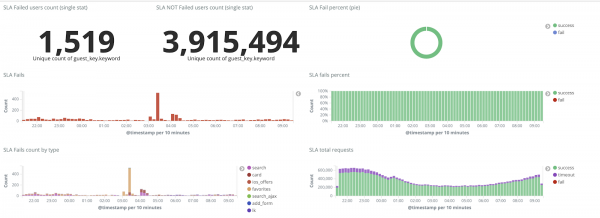
Hej alle sammen, mit navn er Alexander, jeg arbejder som ingeniør hos CIAN og beskæftiger mig med systemadministration og automatisering af infrastrukturprocesser. I kommentarfeltet til en af vores tidligere artikler blev vi bedt om at fortælle, hvor vi får 4 TB logfiler om dagen fra, og hvad vi gør med dem. Ja, vi har mange logfiler, og der er oprettet et separat infrastrukturcluster til deres behandling, hvilket gør det muligt for os at løse problemer hurtigt. I denne artikel vil jeg fortælle om, hvordan vi i løbet af et år har tilpasset det til at arbejde med en konstant voksende strøm af data.
Hvordan vi startede
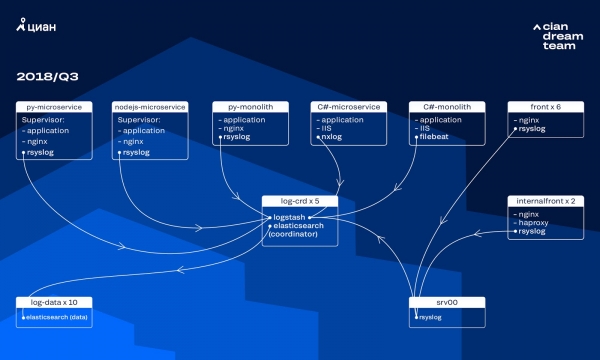
De sidste par år er belastningen på cian.ru steget meget hurtigt, og i tredje kvartal af 2018 nåede antallet af unikke brugere på siden op på 11,2 millioner om måneden. På det tidspunkt mistede vi op til 40 % af logfilerne i kritiske øjeblikke, hvilket gjorde, at vi ikke kunne håndtere hændelserne hurtigt og brugte meget tid og kræfter på at løse dem. Vi kunne også ofte ikke finde årsagen til problemerne, hvilket fik dem til at gentage sig efter et stykke tid. Det var et helvede, som vi måtte gøre noget ved.
På det tidspunkt brugte vi et cluster bestående af 10 datanoder med ElasticSearch version 5.5.2 med standardindstillinger for indekser. Det blev implementeret for mere end et år siden som en populær og tilgængelig løsning: dengang var strømmen af logfiler ikke så stor, så det gav ikke mening at finde på ikke-standard konfigurationer.
Behandlingen af de indkommende logfiler blev håndteret af Logstash på forskellige porte på fem ElasticSearch-koordinatorer. Én indeks, uanset størrelse, bestod af fem shards. Der var etableret time- og døgnrotation, hvilket resulterede i, at der hver time blev tilføjet cirka 100 nye shards til clusteren. Da antallet af logfiler ikke var alt for mange, klarede klusteret det, og ingen lagde mærke til dets indstillinger.
Problemer med hastig vækst
Mængden af genererede logfiler voksede meget hurtigt, da to processer overlapmede hinanden. På den ene side blev antallet af brugere af tjenesten større. På den anden side begyndte vi aktivt at skifte til en mikrotjenestearkitektur, hvilket involverede, at vi delte vores gamle monolitter op i C# og Python. Flere dusin nye mikrotjenester, der erstattede dele af monolitten, genererede betydeligt flere logfiler til infrastrukturclusteren.
Skalering var netop årsagen til, at klyngen blev næsten umulig at styre. Da loggene begyndte at komme ind med en hastighed på 20.000 meddelelser per sekund, øgede hyppig ubrugelig rotation antallet af shards til 6.000, og hver node havde mere end 600 shards.
Dette førte til problemer med tildelingen af RAM, og da en node fejlede, begyndte alle shards at flytte samtidig, hvilket fordoblede trafikken og belastede de andre noder, hvilket gjorde det næsten umuligt at skrive data til klyngen. I denne periode var vi også uden logs. Og ved problemet med serveren mistede vi 1/10 af klyngen generelt. Et stort antal små indeks gjorde det også mere kompliceret.
Uden logs forstod vi ikke årsagerne til hændelsen og kunne på et eller andet tidspunkt risikere at træde på de samme tæer igen, hvilket var helt uacceptabelt for vores teams ideologi, da alle vores arbejdsmechanismer er skræddersyet til det stik modsatte — aldrig at gentage de samme problemer. Derfor havde vi brug for et komplet sæt logs og deres levering næsten i realtid, da teamet av de vagthavende ingeniører overvågede alerter ikke kun fra metrics, men også fra logs. For at forstå omfanget af problemet - på det tidspunkt udgjorde det samlede logniveau cirka 2 TB om dagen.
Vi satte os for at helt undgå tab af logs og reducere leveringstiden til klyngen ELK til maksimum 15 minutter under nødsituationer (til dette tal refererede vi senere som vores interne KPI).
Ny mekanisme til rotation og hot-warm noder
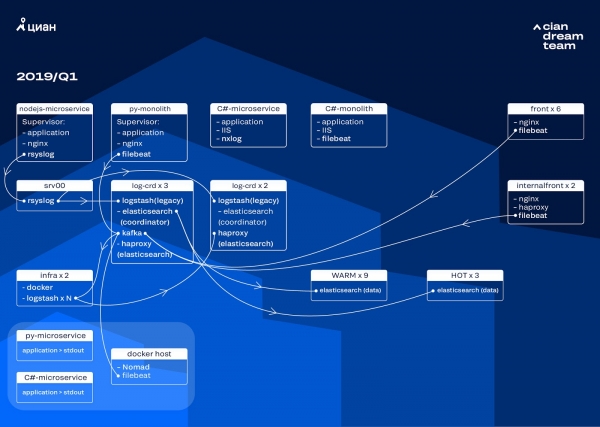
Vi begyndte transformationen af klyngen med at opdatere versionen af ElasticSearch fra 5.5.2 til 6.4.3. Vores klynge 5 versionen gik endnu en gang ned, og vi besluttede at lukke den ned og opdatere den helt - der var trods alt ingen logs. Så denne overgang tog vi kun et par timer.
Den mest omfattende ændring på dette stadium var implementeringen på tre noder med en koordinator som mellembuffer for Apache Kafka. Beskedbrokeren befriede os fra tab af logs under problemer med ElasticSearch. Samtidig tilføjede vi 2 noder til klyngen og skiftede til en hot-warm arkitektur med tre "varme" noder placeret i forskellige skuffer i datacenteret. Her videresendte vi logs, som ikke måtte gå tabt — nginx og også logs for applikationsfejl. De øvrige noder modtog mindre vigtige logs — debug, warning osv., og efter 24 timer blev "vigtige" logs flyttet fra de "varme" noder.
For ikke at øge antallet af små indekser gik vi fra tidsrotation til et rollover-mekanisme. Der var mange oplysninger på forum om, at rotationsmetoden baseret på størrelsen af indekset var meget usikker, så vi besluttede at bruge rotation baseret på antallet af dokumenter i indekset. Vi analyserede hvert indeks og optegnede antallet af dokumenter, hvor efter rotation skulle finde sted. På den måde opnåede vi en optimal shardstørrelse — ikke mere end 50 GB.
Klyngeoptimering
Men vi slap ikke helt for problemerne. Desværre optrådte der stadig små indekser: de nåede ikke den ønskede størrelse, blev ikke roteret og blev fjernet ved en global rengøring af indekser, der var ældre end tre dage, da vi fjernede rotationsmetoden baseret på dato. Dette førte til tab af data, fordi indexet forsvandt helt fra klyngen, og et forsøg på at skrive til et ikke-eksisterende indeks brød logikken i curator’en, som vi brugte til at styre. Alias til skrivning blev transformeret til indekset og brød rollover-logikken, hvilket skabte ukontrolleret vækst i nogle indekser op til 600 GB.
For eksempel for konfigurationen af rotation:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
I fraværet af rollover alias opstod der en fejl:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  <type 'exceptions.ValueError'>: Unable to perform index rollover with alias "nginx_write".
Vi efterlod løsning af dette problem til næste iteration og fokuserede på et andet spørgsmål: vi gik over til pull-logik for Logstash, som håndterer behandling af indgående logs (fjernelse af overflødig information og berigelse). Vi satte det i docker, som vi kører gennem docker-compose, hvor vi også placerede logstash-exporter, der sender metrikker til Prometheus for hurtig overvågning af logstrømmen. På den måde gav vi os selv mulighed for glat at ændre antallet af logstash-instanser, der håndterer hver type log.
Mens vi forbedrede klyngen, voksede besøget på cian.ru til 12,8 millioner unikke brugere om måneden. Som resultat stod vi over for, at vores transformationer lidt forsinkede sig i forhold til ændringerne i produktionen, og vi oplevede, at de "varme" noder ikke kunne håndtere belastningen og bremse hele leveringen af logs. De "kolde" data modtog vi uden problemer, men til leveringen af de andre måtte vi gribe ind og lave manuel rollover for jævnt at fordele indeksene.
Samtidig blev skalering og ændring af indstillingerne for logstash-instanserne i klyngen kompliceret af, at dette var en lokal docker-compose, og alle handlinger blev udført manuelt (for at tilføje nye endepunkter var det nødvendigt manuelt at gå igennem alle serverne og udføre docker-compose up -d overalt).
Genfordeling af logs
I september i år fortsatte vi stadig med at skære monolitten, belastningen på klyngen steg, og logstrømmen nærmede sig 30.000 beskeder i sekundet.
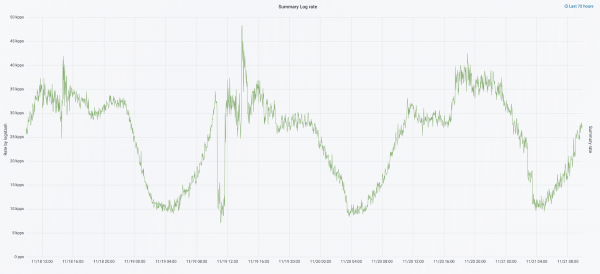
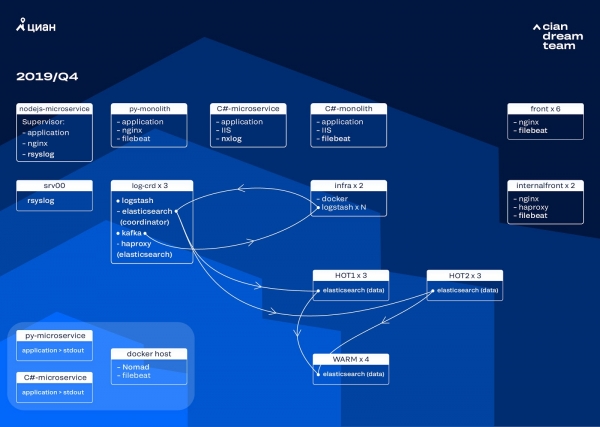
Vi begyndte den næste iteration med opgradering af hardwaren. Fra fem koordinatorer gik vi ned til tre, vi udskiftede datanoder og vandt både penge og lagerkapacitet. Til noderne bruger vi to konfigurationer:
- Til de "varme" noder: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 for Hot1 og 3 for Hot2).
- Til de "kolde" noder: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
På denne iteration udskilte vi indekset med access-logs fra mikrotjenesterne, som tager lige så meget plads som logs fra front-end nginx, til den anden gruppe af tre "varme" noder. Dataene på de "varme" noder opbevarer vi nu i 20 timer, hvorefter de bliver flyttet til de "kolde" sammen med de øvrige logs.
Vi har løst problemet med forsvinden af små indekser ved at justere deres rotation. Nu roteres indekserne i hvert fald hver 23. time, selv når der er lidt data. Dette har lidt øget antal shards (de er nu omkring 800), men med hensyn til klusterets ydeevne er det acceptabelt.
Som resultat har klustret nu seks "varme" og kun fire "kolde" noder. Dette medfører en lille forsinkelse i forespørgsler over længere tidsintervaller, men en stigning i antallet af noder i fremtiden vil løse dette problem.
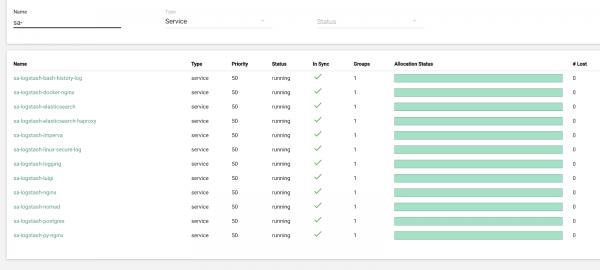
I denne iteration har vi også løst problemet med fraværet af semi-automatisk skalering. For dette har vi implementeret en infrastruktur Nomad-kluster – svarende til det, vi allerede har på produktionen. Indtil videre justeres antallet af Logstash-noder automatisk ikke i forhold til belastningen, men vi vil nå dertil.
Fremtidige planer
Den implementerede konfiguration skalerer fremragende, og vi opbevarer nu 13,3 TB data – alle logs fra de seneste 4 dage, hvilket er nødvendigt for hurtig behandling af alarmer. En del logs omdanner vi til metrikker, som vi opbevarer i Graphite. For at lette arbejdet for ingeniørerne har vi metrikker for infrastrukturklusteret og scripts til semi-automatisk reparation af typiske problemer. Efter stigningen i antallet af datanoder, som er planlagt til næste år, vil vi gå fra at opbevare data i 4 dage til 7 dage. Dette vil være tilstrækkeligt til operationelt arbejde, da vi altid prøver at undersøge hændelser så hurtigt som muligt, og til langsigtede undersøgelser er der telemetridata.
I oktober 2019 voksede besøgstallet på cian.ru allerede til 15,3 millioner unikke brugere om måneden. Dette blev en alvorlig test af den arkitektoniske løsning til levering af logs.
Vi forbereder os nu på at opgradere ElasticSearch til version 7. Faktisk skal mange af indekserne i ElasticSearch opdateres, da de er kommet fra version 5.5 og er blevet erklæret som deprecated i version 6 (i version 7 findes de ikke længere). Dette betyder, at der i opdateringsprocessen helt sikkert vil opstå et eller andet problem, der midlertidigt vil efterlade os uden logs. Fra version 7 ser vi især frem til Kibana med et forbedret grænseflade og nye filtre.
Vi nåede vores hovedmål: vi holder op med at miste logs og har reduceret nedetid i vores infrastrukturkluster fra 2-3 nedbrud om ugen til et par timer med vedligeholdelse om måneden. Alt dette arbejde i produktionen er næsten usynligt. Men nu kan vi præcist bestemme, hvad der sker med vores service, vi kan hurtigt gøre det i roligt tempo og bekymre os mindre for, at logs går tabt. Generelt er vi tilfredse, glade og forbereder os på nye bedrifter, som vi vil fortælle om senere.
Kilde: habr.com
