

Vi elsker alle historier. Vi kan godt lide at sidde rundt om bålet og fortælle om vores tidligere sejre, kampe eller blot om vores erfaringer.
I dag er netop en sådan dag. Og selvom du måske ikke sidder ved bålet lige nu, har vi en historie til dig. En historie om, hvordan vi begyndte at arbejde med lagring på Tarantool.
Engang i vores virksomhed havde vi et par 'monolitter' og et fælles 'loft', som disse monolitter langsomt men sikkert nærmede sig, hvilket begrænsede vores virksomheds vækst. Der var en klar forståelse: En dag ville vi hårdt ramme dette loft.
Nu hersker ideologien om at opdele alt og enhver, fra udstyr til forretningslogik. Som et resultat har vi for eksempel to datacentre, der er stort set uafhængige på netværksniveau. Men dengang var alt helt anderledes.
I dag findes der en masse værktøjer og midler til at foretage ændringer i form af CI/CD, K8S osv. I den 'monolitiske' tid havde vi ikke behov for så mange fremmedord. Det var nok blot at rette op på 'lagringen' i databasen.
Men tiden gik fremad, og antallet af forespørgsler steg tilsvarende, hvilket medførte RPS, der til tider oversteg vores kapaciteter. Da vi gik ind på markedet i CIS-landene, faldt belastningen på databasen i den første monolit aldrig under 90 %, og RPS lå på omkring 2400. Og det var ikke blot små forespørgsler, men store forespørgsler med masser af kontroller og JOINs, der kunne løbe næsten igennem halvdelen af dataene på baggrund af høj IO.
Da der begyndte at komme rigtige udsalg på 'Black Friday' — og Wildberries var en af de første til at afholde dem i Rusland — blev situationen meget dyster. For belastningen på sådanne dage stiger tredobbelt.
Åh, disse 'monolitiske tider'! Jeg er sikker på, at du også har været ude for noget lignende og stadig ikke forstår, hvordan noget sådan kunne ske for dig.
Hvad kan man sige — mode er også en del af teknologierne. For cirka fem år siden måtte vi genoverveje en af disse modefænomener i form af en eksisterende hjemmeside på .NET og MS SQL-server, der nænsomt opbevarede al logikken bag hjemmesiden. Den opbevarede det så nænsomt, at det viste sig at være en langvarig og besværlig fornøjelse at nedbryde en sådan monolit.
Et lille sidespring.
Til forskellige typer begivenheder siger jeg: «hvis I ikke har skåret i monolitten, så er I ikke vokset!» Jeg er interesseret i din mening om dette, så skriv venligst din kommentar.
Og torden bragede
Lad os vende tilbage til vores «bål». For at fordele belastningen af den «monolitiske» funktionalitet besluttede vi at opdele systemet i mikrotjenester baseret på opensource-teknologier. Fordi, i det mindste, så er deres skalerbarhed billigere. Vi havde helt sikkert forståelse for, at vi skulle skalere (og meget) allerede på det tidspunkt. For på det tidspunkt var vi allerede trådt ind på nabomarkederne, og antallet af registreringer, såvel som antallet af ordrer, begyndte at stige endnu mere.
Efter at have analyseret de første kandidater til at forlade monolitten for mikrotjenester, indså vi, at i 80 % af tilfældene kom optagelsen i dem 99 % fra back office-systemer, mens læsningen kom fra frontlinjen. Dette gjaldt især for et par vigtige subsystemer for os — brugerdata og systemet til beregning af den endelige pris på varer baseret på information om kundespecifikke rabatter og kuponer.
Som en bemærkning. Det er skræmmende at forestille sig i dag, men udover de ovennævnte subsystemer blev også produktkataloger, brugerens indkøbsvogn, søgesystemet for produkter, systemet til filtrering af produktkataloger og forskellige anbefalingssystemer fjernet fra vores monolit. For hver enkelt af dem findes der separate klasser af snævert specialiserede systemer, men engang boede de alle i én “hytte”.
Vi planlagde straks at flytte oplysninger om vores kunder til et sharderet system. Men flytningen af funktionaliteten til at beregne den endelige pris på varer krævede en god skalerbarhed i læsning, da det udgjorde den største belastning i RPS og var den mest komplekse at udføre for databasen (der er involveret meget data i beregningsprocessen).
Som et resultat af dette fik vi en skema, der passer godt sammen med Tarantool.
På det tidspunkt blev der valgt driftskemaer for mikrotjenester med flere datacentre på virtuelle og fysiske maskiner. Som vist på billederne blev der anvendt replikeringsvarianter af Tarantool både i master-master- og master-slave-tilstand.
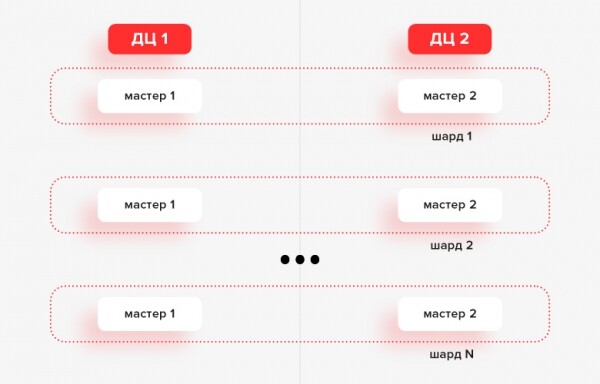
Arkitektur. Variant 1. Brugerens tjeneste
I øjeblikket er der 24 sharder, hver med 2 instanser (en i hvert datacenter), alle i master-master-tilstand.
Over the database are applications that access the database replicas. The applications work with Tarantool through our custom library, which implements the Go driver interface for Tarantool. It sees all replicas and can work with the master for reading and writing. Essentially, it implements a replica set model, into which logic for replica selection, retries, a circuit breaker, and rate limiting has been added.
At the same time, it is possible to configure the replica selection policy per shard. For example, using round-robin.
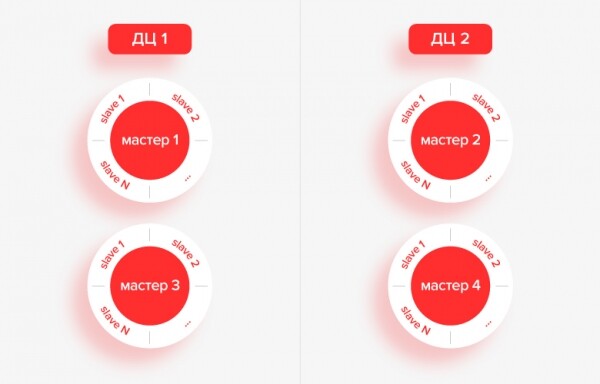
Architecture. Option 2. Service for calculating the final cost of goods.
Several months ago, most requests for calculating the final cost of goods moved to a new service that essentially operates without databases, but some time ago 100% of the requests were handled by a service with Tarantool under the hood.
The service database consists of 4 masters, to which the synchronizer aggregates data, and each of these masters distributes data to read-only replicas through replication. Each master has about 15 such replicas.
In both the first and second schemes, if one data center is unavailable, the application can still retrieve data from the second.
It is worth noting that in Tarantool replication is quite flexible and can be configured at runtime. In other systems, challenges have arisen. For example, changing the parameters max_wal_senders and max_replication_slots in PostgreSQL requires restarting the master, which in some cases can lead to a disruption of connections between the application and the DBMS.
Seek, and you shall find!
Why didn't we do it 'like normal people' and choose a typical approach? It depends on what you consider normal. Many actually make a cluster out of Mongo and spread it across three geo-distributed data centers.
At that time, we already had two projects on Redis. The first was a cache, and the second was a persistent storage for not overly critical data. We had quite a difficult time with it, partly due to our own mistakes. Sometimes quite large volumes were stored in a key, and every now and then the site faced issues. We used this system in a master-slave configuration, and there were many cases when something happened with the master and replication broke.
Det vil sige, at Redis er godt til stateless-opgaver, men ikke til stateful. I princippet løste det de fleste opgaver, men kun hvis de var key-value-løsninger med et par indekser. Men med Redis var der på det tidspunkt ret store problemer med persistens og replikation. Desuden var der klager over ydeevnen.
Vi overvejede MySQL og PostgreSQL. Men den første fik ikke rigtig fat hos os, mens den anden er et ret avanceret produkt, og det ville være uforsvarligt at bygge simple tjenester på det.
Vi prøvede RIAK, Cassandra, endda en grafdatabase. Alt dette er ret nicheløsninger, der ikke kunne fungere som et generelt værktøj til at skabe tjenester.
I sidste ende landede vi på Tarantool.
Vi henvendte os til det, da det var i version 1.6. Vi blev interesseret i symbiosen mellem key-value og funktionaliteten af en relationel database. Der er sekundære indekser, transaktioner og spaces, som er som tabeller, men ikke simple; man kan gemme forskellige antal kolonner i dem. Men Tarantools killer-feature var de sekundære indekser i kombination med key-value og transaktionalitet.
Det spillede også en rolle, at det responsiv russisktalende fællesskab var villig til at hjælpe i chatten. Vi brugte dette aktivt og levede nærmest i chatten. Man skal heller ikke glemme den anstændige persistens uden åbenlyse fejl og problemer. Ser man på vores historie med Tarantool, havde vi mange smertepunkter og fejlsituationer med replikation, men vi har aldrig mistet data på grund af det!
Implementeringen begyndte svært.
På det tidspunkt var vores primære udviklingsstack .NET, som ikke havde en connector til Tarantool. Vi begyndte straks at udvikle noget på Go. Lua fungerede også ret godt. Det største problem på det tidspunkt var debugging: i .NET var det fantastisk, men derefter at dykke ned i en verden af embedded Lua, hvor man ikke har andet end logs til debugging, var vanskeligt. Desuden brød replikationen pludselig sammen fra tid til anden, og vi måtte fordybe os i strukturen af Tarantool-motoren. Chatten hjalp meget, i mindre grad dokumentationen, og nogle gange kiggede vi på koden. På det tidspunkt var dokumentationen ikke særlig god.
I løbet af flere måneder er det lykkedes at få erfaring og opnå gode resultater med Tarantool. Vi har dokumenteret standardpraksisser i Git, som har hjulpet med at etablere nye mikrotjenester. For eksempel, når opgaven var at lave en ny mikrotjeneste, kiggede udvikleren på koden fra den standardløsning, der lå i repositoriet, og det tog ikke mere end en uge at oprette en ny.
Det var specielle tider. Man kunne i øvrigt gå hen til administratoren ved det nærliggende bord og sige: "Giv mig en virtuel maskine". Om tredive minutter havde du allerede maskinen. Du selv tilsluttede dig, installerede alt, og der blev sat trafik på den.
I dag kan det ikke lade sig gøre: man skal oprette overvågning på tjenesten, loggføring, dække funktionaliteten med tests, bestille en virtuel maskine eller en opsætning i Kubernetes osv. Generelt set er det bedre, selvom det er længere og mere besværligt.
Del og hersk. Hvordan står det til med Lua?
Der var et stort dilemma: nogle teams kunne ikke pålideligt implementere ændringer i tjenesten med en stor mængde logik skrevet i Lua. Ofte førte det til, at tjenesten ikke fungerede.
Det vil sige, at udviklerne forbereder en ændring. Tarantool begynder at udføre migreringen, mens replikatet stadig kører med den gamle kode; der kommer en form for DDL gennem replikationen, noget andet, og koden bryder simpelthen sammen, fordi det ikke er taget i betragtning. Som følge heraf var opdateringsproceduren for administratorerne beskrevet på et A4-ark: stoppe replikationen, opdatere dette, genstarte replikationen, deaktivere her, opdatere der. Et mareridt!
Som resultat prøver vi i dag ofte ikke at gøre noget i Lua. Bare ved hjælp af iproto (det binære protokol til kommunikation med serveren), og that's it. Måske er det en mangel på viden hos udviklerne, men fra den synsvinkel er systemet komplekst.
Vi følger ikke altid blindt dette scenarie. I dag har vi ikke sort og hvidt: enten alt på Lua eller alt på Go. Vi forstår allerede, hvordan vi kan kombinere, så vi ikke senere får problemer med migreringen.
Hvor er Tarantool nu?
Tarantool bruges i tjenesten til beregning af den endelige pris på varer under hensyntagen til rabatkuponer, også kaldet «Promotajzer». Som nævnt tidligere, trækker det sig tilbage: det bliver erstattet af en ny katalogtjeneste med forudberegnede priser, men for et halvt år siden blev alle beregninger foretaget i «Promotajzer». Tidligere var halvdelen af dens logik skrevet i Lua. For to år siden blev tjenesten omdannet til et lager, og logikken blev genisoleret i Go, fordi rabatmekanikken blev lidt ændret, og tjenesten manglede ydeevne.
En af de mest kritiske tjenester er brugerprofilen. Det vil sige, at alle brugere af Wildberries gemmes i Tarantool, og der er omkring 50 millioner. Systemet er shardet efter bruger-ID og spredt over flere datacentre med integration i Go-tjenester.
Tidligere var «Promotajzer» førende inden for RPS, og nåede op til 6000 forespørgsler. På et tidspunkt havde vi 50-60 instanser. Nu er liderne i RPS - brugerprofilerne, ca. 12 tusinde. Denne tjeneste anvender brugerdefineret sharding med opdeling efter bruger-ID-intervaller. Tjenesten betjener mere end 20 maskiner, men det er for meget; vi planlægger at reducere de tildelte ressourcer, fordi 4-5 maskiner er tilstrækkeligt.
Sessiontjenesten er vores første tjeneste på vshard og Cartridge. Opsætningen af vshard og opdateringen af Cartridge krævede en del af vores arbejdstid, men i sidste ende lykkedes det.
Tjenesten til visning af forskellige bannere på hjemmesiden og i mobilapplikationen var en af de første, der blev lanceret på Tarantool. Denne tjeneste er bemærkelsesværdig, da den er ca. 6-7 år gammel, den fungerer stadig, og den har aldrig været genstartet. Master-master replikation blev anvendt. Der har aldrig været nogen problemer.
Der er et eksempel på brugen af Tarantool til funktionen af hurtige optegnelser i lagersystemet for at hurtigt verificere information i nogle tilfælde. Vi forsøgte at bruge Redis til dette formål, men dataene i hukommelsen optog mere plads end i Tarantool.
Tjenesterne til ventelister, klientabonnementer, de nu populære historier og forsinkede varer fungerer også med Tarantool. Den sidste service optager cirka 120 GB i hukommelsen. Det er den største tjeneste blandt de nævnte.
Konklusion
Takket være sekundære indekser i kombination med key-value og transaktionalitet er Tarantool særdeles velegnet til mikrotjenestearkitekturer. Vi stod imidlertid over for vanskeligheder, da vi implementerede ændringer i tjenester med meget logik i Lua – tjenesterne stoppede ofte med at fungere. Vi kunne ikke løse dette, og i takt med tiden er vi endt med forskellige kombinationer af Lua og Go: vi ved, hvornår det er bedst at bruge det ene sprog og hvornår det er bedst at bruge det andet.
Andre artikler om emnet
- Vi udvikler en højtydende applikation på Tarantool fra bunden
- Et pålideligt valg af leder i Tarantool Cartridge
- Telegram-kanal for Tarantool med nyheder om produktet
- Diskuter Tarantool i fællesskabs-chattet
Kilde: habr.com
