

Jeg kender mange Data Scientists - og jeg kan vel også selv tælle mig blandt dem - som arbejder på maskiner med GPU, lokale eller virtuelle, placeret i skyen, enten gennem Jupyter Notebook eller gennem en eller anden Python-udviklingsmiljø. I løbet af mine 2 år som AI/ML udvikler arbejdede jeg på denne måde, mens jeg forberedte data på en almindelig server eller arbejdsstation, og kørte træningen på en virtuel maskine med GPU i Azure.
Selvfølgelig har vi alle hørt om — en speciel cloud-platform til maskinlæring. Men efter blot et blik på , får man indtryk af, at Azure ML vil skabe flere problemer for dig, end det vil løse. For eksempel, i det nævnte træningseksempel, starter træningen på Azure ML fra Jupyter Notebook, og selve træningsscriptet foreslås at blive oprettet og redigeret som en tekstfil i en af cellerne — uden at bruge autocompletion, syntax-highlighting og andre fordele ved et ordentligt udviklingsmiljø. Af denne grund har vi længe været tøvende med at bruge Azure ML seriøst i vores arbejde.
Men for nylig fandt jeg en måde at begynde at bruge Azure ML effektivt i mit arbejde! Interesseret i detaljerne?
Den vigtigste hemmelighed er . Den gør det muligt for dig at udvikle træningsscripts direkte i VS Code, mens du bruger alle fordelene ved miljøet — samtidig kan du endda køre scriptet lokalt og derefter blot tage og sende det til træning i Azure ML-klusteret med et par museklik. Praktisk, ikke?
Med det får du følgende fordele ved at bruge Azure ML:
- Du kan arbejde det meste af tiden lokalt på din maskine i et behageligt IDE, og bruge GPU kun til at træne modellen. Samtidig kan puljen af træningsressourcer automatisk tilpasse sig den krævede belastning, og ved at sætte det minimale antal noder til 0 kan du automatisk starte en virtuel maskine "on-demand", når der er træningsopgaver.
- Du kan opbevare alle træningsresultater på ét sted, inklusive opnåede metrikker og opnåede modeller — der er ingen grund til at finde på et eller andet system eller rækkefølge til at opbevare alle resultaterne.
- I dette tilfælde flere personer kan arbejde på et projekt — de kan bruge den samme computerklynge, og alle eksperimenter vil blive sat i kø, og de kan også se hinandens eksperimentresultater. Et sådant scenarie er brug af Azure ML i undervisningen af Deep Learning, når du i stedet for at give hver studerende en virtuel maskine med GPU kan oprette en klynge, som skal bruges centralt af alle. Derudover kan en fælles resultattabel med nøjagtigheden af modellen fungere som et godt konkurrenceelement.
- Med Azure ML kan du nemt gennemføre en række eksperimenter, f.eks. til optimering af hyperparametre — det kan gøres med et par linjer kode, hvilket eliminerer behovet for at køre serier af eksperimenter manuelt.
Jeg håber, jeg har overbevist dig om at prøve Azure ML! Her er, hvordan du kan komme i gang:
- Sørg for, at du har installeret , samt udvidelserne og
- Clone the repository — den indeholder noget demonstrationskode til træning af en model til genkendelse af håndskrevne cifre på MNIST-datasættet.
- Åbn det klonede repository i Visual Studio Code.
- Læs videre!
Azure ML Workspace og Azure ML Portal
Azure ML er organiseret omkring konceptet arbejdsområder — Workspace. I arbejdsområdet kan data opbevares, eksperimenter sendes til træning, og resultaterne af træningen — de opnåede metrikker og modeller — gemmes. Du kan se, hvad der er inde i arbejdsområdet gennem — og derfra kan du udføre mange operationer, fra at uploade data til at overvåge eksperimenter og implementere modeller.
Du kan oprette et arbejdsområde via webgrænsefladen (se ), eller ved at bruge Azure CLI-kommandolinjen ():
az extension add -n azure-cli-ml
az group create -n myazml -l northeurope
az ml workspace create -w myworkspace -g myazml
Der er også nogle beregningsressourcer (Compute). Når du har oprettet et script til at træne modellen, kan du sende eksperimentet til udførelse i arbejdsområdet og angive compute target — scriptet vil blive pakket, kørt i det ønskede beregningsmiljø, og så vil alle eksperimentresultater blive gemt i arbejdsområdet til videre analyse og brug.
Træningsscript til MNIST
Lad os se på en klassisk opgave med brug af MNIST-datasættet. Tilsvarende vil du senere kunne køre dine egne træningsscripts.
I vores repository er der et script train_local.py, der træner en simpel model for lineær regression ved hjælp af SkLearn-biblioteket. Selvfølgelig forstår jeg, at dette ikke er den bedste måde at løse opgaven på — vi bruger det som et eksempel, da det er det enkleste.
Scriptet downloader først MNIST-data fra OpenML og bruger dernæst klassen LogisticRegression til at træne modellen, og derefter printer det den opnåede nøjagtighed:
mnist = fetch_openml('mnist_784')
mnist['target'] = np.array([int(x) for x in mnist['target']])

shuffle_index = np.random.permutation(len(mnist['data']))
X, y = mnist['data'][shuffle_index], mnist['target'][shuffle_index]

X_train, X_test, y_train, y_test =
  train_test_split(X, y, test_size = 0.3, random_state = 42)

lr = LogisticRegression()
lr.fit(X_train, y_train)
y_hat = lr.predict(X_test)
acc = np.average(np.int32(y_hat == y_test))

print('Overall accuracy:', acc)
Du kan køre scriptet på din egen computer og få resultater inden for et par sekunder.
Kører scriptet i Azure ML
Hvis vi kører scriptet til træning gennem Azure ML, har vi to hovedfordele:
- Kørsel af træning på vilkårlige beregningsressourcer, som normalt er mere kraftfulde end den lokale computer. Azure ML sørger for at pakke vores script med alle filer fra den aktuelle mappe i en docker-container, installere de nødvendige afhængigheder og sende det til udførelse.
- Optagelse af resultater i et fælles register inden for Azure ML-arbejdsområdet. For at udnytte denne mulighed skal vi tilføje et par linjer kode til vores script til at registrere den resulterende nøjagtighed:
from azureml.core.run import Run
...
try:
    run = Run.get_submitted_run()
    run.log('accuracy', acc)
except:
    pass
Den relevante version af scriptet kaldes train_universal.py (den er lidt mere kompleks end beskrevet ovenfor, men ikke meget). Dette script kan køres både lokalt og på en fjernberegningsressource.
For at køre det i Azure ML fra VS Code skal du gøre følgende:
Sørg for, at Azure-udvidelsen er tilsluttet dit abonnement. Vælg Azure-ikonen i venstre menu. Hvis du ikke er tilsluttet, vises der en meddelelse i nederste højre hjørne (), ved at klikke på den kan du logge ind via browseren. Du kan også trykke på Ctrl-Shift-P for at åbne kommandopanelet i VS Code og skrive Azure Sign In.
Derefter, i Azure-sektionen (ikonen til venstre), skal du finde sektionen MASKINLÆRING:
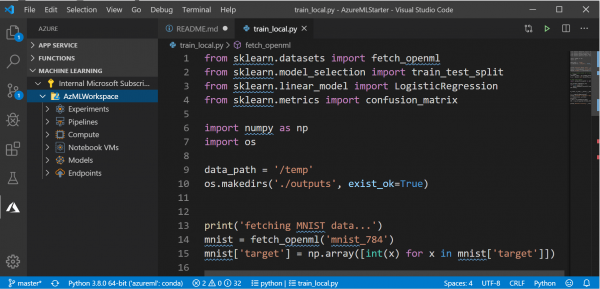
Her skal du se forskellige grupper af objekter inde i arbejdsområdet: computerressourcer, eksperimenter osv.
- Gå til filoversigten, højreklik på scriptet
train_universal.pyog vælg Azure ML: Kør som eksperiment i Azure.
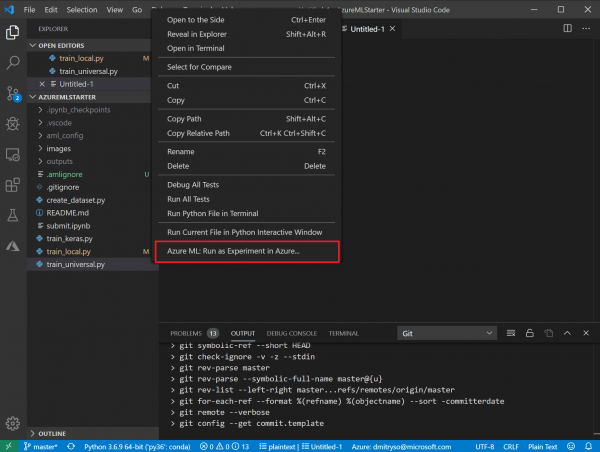
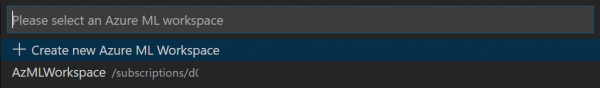
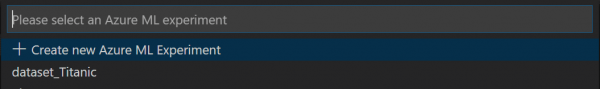
- Derefter følger en række dialoger i VS Code's kommandolinje: bekræft den anvendte abonnement og arbejdsområde i Azure ML, samt vælg Opret nyt eksperiment:
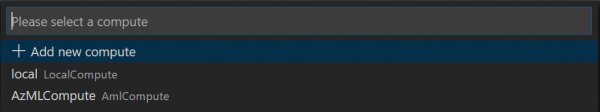
Vælg at oprette en ny computerressource Opret ny compute:
- Compute definerer den computerressource, hvor læringen vil finde sted. Du kan vælge en lokal computer eller en AmlCompute cloud-klynge. Jeg anbefaler at oprette en skalerbar maskinklynge
STANDARD_DS3_v2, med et minimum antal maskiner på 0 (og maksimalt kan være 1 eller flere, afhængigt af dine behov). Dette kan gøres via VS Code-interface, eller på forhånd via .

- Compute definerer den computerressource, hvor læringen vil finde sted. Du kan vælge en lokal computer eller en AmlCompute cloud-klynge. Jeg anbefaler at oprette en skalerbar maskinklynge
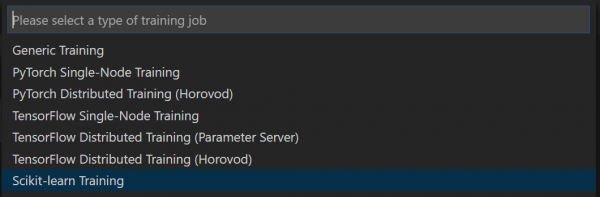
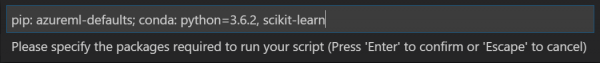
Derefter skal du vælge konfigurationen Compute-konfiguration, som definerer parametrene for den container, der skal oprettes til læringen, især alle nødvendige biblioteker. I vores tilfælde, da vi bruger Scikit Learn, vælger vi SkLearn, og så bekræfter vi blot den foreslåede liste over biblioteker med et tryk på Enter. Hvis du bruger yderligere biblioteker, skal de angives her.


Derefter åbnes et vindue med en JSON-fil, der beskriver eksperimentet. Her kan nogle parametre rettes - for eksempel eksperimentets navn. Tryk derefter på linket Indsend eksperiment direkte inde i denne fil:
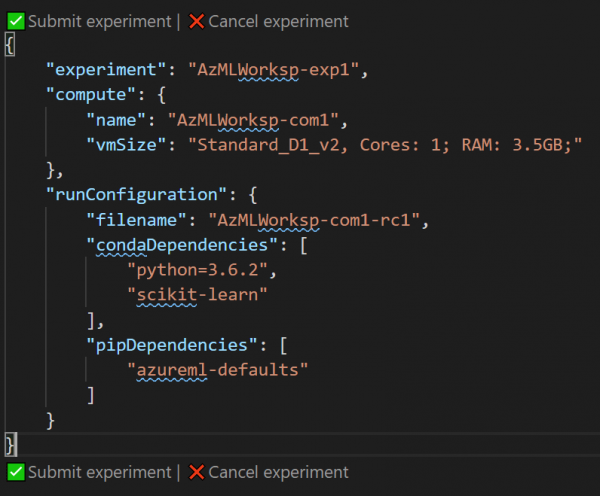
- Efter en vellykket indsendelse af eksperimentet via VS Code, vil du se et link til , hvor du kan spore status og resultaterne af eksperimentet.
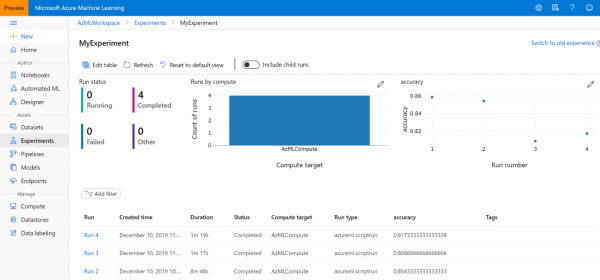
Fremover kan du altid finde det under Eksperimenter , eller i sektionen Azure Machine Learning i listen over eksperimenter:
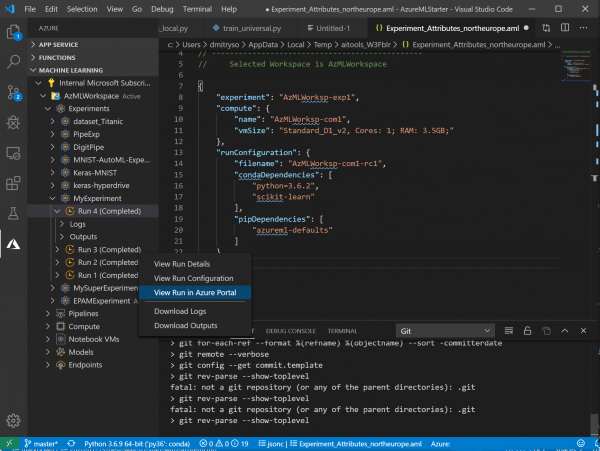
- Hvis du har foretaget nogle rettelser i koden eller ændret parametrene - vil genstart af eksperimentet være meget hurtigere og lettere. Ved at højreklikke på filen vil du se et nyt menupunkt Gentag seneste kørsel — vælg det blot, og eksperimentet vil straks blive startet:
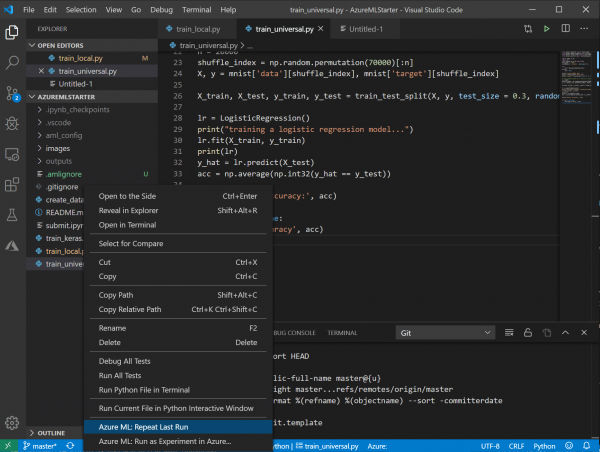
Resultaterne af metrics fra alle kørseler kan du altid finde på Azure ML Portal, der er ikke behov for at notere dem.
Nu ved du, at det er nemt og smertefrit at køre eksperimenter med Azure ML, og samtidig får du en række interessante fordele.
Men du har muligvis bemærket nogle ulemper. For eksempel krævede det betydeligt længere tid at starte scriptet. Selvfølgelig tager det tid at pakke scriptet i en container og implementere det på serveren. Hvis klyngen samtidig er skåret ned til 0 noder, kræver det endnu mere tid at starte den virtuelle maskine, og alt dette er meget mærkbart, når vi eksperimenterer med enkle opgaver som MNIST, som kan løses på få sekunder. Men i det virkelige liv, hvor træningen varer flere timer, dage eller endda uger, bliver denne ekstra tid ubetydelig, især i forhold til den betydeligt højere ydeevne, som en beregningsklynge kan levere.
Hvad nu?
Jeg håber, at du efter at have læst denne artikel vil kunne og vil bruge Azure ML i dit arbejde til at køre scripts, styre beregningsressourcer og centralt opbevare resultater. Men Azure ML kan give dig endnu flere fordele!
Inden for arbejdsområdet kan der opbevares data, hvilket skaber et centralt lager for alle dine opgaver, som er let at tilgå. Derudover kan du køre eksperimenter ikke kun fra Visual Studio Code, men også ved hjælp af API'en — dette kan være særligt nyttigt, hvis du skal optimere hyperparametre og skal køre scriptet mange gange med forskellige parametre. Desuden har Azure ML indbygget en særlig teknologi. , som giver mulighed for en mere raffineret søgning og optimering af hyperparametre. Jeg vil fortælle om disse muligheder i min næste note.
Nyttige ressourcer
Til en mere detaljeret udforskning af Azure ML kan følgende kurser fra Microsoft Learn være nyttige:
Kilde: habr.com
