

Bem. overs.: Vi præsenterer her de tekniske detaljer om årsagerne til den seneste nedetid i det cloud-baserede service leveret af skaberne af Grafana. Dette er et klassisk eksempel på, hvordan en ny og tilsyneladende nyttig funktion, der er designet til at forbedre kvaliteten af infrastrukturen... kan skade, hvis man ikke tager højde for de mange nuancer ved dens anvendelse i realiteterne i produktion. Det er fantastisk, når sådanne materialer dukker op, hvor man kan lære ikke kun af sine egne fejl. Flere detaljer findes i oversættelsen af denne tekst fra vicepræsidenten for produktet hos Grafana Labs.
Fredag den 19. juli stoppede Hosted Prometheus servicen i Grafana Cloud med at fungere i omtrent 30 minutter. Jeg beklager over for alle kunder, der blev ramt af nedbruddet. Vores opgave er at levere de nødvendige værktøjer til overvågning, og vi forstår, at deres utilgængelighed gør dit liv sværere. Vi tager denne hændelse meget alvorligt. I denne note forklares, hvad der skete, hvordan vi reagerede og hvad vi gør for at sikre, at det ikke sker igen.
Background
Grafana Cloud Hosted Prometheus servicen er baseret på — et CNCF projekt til at skabe en horisontalt skalerbar, højt tilgængelig, multi-tenant Prometheus service. Cortex-arkitekturen består af et sæt separate mikrotjenester, hvor hver udfører sin funktion: replikering, opbevaring, forespørgsler osv. Cortex udvikles aktivt, og nye funktioner tilføjes konstant, hvilket forbedrer ydeevnen. Vi deployerer regelmæssigt nye versioner af Cortex i klyngerne, så kunderne kan drage fordel af disse muligheder — heldigvis kan Cortex opdateres uden nedetid.
For nedetidfrie opdateringer kræver Cortex’ Ingester service en ekstra Ingester replikat i opdateringsprocessen. (Bem. overs.: — den grundlæggende komponent i Cortex. Dens opgave er at samle en konstant strøm af samples, gruppere dem i chunk’ere i Prometheus og gemme dem i databaser som DynamoDB, BigTable eller Cassandra. Dette giver gamle Ingester mulighed for at sende aktuelle data til nye Ingester. Det er værd at bemærke, at Ingester kræver mange ressourcer. Der kræves 4 kerner og 15 GB hukommelse pr. pod, dvs. 25 % processorstyrke og hukommelse fra den grundlæggende maskine i vores Kubernetes-klynger. Generelt har vi normalt langt flere ubrugte ressourcer i klyngen end 4 kerner og 15 GB hukommelse, så vi kan nemt køre disse ekstra Ingester under opdateringer.
Men ofte er der under normal drift ikke disse 25 % ubrugte ressourcer på nogen af maskinerne. Ja, og vi stræber ikke efter det: CPU og hukommelse er altid nyttige til andre processer. For at løse dette problem besluttede vi at benytte os af . Ideen er at give Ingester højere prioritet end andre (stateless) mikrotjenester. Når vi har brug for at starte en ekstra (N+1) Ingester, skubber vi midlertidigt andre, mindre pods til side. Disse pods overføres til frie ressourcer på andre maskiner, hvilket efterlader et stort "hul" til at starte den ekstra Ingester.
Torsdag den 18. juli implementerede vi fire nye prioriteringsniveauer i vores klynger: kritisk, høj, middel og lav. De blev testet på den interne klynge uden kundetrafik i cirka en uge. Som standard fik pods uden tildelt prioritet middel prioritet, mens der blev tildelt en klasse med høj prioritet til Ingester. Kritisk blev reserveret til overvågning (Prometheus, Alertmanager, node-exporter, kube-state-metrics osv.). Vores konfiguration er åben, og PR'en kan ses .
Nedbrud
Fredag den 19. juli startede en af ingeniørerne en ny dedikeret Cortex-klynge for en stor kunde. Konfigurationen for denne klynge inkluderede ikke de nye pod-prioriteter, så alle nye pods fik standardprioritet - middel.
Der manglede ressourcer i Kubernetes-klyngen til den nye Cortex-klynge, og den eksisterende produktionsklynge Cortex blev ikke opdateret (Ingester havde ikke høj prioritet). Da Ingester i den nye klynge som standard havde middel prioritet, og de eksisterende pods i produktionen kørte uden prioritet, skubbede Ingester fra den nye klynge Ingester fra den eksisterende produktionsklynge Cortex.
ReplicaSet for the evicted Ingester in the production cluster detected the evicted pod and created a new one to maintain the specified number of replicas. The new pod was assigned by default middel priority, causing another 'old' Ingester in production to lose resources. The result was an avalanche process, which led to the eviction of all Ingester pods for production clusters of Cortex.
Ingester pods are stateful and store data for the previous 12 hours. This allows us to compress them more efficiently before writing to long-term storage. For this, Cortex shards the data by series, using a Distributed Hash Table (DHT), and replicates each series to three Ingester pods with quorum consistency in the style of Dynamo. Cortex does not write data to Ingester pods that are turned off. Thus, when a large number of Ingester pods leave the DHT, Cortex cannot provide sufficient replication of records, causing them to 'fall'.
Detection and resolution
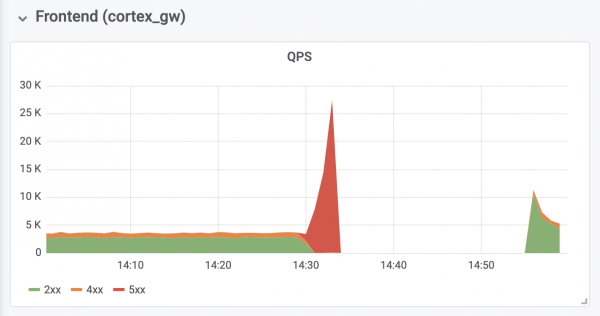
New Prometheus alerts based on 'error budget' (error-budget-based — details will appear in a future article) started sounding the alarm four minutes after the outage began. Over the next five minutes, we conducted diagnostics and scaled the underlying Kubernetes cluster to host both new and existing production clusters.
Another five minutes later, the old Ingester pods successfully recorded their data, while the new ones started up, and the Cortex clusters became available again.
Another 10 minutes were spent on diagnostics and fixing out-of-memory (OOM) errors from the authentication reverse proxy servers located in front of Cortex. The OOM errors were caused by a tenfold increase in QPS (which we believe was due to overly aggressive requests from the client’s Prometheus servers).
Consequences
The overall downtime lasted 26 minutes. No data was lost. Ingester pods successfully uploaded all in-memory data to long-term storage. During the outage, client Prometheus servers buffered remote (remote) records using based on WAL (authored by from Grafana Labs) and repeated the failed records after the failure.
Operations of the production cluster
Konklusioner
It is crucial to learn lessons from this incident and take the necessary measures to prevent its recurrence.
Når vi ser tilbage, må vi erkende, at vi ikke skulle have sat standard middel prioritet, før alle Ingester'enheder i produktionen havde modtaget høj prioriteten. Derudover skulle der have været taget højde for deres høje prioritet på forhånd. Nu er alt rettet op. Vi håber, at vores erfaring vil hjælpe andre organisationer, der overvejer at bruge pod-prioriteter i Kubernetes.
Vi vil tilføje et ekstra niveau af kontrol for udrulningen af enhver yderligere objekt, hvis konfigurationer er globale for klyngen. Fremover vil sådanne ændringer blive vurderet affleste afet større antal personer. Desuden blev den modificering, der førte til fejlen, anset for at være for ubetydelig til et separat projekt dokument — den blev kun diskuteret i et GitHub-issue. Fra nu af vil alle sådanne konfigurationsændringer blive ledsaget af den relevante projekt dokumentation.
Endelig vil vi automatisere omdimensioneringen af den omvendte proxy-authenticator for at forhindre OOM ved overbelastning, som vi har været vidne til, og gennemgå Prometheus standardindstillinger vedrørende rollback og skaleringsmuligheder for at forhindre lignende problemer i fremtiden.
Den oplevede fejl havde også nogle positive konsekvenser: ved at have de nødvendige ressourcer til rådighed, genoprettede Cortex automatisk uden yderligere indblanding. Vi fik også værdifuld erfaring med — vores nye logaggregationssystem, — som hjalp med at sikre, at alle Ingester'enheder opførte sig korrekt under og efter fejlen.
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
