

Hej, Habr! Jeg er Artem Karamychev, leder af systemadministrationsteamet . I løbet af det sidste år har vi lanceret mange nye produkter. Vi ønskede at sikre, at API-tjenester nemt kunne skaleres, var fejl tolerante og klar til hurtig vækst i brugerbelastning. Vores platform er bygget på OpenStack, og jeg vil gerne fortælle om de problemer med komponenternes fejl tolerans, som vi har måttet løse for at opnå et fejl tolerant system. Jeg tror, dette vil være interessant for dem, der også udvikler produkter på OpenStack.
Den samlede fejl tolerans for platformen kommer fra robustheden af dens komponenter. Så vi vil gradvist gennemgå alle niveauer, hvor vi fandt risici og lukkede dem.
Du kan se video versionen af denne historie, som stammer fra en præsentation på konferencen Uptime day 4, der blev organiseret af , .
Fejl tolerans af den fysiske arkitektur
Den offentlige del af MCS-skyen er i øjeblikket baseret i to Tier III datacentre, der er forbundet med et eget mørkt fiberkabelforbindelse, der er reserveret på det fysiske niveau med forskellige ruter, med en kapacitet på 200 Gbit/s. Tier III-niveauet sikrer det nødvendige niveau af fejl tolerans i den fysiske infrastruktur.
Det mørke fiber er reserveret både på det fysiske og logiske niveau. Processen med at reservere kanaler var iterativ, der opstod problemer, og vi forbedrer konstant forbindelsen mellem datacentrerne.
For eksempel for nylig, under arbejde i en brønd nær et af datacentrene, blev rør skadet med en gravemaskine, hvor både hoved- og backup optisk kabel var placeret. Vores fejl tolerante kommunikationskanal til datacentret viste sig at være sårbar på ét punkt, i brønden. Vi mistede således en del af infrastrukturen. Vi lærte af det, tog en række skridt, herunder at lægge ekstra optik gennem den nærliggende brønd.
I datacentre findes der tilstedeværelsessteder for udbydere af netværk, som vi transmitterer vores præfikser til via BGP. For hver netværksretning vælges den bedste metrik, hvilket muliggør at levere den bedste forbindelseskvalitet til forskellige kunder. Hvis forbindelsen gennem en udbyder afbrydes, omdirigerer vi vores routing over de tilgængelige udbydere.
Ved fejl i en udbyder skifter vi automatisk til den næste. Hvis en af datacentrene svigter, har vi en spejlet kopi af vores tjenester i det andet datacenter, som håndterer al belastning.
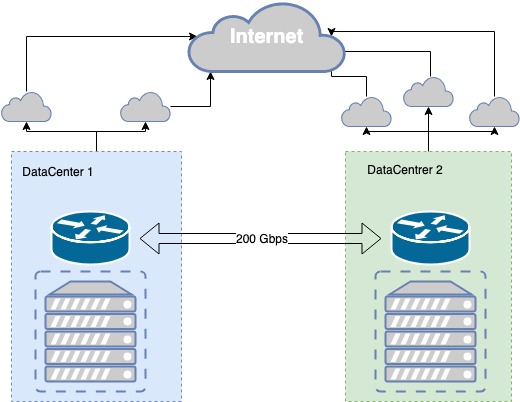
Fejltolerance i den fysiske infrastruktur
Hvad vi bruger til fejltolerance på applikationsniveau
Vores service er bygget på en række opensource-komponenter.
ExaBGP — en service, der implementerer en række funktioner ved hjælp af en dynamisk routingprotokol baseret på BGP. Vi bruger det aktivt til at annoncere vores hvide IP-adresser, som brugerne får adgang til via API.
HAProxy — en højbelastet balancer, der muliggør meget fleksible regler for trafikbalancering på forskellige niveauer af OSI-modellen. Vi bruger det til balancering foran alle tjenester: databaser, meddelelsesmæglere, API-tjenester, webtjenester, vores interne projekter - alt drives af HAProxy.
API-applikation — en webapplikation skrevet i python, hvormed brugeren styrer sin infrastruktur, sin service.
Worker-applikation (herefter blot worker) - i OpenStack-tjenester er dette en infrastrukturdaemon, der muliggør transmission af API-kommandoer til infrastrukturen. For eksempel sker oprettelsen af en disk netop i worker, mens anmodningen om oprettelse sker i API-applikationen.
Standardarkitektur for OpenStack-applikation
De fleste tjenester, der udvikles til OpenStack, forsøger at følge en ensartet paradigme. En tjeneste består typisk af 2 dele: API og workers (backend-udførere). Som regel er API'et en WSGI-applikation skrevet i Python, der køres enten som en selvstændig proces (daemon) eller via en eksisterende webserver som Nginx eller Apache. API'et behandler brugerens anmodning og videresender derefter instruktioner til worker-applikationen. Transmissionen foregår via en meddelelsesbroker, som typisk er RabbitMQ, mens andre varianter understøttes dårligt. Når beskederne kommer ind i brokeren, behandles de af workers, som om nødvendigt returnerer et svar.
Dette paradigme indebærer isolerede fælles fejlpunkter: RabbitMQ og databasen. RabbitMQ er derimod isoleret inden for en enkelt tjeneste og kan i princippet være individuelt for hver service. Derfor adskiller vi i MCS maksimal disse tjenester; til hvert enkelt projekt opretter vi en separat database og en separat RabbitMQ. Denne tilgang er god, fordi i tilfælde af en fejl på nogle sårbare punkter, går ikke hele tjenesten ned, men kun en del af den.
Antallet af worker-applikationer er ikke begrænset af nogen faktorer, så API'et kan nemt skaleres horisontalt bag load-balancere for at øge ydeevnen og fejltolerance.
I nogle tjenester er intern koordinering nødvendig — når komplekse sekventielle operationer finder sted mellem API'et og workers. I dette tilfælde bruges et centralt koordinationspunkt, et klynge-system som Redis, Memcache, etcd, der gør det muligt for én worker at informere en anden om, at denne opgave er tildelt ham ("du, tag venligst ikke fat i den"). Vi bruger etcd. Som regel kommunikerer workers aktivt med databasen, skriver til den og læser information derfra. Vi bruger MariaDB, som vi har i en multimaster-klynge.
Denne klassiske enkeltstående tjeneste er organiseret på den sædvanlige måde for OpenStack. Den kan betragtes som et lukket system, hvor metoderne til skalering og fejltolerance er rimeligt åbenlyse. For eksempel er det tilstrækkeligt at placere en load-balancer foran API'et for at sikre fejltolerance. Skaleringen af workers opnås ved at øge deres antal.
Det svage punkt i hele systemet er RabbitMQ og MariaDB. Deres arkitektur fortjener en særskilt artikel. I denne artikel ønsker jeg at fokusere på API'ernes fejlfindingsfrihed.
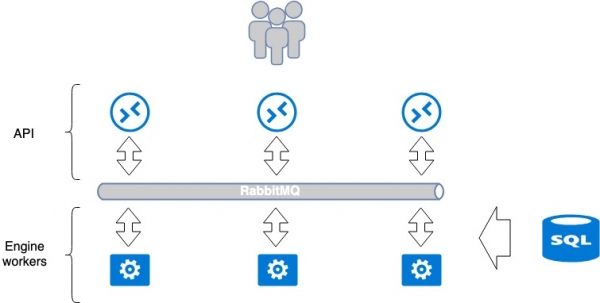
Arkitektur for Openstack Application. Belastningsfordeling og fejltolerance for cloud-platformen
Gør HAProxy-belastningsfordeleren fejltolerant med ExaBGP
For at vores API'er kan være skalerbare, hurtige og fejltolerante, har vi placeret en belastningsfordeler foran dem. Vi valgte HAProxy. Efter min mening har det alle de nødvendige egenskaber til vores opgave: belastning på flere OSI-niveauer, administrationsinterface, fleksibilitet og skalerbarhed, et stort antal belastningsmetoder, understøttelse af sessionstabeller.
Det første problem, der skulle løses, var fejltolerance for selve belastningsfordeleren. Bare at installere belastningsfordeleren skaber også et fejlpunk: hvis belastningsfordeleren går ned, falder tjenesten. For at undgå dette brugte vi HAProxy sammen med ExaBGP.
ExaBGP muliggør implementeringen af en mekanisme til sundhedstjek af tjenesten. Vi brugte denne mekanisme til at kontrollere HAProxy's funktionalitet og i tilfælde af problemer slukke HAProxy-tjenesten fra BGP.
Diagram over ExaBGP+HAProxy
- Vi installerer den nødvendige software, ExaBGP og HAProxy, på tre servere.
- På hver af serverne opretter vi en loopback-grænseflade.
- På alle tre servere angiver vi den samme offentlige IP-adresse for denne grænseflade.
- Den offentlige IP-adresse annonceres til internettet via ExaBGP.
Fejltolerance opnås ved at annoncere den samme IP-adresse fra alle tre servere. Set fra netværket er den samme adresse tilgængelig fra tre forskellige next-hop. Routeren ser tre identiske ruter og vælger den mest prioriterede baseret på sin egen metrik (som normalt er den samme), og trafikken går kun til én af serverne.
I tilfælde af problemer med HAProxy eller hvis en server går ned, stopper ExaBGP med at annoncere ruten, og trafikken skifter glidende til en anden server.
Dermed har vi opnået fejltolerance for belastningsfordeleren.
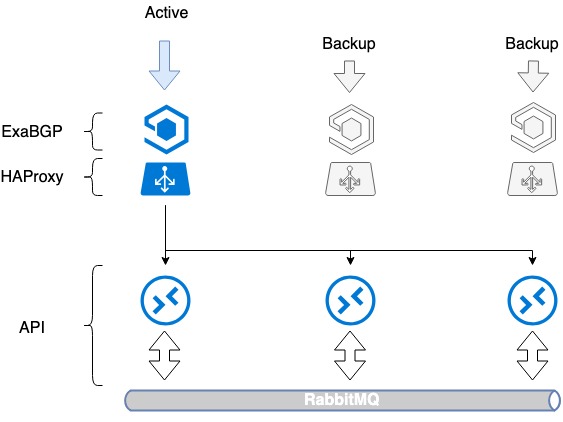
Fejltolerance for HAProxy-belastningsfordelere
Skemaet er ikke perfekt: vi har lært at redundere HAProxy, men ikke at fordele belastningen inden for tjenesterne. Derfor har vi udvidet denne skema lidt: vi er gået over til belastningsfordeling mellem flere offentlige IP-adresser.
DNS-baseret belastningsbalance plus BGP
Spørgsmålet om belastningsbalance foran vores HAProxy er stadig ikke løst. Men det kan løses ret enkelt, som vi gjorde det hos os.
Til belastningsbalancering af tre servere vil der være brug for 3 offentlige IP-adresser og den gode gamle DNS. Hver af disse adresser defineres på loopback-grænsefladen for hver HAProxy og annonceres på internettet.
I OpenStack bruges en servicekatalog til at styre ressourcer, hvor endpoint API for enhver given service angives. I dette katalog angiver vi domænenavnet — public.infra.mail.ru, som opløses via DNS til tre forskellige IP-adresser. Resultatet er, at vi opnår belastningsfordeling mellem de tre adresser via DNS.
Men da vi ikke styrer prioriteterne for valg af server ved annoncering af de offentlige IP-adresser, er det ikke rigtig belastningsbalance. Som regel vil kun én server blive valgt based på IP-adressens anciennitet, mens de to andre forbliver inaktive, da der ikke er angivet nogen målinger i BGP.
Vi begyndte at annoncere ruter gennem ExaBGP med forskellige målinger. Hver belastningsbalancer annoncerer alle tre offentlige IP-adresser, men en af dem, den hovedadresse for denne belastningsbalancer, annonceres med den laveste måling. Så længe alle tre belastningsbalancere er i drift, sendes anmodninger til den første IP-adresse til den første belastningsbalancer, anmodninger til den anden til den anden, og til den tredje til den tredje.
Hvad sker der i det øjeblik, en af belastningsbalancerne falder ud? Ved nedbrud af en hvilken som helst belastningsbalancer annonceres dens grundlæggende adresse stadig fra de to andre, og trafikken omfordeles mellem dem. Dermed giver vi brugeren flere IP-adresser gennem DNS. Gennem DNS-belastningsbalancering og forskellige målinger opnår vi en jævn fordeling af belastningen på alle tre belastningsbalancere. Og samtidig mister vi ikke fejltolerance.
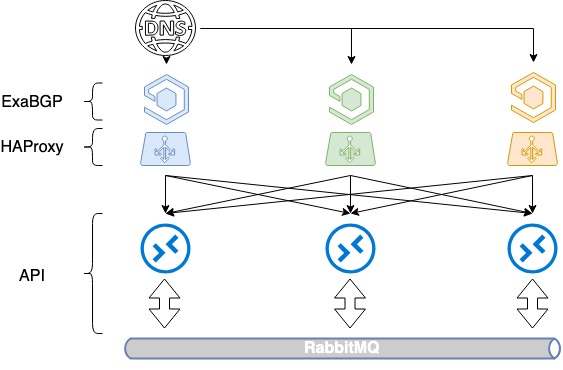
HAProxy-belastningsbalance baseret på DNS + BGP
Interaktion mellem ExaBGP og HAProxy
Så vi har implementeret fejltolerance i tilfælde af serversvigt baseret på ophør af ruteannoncering. Men HAProxy kan også gå ned af andre årsager end serverfejl: administrationsfejl, fejl i tjenesten. Vi ønsker at fjerne den defekte belastningsbalancer fra belastningen i disse tilfælde, og der er behov for en anden mekanisme.
Derfor, ved at udvide det tidligere skema, har vi implementeret heartbeat mellem ExaBGP og HAProxy. Dette er en softwareimplementering af interaktionen mellem ExaBGP og HAProxy, hvor ExaBGP bruger tilpassede scripts til at kontrollere status for applikationer.
For dette skal health checker konfigureres i ExaBGP, så den kan kontrollere status på HAProxy. I vores tilfælde har vi konfigureret health backend i HAProxy, og fra ExaBGP tjekker vi med en simpel GET-anmodning. Hvis annonceringen stopper, fungerer HAProxy sandsynligvis ikke, og den skal ikke annonceres.
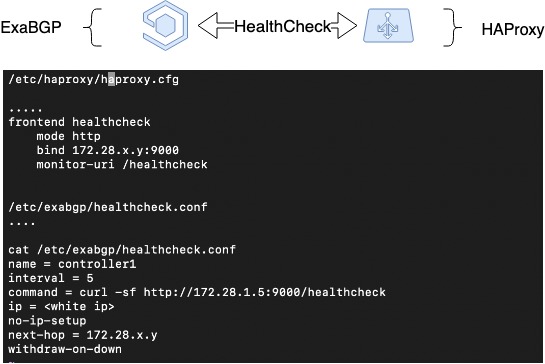
HAProxy Health Check
HAProxy Peers: session synchronisering
Det næste, vi skulle gøre, var at synkronisere sessioner. Når man arbejder med distribuerede belastningsbalancere, er det vanskeligt at organisere gemmelse af information om kunders sessioner. Men HAProxy er en af de få balancere, der kan dette takket være Peers-funktionen — muligheden for at overføre sessionstabeller mellem forskellige HAProxy-processer.
Der findes forskellige metoder til belastningsbalancering: simple, såsom , og avancerede, hvor kundens session huskes, og han hver gang lander på den samme server som før. Vi ville implementere den anden variant.
I HAProxy bruges stick-tables til at gemme kundens sessioner. De gemmer den oprindelige kunde-IP, den valgte target-adresse (backend) og nogle tjenesteinformationer. Som regel bruges stick-tabeller til at gemme parrene source-IP + destination-IP, hvilket er særligt nyttigt for applikationer, der ikke kan overføre brugerens sessionens kontekst ved skift til en anden belastningsbalancer, eksempelvis i RoundRobin-belastningsbalanceringsmodus.
Hvis stick-tabellen kan lære at flytte sig mellem forskellige HAProxy-processer (imellem hvilke belastningsbalanceringen foregår), vil vores balancere kunne arbejde med en fælles pulje af stick-tabeller. Dette vil muliggøre sømløs skift af kundens netværk, hvis en af balancerne fejler, og arbejdet med kundesessioner vil fortsætte på de samme backends, som blev valgt tidligere.
For korrekt funktion skal problemet med IP-adressen på den belastningsbalancer, hvor sessionen er etableret, løses. I vores tilfælde er dette en dynamisk adresse på loopback-interfacet.
Korrekt drift af peers opnås kun under bestemte betingelser. Det vil sige, at TCP-timeouts skal være tilstrækkeligt store, eller skiftet skal være hurtigt nok til, at TCP-sessionen ikke når at afbryde. Dette muliggør dog problemfrit at skifte.
Vi har en tjeneste i IaaS, der er bygget med samme teknologi. Det er , som kaldes Octavia. Den er baseret på to HAProxy-processer, og der er oprindeligt indbygget støtte til peers. I denne tjeneste har de vist sig at fungere fremragende.
På billedet er der skematisk vist bevægelsen af peers-tabeller mellem tre instanser af HAProxy, og et forslag til konfiguration, hvordan dette kan indstilles:
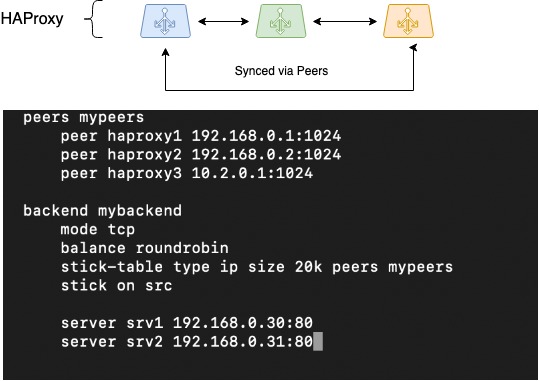
HAProxy Peers (session synkronisering)
Hvis du vil implementere en lignende ordning, skal du nøje teste dens funktion. Det er ikke sikkert, at det vil fungere på samme måde i 100% af tilfældene. Men i det mindste vil du ikke miste stick-tabeller, når du skal huske kilde-IP'en fra klienten.
Begrænsning af antallet af samtidige forespørgsler fra den samme klient
Enhver tjeneste, der er offentligt tilgængelig, herunder vores API'er, kan være udsat for bølger af forespørgsler. Årsagerne kan være vidt forskellige, fra brugerfejl til målrettede angreb. Vi oplever jævnligt DDoS-angreb via IP-adresser. Kunderne laver ofte fejl i deres scripts og udsætter os for mini-DDoS-angreb.
På den ene eller den anden måde er det nødvendigt at forudse en ekstra beskyttelse. En åbenlys løsning er at begrænse antallet af anmodninger til API'et og ikke spilde processorens tid på at behandle skadelige forespørgsler.
Til at implementere sådanne begrænsninger anvender vi rate limits, organiseret på basis af HAProxy, ved hjælp af de samme stick-tabeller. Begrænsningerne kan indstilles ret enkelt og tillader at begrænse brugeren i antallet af anmodninger til API'et. Algoritmen husker kilde-IP'en, hvorfra der foretages forespørgsler, og begrænser antallet af samtidige anmodninger fra én bruger. Selvfølgelig har vi beregnet den gennemsnitlige belastningsprofil på API'et for hver tjeneste og etableret en grænse, der er ca. 10 gange større end denne værdi. Vi fortsætter med at overvåge situationen nøje og holder hånden på pulsen.
Hvordan ser det ud i praksis? Vi har kunder, der konstant bruger vores API til automatisk skalering. De opretter cirka to hundrede til tre hundrede virtuelle maskiner tættere på morgen og sletter dem tættere på aften. For OpenStack at oprette en virtuel maskine, især med PaaS-tjenester, kræver det mindst 1000 API-anmodninger, da interaktionen mellem tjenesterne også sker gennem API.
Sådan omfordeling af opgaver medfører en betydelig belastning. Vi har vurderet denne belastning, indsamlet daglige toppe, fordoblet dem, og dette blev vores rate-limit. Vi holder styr på situationen. Vi ser ofte bots og scannere, som forsøger at undersøge os for at se, om vi har nogle CGA-scripts, som de kan køre; vi skærer aktivt ned på dem.
Hvordan man opdaterer kodebasen uset for brugerne
Vi implementerer også fejltolerance på niveau med kodeudrulningsprocesser. Under udrulninger opstår der fejl, men deres indflydelse på serviceadgang kan minimeres.
Vi opdaterer konstant vores tjenester og skal sikre, at opdateringsprocessen for kodebasen ikke påvirker brugerne. Vi har løst denne opgave ved at bruge mulighederne for styring af HAProxy og implementering af Graceful Shutdown i vores tjenester.
For at løse denne opgave var det nødvendigt at sikre styring af load-balanceren og en "proper" nedlukning af tjenesterne:
- I tilfælde af HAProxy sker styring gennem stats-filen, der i bund og grund er en socket og defineres i konfigurationen af HAProxy. Kommandoer kan sendes dertil gennem stdio. Men vores primære værktøj til kontrol af konfigurationer er Ansible, så der er en indbygget modul til styring af HAProxy, som vi bruger aktivt.
- Størstedelen af vores API- og Engine-tjenester understøtter teknologier til graceful shutdown: når de slukkes, venter de på, at den aktuelle opgave er helt afsluttet, uanset om det er en http-anmodning eller en slags serviceopgave. Det samme gælder for worker’en. Den kender alle opgaver, den udfører, og afsluttes, når alt er afsluttet.
Takket være disse to punkter ser vores sikre udrulningsalgoritme sådan ud.
- Udvikleren samler en ny kodepakke (for os er dette RPM), tester den i udviklingsmiljøet, tester den i staging, og efterlader den i staging-repositoriet.
- Udvikleren angiver opgaven med deployment med en så detaljeret beskrivelse af "artefakterne" som muligt: versionen af den nye pakke, beskrivelsen af den nye funktionalitet og andre detaljer om deploymentet, hvis nødvendigt.
- Systemadministratoren påbegynder opdateringen. Han starter Ansible-playbook'en, som gør følgende:
- Henter pakken fra stage-repositoriet og opdaterer pakken i produktionsrepositoriet.
- Sammensætter listen over backends for den opdaterede service.
- Slukker for den første opdaterede service i HAProxy og venter på, at dens processer er færdige. Takket være graceful shutdown er vi sikre på, at alle eksisterende kundeanmodninger vil blive afsluttet succesfuldt.
- Efter den fuldstændige nedlukning af API, workers og slukningen af HAProxy, opdateres koden.
- Ansible starter tjenesterne.
- For hver tjeneste kalder den specifikke "knapper", der udfører unit-testning baseret på en række foruddefinerede testnøgler. Der udføres en grundlæggende kontrol af den nye kode.
- Hvis der ikke blev opdaget fejl i det forrige trin, aktiveres backend'en.
- Vi går videre til den næste backend.
- Efter opdateringen af alle backends, startes funktionelle tests. Hvis der mangler tests, ser udvikleren på enhver ny funktionalitet, han har arbejdet på.
Deploymentet er nu færdigt.
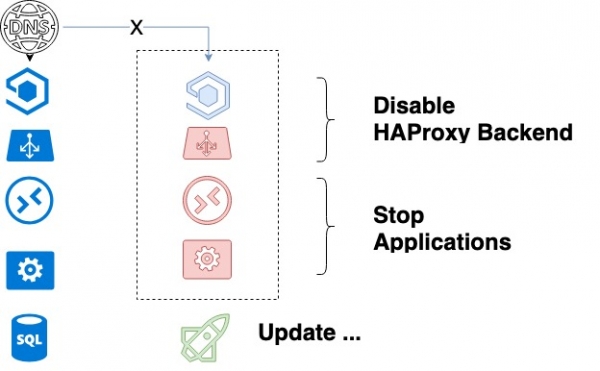
Cyklen for at opdatere servicen
Denne skema ville ikke fungere, hvis vi ikke havde én regel. Vi understøtter samtidig både den gamle og den nye version i produktion. På forhånd, i softwareudviklingsfasen, tages det i betragtning, at selvom der sker ændringer i databasen for tjenesten, vil de ikke bryde den tidligere kode. Resultatet er en gradvis opdatering af kodebasen.
Konklusion
Når jeg deler mine tanker om fejltolerant WEB-arkitektur, vil jeg endnu en gang understrege dens nøglepunkter:
- fysisk fejltolerance;
- netværksfejltolerance (load balancere, BGP);
- fejltolerance af den anvendte og udviklede software.
Alle ønsker stabil uptime!
Kilde: habr.com
