

Vi lancerede nye tjenester, trafikken voksede, vi udskiftede servere, tilføjede nye steder og ombyggede datacentre – og nu vil vi fortælle denne historie, som vi første gang præsenterede for jer for fem år siden..
Fem år er et typisk tidsrum til at opsummere og vurdere fremskridt. Derfor har vi besluttet at fortælle om udviklingen af vores infrastruktur, som har gennemgået en utrolig spændende rejse i løbet af de fem år, vi er stolte af. De kvantitative ændringer, vi har gennemført, er blevet til kvalitative, og nu kan infrastrukturen fungere i tilstande, som for et årti siden syntes som science fiction.
Vi sikrer driften af komplekse projekter med strenge krav til pålidelighed og belastninger, herunder PREMIER og Match TV. Under sportsudsendelser og ved premiere på populære serier kræves der trafikoverførsel i terabits/s, hvilket vi nemt kan håndtere, så ofte at arbejde med sådanne hastigheder længe har været en del af vores hverdag. For fem år siden var det tungeste projekt, der arbejdede på vores systemer, Rutube, som siden da har udviklet sig, øget sine volumener og trafik, hvilket skulle tages i betragtning ved planlægningen af belastninger.
Vi har fortalt om, hvordan vi udviklede 'hardwaren' i vores infrastruktur () og udviklede systemet ansvarlig for videooverførsel (), men siden skriveperioden for disse tekster er der gået meget tid, og mange andre løsninger er blevet skabt og implementeret, hvis resultater gør os i stand til at opfylde moderne krav og være tilstrækkeligt fleksible til at tilpasse os nye opgaver.
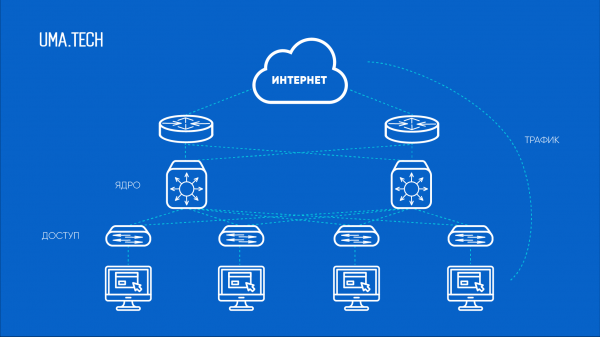
Kernenettet udvikler vi konstant. Vi gik over til Cisco-udstyr i 2015, som vi også nævnte i den tidligere artikel. Dengang var det de samme 10/40G, men af åbenlyse grunde har vi allerede efter et par år opgraderet de eksisterende chassiser, og nu bruger vi også 25/100G aktivt.
100G-forbindelser er længe ikke længere en luksus (snarere er det et presserende krav i vores segment), og de er heller ikke en sjældenhed (flere og flere operatører tilbyder tilslutning med sådanne hastigheder). Dog forbliver 10/40G relevant: gennem disse forbindelser fortsætter vi med at tilslutte operatører med et lille trafikvolumen, hvor det i øjeblikket ikke er hensigtsmæssigt at bruge en mere kapacitetsdrivende port.
Det netværkskerne, vi har skabt, fortjener en særskilt overvejelse og vil senere blive emnet for en separat artikel. Her vil vi dykke ned i de tekniske detaljer og overveje logikken bag vores handlinger under opbygningen. Men nu fortsætter vi med at skitsere infrastrukturen mere skematisk, da jeres opmærksomhed, kære læsere, ikke er ubegribelig.
Video udleveringsservere evolverer hurtigt, for hvilket vi tilbyder en del indsats. Tidligere brugte vi primært 2U-servere med 4-5 netværkskort, hver med to 10G-porte, men nu leveres størstedelen af trafikken fra 1U-servere, hvor 2-3 kort hver har to 25G-porte. Priserne på 10G- og 25G-kort er næsten blevet lige, og hurtigere løsninger gør det muligt at levere både 10G og 25G. Resultatet er en klar besparelse: færre serverkomponenter og kabler til tilslutning – lavere omkostninger (og højere pålidelighed), komponenter optager mindre plads i racken – hvilket muliggør placering af flere servere pr. pladsenhed og dermed lavere lejeomkostninger.
Men vigtigere er gevinsten i hastighed! Nu kan vi med 1U levere mere end 100G! Og dette i en situation, hvor nogle store russiske projekter betegner en udlevering på 40G med 2U som en 'bedrift'. Vi ville ønske, det var vores problemer!
Lad os bemærke, at generationen af netværkskort, der kun kan arbejde på 10G, stadig er i brug. Dette udstyr fungerer stabilt og er os velkendt, så vi har ikke smidt det væk, men fundet en ny anvendelse for det. Disse komponenter har vi installeret i videoopbevaringsservere, som for effektiv drift åbenlyst klart ikke kan nøjes med én to 1G-grænseflader, her viste 10G-kort sig at være relevante.
Datablagringssystemer De også vokser. I løbet af de seneste fem år er de gået fra at have tolv diskpladser (12x HDD 2U) til at have seksogtredive diskpladser (36x HDD 4U). Nogle er bange for at bruge så store chassis, da et enkelt fejl kan true hele systemets ydeevne – eller endda dets funktionsdygtighed! – Men hos os vil det ikke ske: vi har sikret os redundans med geodistribuerede data kopier. Vi har fordelt chassis i forskellige datacentre – vi bruger i alt tre – og dette forhindrer problemer både ved fejl i chassis og ved nedbrud på site.
Selvfølgelig har denne tilgang gjort hardware RAID overflødig, og vi har derfor droppet det. Ved at fjerne redundans har vi samtidig øget systemets pålidelighed, forenklet løsningen og fjernet et af de potentielle fejlpunkter. Lad os minde om, at vores storage-systemer er "håndlavede". Dette valg tog vi helt bevidst, og resultatet har fuldt ud tilfredsstillet os.
Datacentre i løbet af de sidste fem år har vi skiftet flere gange. Siden skrivningen af den tidligere artikel har vi kun ikke ændret ét datacenter – DataLine – de andre har krævet udskiftning i takt med udviklingen af vores infrastruktur. Alle flytninger mellem sites har været planlagte.
For to år siden migrerede vi indenfor MMTS-9 og flyttede til en site med kvalitetsembelægning, god kølesystem, stabil strømforsyning og uden den støv, der tidligere lå i tykke lag på alle overflader og også fyldte vores udstyr. Valget af kvalitet i ydelser – og fraværet af støv! – var årsagen til vores flytning.
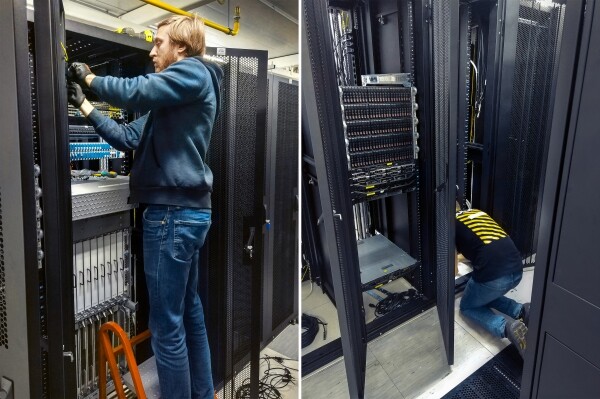
Næsten altid "gælder en flytning som to brande", men problemerne under migrationen er hver gang forskellige. Denne gang blev den største udfordring ved flytningen inden for et datacenter "leveret" af de optiske krydsforbindelser – deres overflod på tværs af etagerne uden at blive samlet i en fælles krydsforbindelse fra teleselskaberne. Processen med at opdatere og omdirigere krydsforbindelserne (hvor ingeniørerne fra MMTS-9 hjalp os) var nok det sværeste trin i migrationen.
Den anden migration fandt sted for et år siden, i 2019, da vi flyttede fra et mindre godt datacenter til O2xygen. Årsagerne til flytningen var lignende dem, der er nævnt ovenfor, men der kom også et problem med den manglende attraktivitet af det oprindelige datacenter for teleselskaber – mange udbydere måtte vi "indlejre" til dette punkt selv.
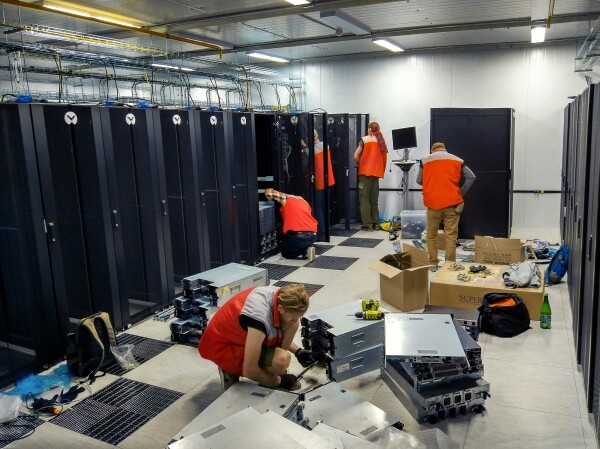
Migrationen af 13 racks til en kvalitetslokation i MMTS-9 gjorde det muligt at udvikle denne lokation ikke kun som operatør (par tre racks og "bypass" til operatører), men også at anvende den som en af de primære. Dette har gjort migrationen fra et mindre godt datacenter lidt lettere – det meste af udstyret derfra blev vi flyttet til en anden lokation, og O2xygen fik rollen som den voksende, da vi også sendte 5 racks med udstyr derhen.
I dag er O2xygen allerede en fuldgyldig lokation, hvor de nødvendige operatører "er kommet" til og fortsætter med at tilslutte sig. For operatørerne har O2xygen også vist sig at være attraktiv med hensyn til strategisk udvikling.
Hovedfasen af flytningen gennemfører vi bestemt på en nat, og ved migrationen inden for MMTS-9 og til O2xygen overholdt vi denne regel. Vi understreger, at regelen om "flytning på en nat" strengt overholdes uanset antallet af racks! Der var endda et tilfælde, hvor vi flyttede 20 racks og også fik det gjort på en nat. Migrationen er en forholdsvis ukompliceret proces, der kræver omhu og rækkefølge, men der er også nogle tricks både i forberedelsesprocessen, ved flytningen og ved implementeringen på den nye lokation. Vi er klar til at fortælle mere detaljeret om migrationen, hvis du er interesseret.
Resultater Vi kan godt lide femårsplaner. Vi har afsluttet opbygningen af en ny fejltolerant infrastruktur, fordelt over tre datacentre. Vi har markant øget trafikkens tæthed – hvis vi for nylig var glade for 40-80G med 2U, er det nu normalt for os at levere 100G med 1U. Nu opfattes en terabit trafik som hverdagskost for os. Vi er klar til at fortsætte med at udvikle vores infrastruktur, som er blevet fleksibel og skalerbar.
Spørgsmål: Hvad skal vi fortælle dig i de kommende tekster, kære læsere? Om hvorfor vi begyndte at lave vores egne datalagringssystemer? Om netværkskerner og deres egenskaber? Om tricks og nuancer ved migration mellem datacentre? Om optimering af løsninger gennem valg af komponenter og finjustering af parametre? Om oprettelse af robuste løsninger takket være multipel redundans og horisontale skaleringsmuligheder inden for datacentret, der er implementeret i strukturen af tre datacentre?
Forfatter: Peter Vinogradov – Teknisk direktør hos Uma.Tech
Kilde: habr.com
