

JPEG-billeder findes overalt i vores digitale liv, men bag dette lag af bevidsthed skjuler der sig algoritmer, der eliminerer detaljer, som det menneskelige øje ikke opfatter. Resultatet er en fremragende visuel kvalitet med minimal filstørrelse – men hvordan fungerer det præcist? Lad os se på, hvad vores øjne ikke ser!
Det er let at tage det for givet, at man kan sende et billede til en ven uden at bekymre sig om, hvilken enhed, browser eller operativsystem de bruger – men det har ikke altid været sådan. I begyndelsen af 1980'erne kunne computere gemme og vise digitale billeder, men der var mange konkurrerende ideer om den bedste måde at gøre dette på. Man kunne ikke bare sende et billede fra én computer til en anden og håbe, det ville fungere.
For at løse dette problem blev der i 1986 nedsat et ekspertudvalg fra hele verden kaldet "" (JPEG), som blev etableret i samarbejde mellem International Organization for Standardization (ISO) og International Electrotechnical Commission (IEC) – to internationale standardiseringsorganisationer, hvis hovedkontor ligger i Genève (Schweiz).
Gruppen af mennesker kaldet JPEG skabte JPEG-billedkomprimeringsstandarden i 1992. Enhver, der har brugt internettet, er sandsynligvis stødt på billeder i JPEG-format. Det er den mest udbredte metode til kodning, sending og opbevaring af billeder. Fra websteder til e-mails og sociale medier anvendes JPEG milliarder af gange dagligt – næsten hver gang vi ser et billede online eller sender et. Uden JPEG ville internettet være mindre farverigt, langsommere, og der ville sandsynligvis være færre kattebilleder!
Denne artikel omhandler, hvordan man dekoderer et JPEG-billede. Med andre ord om, hvad der kræves for at omdanne de komprimerede data, der er gemt på computeren, til et billede, der vises på skærmen. Dette er vigtigt at vide, ikke kun for bedre at forstå teknologien, som vi bruger hver dag, men også fordi ved at afsløre komprimeringsniveauerne lærer vi mere om perception og syn, samt hvilke detaljer vores øjne er mest følsomme overfor.
Derudover er det meget interessant at lege med billeder på denne måde.
Kig ind i JPEG
På computeren opbevares alt som en sekvens af binære tal. Normalt grupperes disse bits, nuller og ettere, i grupper af otte og danner bytes. Når du åbner et JPEG-billede på computeren, skal noget (browseren, operativsystemet, eller noget andet) dekode bytes, således at det gendanner det oprindelige billede i form af en liste af farver, der kan vises.
Hvis du downloader dette nuttede og åbner det i en teksteditor, vil du se en masse uforståelige tegn.
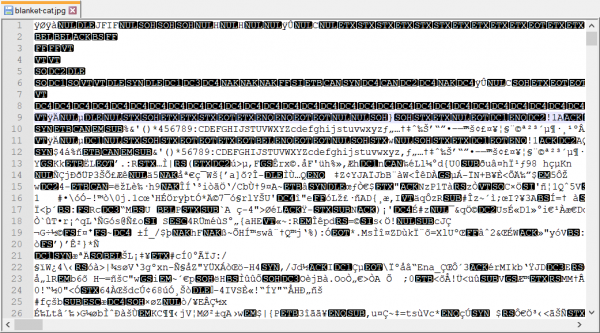
Her bruger jeg Notepad++ til at undersøge filens indhold, da almindelige tekstredaktører, som den almindelige Notepad i Windows, vil ødelægge binærfilen, når de gemmes, og den vil ikke længere opfylde JPEG-formatet.
Ved at åbne billedet i en teksteditor forvirrer du computeren, ligesom du forvirrer din hjerne, når du gnider øjnene og begynder at se farvede pletter!
De pletter, du ser, er kendt som , og er ikke et resultat af lysets påvirkning eller hallucinationer skabt af sindet. De opstår, fordi din hjerne antager, at alle elektriske signaler i synsnervene sender information om lys. Hjernen skal lave sådanne antagelser, da den ikke på nogen måde kan vide, om signalet er lyd, vision eller noget andet. Alle nerver i kroppen sender helt ensartede elektriske impulser. Ved at presse på øjnene sender du signaler, der ikke er visuelle, men som aktiverer øjnerceptorerne, hvilket din hjerne fejltolker – i dette tilfælde – som noget visuelt. Du kan bogstaveligt talt se trykket!
Det er sjovt at tænke på, hvor meget computere ligner hjernen, men det er også en nyttig analogi, der illustrerer, hvor meget værdien af data - overført gennem kroppen via nerverne eller opbevaret på computeren - afhænger af deres fortolkning. Alle binære data består af nuller og ettere, de grundlæggende komponenter, der kan overføre information af enhver art. Din computer gætter ofte, hvordan man skal fortolke dem ved hjælp af hints, som f.eks. filudvidelser. Og nu beder vi den om at fortolke dem som tekst, fordi det er, hvad tekstbehandleren forventer.
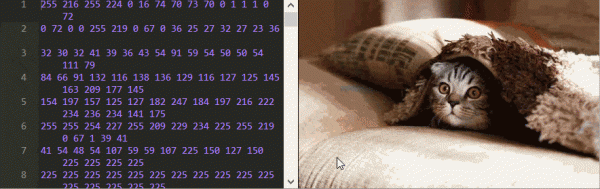
For at forstå, hvordan man dekoder JPEG, skal vi se de oprindelige signaler - de binære data. Dette kan gøres ved hjælp af en hexadecimal editor eller direkte på ! Der er et billede, ved siden af hvilket der i tekstfeltet er angivet alle dets bytes (undtaget headeren), præsenteret i decimalform. Du kan ændre dem, og scriptet genkoder og leverer et nyt billede i realtid.
Man kan lære meget bare ved at lege med denne editor. For eksempel, kan du sige, i hvilken rækkefølge pixelene er gemt?
I dette eksempel er det mærkeligt, at ændringer af nogle tal overhovedet ikke påvirker billedet, men hvis du f.eks. ændrer tallet 17 til 0 i den første linje, så vil billedet helt ødelægges!
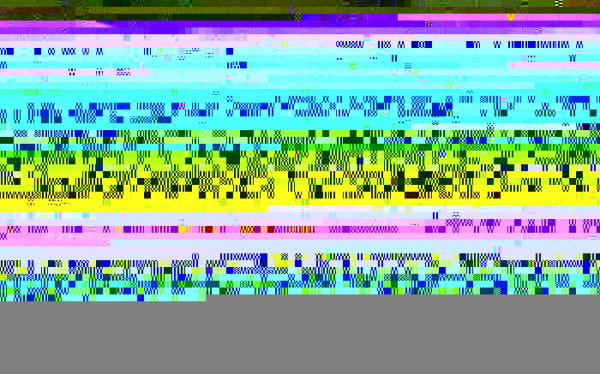
Andre ændringer, for eksempel at ændre 7 på linje 1988 til tallet 254, ændrer farven, men kun på de følgende pixel.
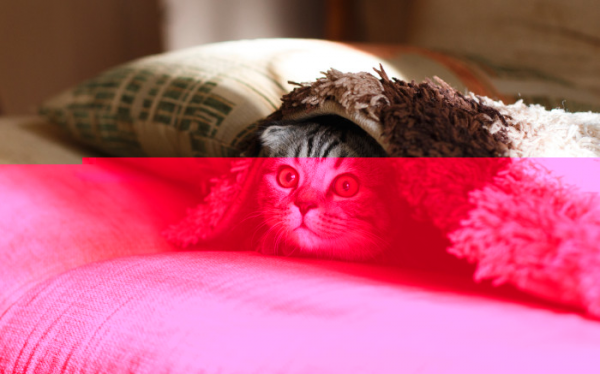
Måske det mest mærkelige er, at nogle tal ændrer ikke kun farven, men også formen på billedet. Ændr 70 i linje 12 til 2 og kig på den øverste række af billedet for at se, hvad jeg mener.
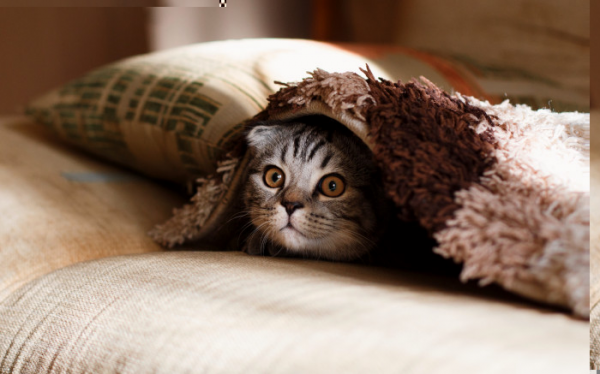
Og uanset hvilket JPEG-billede du bruger, vil du altid finde disse mystiske skakkemønstre, når du redigerer bytes.
Når man leger med editoren, er det svært at forstå, hvordan billedet genskabes fra disse bytes, da JPEG-kompression består af tre forskellige teknologier, der anvendes sekventielt på niveauer. Vi vil undersøge hver af dem separat for at afsløre den mystiske adfærd, vi observerer.
Tre niveauer af JPEG-kompression:
- .
- .
- , og
For you to grasp the scale of compression, note that the image above contains 79,819 numbers, which is about 79 KB. If we stored it uncompressed, each pixel would require three numbers—for the red, green, and blue components. This would total 917,700 numbers, or about 917 KB. As a result of JPEG compression, the final file size reduced by more than 10 times!
In fact, this image can be compressed even further. Below are two images side by side—the photo on the right has been compressed to 16 KB, which is 57 times smaller than the uncompressed version!
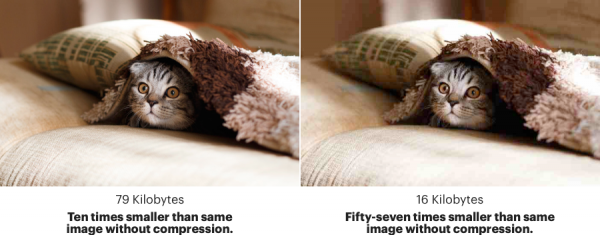
If you look closely, you'll see that these images are not identical. Both are pictures with JPEG compression, but the one on the right is much smaller in size. It also looks a bit worse (check out the squares of the background colors). That's why JPEG is also called lossy compression; during the compression process, the image changes and loses some details.
1. Color Subsampling
Here is the image applying only the first level of compression.
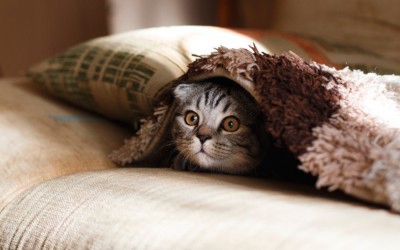
(The interactive version is in the article). Removing one number disrupts all colors. However, if you remove exactly six numbers, it hardly affects the image.
Now the numbers are a bit easier to decode. It's almost a simple list of colors, where each byte changes exactly one pixel, but it's already half the size of the uncompressed image (which would take about 300 KB in this reduced size). Can you guess why?
You can see that these numbers do not represent the standard red, green, and blue components, because if you replace all the numbers with zeros, you'll get a green image (not white).

This is because these bytes represent Y (luminance),
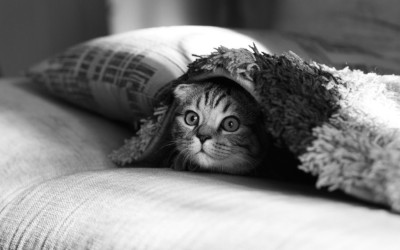
Cb (relative blueness),
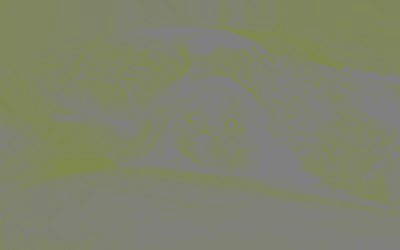
and Cr (relative redness) of the image.
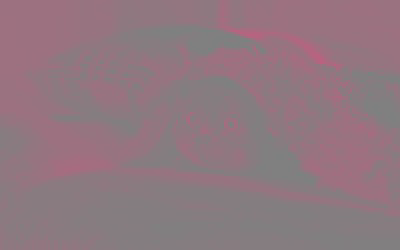
Why not use RGB? After all, that’s how most modern screens work. Your monitor can display any color, including red, green, and blue in varying intensities for each pixel. White is produced by turning all three on at full brightness, while black is achieved by turning them all off.
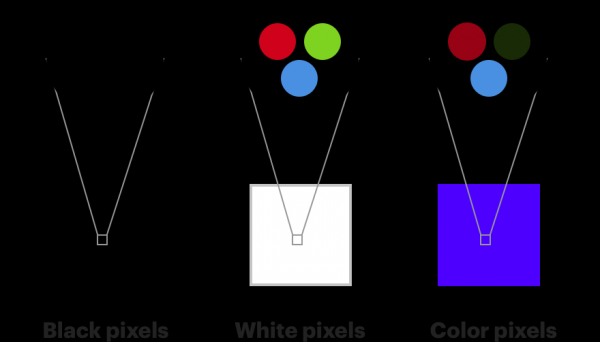
It's also very similar to how the human eye works. The color receptors in our eyes are called '«, og de opdeles i tre typer, hvor hver især er mere følsom overfor enten røde, grønne eller blå farver [S-type koner er følsomme i violet-blå (S fra engelsk Short – kortbølget spektrum), M-type – i grøn-gul (M fra engelsk Medium – mellem-bølget), og L-type – i gul-rød (L fra engelsk Long – langbølget) dele af spektret. Tilstedeværelsen af disse tre typer koner (ogstænger, der er følsomme i smaragdgrøn delen af spektret) giver mennesket farvesyn. / bem. overs.]. , en anden type fotoreceptorer i vores øjne, er i stand til at opdage ændringer i lysstyrke, men er meget mere følsom over for farve. Der er cirka 120 millioner stænger og kun 6 millioner koner i vores øjne.
Derfor bemærker vores øjne ændringer i lysstyrke meget bedre end ændringer i farve. Hvis man adskiller farve fra lysstyrke, kan man fjerne lidt farve, og ingen vil bemærke det. Farvesubdiskretisering er en proces, hvor farvekomponenter i billedet præsenteres med en lavere opløsning sammenlignet med lysstyrkekomponenterne. I eksemplet ovenfor har hver pixel præcist én Y-komponent, og hver enkelt gruppe af fire pixels har præcis én Cb og én Cr komponent. Derfor indeholder billedet fire gange mindre farveinformation end originalen.
Farverummet YCbCr bruges ikke kun i JPEG. Det blev oprindeligt opfundet i 1938 til tv-sendinger. Ikke alle har et farvet television, så opdelingen af farve og lysstyrke gjorde det muligt for alle at modtage det samme signal, mens farveløse tv'er bare brugte lysstyrke-komponenten.
Derfor ødelægger sletningen af et enkelt tal fra editoren fuldstændigt alle farver. Komponenterne gemmes i form af Y Y Y Y Cb Cr (faktisk ikke nødvendigvis i denne rækkefølge – rækkefølgen bestemmes af filens header). Sletning af det første tal vil resultere i, at den første Cb værdi vil blive opfattet som Y, Cr som Cb, og generelt vil dette skabe en dominoeffekt, der skifter alle farverne i billedet.
JPEG-specifikationen forpligter dig ikke til at bruge YCbCr. Men i de fleste filer anvendes det, fordi det giver billeder af bedre kvalitet efter sub-sampling sammenlignet med RGB. Men du behøver ikke at tage mit ord for det. Se selv i tabellen nedenfor, hvordan sub-sampling af hver enkelt komponent vil se ud både i RGB og YCbCr.
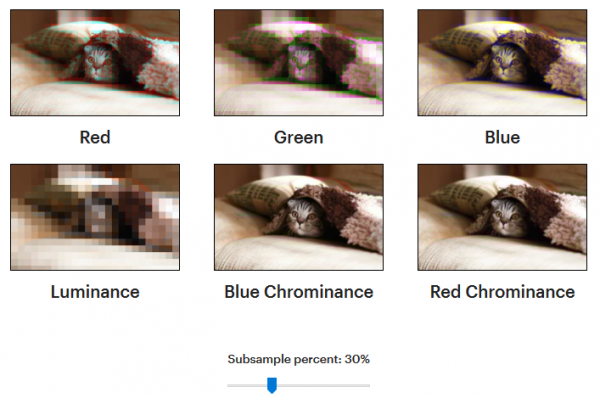
(The interactive version is in the artikler).
Fjernelsen af blå er ikke så bemærkelsesværdig som rød eller grøn. Det skyldes, at af de seks millioner kegler i dine øjne er omtrent 64% følsomme over for rød, 32% til grøn og 2% til blå.
Sub-sampling af Y-komponenten (nederst til venstre) er den mest synlige. Selv en lille ændring er tydelig.
Transformationen af billedet fra RGB til YCbCr reducerer ikke filstørrelsen, men gør det lettere at finde mindre synlige detaljer, der kan fjernes. Tab af kvalitet opstår i det andet trin. Ideen er baseret på at præsentere data i en mere komprimerbar form.
2. Discrete Cosine Transform og sub-sampling
Denne grad af kompression definerer i høj grad essensen af JPEG. Efter farveomformningen til YCbCr komprimeres komponenterne enkeltvis, så vi kan fokusere udelukkende på Y-komponenten. Og sådan ser bytes af Y-komponenten ud efter anvendelse af dette niveau.
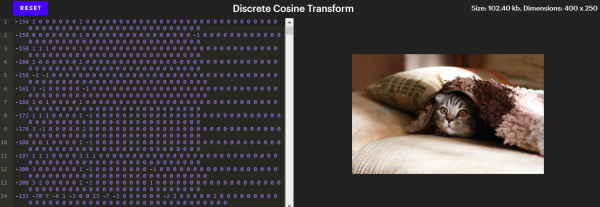
(The interactive version is in the artikler). I den interaktive version klikker du på et pixel for at rulle redaktøren til den linje, der angiver det. Prøv at slette tal fra slutningen eller tilføje nogle nuller til et bestemt nummer.
Ved første øjekast ser det ud som en meget dårlig kompression. I billedet er der 100.000 pixels, og for at angive deres lysstyrke (Y-komponenter) kræves 102.400 tal — det er værre, end hvis ingenting blev komprimeret!
Men bemærk, at de fleste af disse tal er nul. Desuden kan alle disse nuller i slutningen af linjerne fjernes uden at ændre billedet. Der er cirka 26.000 tal tilbage, hvilket er næsten 4 gange mindre!
På dette niveau ligger hemmeligheden bag skakmønstre. I modsætning til andre effekter, vi har set, er fremkomsten af disse mønstre ikke en glitch. De er byggeklodserne i hele billedet. Hver linje i redaktøren indeholder præcis 64 tal, koefficienterne for den discrete cosine transform (DCT), der svarer til intensiteterne af 64 unikke mønstre.
Disse mønstre dannes baseret på kosinusgrafen. Sådan ser nogle af dem ud:
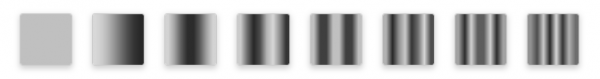
8 ud af 64 koefficienter
Nedenfor er et billede, der viser alle 64 mønstre.
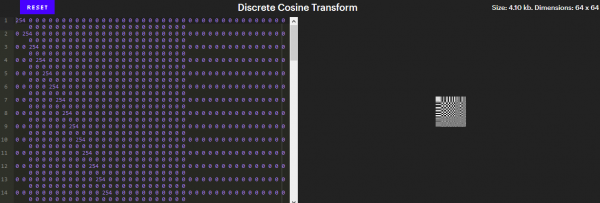
(The interactive version is in the artikler).
Disse mønstre har særlig betydning, da de danner basis for billeder i størrelse 8x8. Hvis du ikke er bekendt med lineær algebra, betyder det, at ethvert billede i størrelse 8x8 kan opnås fra disse 64 mønstre. DCT er en proces, hvor billeder opdeles i blokke af 8x8 og hver blok omdannes til en kombination af disse 64 koefficienter.
At ethvert billede kan bygges op af 64 bestemte mønstre synes at være magisk. Men det er det samme som at sige, at ethvert sted på Jorden kan beskrives med to tal – breddegrad og længdegrad [med angivelse af halvkuglerne / note fra oversætter]. Vi betragter ofte Jordens overflade som todimensional, hvorfor vi kun har brug for to tal. Et 8x8 billede har 64 dimensioner, så vi har brug for 64 tal.
Det er stadig uklart, hvordan dette hjælper os med hensyn til kompression. Hvis vi har brug for 64 tal for at repræsentere et 8x8 billede, hvorfor vil denne metode være bedre end blot at gemme 64 lysstyrkekomponenter? Vi gør dette af samme grund, som vi omdannede tre RGB-tal til tre YCbCr-tal: det giver os mulighed for at fjerne usynlige detaljer.
Det er svært at se, hvilke specifikke detaljer der fjernes på dette stadium, da JPEG anvender DCT på blokke af 8x8. Men intet forhindrer os i at anvende det på hele billedet. Sådan ser DCT ud for Y-komponenten anvendt på hele billedet:
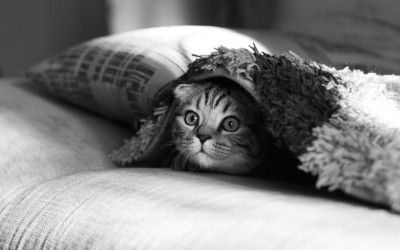
Fra slutningen kan man fjerne mere end 60.000 tal næsten uden nogen mærkbar ændring på billedet.
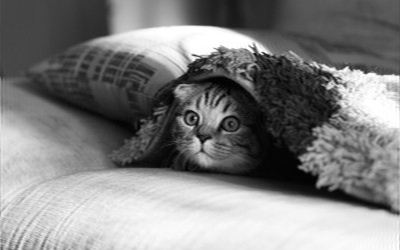
Men bemærk, at hvis vi nulstiller de første fem tal, vil forskellen være tydelig.
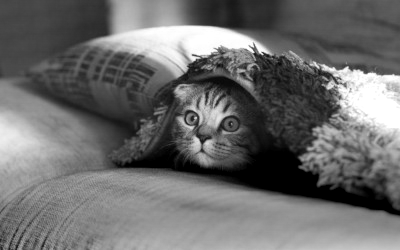
Tallene i begyndelsen angiver ændringer i lav frekvens i billedet, og vores øjne opfatter dem bedst. Tallene nær slutningen angiver ændringer i høj frekvens, som er sværere at bemærke. For at 'se det, der ikke kan ses med det blotte øje', kan vi isolere disse højfrekvente detaljer ved at nulstille de første 5000 tal.
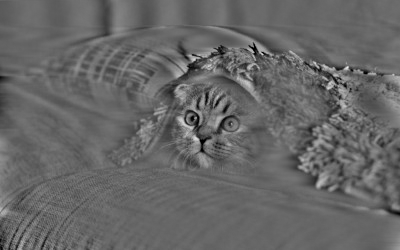
Vi ser alle områder af billedet, hvor der sker de største ændringer fra pixel til pixel. Katteøjnene, dens knurhår, det fluffy tæppe og skyggerne i nederste venstre hjørne fremhæves. Man kan gå endnu længere ved at nulstille de første 10.000 tal:
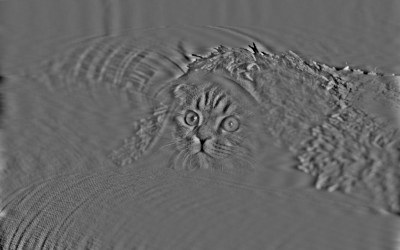
20 000:
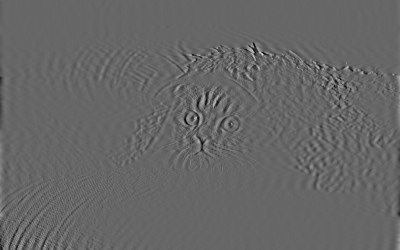
40 000:
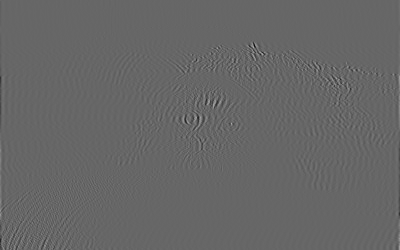
60 000:
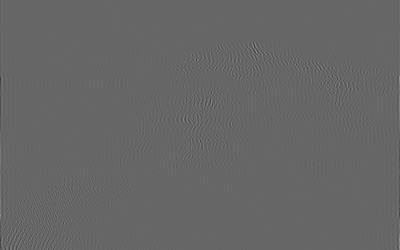
Disse højfrekvente detaljer fjernes i komprimeringsfasen. Farveomdannelse til DCT-koefficienter er tabsfri. Tab opstår i diskretiseringstrinnet, hvor høje frekvenser eller værdier tætte på nul fjernes. Når du sænker JPEG-billedkvaliteten, øger programmet tærsklen for antallet af fjernede værdier, hvilket resulterer i en mindre filstørrelse, men gør billedet mere pixeliseret. Derfor så billedet i første afsnit, der var 57 gange mindre, således ud. Hver 8x8 blok blev repræsenteret af et meget mindre antal DCT-koefficienter sammenlignet med en højere kvalitetsversion.
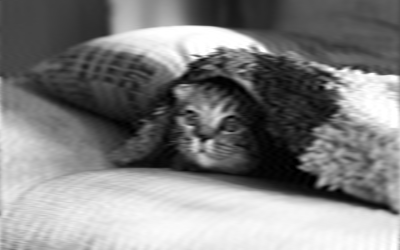
Du kan skabe en fantastisk effekt som gradvis streaming af billeder. Du kan vise et sløret billede, som bliver mere og mere detaljeret, efterhånden som flere koefficienter downloades.
Her, bare for sjov, hvad der sker, når der bruges kun 24.000 tal:
Eller kun 5000:
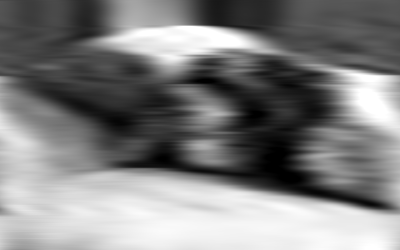
Meget sløret, men som om det er genkendeligt!
3. Længde-kodning, delta og Huffman
Indtil nu har alle komprimeringsfaser været med tab. Den sidste fase derimod er tabsfri. Den fjerner ikke information, men reducerer betydeligt filstørrelsen.
Hvordan kan man komprimere noget uden at kassere information? Forestil dig, hvordan vi ville beskrive et simpelt sort rektangel på 700 x 437.
JPEG bruger 5000 tal til dette, men der kan opnås meget bedre resultater. Kan du forestille dig en kodningsskema, der ville beskrive et sådant billede med så få bytes som muligt?
Den mindste skema, jeg kunne tænke mig, bruger fire: tre til at angive farven, og den fjerde til at angive, hvor mange pixels der har den farve. Ideen om at repræsentere gentagne værdier på en så komprimeret måde kaldes længde-kodning. Den er tabsfri, fordi vi kan genskabe de kodede data i deres oprindelige form.
Størrelsen på JPEG-filen med den sorte rektangel er meget større end 4 byte - husk, at kompression på DCT-niveau anvendes på blokke af 8x8 pixels. Derfor har vi brug for mindst én DCT-koefficient for hver 64 pixels. Vi har brug for en, fordi i stedet for at gemme én DCT-koefficient efterfulgt af 63 nuller, tillader langt kodning os at gemme ét tal og angive, at "alle de andre er nuller."
Delta-kodning er en teknik, hvor hver byte indeholder forskellen fra en eller anden værdi, ikke en absolut størrelse. Derfor ændrer redigering af bestemte bytes farven på alle de andre pixels. For eksempel, i stedet for at gemme
12 13 14 14 14 13 13 14
Vi kunne starte med 12, og så blot angive, hvor meget der skal lægges til eller trækkes fra for at få det næste tal. Og denne sekvens i delta-kodningen ser sådan ud:
12 1 1 0 0 -1 0 1
De transformerede data bliver ikke mindre end de oprindelige, men det er lettere at komprimere dem. Anvendelse af delta-kodning før langt kodning kan være en stor hjælp, samtidig med at det forbliver tabsfri kompression.
Delta-kodning er en af de få teknikker, der anvendes uden for 8x8 blokke. Blandt de 64 DCT-koefficienter er én blot en konstant bølgefunktion (ensfarvet). Den repræsenterer den gennemsnitlige lysstyrke af hver blok for lysstyrkekomponenterne, eller den gennemsnitlige blå nuance for Cb-komponenterne, osv. Den første værdi for hver DCT-blok kaldes DC-værdien, og hver DC-værdi gennemgår delta-kodning i forhold til de tidligere. Derfor vil en ændring i lysstyrken af den første blok påvirke alle blokke.
Der er et sidste spørgsmål: hvordan kan ændringen af et enkelt tal fuldstændig ødelægge hele billedet? Indtil videre har komprimeringsniveauerne ikke haft sådanne egenskaber. Svaret ligger i JPEG-headeren. De første 500 bytes indeholder metadata om billedet - bredde, højde, osv., og indtil vi har arbejdet med dem.
Uden header er det næsten umuligt (eller meget svært) at dekode JPEG. Det ville se ud, som om jeg forsøgte at beskrive et maleri for dig, og begyndte at finde på ord for at formidle mit indtryk. Beskrivelsen vil sandsynligvis være temmelig kondenseret, da jeg kan finde på ord med netop den betydning, jeg ønsker at overføre, men for alle andre giver de ikke mening.
Det lyder måske dumt, men det er præcis sådan, det fungerer. Hvert JPEG-billede komprimeres med koder, der er specifikke for det. Kodeordbogen gemmes i overskriften. Denne teknik kaldes "Huffman-kodning", og ordbogen er en Huffman-tabel. I overskriften er tabellen markeret med to bytes – 255 og derefter 196. Hver farvekomponent kan have sin egen tabel.
Ændringer i tabellerne vil have en radikal indvirkning på ethvert billede. Et godt eksempel er at ændre 1 til 12 på linje 15.
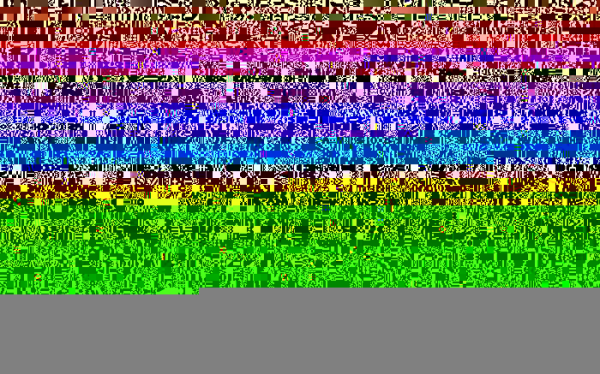
Dette sker, fordi tabellerne angiver, hvordan man skal læse de enkelte bits. Indtil nu har vi kun arbejdet med binære tal i decimalform. Men dette skjuler faktum, at hvis du vil gemme nummer 1 i en byte, så vil det se ud som 00000001, da der i hver byte skal være præcist otte bits, selvom du kun har brug for én af dem.
Dette kan potentielt være en stor pladsbesparelse, hvis du har mange små tal. Huffman-kodning er en teknik, der gør det muligt for os at lette dette krav om, at hvert tal skal være otte bits. Det betyder, at hvis du ser to bytes:
234 115
så kan det, afhængigt af Huffman-tabellen, være tre tal. For at udtrække dem skal du først opdele dem i individuelle bits:
11101010 01110011
Herefter refererer vi til tabellen for at forstå, hvordan de skal grupperes. For eksempel kan det være de første seks bits (111010) eller 58 i decimal, efterfulgt af fem bits (10011) eller 19, og endelig de sidste fire bits (0011) eller 3.
Derfor er det meget vanskeligt at forstå bytes på dette komprimeringsstadie. Bytes repræsenterer ikke det, de ser ud til. Jeg vil ikke gå ind i detaljerne om arbejdet med tabellen i denne artikel, men om dette emne på nettet .
Et af de interessante tricks, du kan gøre, når du kender dette, er at adskille overskriften fra JPEG'en og gemme den separat. I praksis vil det betyde, at kun du kan læse filen. Facebook gør dette for at reducere filerne endnu mere.
En anden ting, du kan gøre, er at ændre Huffman-tabellen en smule. For andre vil det se ud som et beskadiget billede. Og kun du vil kende den magiske løsning på at reparere det.
Lad os opsummere: hvad er nødvendigt for at dekode JPEG? Det er nødvendigt at:
- udtrække Huffman-tabel (tabeller) fra overskriften og dekode bits.
- Udtræk koefficienterne for det diskrete cosinus-transform for hver farve- og lyskomponent for hver 8x8 blok ved at udføre omvendte transformationer af løbende længdekodning og delta.
- Kombiner cosinus baseret på koefficienterne for at få pixelværdierne for hver 8x8 blok.
- Skalér farvekomponenterne, hvis der er blevet udført sub-sampling (denne information findes i headeren).
- Konverter de opnåede YCbCr-værdier for hver pixel til RGB.
- Vis billedet på skærmen!
Seriøs indsats for bare at se et billede af en kat! Men hvad jeg synes er interessant ved dette – er, hvor menneskevenlig JPEG-teknologien er. Den bygger på egenskaber ved vores opfattelse, hvilket muliggør en meget bedre kompression end traditionelle teknologier. Og nu, hvor jeg forstår, hvordan JPEG fungerer, kan jeg forestille mig, hvordan disse teknologier kan overføres til andre områder. For eksempel kan delta-kodning i video resultere i en betydelig reduktion af filstørrelsen, da der ofte er store områder, der ikke ændres fra ramme til ramme (for eksempel baggrunden).
, er åben og indeholder instruktioner til at erstatte billeder med dine egne.
Kilde: habr.com
