

Hej, Habr-folk. I dag starter undervisningen i den første gruppe af kurset . I den forbindelse vil vi gerne fortælle jer om, hvordan det åbne webinar om dette kursus forløb.
I talte vi om de udfordringer, SQL-databaser står overfor i cloud-æraen og Kubernetes. Samtidig så vi på, hvordan SQL-databaser tilpasser sig og muterer under indflydelse af disse udfordringer.
Webinaret blev ledet af , Google Cloud Practice Delivery Manager hos EPAM Systems.
Da træerne var små...
Lad os først huske, hvordan valget af DBMS begyndte i slutningen af det forrige århundrede. Det vil ikke være svært, for valget af DBMS dengang begyndte og sluttede ved Oracle.
I slutningen af 90'erne og begyndelsen af nullerne var der i realiteten ikke meget valg, når vi taler om industriskalerbare databaser. Ja, IBM DB2, Sybase og nogle andre databaser eksisterede og forsvandt, men generelt set var de ikke så synlige i forhold til Oracle. Derfor var ingeniørernes færdigheder på det tidspunkt på en eller anden måde knyttet til det eneste valg, der fandtes.
En Oracle DBA skulle kunne:
- installere Oracle Server fra distributionen;
- konfigurere Oracle Server:
- init.ora;
- listener.ora;
— oprette:
- tabelrum;
- skemaer;
- brugere;
— udføre backup og gendannelse;
— overvåge systemet;
— håndtere suboptimale forespørgsler.
Desuden blev der ikke krævet meget af Oracle DBA:
- kunne vælge den optimale DBMS eller anden teknologi til opbevaring og behandling af data;
- sikre høj tilgængelighed og horisontal skalerbarhed (det var ikke altid et spørgsmål for DBA);
- have en god viden om emneområdet, infrastruktur, anvendelsesmæssig arkitektur, OS;
- udføre indlæsning og udskrivning af data samt migrere data mellem forskellige DBMS.
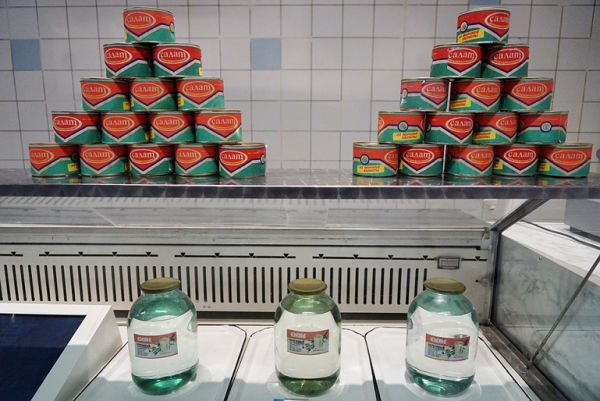
Hvis vi ser på valgprocessen dengang, minder det om at vælge i en sovjetisk butik i slutningen af 80'erne:
Vores tid
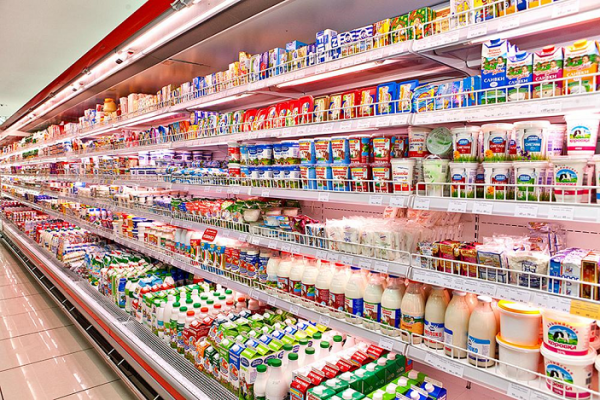
Siden da er træerne vokset, verden har ændret sig, og det ser nu sådan ud:
Markedet for DBMS har også ændret sig, hvilket fremgår klart af den seneste rapport fra Gartner:
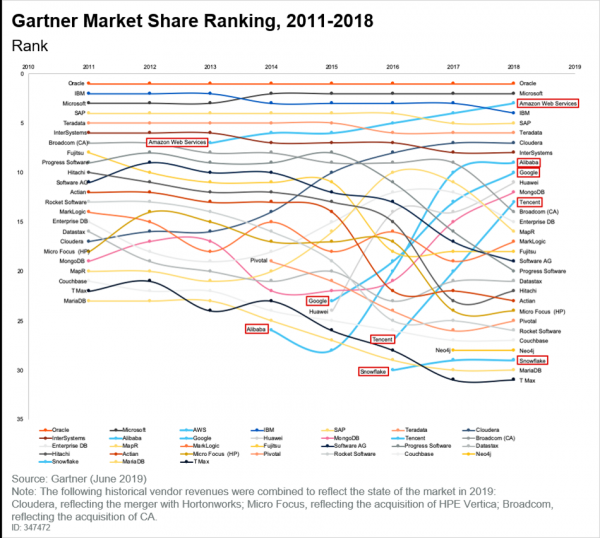
Det skal nævnes, at skyen har fået sin niche, og dens popularitet vokser. Hvis man læser den samme rapport fra Gartner, vil vi se følgende konklusioner:
- Mange kunder er på vej til at overføre applikationer til skyen.
- Nye teknologier dukker først op i skyen, og der er ikke nogen garanti for, at de nogensinde vil flytte til en ikke-skyinfrastruktur.
- Modellen for prisfastsættelse baseret på pay-as-you-go er blevet almindelig. Alle ønsker kun at betale for det, de bruger, og det er ikke længere en trend, men blot en konstatering af fakta.
Hvad nu?
I dag er vi alle i skyen. De spørgsmål, vi står over for, handler om valg. Og valgmulighederne er enorme, selv hvis vi kun taler om valg af databasesystemer i On-premises format. Desuden har vi managed services og SaaS. På denne måde bliver valget kun mere kompliceret år for år.
Sammen med valgmulighederne er der også begrænsende faktorer:
- pris. Mange teknologier koster stadig penge;
- færdigheder. Hvis vi taler om open source-software, opstår spørgsmålet om færdigheder, da gratis software kræver, at dem, der implementerer og driver den, har tilstrækkelig kompetence;
- funktionalitet. Ikke alle tjenester, der er tilgængelige i skyen og bygget, for eksempel på baggrund af den samme Postgres, har de samme funktioner som Postgres On-premises. Dette er en væsentlig faktor, som man skal kende og forstå. Desuden bliver denne faktor vigtigere end viden om skjulte muligheder ved et bestemt databasesystem.
Hvad forventer man nu fra DA/DE:
- god forståelse af fagområdet og anvendt arkitektur;
- evnen til korrekt at vælge den passende databasesystemteknologi i forhold til den stillede opgave;
- evnen til at vælge den optimale implementeringsmetode for den valgte teknologi i forhold til de eksisterende begrænsninger;
- evnen til at udføre dataoverførsel og migrering;
- evnen til at implementere og drive de valgte løsninger.
Det følgende eksempel på grundlag af GCP demonstrerer, hvordan valget af en bestemt datateknologi afhænger af deres struktur:
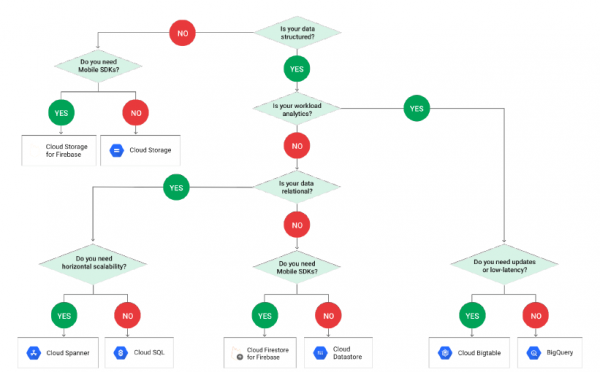
Bemærk, at PostgreSQL ikke er med i skemaet, da det skjuler sig bag terminologien Cloud SQL. Når vi kommer ind i Cloud SQL, skal vi igen træffe et valg:
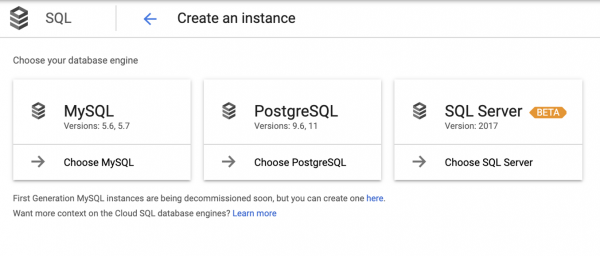
Det er værd at bemærke, at dette valg ikke altid er klart, og derfor styres applikationsudviklere ofte af deres intuition.
I alt:
- Jo længere man kommer, desto mere aktuelt bliver spørgsmålet om valg. Selv når man kun ser på GCP, forekommer der kun nogle nævnelser af RDBMS i trin 4 (og der er Spanner tæt ved). Desuden optræder valget af PostgreSQL først i trin 5, og der er endnu MySQL og SQL Server ved siden af, så der er meget at vælge imellem, men man skal vælge.
- Man bør ikke glemme begrænsningerne midt i fristelserne. For det meste ønsker alle Spanner, men det er dyrt. I sidste ende ser en typisk anmodning således ud: «Laver I venligst Spanner for prisen af Cloud SQL, I er jo fagfolk!»
Hvad skal man så gøre?
Uden at påstå at have den endelige sandhed, lad os sige følgende:
Man skal ændre tilgang til uddannelse:
- At lære som man gjorde før til DBA'er giver ikke mening;
- kendskab til ét produkt er nu ikke længere nok;
- og at kende mange på niveauet for ét er umuligt.
Man skal ikke kun vide om produktet, men også:
- brugsområdet for dets anvendelse;
- forskellige implementeringsmetoder;
- fordele og ulemper ved hver metode;
- analoge og alternative produkter for at træffe en informeret og optimal beslutning og ikke altid til fordel for et velkendt produkt.
Og så skal man kunne migrere data og forstå de grundlæggende principper for integration med ETL.
Reelt eksempel
For nylig skulle jeg lave backend til en mobilapplikation. På tidspunktet for arbejdet var backend allerede udviklet og klar til implementering, og udviklerteamet havde brugt cirka to år på dette projekt. Derudover blev der stillet følgende opgaver:
- at opbygge CI/CD;
- at foretage en arkitektur-review;
- at sætte det hele i drift.
Selve applikationen var mikrotjenestebaseret, og koden på Python/Django var blevet udviklet fra bunden og direkte i GCP. Hvad angår målgruppen, blev der antaget to regioner — USA og EU, og trafikken blev distribueret via Global Load balancer. Alle workloads og beregningsbelastning kørte i Google Kubernetes Engine.
Hvad angår dataene, var der 3 strukturer:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
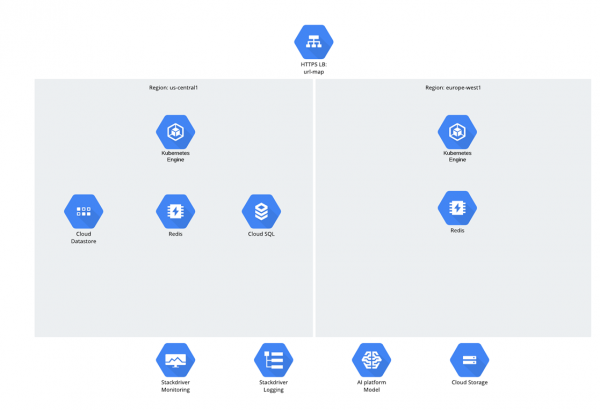
Man kan spørge, hvorfor Cloud SQL blev valgt? Sandheden er, at sådanne spørgsmål i de seneste år skaber en eller anden akavet pause — man får indtrykket af, at folk er blevet flove over relationelle databaser, men de fortsætter med at bruge dem aktivt ;-).
Hvad angår vores tilfælde, blev Cloud SQL valgt af følgende grunde:
- Som nævnt blev applikationen udviklet ved hjælp af Django, og den har en model, der viser permanente data fra SQL-databasen i Python-objekter (Django ORM).
- Selve rammeværket understøttede en ret afrundet liste over databasesystemer:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Derfor valgte vi PostgreSQL fra denne liste ret intuitivt (det var jo ikke Oracle, vi skulle vælge).
Hvad der manglede:
- applikationen var kun implementeret i 2 regioner, og der var planer om en 3. (Asien);
- Databasen var beliggende i det nordamerikanske område (Iowa);
- kunden havde bekymringer angående mulige forsinkelser med adgang fra Europa og Asien og afbrydelser i servicen i tilfælde af nedetid for databasen.
Selvom Django selv kan arbejde med flere databaser parallelt og opdele dem efter læsning og skrivning, var der ikke så mange skrivninger i applikationen (over 90% var læsning). Generelt, hvis vi kunne oprette en read-replica af hoveddatabasen i Europa og Asien, ville det være en kompromis-løsning. Hvad er der så svært ved det?
Kompleksiteten lå i, at kunden ikke ønskede at opgive brugen af managed services og Cloud SQL. Og mulighederne for Cloud SQL er i øjeblikket begrænsede. Cloud SQL understøtter høj tilgængelighed (HA) og read-replica (RR), men den samme RR understøttes kun i én region. Når databasen er oprettet i den amerikanske region, kan du ikke lave en read-replica i den europæiske region ved hjælp af Cloud SQL, selvom PostgreSQL i sig selv ikke forhindrer det. Korrespondancen med Googles medarbejdere førte ikke til noget og sluttede med løfter i stil med "vi kender problemet og arbejder på det, spørgsmålet vil blive løst en dag".
Hvis vi opregner mulighederne i Cloud SQL punktvis, ville det se nogenlunde sådan ud:
1. Høj tilgængelighed (HA):
- inden for én region;
- via diskreplikation;
- der bruges ikke PostgreSQL-mekanismer;
- automatiseret og manuel kontrol — failover/failback er muligt;
- ved skift er databasen utilgængelig i flere minutter.
2. Read Replica (RR):
- inden for én region;
- hot standby;
- PostgreSQL streaming replication.
Desuden står man, som det er sædvanligt, over for nogle begrænsninger:
- kunden ønskede ikke at skabe flere enheder og anvende IaaS, bortset fra via GKE;
- kunden ville ikke udrulle self service PostgreSQL/MySQL;
- Og generelt ville Google Spanner være en god løsning, hvis det ikke var for prisen, men med det kan Django ORM ikke arbejde; bortset fra det er det dog et glimrende produkt.
I betragtning af situationen kom der et spørgsmål fra kunden: «Kan I lave noget lignende, der fungerer som Google Spanner, men også virker med Django ORM?»
Løsningsmulighed nr. 0
Det første, der kom i tankerne:
- forblive inden for CloudSQL;
- der vil ikke være nogen indbygget replikation mellem regioner i nogen form;
- forsøge at tilføje en replika til den eksisterende Cloud SQL by PostgreSQL;
- starte en PostgreSQL-forekomst et sted, men i det mindste ikke røre master.
Desværre viste det sig, at det ikke kunne lade sig gøre, da der ikke er adgang til værten (den er overhovedet i et andet projekt) — pg_hba osv., og der er heller ikke adgang som superbruger.
Løsningsmulighed nr. 1
Efter nogle yderligere overvejelser og med hensyn til de tidligere omstændigheder ændrede tankerne sig lidt:
- vi forsøger stadig at holde os inden for CloudSQL, men vi skifter til MySQL, da Cloud SQL by MySQL har en ekstern master, der:
— fungerer som proxy for ekstern MySQL;
— ser ud som en MySQL-forekomst;
— er designet til at migrere data fra andre skyer eller On-premises.
Da opsætningen af MySQL-replikation ikke kræver adgang til værten, fungerede det i princippet, men var meget ustabilt og upraktisk. Og da vi gik videre, blev det endnu mere skræmmende, da vi oprettede hele strukturen med terraform, og hvad nu hvis det viste sig, at den eksterne master ikke understøttes af terraform. Ja, Google har en CLI, men af en eller anden grund fungerede det også kun sporadisk — nogle gange blev den oprettet, andre gange ikke. Måske fordi CLI'en blev designet til at migrere data udefra, ikke til replikering.
Faktisk blev det klart, at Cloud SQL slet ikke var passende. Som man siger, vi gjorde alt, hvad vi kunne.
Løsningsmulighed nr. 2
Da vi ikke kunne forblive inden for Cloud SQL, forsøgte vi at formulere kravene til et kompromisløsning. Kravene viste sig at være følgende:
- arbejde i Kubernetes, maksimere brugen af ressourcer og muligheder i Kubernetes (DCS, …) og GCP (LB, …);
- mangel på ballast fra en masse unødvendige ting i skyen såsom HA proxy;
- mulighed for at køre HA PostgreSQL eller MySQL i hovedregionen; i de øvrige regioner — HA fra RR i hovedregionen plus dens kopi (for pålidelighed);
- multi master (det var ikke noget, vi havde lyst til at beskæftige os med, men det var ikke så principielt)
.
Som resultat af disse krav dukkede der endelig pegnette DBMS- og bindemuligheder:
- MySQL Galera;
- CockroachDB;
- PostgreSQL værktøjer
:
— pgpool-II;
— Patroni.
MySQL Galera
MySQL Galera-teknologien er udviklet af Codership og er et plugin til InnoDB. Egenskaber:
- multi master;
- synchron replikation;
- læsning fra enhver node;
- skrivning til enhver node;
- indbygget HA-mekanisme;
- der er en Helm chart fra Bitnami.
CockroachDB
Ifølge beskrivelsen er det en fantastisk ting og repræsenterer et open source-projekt, skrevet i Go. Hovedaktøren er Cockroach Labs (grundlagt af folk fra Google). Denne relationelle DBMS er oprindeligt designet til at være distribueret (med horisontal skalerbarhed 'out of the box') og fejltolerant. Dens forfattere har sat sig for at 'kombinere rigdommen af SQL-funktionalitet med den horisontale tilgængelighed, der er typisk for NoSQL-løsninger'.
Som en behagelig bonus - støtte til PostgreSQL-forbindelsesprotokollen.
Pgpool
Dette er et lag ovenpå PostgreSQL, faktisk en ny entitet, der tager imod alle forbindelser og behandler dem. Har sin egen load balancer og parser, licenseret under BSD-licensen. Tilbyder store muligheder, men ser lidt skræmmende ud, da den nye enhed muligvis kunne være en kilde til yderligere eventyr.
Patroni
Dette var det sidste, jeg så på, og det viste sig at være berettiget. Patroni er et open source-værktøj, der i bund og grund fungerer som en daemon i Python, der automatisk håndterer PostgreSQL-klynger med forskellige typer replikation og automatisk rolleændring. Det viste sig at være meget interessant, da det godt integreres med Kubernetes og ikke medfører nogle nye enheder.
Hvad blev valgt til sidst
Valget var ikke let:
- CockroachDB — fantastisk, men skræmmende;
- MySQL Galera — også godt, bruges mange steder, men MySQL;
- Pgpool — mange unødvendige enheder, middelmådig integration med cloud og K8s;
- Patroni — fremragende integration med K8s, ingen unødvendige enheder, godt integreret med GCP LB.
Derfor blev valget Patroni.
Konklusioner
Det er tid til at opsummere kort. Ja, verden af IT-infrastruktur har ændret sig væsentligt, og dette er kun begyndelsen. Og hvis cloud tidligere kun var en anden type infrastruktur, så er det nu anderledes. Desuden dukker innovationer i cloud konstant op, og de vil fortsat gøre det, og muligvis vil de først dukke op i cloud og derefter, med hjælp fra startups, blive flyttet til On-premises.
Når det gælder SQL, vil SQL altid være relevant. Det betyder, at man skal have kendskab til PostgreSQL og MySQL og kunne arbejde med dem, men det er endnu vigtigere at vide, hvordan man anvender dem korrekt.
Kilde: habr.com
