

Det siges, at man skal prøve alt i livet mindst én gang. Hvis du er vant til at arbejde med relationelle databaser, er det værd at stifte bekendtskab med NoSQL i praksis, i det mindste for at få en generel forståelse. I takt med den hurtige udvikling af denne teknologi er der mange modstridende meninger og hede debatter om emnet, hvilket især vækker interessen.
Hvis man dykker ned i essensen af alle disse debatter, kan man se, at de opstår på grund af en forkert tilgang. De, der bruger NoSQL-databaser der, hvor de er nødvendige, er tilfredse og får alle fordelene ved denne løsning. Eksperimentatorer, der satser på denne teknologi som en kur mod alt, hvor den slet ikke er anvendelig, oplever skuffelse, da de mister de stærke sider ved relationelle databaser uden at opnå væsentlige fordele.
Jeg vil fortælle om vores erfaring med implementeringen af en løsning baseret på Cassandra-database: hvad vi stødte på, hvordan vi kom igennem svære situationer, om vi nåede at opnå fordele ved at bruge NoSQL, og hvor vi måtte investere ekstra ressourcer.
Den oprindelige opgave var at bygge et system til at optage opkald i et bestemt lager.
Systemets funktionsprincip er følgende. Der modtages filer med en bestemt struktur, der beskriver opkaldsstrukturen. Derefter sikrer applikationen, at denne struktur gemmes i de relevante kolonner. De gemte opkald bruges senere – til at vise forbrugsinformation for abonnenter (opkald, historie over saldo).
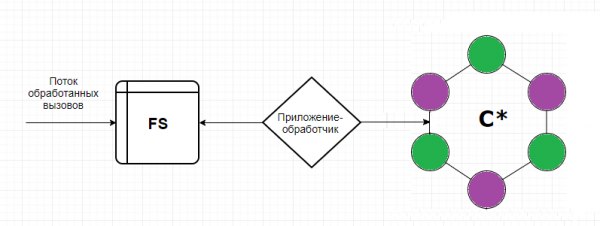
Hvorfor vi valgte Cassandra er helt forståeligt – den skriver som en maskingevær, er let at skalere, og er fejltolerant.
Så her er hvad erfaringen har givet os
Ja, en nedbrudt node er ikke en tragedie. Det er netop essensen af Cassandra’s fejltolerance. Men en node kan være i live og stadig begynde at falde i ydeevne.. Som det viste sig, afspejles dette straks i ydeevnen af hele klyngen.
Cassandra vil ikke beskytte der, hvor Oracle reddede med sine begrænsninger.. Og hvis applikationens forfatter ikke har indset dette på forhånd, er en duplikat for Cassandra ikke bedre end originalen. Kommer den, så indsætter vi den.
Den gratis Cassandra "ud af boksen" blev pludselig ikke populær blandt sikkerhedsafdelingen: der er ingen logføring af brugerhandlinger, heller ikke adskillelse af rettigheder.. Oplysninger om opkald vedrører personlige data, hvilket betyder, at alle forsøg på at anmode om eller ændre dem skal loggøres med mulighed for efterfølgende revision. Det er også vigtigt at forstå behovet for at opdele rettigheder på forskellige niveauer for forskellige brugere. En almindelig driftsingeniør og en superadministrator, der frit kan slette hele keyspace, har forskellige roller, ansvar og kompetence. Uden en sådan adskillelse af adgangen vil værdien og integriteten af data straks være under spørgsmålet, hurtigere end ved en konsistensniveau ANY.
Vi har ikke taget højde for, at opkaldene kræver både seriøs analyse og periodiske stikprøver under en bred vifte af betingelser. Da de udvalgte poster derefter skal slettes og overskrives (i rammerne af opgaven skal vi understøtte dataaktualiseringen ved oprindeligt forkert indkomne data til os), er Cassandra ikke vores ven her. Cassandra er som en sparebøsse – den er praktisk at gemme i, men man kan ikke tælle i den.
Vi står over for et problem med at overføre data til testzoner (5 noder i testen mod 20 i produktionen). Dump i så fald kan ikke anvendes.
Problemet med opdateringer af dataskemaet for applikationen, der skriver til Cassandra. Nedrulning vil skabe en stor mængde gravstene, hvilket uforudsigeligt kan sænke vores ydeevne. Cassandra er optimeret til skrivning, og før den skriver, tænker den ikke meget over det. Enhver operation med eksisterende data i den er også en skriveoperation. Dvs. ved at slette unødvendige poster, skaber vi bare endnu flere poster, og kun en del af dem vil blive markeret som gravsten.
Timeouts ved indsættelse. Cassandra er fantastisk til skrivning, men nogle gange kan den indkommende strøm forvirre den betydeligt. Dette sker, når applikationen begynder at cykle gennem flere poster, som ikke kan indsættes af en eller anden grund. Og vi får brug for en rigtig DBA, der vil overvåge gc.log, system- og debugloggerne med henblik på langsomme forespørgsler og målinger på compaction pending.
Flere datacentre i klyngen. Hvorfra skal der læses, og hvor skal der skrives?
Er det muligt at adskille læsning og skrivning? Og hvis ja, skal der så være en DC til skrivning eller læsning tættere på applikationen? Og kan vi ende med en rigtig split brain, hvis vi vælger en forkert konsistensniveau? Der er mange spørgsmål, mange uudforskede indstillinger og muligheder, som vi virkelig gerne vil eksperimentere med.
Hvordan løste vi det
For at forhindre, at noden falder, deaktiverede vi SWAP. Og nu, når der mangler hukommelse, skal noden gå ned i stedet for at skabe lange gc-pauser.
Så vi stoler ikke længere på logikken i databasen. Applikationsudviklerne genlærer og begynder aktivt at sikkerhedskopiere i deres egen kode. Ideel og klar opdeling af dataopbevaring og databehandling.
Vi købte support fra DataStax. Den pakke-baserede Cassandra udvikles ikke længere (sidste commit var i februar 2018). Samtidig tilbyder Datastax en fremragende service og et stort antal tilpassede og optimerede løsninger til eksisterende IT-systemer.
Jeg vil også bemærke, at Cassandra ikke er særlig praktisk til forespørgsler ved selection. Selvfølgelig er CQL et stort skridt i retning af brugerne (sammenlignet med Thrift). Men hvis du har hele afdelinger, der er vant til sådanne bekvemme joins, fri filtrering efter ethvert felt og optimeringsmuligheder for forespørgsler, og disse afdelinger arbejder på at lukke klager og problemer, så virker en løsning baseret på Cassandra fjendtlig og tåbelig for dem. Og vi begyndte at finde ud af, hvordan vores kolleger kunne lave selectioner.
Vi overvejede to muligheder. I den første mulighed skriver vi kald ikke kun til C*, men også til den arkiverede Oracle-database. Men i modsætning til C* gemmes kald kun for den nuværende måned i denne database (tilstrækkelig lagringsdybde for kald til omprissætnings tilfælde). Her kunne jeg straks se det følgende problem: hvis vi skriver synkront, mister vi alle fordelene ved C*, som er relateret til hurtig indsættelse; hvis asynkront – er der ingen garanti for, at alle nødvendige kald overhovedet havnede i Oracle. Der var en fordel, men stor: til drift forbliver den samme velkendte PL/SQL Developer, dvs. vi kan praktisk talt implementere mønsteret 'Fasade'. Alternativ mulighed. Vi implementerer en mekanisme, som eksporterer kald fra C*, henter nogle data til berigelse fra de relevante tabeller i Oracle, samler de indhentede udtag og giver os det endelige resultat, som vi så bruger på en eller anden måde (ruller tilbage, gentager, analyserer, beundrer). Ulemper: processen bliver temmelig flertrins, og derudover mangler der et interface for driftspersonalet.
I sidste ende stoppede vi alligevel ved den anden mulighed. Til udtræk fra forskellige databaser brugte vi Apache Spark. Essensen af mekanismen er reduceret til Java-kode, som ved hjælp af angivne nøgler (abonent, tidspunkt for opkald – nøgler i sektionen) trækker data ud fra C*, samt de nødvendige data til berigelse fra enhver anden database. Derefter samler den dem i sin hukommelse og outputter resultatet til en resultat tabel. Vi tegnede en web-grænseflade over Spark, og det viste sig at være ganske egnet til drift.
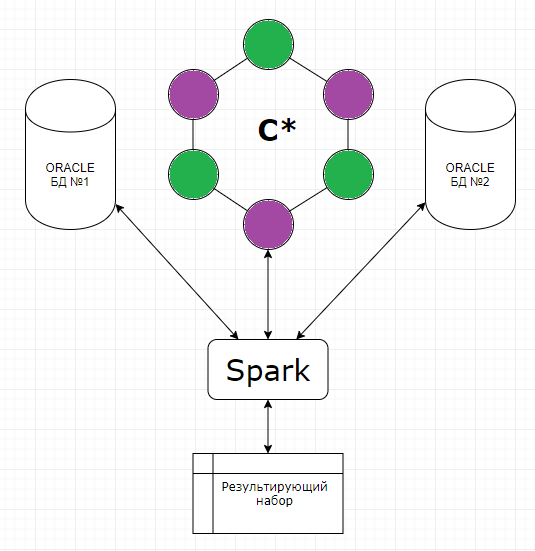
I arbejdet med opdateringen af data, overvejede vi igen flere løsninger. Både flytning via Sstloader og muligheden for at opdele klyngen i testområdet i to dele, hvor hver del skiftevis tilslutter sig den ene produktionsklynge og derved får strøm derfra. Under opdateringen var det planlagt at bytte dem om: den del, der arbejdede i testen, skulle ryddes og introduceres i produktion, mens den anden begynder at arbejde med data separat. Men efter at have tænkt over det igen, vurderede vi mere rationelt, hvilke data der er værd at flytte, og indså, at disse kald i sig selv er en inkonsistent enhed til tests, der hurtigt kan genereres ved behov, og at den produktionssættede datamængde ikke har værdi til flytning til test. Der er flere lagerobjekter, som er værd at flytte, men det er bogstaveligt talt et par tabeller, der ikke er så tunge. Derfor Blev Spark igen en hjælpsom løsning, hvor vi skrev og aktivt brugte et script til at overføre data mellem tabellerne i produktions-test.
Vores nuværende deploymentspolitik tillader os at arbejde uden tilbagekaldelser. Før produktionen er der obligatorisk udrulning til test, hvor fejlen ikke er så kostbar. I tilfælde af fejl kan vi altid droppe keyspace og udrulle hele skemaet fra starten.
For at sikre uafbrudt tilgængelighed af Cassandra er der behov for en DBA, men ikke kun ham. Alle, der arbejder med applikationen, skal forstå, hvor og hvordan man ser den aktuelle situation samt hvordan man rettidigt diagnosticerer problemer. Til dette bruger vi aktivt DataStax OpsCenter (Administration og overvågning af arbejdsbelastninger), systemmetrikker fra Cassandra-driveren (antal timeouts ved skrivning til C*, antal timeouts ved læsning fra C*, maksimal latency osv.), og monitorerer selve applikationens arbejde, der arbejder med Cassandra.
Da vi tænkte over det tidligere spørgsmål, indså vi, hvor vores hovedrisiko kunne ligge. Det er - formerne for datavisualisering, der trækker data fra flere uafhængige forespørgsler til lageret. På den måde kan vi få ret usammenhængende information. Men dette problem ville også være aktuelt, hvis vi kun arbejdede med et datacenter. Så det mest fornuftige her er selvfølgelig at lave en batch-funktion til datalæsning i en ekstern applikation, som sikrer, at data indhentes på én gang. Hvad angår adskillelsen mellem læsning og skrivning i forhold til ydeevne, så stoppede vi her, fordi risikoen for, at vi ved et mistet forbindelsesmellem DС kunne få to fuldstændig usammenhængende klynger.
I sidste ende, på nuværende tidspunkt har vi valgt konsistensniveauet for skrivning til EACH_QUORUM, og for læsning - LOCAL_QUORUM
Korte indtryk og konklusioner
For at vurdere den opnåede løsning med hensyn til driftsupport og fremtidige udviklingsmuligheder, besluttede vi at overveje, hvor vi ellers kunne anvende en sådan udvikling.
Hvis vi skal være hurtige, så datascoring for programmer af typen „Betal, når det passer dig“ (vi indlæsser information i S*, beregner med Spark-scripts), håndtering af klager med aggregering efter retninger, opbevaring af roller og beregning efter rollens matrix for brugeradgangsrettigheder.
Som vi kan se, er repertoiret bredt og varieret. Og hvis vi skal vælge side blandt fortalere/imodstandere af NoSQL, så vil vi tilslutte os tilhængerne, da vi har fået vores fordele, og netop der, hvor vi forventede det.
Selv Cassandra-versionen ud af boksen tillader horisontal skalering i realtid, hvilket løser spørgsmålet om at øge dataene i systemet helt smertefrit. Vi har formået at isolere en meget højt belastet mekanisme til beregning af aggregater baseret på opkald, samt at adskille skemaet og logikken i applikationen, hvilket har befriet os for den skadelige praksis med at skrive skræddersyede jobs og objekter i selve databasen. Vi har fået mulighed for at vælge og tilpasse, hvor vi vil udføre beregninger, og hvor vi vil skrive data, og vi har sikret os mod nedbrud af både enkelte noder og datacenteret generelt.
Når vi anvender vores arkitektur på nye projekter, og allerede besidder en vis erfaring, vil vi straks tage de nævnte nuancer i betragtning og undgå nogle fejl for at glatte de spidse kanter, som vi oprindeligt ikke kunne undgå.
For eksempel, følges op på opdateringerne af Cassandra i tide, fordi mange af de problemer, vi fik, allerede var kendte og blev rettet.
Ikke at placere både databasen og Spark på de samme noder (eller strengt adskille efter antallet af tilladte ressourceforbrug), da Spark kan bruge mere RAM end tilladt, og vi hurtigt vil få problem nummer 1 fra vores liste.
At forbedre overvågningen og driftskompetencen allerede i testfasen af projektet. Oprindeligt at tage højde for så mange potentielle brugere af vores løsning som muligt, fordi det i sidste ende vil bestemme strukturen af databasen.
At gennemgå den resulterende skema flere gange med henblik på mulig optimering. At identificere hvilke felter der kan serialiseres. At forstå hvilke ekstra tabeller vi skal lave for bedst og mest optimalt at tage højde for og derefter returnere den nødvendige information (for eksempel ved at acceptere, at de samme data kan gemmes i forskellige tabeller med forskellige opdelinger efter forskellige kriterier, kan vi væsentligt spare på procesortiden ved læseforespørgsler).
Det er ikke dårligt at planlægge TTL og oprydning af forældede data fra starten.
Når data eksporteres fra Cassandra bør applikationens logik fungere efter princippet FETCH, så ikke alle rækker bliver indlæst i hukommelsen på én gang, men vælges i batches.
Det er ønskeligt at kontrollere systemets fejltolerance, inden projektet overføres til den beskrevne løsning ved at udføre en række crash-tests, som f.eks. datatab i et datacenter, genopretning af beskadigede data over en given periode, netværksnedbrud mellem datacentre. Sådanne tests vil ikke kun evaluere fordele og ulemper ved den foreslåede arkitektur, men også give en god opvarmningspraksis til de ingeniører, der udfører dem, og den opnåede færdighed vil bestemt ikke være overflødig, hvis systemfejl opstår i produktionen.
Hvis vi arbejder med kritisk information (såsom data til fakturering, beregning af abonnementsrestancer), er det også vigtigt at overveje værktøjer, der kan reducere risici, der opstår på grund af databasenes særlige karakteristika. For eksempel at bruge værktøjet nodesync (Datastax) og udvikle en optimal strategi for dets anvendelse, så man for konsistens ikke skaber en overflødig belastning på Cassandra og kun anvende det til bestemte tabeller i bestemte perioder.
Hvordan står det til efter et halvt år med Cassandra? Generelt er der ikke uløste problemer. Vi har heller ikke haft alvorlige nedbrud eller datatab. Ja, vi måtte tænke på at kompensere for nogle problemer, der ikke tidligere fandtes, men det påvirkede ikke vores arkitektoniske beslutning i nævneværdig grad. Hvis du ønsker at prøve noget nyt og ikke er bange for det, men samtidig ikke vil blive alt for skuffet, så vær forberedt på, at der ikke er noget gratis. Du må bruge mere tid på at undersøge, sætte dig ind i dokumentationen og samle din egen erfaring end med det gamle legacy-system, og ingen teori kan på forhånd fortælle dig, hvilke specifikke udfordringer der venter dig.
Kilde: habr.com
