

Mange står over for Elasticsearch. Men hvad sker der, når man ønsker at opbevare logs "i en særligt stor mængde"? Uden smerte at overvinde fejlen i et af flere datacentre? Hvilken arkitektur bør man vælge, og hvilke fælder skal man være opmærksom på?
Vi i Odnoklassniki har besluttet at løse log-management-udfordringen med Elasticsearch, og nu deler vi vores erfaring med Habra: både om arkitektur og om faldgruber.
Jeg er Pyotr Zaitsev, arbejder som systemadministrator hos Odnoklassniki. Tidligere var jeg også administrator, arbejdede med Manticore Search, Sphinx Search, Elasticsearch. Det er muligt, at hvis der kommer en anden ...search, så vil jeg sikkert arbejde med det også. Jeg deltager også i en række open source-projekter på frivillig basis.
Da jeg kom til Odnoklassniki, sagde jeg uovervejet til interviewet, at jeg kunne arbejde med Elasticsearch. Efter jeg havde vænnet mig til det og lavet nogle enkle opgaver, fik jeg tildelt en stor opgave omkring reformering af log-management-systemet, som eksisterede på det tidspunkt.
Krav
Kravene til systemet blev formuleret på følgende måde:
- Som frontend skulle Graylog anvendes. Fordi virksomheden allerede havde erfaring med dette produkt, var programmører og testere bekendte med det, og det var komfortabelt for dem.
- Data volumen: i gennemsnit 50-80 tusinde meddelelser i sekundet, men hvis noget går galt, så er trafik ikke begrænset, det kan være 2-3 millioner linjer i sekundet.
- Efter at have diskuteret kravene til behandlingstiden for søgeforespørgsler med kunderne, indså vi, at det typiske brugsmønster for et sådant system er, at folk søger logs fra deres applikation over de sidste to dage og ikke vil vente mere end et sekund på resultatet af deres forespørgsel.
- Administratorerne insisterede på, at systemet nemt skulle kunne skaleres, om nødvendigt, uden at det kræver dybdegående indsigt i, hvordan det fungerer.
- Den eneste vedligeholdelsesopgave, som disse systemer krævede jævnligt, var at skifte noget hardware.
- Derudover har Odnoklassniki en fremragende teknisk tradition: enhver service, vi lancerer, skal kunne overleve et datacentrets nedbrud (uforudset, ikke-planlagt og når som helst).
Det seneste krav i implementeringen af dette projekt har givet os de største udfordringer, som jeg vil fortælle mere om senere.
Miljø
Vi arbejder i fire datacentre, men Elasticsearch-datanoder kan kun være placeret i tre (af en række ikke-tekniske grunde).
I disse fire datacentre findes der omkring 18.000 forskellige logkilder – hardware, containere, virtuelle maskiner.
En vigtig funktion: klusteret startes i containere ikke på fysiske maskiner, men på . Containerne garanteres 2 kerner, svarende til 2.0Ghz v4, med mulighed for at udnytte de øvrige kerner, hvis de står stille.
Med andre ord:
Topologi
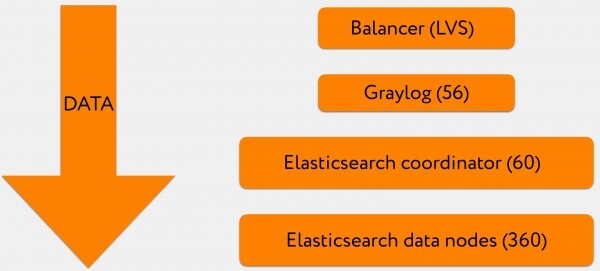
Den samlede løsning så jeg oprindeligt således:
- 3-4 VIP'er står bag A-recorden for domænet Graylog, som er adressen, hvor loggene sendes.
- hver VIP fungerer som en LVS-balance.
- Derefter lander loggene på en Graylog-batteri, hvor noget data sendes i GELF-format, mens andet sendes i syslog-format.
- Derefter skrives alt dette i store batches til en batteri af Elasticsearch-koordinatorer.
- Og de sender forespørgsler om skrivning og læsning til de relevante datanoder.
Terminologi
Måske er ikke alle bekendt med terminologien, så jeg vil gerne tage et øjeblik til at gennemgå den.
Der findes flere typer noder i Elasticsearch – master-, koordinator- og datanode. Der er også to andre typer til forskellige transformationer af logs og til forbindelse mellem forskellige klustre, men vi har kun brugt de nævnte.
Master
Pinger alle noder i klustret, opretholder et opdateret kort over klustret og distribuerer det mellem noderne, håndterer events logik og udfører en række forskellige cluster-brede opgaver.
Koordinator
Udfører én opgave: modtager forespørgsler fra klienter om læsning eller skrivning og ruter denne trafik. Hvis det er en skriveforespørgsel, vil den sandsynligvis spørge masteren, hvilken shard fra den relevante indeks den skal placere denne i, og videresende forespørgslen derfra.
Datanode
Opbevarer data, udfører søgeforespørgsler fra eksterne kilder, og operationer på de shards, som den har.
Graylog
Dette er noget i stil med en sammensmeltning af Kibana med Logstash i ELK-stakken. Graylog kombinerer både UI og logbehandlingspipeline. Under hjelmen i Graylog arbejder Kafka og Zookeeper, som sikrer sammenhængen af Graylog som et cluster. Graylog kan cache logs (Kafka) i tilfælde af, at Elasticsearch ikke er tilgængelig, og gentage mislykkedes læse- og skriveanmodninger, gruppere og mærke logs i henhold til fastsatte regler. Ligesom Logstash har Graylog funktionalitet til at modificere strenge, før de skrives til Elasticsearch.
Derudover har Graylog en indbygget service discovery, der gør det muligt, baseret på en tilgængelig node af Elasticsearch, at få hele kortet af clustret og filtrere det efter et bestemt tag, hvilket giver mulighed for at dirigere forespørgsler til bestemte containere.
Visuelt ser det omtrent sådan ud:

Dette er et screenshot fra en specifik instans. Her bygger vi et histogram baseret på en søgeforespørgsel og viser relevante strenge.
Indekser
Når vi vender tilbage til systemarkitekturen, vil jeg gerne fokusere på, hvordan vi byggede indekseringsmodellen, så alt dette fungerer korrekt.
I det tidligere diagram er dette det laveste niveau: Elasticsearch data noder.
Et indeks er en stor virtuel enhed, der består af shards af Elasticsearch. Hver af shards er i sig selv blot en Lucene-indeks. Og hver Lucene-indeks består igen af et eller flere segmenter.
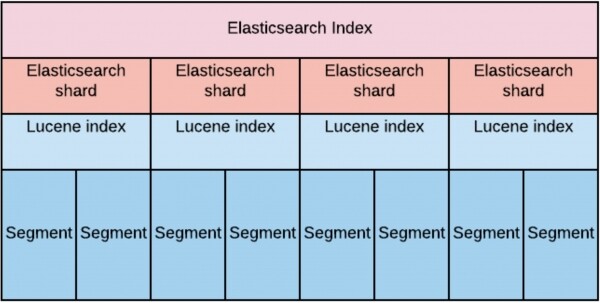
Ved designet overvejede vi, at for at opfylde kravene til læsehastighed ved store datamængder, var vi nødt til jævnt at "fordele" disse data over datanoderne.
Dette førte til, at antallet af shards på et indeks (med replika) skulle være strengt lig med antallet af datanoder. For det første for at sikre en replication factor lig med to (dvs. vi kan miste halvdelen af clustret). For det andet for at behandle læse- og skriveforespørgsler på mindst halvdelen af clustret.
Opbevaringstiden blev først fastsat til 30 dage.
Fordelingen af shards kan repræsenteres grafisk på følgende måde:
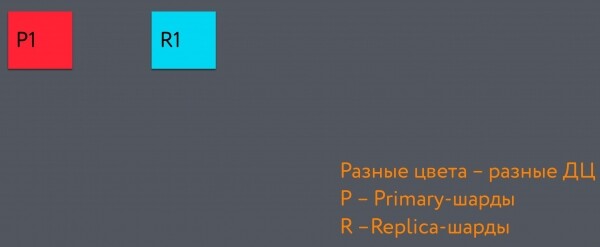
Hele den mørkegrå rektangel er indekset. Den venstre røde firkant i den er primary shard, den første i indekset. Og den blå firkant er replica shard. De ligger i forskellige datacentre.
Når vi tilføjer endnu en shard, ender den i det tredje datacenter. Og i sidste ende får vi sådan en struktur, der muliggør tab af et datacenter uden tab af datakonsistens:
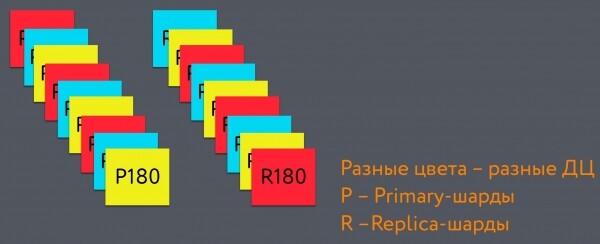
Vi har sat roteringen af indekser, dvs. oprettelsen af et nyt indeks og sletningen af det ældste, til 48 timer (baseret på mønsteret for indeksbrug: de seneste 48 timer søges der oftest).
Denne rotationsinterval for indekserne skyldes følgende grunde:
Når en søgeforespørgsel lander på en bestemt data-node, er det, med hensyn til ydeevne, mere fordelagtigt, at der forespørges på én shard, hvis dens størrelse svarer til størrelsen af node-hukommelsen. Dette gør det muligt at holde den "varme" del af indekset i hukommelsen og hurtigt få adgang til den. Når der bliver mange "varme dele", forringes hastigheden af søgningen i indekset.
Når en node begynder at udføre en søgeforespørgsel på en shard, tildeler den et antal tråde svarende til antallet af hyper-tråde på den fysiske maskine. Hvis søgeforespørgslen berører mange shards, stiger antallet af tråde proportionalt. Dette påvirker søgehastigheden negativt og påvirker indeksering af nye data.
For at sikre den nødvendige søgehastighed besluttede vi at bruge SSD. For hurtig behandling af forespørgsler skulle de maskiner, der blev brugt til disse containere, have mindst 56 kerner. Tallet 56 er valgt som en betinget tilstrækkelig størrelse, der bestemmer antallet af tråde, som Elasticsearch vil skabe under drift. I Elasticsearch afhænger mange parametre for thread pool direkte af antallet af tilgængelige kerner, hvilket direkte påvirker det nødvendige antal noder i klyngen efter princippet "mindre kerner — flere noder".
I sidste ende viste det sig, at en shard vejer omkring 20 gigabyte i gennemsnit, og der er 360 shards pr. indeks. Hvis vi roterer dem hver 48 timer, har vi 15 stykker. Hvert indeks rummer data for 2 dage.
Skrive- og læseskemaer for data
Lad os se på, hvordan data skrives i dette system.
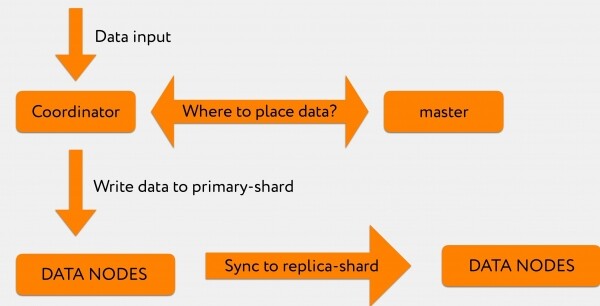
Antag, at vi modtager en anmodning fra Graylog til koordinatoren. For eksempel ønsker vi at indeksere 2-3 tusinde rækker.
Koordinatoren, der modtog en forespørgsel fra Graylog, spørger masteren: "I indeksningsforespørgslen blev vi konkret angivet en indeks, men det er ikke angivet, hvilken shard dette skal skrives til."
Masteren svarer: "Skriv denne information i shard nummer 71," hvorefter den sendes direkte til den relevante data-node, hvor primary-shard nummer 71 er placeret.
Herefter replikeres transaktionsloggen til replica-shard, som allerede er i et andet datacenter.
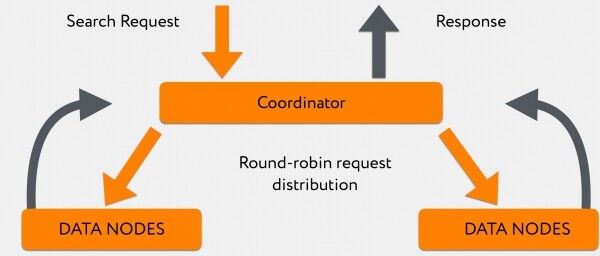
Fra Graylog ankommer en søgeforespørgsel til koordinatoren. Koordinatoren videresender den baseret på indekset, mens Elasticsearch fordeler forespørgslerne mellem primary-shard og replica-shard efter round-robin princippet.
De 180 noder svarer ujævnt, og mens de svarer, opsamler koordinatoren information, som allerede er 'spyttet ud' af hurtigere data-noder. Når enten al information er modtaget, eller timeout for forespørgslen er nået, returneres alt direkte til klienten.
Hele dette system behandler i gennemsnit søgeforespørgsler fra de seneste 48 timer på 300-400 ms, undtagen de forespørgsler, der har leading wildcard.
"Blomsterne" fra Elasticsearch: konfiguration af Java
For at alt dette kunne fungere som vi oprindeligt ønskede, brugte vi meget tid på at justere forskellige aspekter i klusteret.
Den første del af de problemer, vi opdagede, var relateret til, hvordan Java som standard er forudindstillet i Elasticsearch.
Problem nummer ét
Vi observerede et meget stort antal meddelelser om, at vi på Lucene-niveau, når background job'ene kørte, blev fusioneringer af Lucene-segmenter afsluttet med fejl. Logfilerne viste, at dette var en OutOfMemoryError. Gennem telemetri kunne vi se, at heapen var ledig, og det var uklart, hvorfor denne operation fejlede.
Det viste sig, at fusionerne af Lucene-indekser skete uden for heapen. Og containerne var ret strengt begrænset i de ressourcer, de kunne bruge. I disse ressourcer fik kun heap plads (heap.size var omtrent lig RAM), mens nogle off-heap operationer fejlede med en hukommelsesallokeringsfejl, hvis de af en eller anden grund ikke kunne holde sig inden for de ~500MB, som var tilbage til grænsen.
Løsningen var ret triviel: mængden af RAM tilgængelig for containeren blev forøget, hvorefter vi glemte, at vi overhovedet havde sådanne problemer.
Problem nummer to
Fire til fem dage efter opstarten af klusteret bemærkede vi, at data-noder periodisk begyndte at falde ud af klusteret og derefter komme ind igen efter cirka 10-20 sekunder.
Da vi begyndte at undersøge sagen, viste det sig, at denne såkaldte off-heap hukommelse i Elasticsearch næsten ikke bliver kontrolleret. Da vi tildelte containeren mere hukommelse, fik vi mulighed for at fylde direkte bufferpuljer med forskellige oplysninger, og de blev kun renset, når explicit GC fra Elasticsearch blev udløst.
I nogle tilfælde tog denne operation ret lang tid, og i mellemtiden nåede klyngen at markere denne node som allerede ude. Dette problem er godt beskrevet .
Løsningen var som følger: Vi begrænsede Java's evne til at bruge størstedelen af hukommelsen uden for heap til disse operationer. Vi satte den til 16 gigabyte (-XX:MaxDirectMemorySize=16g), hvilket resulterede i, at explicit GC blev kaldt betydeligt oftere og arbejdede meget hurtigere, hvilket stoppede destabilisering af klyngen.
Problem tre
Hvis du tror, at problemerne med "noder, der forlader klyngen i de mest uventede øjeblikke" er slut, tager du fejl.
Da vi konfigurerede arbejdet med indeksene, valgte vi mmapfs for at på friske shards med høj segmentering. Dette var en ret grov fejl, fordi ved brug af mmapfs bliver filen kortlagt ind i hukommelsen, og derefter arbejder vi allerede med den kortlagte fil. Dette betyder, at ved forsøg på GC at stoppe tråde i applikationen, tager det os meget lang tid at nå safepoint, og undervejs stopper applikationen med at svare på masterens forespørgsler om, hvorvidt det er live. Derfor antager masteren, at noden ikke længere er til stede i klyngen. Efter omkring 5-10 sekunder arbejder garbage collector, noden genopstår, genoptager forbindelsen til klyngen og begynder at initialisere shards. Alt dette mindede meget om "den produktion, vi fortjente" og egner sig ikke til noget seriøst.
For at slippe af med en sådan adfærd skiftede vi først til standard niofs, og derefter, da vi migrerede fra 5. versioner af Elastic til 6. versioner, prøvede vi hybridfs, hvor dette problem ikke opstod. Du kan læse mere om typerne af storage .
Problem fire
Derefter var der endnu et meget interessant problem, som vi behandlede i rekorden lang tid. Vi jagede det i 2-3 måneder, fordi mønsteret var fuldstændig uklart.
Nogle gange gik vores koordinatorer ind i Full GC, normalt et sted efter frokost, og kom aldrig tilbage derfra. Når vi loggede GC-forsinkelser, så det således ud: alt gik godt, godt, godt, og pludselig blev alt skarpt dårligt.
Først troede vi, at vi havde en ond bruger, der startede en forespørgsel, der fik koordinatoren til at gå ud af driftsmode. Vi loggede meget længe forespørgsler for at finde ud af, hvad der skete.
Det viste sig, at på det tidspunkt, hvor en bruger starter en meget stor forespørgsel, og den rammer en bestemt Elasticsearch koordinator, svarer nogle noder langsommere end andre.
Og den tid, det tager koordinatoren at vente på svar fra alle noder, akkumulerer han resultaterne, der er sendt fra allerede besvarede noder. For GC betyder det, at vores brugsmønster for heapen ændrer sig meget hurtigt. Den GC, vi brugte, kunne ikke håndtere denne opgave.
Den eneste løsning, vi fandt for at ændre klusterets adfærd i en sådan situation, var migration til JDK13 og brug af affaldssamleren Shenandoah. Det løste problemet, og vores koordinatorer holdt op med at falde.
På dette punkt sluttede problemerne med Java, og problemerne med båndbredde begyndte.
«Bær» med Elasticsearch: båndbredde
Problemer med båndbredde betyder, at vores kluster fungerer stabilt, men ved spidser af antallet af indekserede dokumenter og i manøvrer er ydeevnen utilstrækkelig.
Det første symptom, vi mødte: ved nogle «eksplosioner» i produktionen, når der pludselig genereres en meget stor mængde logs, begynder Graylog ofte at vise fejlen indexing es_rejected_execution.
Dette skete, fordi thread_pool.write.queue på en datanode, før Elasticsearch kan behandle forespørgslen om indeksering og sende oplysninger til shard på disk, som standard kun kan cache 200 forespørgsler. Og i siger meget lidt om denne parameter. Der angives kun det maksimale antal tråde og standardstørrelsen.
Selvfølgelig gik vi til at justere denne værdi og fandt følgende: specifikt i vores opsætning kan der caches ret godt op til 300 forespørgsler, mens en større værdi vil føre til, at vi igen havner i Full GC.
Desuden, da dette er beskeder, der modtages i én enkelt forespørgsel, var det også nødvendigt at justere Graylog, så den ikke skriver ofte og i små batcher, men i store batcher eller én gang hvert 3. sekund, hvis batchen stadig ikke er fuld. I så fald betyder det, at de oplysninger, vi skriver til Elasticsearch, bliver tilgængelige ikke efter to sekunder, men efter fem (hvilket vi er tilfredse med), men antallet af retries, der skal gøres for at skubbe en stor mængde information, reduceres.
Dette er især vigtigt i de øjeblikke, hvor noget er faldet et sted, og det gør os opmærksom på det, for at undgå at få fuldstændig spammet Elastic, og efter noget tid — ikke-fungerende noder i Graylog på grund af fyldte buffere.
Desuden, da vi oplevede disse eksplosioner i produktionen, modtog vi klager fra programmører og testere: i det øjeblik, hvor de meget havde brug for disse logs, blev de givet til dem meget langsomt.
Vi begyndte at undersøge sagen. På den ene side var det klart, at både søgeforespørgsler og indlæsningsanmodninger blev behandlet på stort set de samme fysiske maskiner, og der ville være bestemte nedgange under alle omstændigheder.
Men dette kunne delvist omgås ved, at der i sjette version af Elasticsearch kom en algoritme, som gør det muligt at fordele forespørgsler mellem relevante data-noder ikke efter tilfældig round-robin-princip (containere, der beskæftiger sig med indeksering og har primary-shard, kan være meget belastede, og der vil ikke være mulighed for hurtigt at svare), men at dirigere denne forespørgsel til en mindre belastet container med replica-shard, som vil svare betydeligt hurtigere. Med andre ord kom vi til use_adaptive_replica_selection: true.
Billedet af læsningen begynder at se således ud:
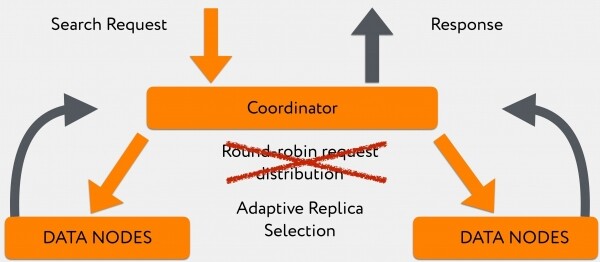
Overgangen til denne algoritme har betydeligt forbedret forespørgselstiden i de øjeblikke, hvor vi havde en stor strøm af logs til skrivning.
Endelig var det primære problem at afslutte data-centret smertefrit.
Hvad vi ønskede fra klyngen lige efter tabet af forbindelsen til et datacenter:
- Hvis vores nuværende master befinder sig i det afbrudte datacenter, vil den blive genvalgt og flytte sin rolle til en anden node i et andet datacenter.
- Masteren vil hurtigt fjerne alle utilgængelige noder fra klyngen.
- Baseret på de resterende vil han forstå: i det tabte datacenter havde vi sådanne primary shards, hurtigt promoverer komplementære replica shards i de resterende datacentre, og vi vil fortsætte med at indeksere dataene.
- Som et resultat heraf vil vores båndbredde i klyngen til skrivning og læsning gradvist degraderes, men generelt vil alt fungere, omend langsomt, men stabilt.
Som det viser sig, ønskede vi os noget i denne stil:
Men vi fik følgende:
Hvordan kunne dette ske?
På tidspunktet for datacenterets fald blev vores flaskehals masteren.
Hvorfor?
Det vigtigste er, at der i masteren er en TaskBatcher, der er ansvarlig for distributionen af bestemte opgaver og hændelser i klyngen. Enhver nodes udgang, enhver opgradering af shards fra replica til primary, enhver opgave til at oprette et eller andet shard - alt dette kommer først ind i TaskBatcher, hvor det behandles sekventielt og i ét stream.
På tidspunktet for udgangen af et datacenter skete det, at alle datanoder i de overlevende datacentre følte, det var deres pligt at informere masteren 'vi har mistet sådanne shards og sådanne datanoder'.
Samtidig sendte de overlevende datanoder al denne information til den nuværende master og forsøgte at vente på bekræftelse om, at han havde modtaget det. De ventede ikke, da masteren modtog opgaver hurtigere, end han kunne svare. Noderne gentog deres forespørgsler ved timeout, mens masteren i mellemtiden ikke engang forsøgte at svare dem og var helt opslugt af opgaven med at sortere forespørgslerne efter prioriteter.
I et terminalt scenarie viste det sig, at datanoderne spammede masteren, til han gik i full GC. Efter dette flyttede vores rolle som master til en anden node, og med hende skete der helt det samme, og i sidste ende kollapsede klyngen fuldstændigt.
Vi foretog målinger, og indtil version 6.4.0, hvor dette blev rettet, var det nok at få blot 10 datanoder ud af 360 til at lægge klyngen helt ned.
Det så cirka sådan ud:
Efter version 6.4.0, hvor de løste denne skræmmende bug, holdt datanoderne op med at dræbe masteren. Men han blev ikke 'klogere' af den grund. Når vi for eksempel fjerner 2, 3 eller 10 (hvilket som helst antal, der ikke er lig med én) datanoder, modtager masteren en slags første besked, der siger, at node A er gået ud, og han forsøger at informere node B, node C, node D om dette.
Og i øjeblikket kan dette kun tackles ved at indstille en timeout for forsøg på at fortælle nogen om noget, svarende til cirka 20-30 sekunder, og dermed styre hastigheden, hvormed datacenteret forlader klyngen.
I princippet falder dette inden for de krav, der oprindeligt blev stillet til det endelige produkt i projektets rammer, men set fra et 'rent videnskabeligt' perspektiv er det en fejl. Som i øvrigt blev løst af udviklerne i version 7.2.
Når en datanode gik ned, viste det sig, at det var vigtigere at sprede informationen om dens nedbrud end at informere hele klyngen om, hvilke primary-shard der var på den (for at promovere replica-shard i et andet datacenter til primary, så der kunne skrives information til dem).
Derfor, når alt er 'overstået', bliver de nedlagte datanoder ikke straks markeret som stale. Derfor er vi nødt til at vente, til alle pingene til de nedlagte datanoder er timed out, og først derefter begynder vores klynge at fortælle, at der, der og der skal fortsættes med at skrive information. Du kan læse mere om det .
Som et resultat tager operationen med at trække datacenteret i dag omkring 5 minutter i myldretiden. For en så stor og klodset maskine er det et ret godt resultat.
Som et resultat kom vi frem til følgende løsning:
- Vi har 360 datanoder med diske på 700 gigabyte.
- 60 koordinatorer til at routinge trafikken mellem de nævnte datanoder.
- 40 mestre, som vi har bevaret som en slags arv fra versioner før 6.4.0 — for at overleve nedtrækningen af datacenteret, var vi mentalt forberedte på at miste nogle maskiner, for at have et fejlfrit kvorum af mestre, selv under det værste scenarie.
- Enhver forsøg på at kombinere roller på én container stødte på det faktum, at node på et eller andet tidspunkt ville bryde sammen under belastning.
- I hele klyngen anvendes heap.size på 31 gigabyte: alle forsøg på at reducere størrelsen resulterede i, at tunge søgeforespørgsler med leading wildcard enten dræbte nogle noder eller fik circuit breaker til at gå ned i selve Elasticsearch.
- Desuden prøvede vi at holde antallet af objekter i klyngen så lavt som muligt for at kunne behandle så få hændelser som muligt på det smaleste sted, som vi havde i mesteren.
Til sidst om overvågning
For everything to work as intended, we monitor the following:
- Each data node reports to our cloud that it exists and has certain shards on it. When we shut something down somewhere, the cluster reports within 2-3 seconds that in center A we have shut down nodes 2, 3, and 4 — this means that in other data centers we cannot shut down the nodes on which there are unique shards.
- Knowing the master's behavior, we pay close attention to the number of pending tasks. Because even one hanging task, if not timed out in time, can theoretically become the reason why our promotion of a replica shard to primary might fail, affecting indexing.
- We also keep a close watch on garbage collector delays, as we have had significant issues with this during optimization.
- Rejects by threads to understand in advance where the 'bottleneck' is located.
- And the standard metrics, such as heap, RAM, and I/O.
When building monitoring, one must consider the features of the Thread Pool in Elasticsearch. describes the configuration options and default values for searching and indexing, but completely omits thread_pool.management. These threads process, among other things, requests like _cat/shards and other similar requests that are convenient for monitoring. The larger the cluster, the more such requests are executed per unit of time, and the aforementioned thread_pool.management is not only absent from the official documentation, but is also limited by default to 5 threads, which quickly get utilized, after which monitoring stops working correctly.
What I want to say in conclusion: we did it! We managed to provide our programmers and developers with a tool that can quickly and reliably provide information about what is happening in production in almost any situation.
Yes, it turned out to be quite complex, but nevertheless, we were able to fit our requirements into existing products without having to patch or rewrite them.
Kilde: habr.com
