

Jeg vil gerne beskrive en interessant mekanisme for arbejde med konfigurationen af et distribueret system. Konfigurationen præsenteres direkte i et kompilérbart sprog (Scala) ved hjælp af sikre typer. I dette indlæg gennemgås et eksempel på sådan en konfiguration, og forskellige aspekter af implementeringen af den kompilérbare konfiguration i den overordnede udviklingsproces vil blive diskuteret.
()
Introduktion
At bygge et pålideligt distribueret system indebærer, at der anvendes korrekte konfigurationer på alle noder, som er synkroniseret med de andre noder. Normalt anvendes DevOps-teknologier (terraform, ansible eller noget lignende) til automatisk at generere konfigurationsfiler (ofte specifikke for hver node). Vi ønsker også at være sikre på, at de interagerende noder anvender identiske protokoller (herunder version). Ellers vil der være inkompatibilitet i vores distribuerede system. I en JVM-verden er en konsekvens af dette krav behovet for at bruge den samme version af biblioteket, der indeholder protokolmeddelelser, overalt.
Hvad med testningen af det distribuerede system? Selvfølgelig antager vi, at der er enhedstest for alle komponenter, før vi går videre til integrationstests. (For at vi kan ekstrapolere testresultaterne til runtime, skal vi også sikre, at der er et identisk sæt biblioteker under testningen og i runtime.)
Når man arbejder med integrationstests, er det ofte lettere at bruge den samme classpath på alle noder. Vi skal kun sikre, at den samme classpath anvendes i runtime. (Selvom det er helt muligt at køre forskellige noder med forskellige classpaths, fører det til en mere kompliceret konfiguration og vanskeligheder med deployment og integrationstests.) I dette indlæg antager vi, at der anvendes den samme classpath på alle noder.
Konfigurationen udvikler sig sammen med applikationen. For at identificere de forskellige faser af programudviklingen bruger vi versioner. Det giver også mening at identificere de forskellige versioner af konfigurationerne. Selve konfigurationen placeres i et versionskontrolsystem. Hvis der er én enkelt konfiguration i produktion, kan vi blot bruge versionsnummeret. Hvis der derimod bruges flere instanser af produktion, vil vi have brug for flere
konfigurationsgrene og en ekstra etikette ud over versionen (f.eks. navnet på grenen). Dermed kan vi entydigt identificere den nøjagtige konfiguration. Hver konfigurationsidentifikator svarer entydigt til en bestemt kombination af distribuerede noder, porte, eksterne ressourcer og bibliotekversioner. I dette indlæg antager vi, at der kun er én gren, og at vi kan identificere konfigurationen på en almindelig måde ved hjælp af tre tal, adskilt af punkter (1.2.3).
I moderne miljøer oprettes konfigurationsfiler manuelt sjældent. De genereres oftere under implementeringen og berøres ikke derefter (for at ). Der opstår et naturligt spørgsmål: hvorfor bruger vi stadig tekstformat til opbevaring af konfiguration? En helt levedygtig alternativ løsning ville være at anvende almindelig kode til konfiguration og drage fordel af tjek under kompileringen.
I dette indlæg undersøger vi netop ideen om at repræsentere konfigurationen inden for det kompilerede artefakt.
Kompileret konfiguration
I dette afsnit ses et eksempel på en statisk, kompilérbar konfiguration. To enkle tjenester implementeres - en ekkoservice og en klient til ekkoservicen. På baggrund af disse to tjenester konstrueres to varianter af systemet. I den ene variant placeres begge tjenester på én node, i den anden variant - på forskellige noder.
Typisk indeholder et distribueret system flere noder. Noderne kan identificeres ved hjælp af værdier af en bestemt type NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
eller
case class NodeId(hostName: String)eller endda
object Singleton
type NodeId = Singleton.type
Noderne udfører forskellige roller, hvor tjenester kører, og der kan etableres TCP/HTTP-forbindelser mellem dem.
For describing TCP connections, we need at least a port number. We would also like to reflect the protocol that is supported on this port to ensure that both the client and server use the same protocol. We will describe the connection using such a class:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])hvor Port — just an integer Int with a specified range of valid values:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined types
See the library og . In short, the library allows adding constraints to types that are checked at compile time. In this case, the valid port number values are 16-bit integers. Using the refined library in the compiled configuration is not mandatory but improves the compiler's ability to check the configuration.
For HTTP (REST) protocols, besides the port number, we may also need the path to the service:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom types
To identify the protocol at compile time, we use a type parameter that is not used inside the class. This decision is related to the fact that we do not use a protocol instance at runtime, but would like the compiler to check for protocol compatibility. By specifying the protocol, we cannot pass an inappropriate service as a dependency.
One of the common protocols is REST API with JSON serialization:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]hvor RequestMessage — request type, ResponseMessage — response type.
Of course, other protocol descriptions that provide the required precision of description can also be used.
For the purposes of this post, we will use a simplified version of the protocol:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Here, the request is a string added to the URL, while the response is the string returned in the body of the HTTP response.
The service configuration is described by the service name, ports, and dependencies. These elements can be represented in Scala in several ways (for example, HList-s, algebraic data types). For the purposes of this post, we will use the Cake Pattern and represent modules using traits. (The Cake Pattern is not a mandatory element of the described approach. It's just one of the possible implementations.)
Dependencies between services can be represented as methods returning the ports EndPoints of other nodes:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
For creating an echo service, all you need is the port number and an indication that this port supports the echo protocol. We could omit specifying a particular port, as traits allow declaring methods without implementation (abstract methods). In this case, when creating a specific configuration, the compiler would require us to provide an implementation for the abstract method and the port number. Since we've implemented the method, we can skip specifying another port when creating a specific configuration. The default value will be used.
In the client configuration, we declare a dependency on the echo service:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
The dependency has the same type as the exported service echoService. Specifically, in the echo client, we require the same protocol. Therefore, when connecting two services, we can be confident that everything will work correctly.
Service Implementation
To start and stop the service, a function is required. (The ability to stop the service is critically important for testing.) Again, there are several options for implementing such a function (for example, we could use type classes based on the type of configuration). For the purposes of this post, we will use the Cake Pattern. We will represent the service using a class cats.Resource, as this class already provides methods for safely and reliably releasing resources in case of issues. To obtain a resource, we need to provide a configuration and a ready runtime context. The service start function might look like this:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
hvor
Konfigurer— the type of configuration for this serviceAddressResolver— a runtime object that allows you to know the addresses of other nodes (see below)
and other types from the library cats:
F[_]— the type of effect (in the simplest caseF[A]could just be a function() => A. In this post, we will usecats.IO.)Reader[A,B]— a more or less equivalent of a functionA => Bcats.Resource— a resource that can be obtained and releasedTimer— a timer (allows sleeping for a while and measuring time intervals)ContextShift— an analogExecutionContextApplicative— a class of effect type that allows combining individual effects (almost a monad). In more complex applications, it might be better to useMonad/ConcurrentEffect.
By using this function signature, we can implement several services. For instance, a service that does nothing:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(See. , hvor andre tjenester er implementeret — ,
og .)
Noden er et objekt, der kan starte flere tjenester (starten af ressourcekæden sikres gennem Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Bemærk, at vi angiver den nøjagtige type konfiguration, der kræves for denne node. Hvis vi glemmer at angive en af de konfigurationstyper, der kræves af en individuel tjeneste, vil der opstå en kompilationsfejl. Vi vil heller ikke være i stand til at starte noden, hvis vi ikke leverer et objekt med den rigtige type og alle nødvendige data.
Navnene på noderne
For at oprette forbindelse til en fjernnode har vi brug for en faktisk IP-adresse. Det er muligt, at adressen bliver kendt senere end de andre dele af konfigurationen. Derfor har vi brug for en funktion, der viser nodens identifikator i adressen:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Vi kan foreslå flere måder at implementere en sådan funktion på:
- Hvis adresserne bliver kendt før distributionen, kan vi generere Scala-kode med
adresserne og derefter starte kompileringen. På dette tidspunkt vil der blive udført kompilering og test.
I så fald vil funktionen være kendt statisk og kan præsenteres i koden som en visningMap[NodeId, NodeAddress]. - I nogle tilfælde bliver den gyldige adresse først kendt efter nodens opstart.
I dette tilfælde kan vi implementere en "opdagelsestjeneste" (discovery), der starter før de andre noder, og alle noder vil registrere sig i denne tjeneste og anmode om adresserne på de andre noder. - Hvis vi kan ændre
/etc/hosts, kan vi bruge foruddefinerede værtsnavne (såsommy-project-main-nodeogecho-backend) og simpelthen forbinde disse navne
til IP-adresserne under distributionen.
I dette indlæg vil vi ikke se nærmere på disse tilfælde. Til vores
legetøjeksempel vil alle noder have én IP-adresse — 127.0.0.1.
Lad os se på to varianter af et distribueret system:
- Placering af alle tjenester på én node.
- Og placeringen af ekko-tjenesten og ekko-klienten på forskellige noder.
Konfiguration for :
Konfiguration for én node
objekt SingleNodeConfig udvider EchoConfig[String]
  med EchoClientConfig[String] med FiniteDurationLifecycleConfig
{
  case object Singleton

  type NodeId = Singleton.type
  def nodeId = Singleton


  /** Typesikker serviceport-specifikation. */
  override def portNumber: PortNumber = 8088


  /** Vi bruger den service, som tilbydes af den samme vært. */
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hej"

  def pollInterval: FiniteDuration = 1.second


  // livscykluscontroller konfiguration
  def lifetime: FiniteDuration = 10500.milliseconds
}
Objektet implementerer konfigurationen for både klient og server. Derudover bruges livscykluskonfigurationen til at afslutte programmet efter et interval levetid . (Ctrl-C fungerer også og frigiver korrekt alle ressourcer.)
Den samme samling af traits konfigurationer og implementeringer kan bruges til at oprette et system bestående af :
Konfiguration for to noder
  objekt NodeServerConfig udvider EchoConfig[String] med SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig udvider EchoClientConfig[String] med FiniteDurationLifecycleConfig
  {

    // NB! afhængighedsspecifikation
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds

    def testMessage: String = "dolly"
  }
Vigtigt! Vær opmærksom på, hvordan bindingen af tjenester udføres. Vi angiver en tjeneste, der implementeres af en node som implementering af en afhængighedsmetode for en anden node. Typen af afhængighed kontrolleres af compileren, da den indeholder protokoltypen. Ved kørsel vil afhængigheden indeholde den korrekte identifikator for målnoten. På denne måde angiver vi portnummeret kun én gang og henviser altid sikkert til den rigtige port.
Implementering af to noder i systemet
Til denne konfiguration bruger vi de samme implementeringer af tjenester uden ændringer. Den eneste forskel er, at vi nu har to objekter, der implementerer forskellige sæt af tjenester:
  objekt TwoJvmNodeServerImpl udvider ZeroServiceImpl[IO] med EchoServiceService og SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] med SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl udvider ZeroServiceImpl[IO] med EchoClientService og FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] med FiniteDurationLifecycleConfig
  }
Den første node implementerer serveren og har kun brug for serverkonfigurationen. Den anden node implementerer klienten og bruger en anden del af konfigurationen. Begge noder har også brug for livscyklusstyring. Servernoden kører ubegribelig længe, indtil den stoppes SIGTERMmedmindre klientnoden afsluttes efter et stykke tid. Se. .
Den overordnede udviklingsproces
Lad os se på, hvordan denne tilgang til konfiguration påvirker den overordnede udviklingsproces.
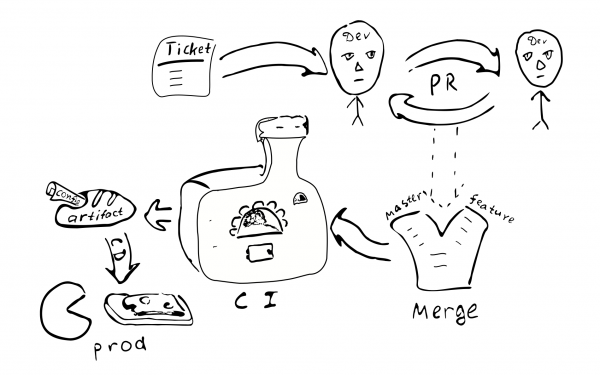
Konfigurationen vil blive kompileret sammen med resten af koden, og et artefakt (.jar) vil blive genereret. Det giver mening at placere konfigurationen i et separat artefakt. Dette skyldes, at vi kan have mange konfigurationer baseret på den samme kode. Igen kan der genereres artefakter, der svarer til forskellige konfigurationsgrene. Sammen med konfigurationen bevares afhængigheder fra specifikke versioner af biblioteker, og disse versioner bevares for altid, uanset hvornår vi beslutter at implementere denne konfigurationsversion.
Enhver ændring af konfigurationen bliver til en ændring af koden. Således vil hver sådanne
ændringer blive dækket af den almindelige kvalitetskontrolproces:
Ticket i bug-tracker -> PR -> review -> sammenfletning med de relevante grene ->
integration -> implementering
De vigtigste konsekvenser af implementeringen af kompilerbar konfiguration:
Konfiguration vil blive aftalt på alle noder i det distribuerede system. Da alle noder modtager den samme konfiguration fra en enkelt kilde, er det.
Det er problematisk at ændre konfigurationen kun på én af noderne. Derfor er "konfigurationsdrift" (configuration drift) usandsynlig.
Det bliver sværere at foretage små ændringer i konfigurationen.
Størstedelen af ændringer i konfigurationen vil finde sted inden for den overordnede udviklingsproces og vil blive udsat for review.
Er der brug for et separat repository til opbevaring af produktionskonfiguration? I en sådan konfiguration kan der være adgangskoder og anden hemmelig information, som vi gerne vil begrænse adgangen til. På baggrund af dette giver det åbenbart mening at gemme den endelige konfiguration i et separat repository. Konfigurationen kan opdeles i to dele - én indeholdende offentlige konfigurationsparametre, og en anden indeholdende parametre med begrænset adgang. Dette vil give de fleste udviklere adgang til de offentlige parametre. Sådan en opdeling er ikke svær at opnå ved at bruge mellemliggende traits, der indeholder standardværdier.
Mulige variationer
Lad os prøve at sammenligne den kompilerede konfiguration med nogle almindelige alternativer:
- Tekstfil på målmaskinen.
- Centraliseret key-value lagring (
i den relevante Docker-container/zookeeper). - Komponenter i processen, der kan rekonfigureres/genstartes uden at genstarte processen.
- Opbevaring af konfiguration uden for artefakten og versionskontrol.
Tekstfiler giver betydelig fleksibilitet med hensyn til små ændringer. Systemadministratoren kan få adgang til en fjernnode, foretage ændringer i de relevante filer og genstarte tjenesten. For store systemer kan dog en sådan fleksibilitet være uønsket. Cambemodificeringer efterlader ingen spor i andre systemer. Ingen foretager review af ændringer. Det er svært at fastslå, hvem der præcist har foretaget ændringerne og hvorfor. Ændringerne bliver ikke testet. Hvis systemet er distribueret, kan administratoren glemme at foretage den relevante ændring på de andre noder.
(Det skal også bemærkes, at anvendelsen af en kompileret konfiguration ikke udelukker muligheden for fremover at bruge tekstfiler. Det vil være tilstrækkeligt at tilføje en parser og validator, der giver den samme type Konfigurer, og man kan fortsætte med at bruge tekstfiler. Heraf følger det direkte, at kompleksiteten af systemet med en kompileret konfiguration er noget mindre end kompleksiteten af et system, der bruger tekstfiler, da der kræves yderligere kode til tekstfiler.)
Et centraliseret nøgle-værdi lager er en god mekanisme til distribution af metadata for en distribueret applikation. Vi bør definere, hvad der er konfigurationsparametre, og hvad der blot er data. Lad os antage, at vi har en funktion C => A => B, hvor parametrene C sjældent ændres, mens dataene A ændres ofte. I dette tilfælde kan vi sige, at C er konfigurationsparametre, mens A er data. Det ser ud til, at konfigurationsparametrene adskiller sig fra dataene ved, at de generelt ændres sjældnere end dataene. Desuden kommer dataene typisk fra én kilde (brugeren), mens konfigurationsparametrene kommer fra en anden (systemadministratoren).
Hvis sjældent ændrede parametre skal opdateres uden at genstarte programmet, kan det ofte føre til en kompleksitet i programmet, da vi på en eller anden måde skal levere parametrene, opbevare, parse og validere, samt håndtere ugyldige værdier. Derfor giver det mening at reducere antallet af parametre, der kan ændres i løbet af programmets drift (eller slet ikke at understøtte sådanne parametre).
I forhold til dette indlæg vil vi skelne mellem statiske og dynamiske parametre. Hvis service-logikken kræver ændring af parametre under programmets kørsel, kalder vi sådanne parametre dynamiske. I modsat fald er parametrene statiske og kan konfigureres med en kompilerbar konfiguration. For dynamisk rekonfiguration kan vi have brug for en mekanisme til at genstarte dele af programmet med nye parametre, ligesom genstart af processer i operativsystemet. (Vi mener, det er ønskeligt at undgå realtidsrekonfiguration, da det øger systemets kompleksitet. Hvis det er muligt, er det bedre at anvende standardmulighederne i OS til at genstarte processer.)
Et af de vigtige aspekter ved brug af statisk konfiguration, som får folk til at overveje dynamisk rekonfiguration, er den tid, systemet kræver for at genstarte efter en opdatering af konfigurationen (downtime). I virkeligheden, hvis vi skal ændre den statiske konfiguration, bliver vi nødt til at genstarte systemet for at de nye værdier træder i kraft. Problemet med downtime har forskellig alvorlighed for forskellige systemer. I nogle tilfælde kan genstarten planlægges til et tidspunkt, hvor belastningen er minimal. Hvis der er behov for at sikre en kontinuerlig service, kan vi implementere . Når vi skal genstarte systemet, starter vi en parallel instans af systemet, omdirigerer balanceringsapparatet til den, og venter på, at de gamle forbindelser afsluttes. Når alle gamle forbindelser er afsluttet, slukker vi for den gamle instans af systemet.
Lad os nu se på spørgsmålet om opbevaring af konfigurationen inden for artefakten eller uden for den. Hvis vi opbevarer konfigurationen inden for artefakten, har vi i det mindste haft mulighed for at bekræfte konfigurationens korrekthed under opbygningen af artefakten. Hvis konfigurationen er uden for den kontrollerede artefakt, er det svært at spore, hvem der har foretaget ændringer i denne fil, og hvorfor. Hvor vigtigt er dette? Efter vores mening er det vigtigt for mange produktionssystemer at have en stabil og høj kvalitet konfiguration.
Artefaktversionen gør det muligt at bestemme, hvornår den blev oprettet, hvilke værdier den indeholder, hvilke funktioner der er aktiveret/deaktiveret, og hvem der har ansvaret for eventuelle ændringer i konfigurationen. Selvfølgelig kræver det en vis indsats at opbevare konfigurationen inden i artefakten, så det er nødvendigt at træffe en bevidst beslutning.
For og imod
Jeg vil gerne fokusere på fordele og ulemper ved den foreslåede teknologi.
Fordele
Nedenfor er en liste over de vigtigste funktioner i den kompilérbare konfiguration af det distribuerede system:
- Statisk konfigurationskontrol. Giver os sikkerhed for, at
konfigurationen er korrekt. - Rigt konfigurationssprog. Normalt er andre konfigurationsmetoder begrænset til maksimalt at erstatte strengvariabler. Ved at bruge Scala bliver et bredt spektrum af sprogfunktioner tilgængelige for at forbedre konfigurationen. For eksempel kan vi bruge
traits til standardværdier, grupperer parametre ved hjælp af objekter, og kan referere til val'ene, der er erklæret én gang (DRY) i den omgivende synlighed. Vi kan direkte instantiere enhver klasse inden for konfigurationen (Seq,Kort, brugerdefinerede klasser). - DSL. I Scala er der en række sprogfunktioner, der letter oprettelsen af DSL. Disse funktioner kan bruges til at implementere et konfigurationssprog, der ville være mere brugervenligt for den målgruppes brugere, således at konfigurationen ville være mindst læsbar for fagfolk. Fagfolk kan f.eks. deltage i gennemgangsprocessen af konfigurationen.
- Integritet og synkronisering mellem noder. En af fordelene ved at have konfigurationen for et helt distribueret system opbevaret et eneste sted er, at alle værdier erklæres præcist én gang og derefter genbruges overalt, hvor de er nødvendige. Brug af phantomtyper til at erklære porte sikrer, at alle korrekte konfigurationer af systemet bruger kompatible protokoller. Tilstedeværelsen af eksplicitte obligatoriske afhængigheder mellem noder garanterer, at alle tjenester vil være knyttet sammen.
- Høj kvalitet af ændringer. Ændringer i konfigurationen, ved hjælp af en fælles udviklingsproces, gør det muligt at anvende høje kvalitetsstandarder også for konfigurationen.
- Samtidig opdatering af konfigurationen. Automatisk implementering af systemet efter ændringer i konfigurationen sikrer, at alle noder bliver opdateret.
- Forenkling af applikationen. Applikationen kræver ikke parsing, konfigurationskontrol og behandling af ugyldige værdier. Dermed reduceres kompleksiteten i applikationen. (Nogle af de komplikationer i konfigurationen, som ses i vores eksempel, er ikke et kendetegn ved den kompilerbare konfiguration, men blot et bevidst valg, drevet af ønsket om større type-sikkerhed.) Det er ret nemt at gå tilbage til den normale konfiguration — det kræver blot at implementere de manglende dele. Derfor kan man f.eks. starte med den kompilerbare konfiguration og udsætte implementeringen af unødvendige dele til det tidspunkt, hvor der virkelig er behov for det.
- Versionsstyret konfiguration. Da konfigurationsændringer følger den sædvanlige takst for andre ændringer, får vi et artefakt med en unik version ved udgangen. Dette gør det muligt for os f.eks. at vende tilbage til en tidligere version af konfigurationen efter behov. Vi kan endda bruge konfigurationen fra et år siden, og systemet vil fungere præcis som før. En stabil konfiguration forbedrer forudsigeligheden og pålideligheden af det distribuerede system. Da konfigurationen er fastlagt på compileringstidspunktet, er det ret svært at forfalske den i produktionen.
- Modularitet. Den foreslåede ramme er modulær, og moduler kan kombineres på forskellige måder for at skabe forskellige systemer. Især kan man i én version konfigurere systemet til at køre på en enkelt node, mens det i en anden kan køre på flere noder. Man kan skabe flere konfigurationer til produktions-eks. af systemet.
- Testning. Ved at erstatte enkelte tjenester med mock-objekter kan man opnå flere versioner af systemet, der er praktiske til testning.
- Integrations testning. En ensartet konfiguration af hele det distribuerede system giver mulighed for at køre alle komponenter i et kontrolleret miljø under integrations testningen. Det er nemt at simulere for eksempel en situation, hvor nogle noder bliver utilgængelige.
Ulemper og begrænsninger
Den kompilerede konfiguration adskiller sig fra andre konfigurationsmetoder og kan være uegnet til nogle applikationer. Nedenfor er nogle ulemper:
- Statisk konfiguration. Nogle gange er det nødvendigt hurtigt at rette konfigurationen i produktion og omgå alle beskyttelsesmekanismer. Under denne tilgang kan dette være mere kompliceret. I det mindste kræves der stadig kompilering og automatiseret implementering. Dette er både en nyttig funktion ved tilgangen og en ulempe i nogle tilfælde.
- Konfigurationsgenerering. Hvis konfigurationsfilen genereres af et automatiseret værktøj, kan der kræves ekstra indsats for at integrere byggescriptet.
- Værktøjer. I øjeblikket er de værktøjer og metoder, der er beregnet til arbejdet med konfiguration, baseret på tekstfiler. Ikke alle sådanne værktøjer/metoder vil være tilgængelige i tilfælde af kompileret konfiguration.
- Ændring af synspunkter er nødvendig. Udviklere og DevOps er vant til tekstfiler. Selve ideen om at kompilere konfiguration kan være noget overraskende og uvant og kan fremkalde afvisning.
- En højkvalitets udviklingsproces er nødvendig. For at komfortabelt kunne bruge en kompileret konfiguration er fuld automatisering af bygge- og implementeringsprocessen (CI/CD) nødvendig. Ellers vil det være tilstrækkeligt besværligt.
Lad os også se på en række begrænsninger i det betragtede eksempel, som ikke relaterer sig til idéen om en kompileret konfiguration:
- Hvis vi giver overskydende konfigurationsoplysninger, der ikke bruges af noden, vil kompilereren ikke hjælpe os med at opdage manglen på implementering. Dette problem kan løses ved at opgive Cake Pattern'et og bruge mere strenge typer, for eksempel,
HListeller algebraiske datatyper (case classes) til at repræsentere konfigurationen. - I konfigurationsfilen er der strenge, der ikke vedrører selve konfigurationen: (
pakke,import, objektdeklarationer;override def‘er for parametre, der har standardværdier). Det er muligt at delvist undgå dette ved at implementere et eget DSL. Derudover pålægger andre konfigurationsformer (f.eks. XML) også visse begrænsninger på filstrukturen. - I dette indlæg vil vi ikke behandle dynamisk rekonfiguration af et cluster af lignende noder.
Konklusion
I dette indlæg har vi undersøgt ideen om at repræsentere konfiguration i kildekoden ved hjælp af de avancerede funktioner i Scala-typesystemet. Denne tilgang kan anvendes i forskellige applikationer som et alternativ til de traditionelle konfigurationsmetoder baseret på XML- eller tekstfiler. Selvom vores eksempel er implementeret i Scala, kan de samme ideer overføres til andre kompilérbare sprog (som Kotlin, C#, Swift, ...). Denne tilgang kan prøves i et af de kommende projekter, og hvis det ikke fungerer, kan man skifte til tekstfiler og tilføje de manglende detaljer.
Naturligvis kræver kompilérbar konfiguration en kvalitetsudviklingsproces. Til gengæld sikres høj kvalitet og pålidelighed i konfigurationerne.
Den præsenterede tilgang kan udvides:
- Man kan bruge makroer til at udføre kontroller under kompileringen.
- Det er muligt at implementere et DSL til at repræsentere konfigurationen i en form, der er tilgængelig for slutbrugerne.
- Dynamisk ressourcehåndtering med automatisk justering af konfigurationen kan implementeres. For eksempel, når antallet af noder i clusteren ændres, kræves det, at (1) hver node får en lidt anderledes konfiguration; (2) clusteradministrator modtager oplysninger om de nye noder.
Taknemmelighed
Jeg vil gerne takke Andrey Saksonov, Pavel Popov og Anton Nekhaev for deres konstruktive kritik af udkastet til artiklen.
Kilde: habr.com
