

Platformen giver mulighed for at strømline oprettelsen af , herunder i infrastruktur leveret af cloudtjenesteudbydere, på virtualiseringsplatforme eller i bare-metal systemer. For i sandhed at skabe en cloudplatform måtte vi have stram kontrol over alle anvendte elementer og dermed forbedre pålideligheden af den komplekse automatiseringsproces.
En åbenlys løsning var at bruge Red Hat Enterprise Linux CoreOS (en variant af Red Hat Enterprise Linux) og CRI-O som standard, og det er grunden til…
Da emnet navigering er særdeles heldigt til at finde analogier til at forklare, hvordan Kubernetes og containere fungerer, vil vi forsøge at beskrive de forretningsproblemer, som CoreOS og CRI-O løser, ved hjælp af eksemplet . I 1803 blev Marc Brunel bedt om at fremstille 100.000 riggblokke til det voksende britiske marineflåde. En riggblok er en type udstyr, der bruges til at fastgøre reb til sejl. Indtil begyndelsen af det 19. århundrede blev disse blokke fremstillet manuelt, men Brunel formåede at automatisere produktionen og begynde at fremstille standardiserede blokke ved hjælp af maskiner. Automatiseringen af denne proces betød, at alle blokke i praksis var ens, kunne nemt udskiftes i tilfælde af brud og kunne fremstilles i store mængder.
Og nu kan du forestille dig, at Brunel skulle udføre dette arbejde for 20 forskellige skibsmodeller (versioner af Kubernetes) og for fem forskellige planeter med helt forskellige havstrømme og vinde (cloududbydere). Desuden var det nødvendigt, at alle skibe (OpenShift-klynger), uanset hvilke planeter de navigerer på, optrådte ens for kaptajnerne (operatører, der styrer klyngernes drift). Fortsættende den marine analogi, ville kaptajnerne på skibene være fuldstændig ligeglade med, hvilke riggblokke (CRI-O) der blev brugt på deres skibe – for dem er det vigtigste, at disse blokke er robuste og pålidelige.
For OpenShift 4, as a cloud platform, there is a very similar business task. New nodes must be created at the moment of cluster creation, in the case of a failure in one of the nodes, or when scaling the cluster. When creating and initializing a new node, the critical components of the host, including CRI-O, must also be appropriately configured. As in any other production process, it is essential to supply 'raw materials' at the beginning. In the case of ships, metal and wood serve as raw materials. However, for creating a host for deploying containers in an OpenShift 4 cluster, configuration files and the provided API servers must be available at the input. After that, OpenShift will ensure the necessary level of automation throughout the entire lifecycle, offering essential product support for end-users and thus recouping the investments in the platform.
OpenShift 4 was designed to ensure convenient upgrades of the system throughout the lifecycle of the platform (for versions 4.X) for all major cloud computing providers, virtualization platforms, and even bare metal systems. For this purpose, nodes must be built on interchangeable components. When the cluster requires a new version of Kubernetes, it also receives the appropriate version of CRI-O on CoreOS. Since the CRI-O version is directly tied to Kubernetes, this greatly simplifies any rearrangements for testing, troubleshooting, or support purposes. Furthermore, this approach helps reduce costs for end-users and Red Hat.
This is a fundamentally new perspective on Kubernetes clusters, which lays the groundwork for planning new very useful and attractive features. CRI-O (the Open Container Initiative's Container Runtime Interface project, abbreviated CRI-OCI) has proven to be the most suitable choice for the mass creation of nodes required for working with OpenShift. CRI-O replaces the previously used Docker engine, offering OpenShift users – yes, you heard it right – a boring container engine created specifically for use with Kubernetes.
The world of open containers
Verden bevæger sig for længe siden mod åbne containere. Uanset om det er i Kubernetes eller på lavere niveauer, fører til en økosystem af innovationer på hvert niveau.
Det hele begyndte med oprettelsen af Open Containers Initiative . På dette tidlige tidspunkt blev specifikationerne for container og . Dette gjorde det muligt at garantere, at værktøjer kan bruge en fælles standard og et fælles format til at arbejde med dem. Senere blev specifikationerne , hvilket gjorde det nemt for brugerne at dele .
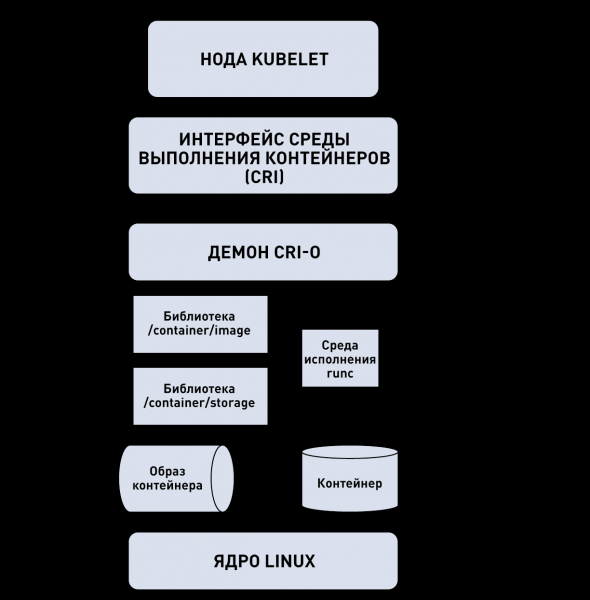
Derefter udviklede Kubernetes-samfundet en fælles standard for det tilsluttede interface (pluggable interface), kaldet . Takket være dette kunne Kubernetes-brugerne tilslutte forskellige motorer til at arbejde med containere ud over Docker.
Ingeniører fra Red Hat og Google så et eksisterende marked behov for en container motor, der kunne acceptere anmodninger fra Kubelet via CRI-protokollen og præsenterede containere, der var kompatible med de ovennævnte OCI-specifikationer. Så Men vent, vi sagde jo, at dette materiale ville handle om CRI-O? Faktisk gør det, men med udgivelsen af projektet blev omdøbt til CRI-O.
Fig. 1.
Innovationer med CRI-O og CoreOS
Med lanceringen af OpenShift 4 blev den , der blev brugt på platformen som standard, ændret og Docker blev erstattet af CRI-O, som sikrede en økonomisk, stabil, enkel og kedelig miljø til at køre containere, der udvikler sig parallelt med Kubernetes. Dette letter betydeligt vedligeholdelsen og konfigurationen af klyngen. Konfigurationen af container motoren og værten samt administrationen af dem bliver automatiseret i rammerne af OpenShift 4.
Vent, hvordan er det nu?
Netop så, med fremkomsten af OpenShift 4 er der ikke længere behov for at tilslutte sig separate værter og installere container motoren, konfigurere lageret, indstille servere til at finde eller konfigurere netværket. OpenShift 4-platformen blev fuldstændig redesignet til at bruge the ikke kun set fra slutbrugerens applikationer, men også fra grundlæggende operationer på platformniveau, såsom implementering af billeder, konfiguration af systemet eller installation af opdateringer.
Kubernetes har altid tilladt brugere at styre applikationer ved at definere den ønskede tilstand og bruge , for at sikre at den faktiske tilstand maksimalt svarer til den angivne tilstand. Denne åbner store muligheder, både set fra udviklingens og driftsmæssig perspektiv. Udviklere kan definere den ønskede tilstand, til operatøren i form af en YAML- eller JSON-fil, og derefter kan operatøren oprette det nødvendige instans af applikationen i produktionsmiljøet, hvor driftsstatus for denne instans vil være fuldstændig i overensstemmelse med den angivne.
Ved at bruge operatører (Operators) i platformen, bringer OpenShift 4 denne nye paradigme (ved at anvende konceptet for angivet og faktisk tilstand) til administration af RHEL CoreOS og CRI-O. Opgaver med konfiguration og versionsadministration af operativsystemet og containermotoren automatiseres ved hjælp af den såkaldte . MCO forenkler i høj grad arbejde for klyngelederne, idet det i praksis automatiserer de sidste trin i installationen samt de efterfølgende operationer efter installationen (day two operations). Alt dette gør OpenShift 4 til en ægte cloud-platform. Vi vil vende tilbage til dette lidt senere.
Kørsel af containere
Brugere har haft mulighed for at bruge CRI-O motoren i OpenShift platformen siden version 3.7 i Tech Preview-status og siden version 3.9 i Generally Available (understøttet i øjeblikket) status. Desuden bruger Red Hat massivt i OpenShift Online siden version 3.10. Alt dette har givet teamet bag CRI-O en enorm erfaring med masseudrulning af containere i store Kubernetes-klynger. For at få grundlæggende indsigt i, hvordan Kubernetes bruger CRI-O, lad os se på den følgende illustration, som viser, hvordan arkitekturen fungerer.
Fig. 2. Hvordan containere fungerer i en Kubernetes-klynge
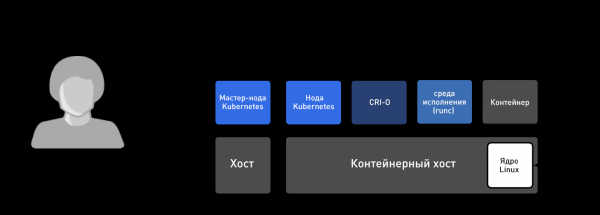
CRI-O forenkler oprettelsen af nye container-værter ved at synkronisere hele det øverste niveau, når nye noder initieres samt ved udgivelse af nye versioner af OpenShift-platformen. Revisionen af hele platformen muliggør transaktionsopdateringer / tilbageførsler og forebygger også gensidige blokeringer mellem afhængighederne af container-værtskernen, container-motoren, noderne (Kubelets) og Kubernetes Master-noden. Med centraliseret styring af alle platformens komponenter, med kontrol og administration af versioner, kan man altid spore den klare vej fra tilstand A til tilstand B. Dette forenkler opdateringsprocessen, forbedrer sikkerheden, øger rapporteringen af ydeevne og hjælper med at reducere omkostningerne ved opdateringer og installation af nye versioner.
Demonstration af kraften i udskiftelige komponenter
Som nævnt tidligere giver brugen af Machine Config Operator til at styre container-værten og container-motoren i OpenShift 4 et nyt niveau af automatisering, som ikke var muligt på Kubernetes-platformen tidligere. For at demonstrere de nye muligheder vil vi vise, hvordan du kan foretage ændringer i filen crio.conf. For at undgå forvirring med terminologien, så prøv at fokusere på resultaterne.
Først lad os oprette det, der kaldes Container Runtime-konfiguration – Container Runtime Config. Tænk på det som en slags Kubernetes-resource, der repræsenterer konfigurationen for CRI-O. Faktisk er det en specialiseret version af det, der kaldes MachineConfig, som repræsenterer enhver konfiguration, der implementeres på en RHEL CoreOS-maskine inden for OpenShift-klustret.
Denne brugerdefinerede ressource, kaldet ContainerRuntimeConfig, blev skabt for at lette konfigurationen af CRI-O for klyngeadministratorer. Det er et kraftfuldt værktøj, der kan anvendes på bestemte noder afhængigt af indstillingerne for MachineConfigPool. Tænk på dette som en gruppe af maskiner, der tjener det samme formål.
Bemærk de to sidste linjer, som vi vil ændre i filen /etc/crio/crio.conf. Disse to linjer ligner meget linjerne i filen crio.conf, som er:
vi ContainerRuntimeConfig.yaml
Output:
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Vi sender nu denne fil til Kubernetes-klyngen og kontrollerer, at den faktisk blev oprettet. Bemærk, at arbejdet udføres præcist som med enhver anden Kubernetes-ressource:
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Output:
NAVN              ALDER
set-log-and-pid   22h
Efter at vi har oprettet ContainerRuntimeConfig, skal vi ændre en af MachineConfigPools for at informere Kubernetes om, at vi ønsker at anvende denne konfiguration på en bestemt gruppe maskiner i klyngen. I dette tilfælde ændrer vi MachineConfigPool for master-noderne:
oc edit MachineConfigPool/master
Output (for tydelighedens skyld er hovedindholdet efterladt):
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
På dette tidspunkt begynder MCO at oprette en ny fil crio.conf for klyngen. Den færdige konfigurationsfil kan ses via Kubernetes API. Husk, at ContainerRuntimeConfig kun er en specialiseret version af MachineConfig, så vi kan se resultatet ved at kigge på de relevante linjer i MachineConfigs:
oc get MachineConfigs | grep rendered
Output:
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16h
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16h
Bemærk, at den opnåede konfigurationsfil for master-noderne viste sig at være en nyere version end de oprindelige konfigurationer. For at se den, kør følgende kommando. Vi bemærker også, at dette muligvis er et af de bedste en-linjers scripts i Kubernetes' historie:
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Output:
pids_limit = 2048
Lad os nu sikre os, at konfigurationen er blevet anvendt på alle master-noder. Først henter vi listen over noder i klyngen:
oc get node | grep master

Output:

ip-10-0-135-153.us-east-2.compute.internal   Klar master 23h v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Klar master 23h v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Klar master 23h v1.12.4+509916ce1
Lad os nu kigge på den installerede fil. Du vil se, at filen er blevet opdateret med de nye værdier for direktiverne pid og debug, som vi angav i ressourcen ContainerRuntimeConfig. Ren elegance:
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid’
Output:
...
pids_limit = 2048
...
log_level = "debug"
...
Alle disse ændringer i klusteret blev foretaget uden at starte SSH. Alt arbejde blev udført ved at henvende sig til master-noden i Kubernetes. Det vil sige, at disse nye parametre kun blev konfigureret på master-noderne. Arbejdsnoderne blev ikke ændret, hvilket demonstrerer fordelene ved Kubernetes-metodologien med brug af specificerede og aktuelle tilstande i forhold til containerhosts og containermotorer med udskiftelige elementer.
Det ovenstående eksempel viser muligheden for at foretage ændringer i et lille OpenShift Container Platform 4 kluster med tre arbejdsnoder eller i et stort produktionskluster med 3000 noder. Under alle omstændigheder vil arbejdsomfanget være det samme – og ganske lille – det er tilstrækkeligt at konfigurere ContainerRuntimeConfig-filen og ændre én label i MachineConfigPool. Og du kan gøre dette med enhver version af den anvendte Kubernetes OpenShift Container Platform 4.X i hele dens livscyklus.
Ofte udvikler teknologiske virksomheder sig så hurtigt, at vi ikke er i stand til at forklare, hvorfor vi vælger bestemte teknologier til grundlæggende komponenter. Containermotorer har historisk set været den komponent, som brugerne interagerer direkte med. Da populariteten af containere logisk set startede med fremkomsten af containermotorer, viser brugerne ofte interesse for dem. Dette er endnu en grund til, at Red Hat valgte CRI-O. Containere udvikler sig, og i dag er fokuset primært på orkestrering, og vi er kommet til den konklusion, at CRI-O giver den bedste oplevelse i brugen af OpenShift 4.
Kilde: habr.com
