

Kunderne anmoder i stigende grad om løsninger som: „Vi vil have noget som Amazon RDS, men billigere“; „Vi vil have noget som RDS, men til enhver infrastruktur“. For at implementere en sådan managed-løsning på Kubernetes har vi kigget på de nuværende tilstande af de mest populære operatører for PostgreSQL (Stolon, operatører fra Crunchy Data og Zalando) og har truffet vores valg.
Denne artikel er baseret på vores erfaring, både fra et teoretisk perspektiv (oversigt over løsninger) og fra en praktisk side (hvad vi valgte og hvad der kom ud af det). Men først, lad os fastslå, hvilke krav der generelt stilles til en potentiel erstatning for RDS …
Hvad er RDS?
Når folk taler om RDS, henviser de ifølge vores erfaring til en managed database-tjeneste, der:
- er nem at konfigurere;
- har mulighed for at arbejde med snapshots og gendanne fra dem (helst med støtte til );
- mulighed for at oprette master-slave topologier;
- har en bred liste af udvidelser;
- giver revisions- og brugeradgangsstyring.
Generelt set kan tilgange til implementeringen af den stillede opgave være meget forskellige, men metoden med betinget Ansible er ikke nær os. (En lignende konklusion nåede også kollegerne fra 2GIS efter på at skabe et „værktøj til hurtig implementering af en fejlbehæftet Postgres-klynge“.)
Operatører er den almindeligt accepterede tilgang til at løse sådanne opgaver i Kubernetes-økosystemet. Jeg har tidligere omtalt deres anvendelse til databaser, der kører inden i Kubernetes, i en af mine præsentationer, , i .
NB: For at skabe enkle operatører hurtigt anbefaler vi at se på vores Open Source-værktøj . Ved at bruge det kan man gøre dette uden kendskab til Go, med metoder mere velkendte for systemadministratorer: Bash, Python osv.
Der findes flere populære K8s-operatører til PostgreSQL:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Lad os se nærmere på dem.
Valg af operatør
Udover de vigtige funktioner, der allerede er nævnt ovenfor, forventede vi — som infrastrukturdriftsteknikere i Kubernetes — også følgende fra operatørerne:
- deployering fra Git og med ;
- support til pod anti-affinity;
- installation af node affinity eller node selector;
- installation af tolerances;
- muligheder for tuning;
- forståelige teknologier og endda kommandoer.
Uden at gå i detaljer om hvert punkt (spørg i kommentarerne, hvis der er spørgsmål tilbage efter at have læst hele artiklen), vil jeg generelt bemærke, at disse parametre er nødvendige for en mere præcis beskrivelse af specialiseringen af klyngeknuder, så man kan bestille dem til specifikke applikationer. På denne måde kan vi opnå en optimal balance mellem ydeevne og omkostninger.
Nu til selve PostgreSQL-operatørerne.
1. Stolon
fra det italienske firma Sorint.lab i blev betragtet som en form for standard blandt operatørerne for DBMS. Det er et ret gammelt projekt: den første offentlige udgivelse fandt sted allerede i november 2015(!), og GitHub-repositoriet kan prale af næsten 3000 stjerner og 40+ bidragsydere.
Og faktisk er Stolon et fremragende eksempel på gennemtænkt arkitektur:
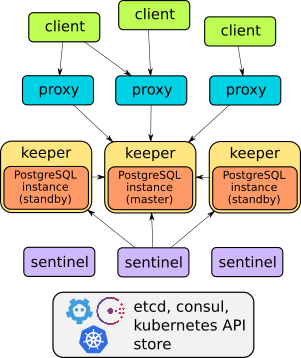
Man kan læse om dette operatørs opbygning i rapporten eller . Generelt set kan det siges, at det kan gøre alt det nævnte: failover, proxy til gennemsigtig adgang for klienter, backups… Desuden giver proxyen adgang gennem et enkelt serviceendpoint — i modsætning til de to andre løsninger, der vil blive gennemgået senere (de har to tjenester til adgang til databasen).
Dog har Stolon , hvilket gør, at man ikke kan implementere det, så man nemt og hurtigt — "som varme bolde" — kan oprette instanser af DBMS i Kubernetes. Administration sker gennem værktøjet stolonctl, implementeringen — gennem Helm-chartet, og brugerdefinerede ressourcer angives i ConfigMap.
På den ene side synes det, at operatøren ikke rigtig er en operatør (da den ikke bruger CRD). Men på den anden side er det et fleksibelt system, der gør det muligt at konfigurere ressourcer i K8s, som du ønsker.
Afslutningsvis virker det for os ikke optimalt at have et separat chart til hver DB. Derfor begyndte vi at lede efter alternativer.
2. Crunchy Data PostgreSQL Operator
, en ung amerikansk startup, så ud til at være et logisk alternativ. Dens offentlige historie begynder med den første udgivelse i marts 2017, og siden da har GitHub-repositoriet fået lidt under 1300 stjerner og 50+ bidragsydere. Den seneste udgivelse i september blev testet for arbejde med Kubernetes 1.15—1.18, OpenShift 3.11+ og 4.4+, GKE og VMware Enterprise PKS 1.3+.
Arkitekturen for Crunchy Data PostgreSQL Operator opfylder også de angivne krav:
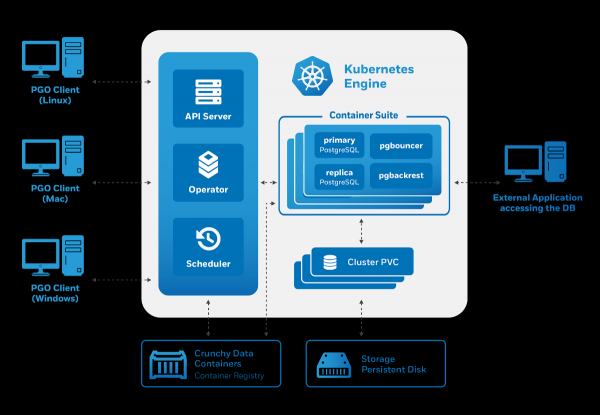
Administration occurs via a utility pgo, but it in turn generates Custom Resources for Kubernetes. Therefore, as potential users, the operator pleased us:
- there's management through CRD;
- convenient user management (also through CRD);
- integration with other components — a specialized collection of container images for PostgreSQL and utilities for working with it (including pgBackRest, pgAudit, extensions from contrib, etc.).
However, attempts to start using the operator from Crunchy Data revealed several problems:
- There was no possibility for tolerations — only nodeSelector was provided.
- The created pods were part of a Deployment, even though we deployed a stateful application. Unlike StatefulSets, Deployments cannot create disks.
This last drawback leads to funny moments: in the test environment, it was possible to run 3 replicas with one disk local storage, resulting in the operator reporting that 3 replicas were running (although this was not the case).
Another feature of this operator is its built-in integration with various auxiliary systems. For example, installing pgAdmin and pgBounce is easy, and preconfigured Grafana and Prometheus are being considered. In a recent improved integration with the project , allowing the operator to offer clear visualization of metrics for PgSQL "out of the box."
Nevertheless, the strange choice of generated Kubernetes resources led us to search for an alternative solution.
3. Zalando Postgres Operator
We have long been familiar with Zalando products: we have experience using Zalenium and, of course, we tried — their popular HA-solution for PostgreSQL. One of its authors, Alexey Klyukin, talked about the company's approach to creating in a broadcast of , and we liked it.
This is the youngest solution among those considered in the article: the first release took place in August 2018. However, despite the small number of formal releases, the project has come a long way, already surpassing the solution from Crunchy Data with over 1300 stars on GitHub and the highest number of contributors (70+).
"Under the hood," this operator uses time-tested solutions:
- Patroni and for management,
- — for backups,
- — as a connection pool.
Sådan præsenteres Zalando-operatorens arkitektur:
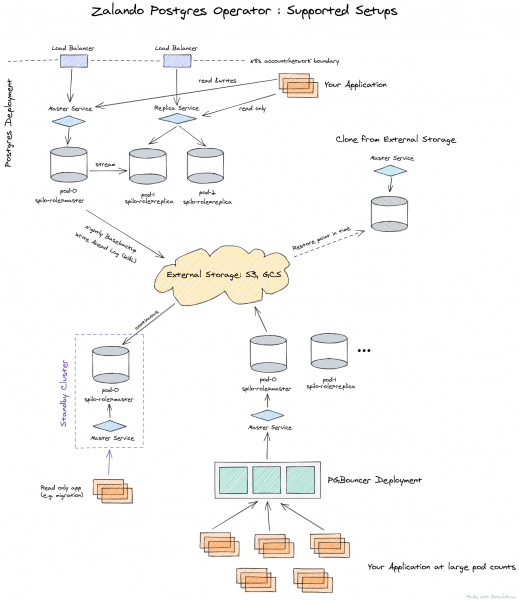
Operatoren administreres fuldt ud via Custom Resources, automatisk opretter StatefulSet fra containere, som derefter kan tilpasses ved at tilføje forskellige sidecar'er til pod'en. Alt dette er en betydelig fordel sammenlignet med operatoren fra Crunchy Data.
Da vi valgte løsningen fra Zalando blandt 3 overvejede muligheder, vil den følgende beskrivelse af dens funktioner blive præsenteret nedenfor, sammen med praksis for anvendelse.
Praksis med Postgres Operator fra Zalando
Deployeringen af operatoren er meget enkel: det er nok at downloade den nyeste release fra GitHub og anvende YAML-filerne fra biblioteket . Som et alternativ kan man også bruge .
Efter installationen bør man tage sig af konfigurationen af . Det sker via ConfigMap postgres-operator i det navnerum, hvor du har installeret operatoren. Når lagrene er konfigureret, kan du deployere dit første PostgreSQL-klynge.
For eksempel ser vores standarddeployering således ud:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Denne manifest deployerer en klynge med 3 instanser med en sidecar i form af , fra hvilken vi indsamler applikationsmetrikker. Som du kan se, er det hele meget simpelt, og hvis ønskes, kan man gøre det bogstaveligt talt ubegribelig mængde klynger.
Det er værd at bemærke webpanelet til administration — . Det leveres sammen med operatoren og gør det muligt at oprette og slette klynger samt arbejde med de backups, som operatoren laver.
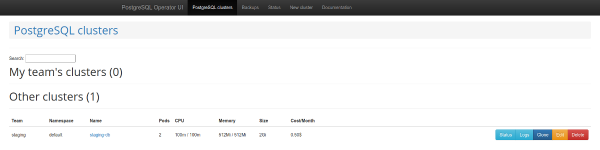
Liste over PostgreSQL-klynger
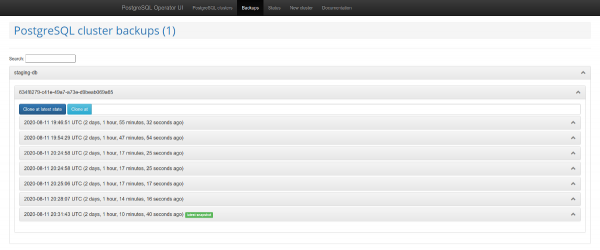
Backupstyring
En anden interessant funktion er understøttelsen af . Denne mekanisme opretter automatisk roller i PostgreSQL, baseret på den modtagne liste over brugernavne. Derefter gør API'et det muligt at returnere en liste over brugere, for hvilke der automatisk oprettes roller.
Problemer og deres løsninger
Dog brugen af operatøren viste hurtigt, at der var flere væsentlige ulemper:
- mangel på støtte til nodeSelector;
- umulighed for at deaktivere backups;
- når man bruger funktionen til at oprette databaser, gives der ingen standardprivilegier;
- der mangler periodisk dokumentation, eller den er ikke opdateret.
Heldigvis kan mange af dem løses. Lad os starte fra slutningen — problemer med dokumentation.
Du vil sandsynligvis opleve, at det ikke altid er klart, hvordan man angiver en backup og hvordan man forbinder backup-bucket til Operator UI. Dette nævnes kort i dokumentationen, og den reelle beskrivelse findes i :
- det er nødvendigt at lave en hemmelighed;
- overføre den til operatøren som et parameter
pod_environment_secret_namei CRD med operatørens indstillinger eller i ConfigMap (det afhænger af, hvordan du har besluttet at installere operatøren).
Men som det viste sig, er det i øjeblikket umuligt. Det er derfor, vi har samlet med nogle yderligere tredjepartsudviklinger. Læs mere om den nedenfor.
Hvis du overfører parametre til operatøren for backup, nemlig — wal_s3_bucket og adgangsnøgler til AWS S3, så vil den tage backup af alt: ikke kun databaser i produktion, men også staging. Det var ikke tilfredsstillende for os.
I beskrivelsen af parametrene for Spilo, som er den grundlæggende Docker-omslag for PgSQL, når man bruger operatøren, blev det klart: man kan overføre parameteren WAL_S3_BUCKET som tom, hvilket derved deaktiverer backups. Desuden, til stor glæde, fandtes der også en , som vi straks accepterede i vores fork. Nu er det nok bare at tilføje enableWALArchiving: false til ressourcen for PostgreSQL-klyngen.
Ja, der var mulighed for at gøre det anderledes ved at køre 2 operatører: en til staging (uden backups) og den anden til produktion. Men sådan kunne vi nøjes med én.
Okay, vi har lært at give adgang til S3 i databaser, og backups begyndte at blive sendt til lageret. Hvordan får man backup-siderne til at fungere i Operator UI?
I Operator UI er det nødvendigt at tilføje 3 variable:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Efter dette vil styringen af backups være tilgængelig, hvilket i vores tilfælde vil forenkle arbejdet med staging, da vi kan levere snapshots fra produktion uden yderligere scripts.
Som en yderligere fordel blev arbejdet med Teams API nævnt og de brede muligheder for at oprette databaser og roller ved hjælp af operatøren. Men de oprettede roller havde ingen standardrettigheder.Derfor kunne en bruger med læserettigheder ikke læse de nye tabeller.
Hvorfor er det sådan? På trods af at koden nødvendige GRANT, anvendes de langt fra altid. Der er 2 metoder: syncPreparedDatabases og syncDatabases. I syncPreparedDatabases — på trods af at der i sektionen preparedDatabases er en betingelse defaultRoles og defaultUsers til oprettelse af roller, — anvendes standardrettighederne ikke. Vi er i gang med at forberede et patch, så disse rettigheder automatisk anvendes.
Og det sidste punkt i de relevante forbedringer for os — , der tilføjer Node Affinity til den oprettede StatefulSet. Vore kunder foretrækker ofte at reducere omkostningerne ved at bruge spot-instanser, og det er tydeligt, at man ikke bør placere databasetjenester på dem. Dette spørgsmål kunne også løses gennem tolerancer, men tilstedeværelsen af Node Affinity giver større sikkerhed.
Hvad kom der ud af det?
Efter at have løst de nævnte problemer, forkede vi Postgres Operator fra Zalando til , hvor det bygges med så nyttige patches. Og for ekstra bekvemmelighed samlede vi også .
Listen over PR'er, der er accepteret i fork:
- ;
- ;
- ;
- .
Det ville være fantastisk, hvis fællesskabet støttede disse PR'er, så de kom ind i upstream med den næste version af operatøren (1.6).
Bonus! Succeshistorie med migration af produktion
Hvis du bruger Patroni, kan du migrere live produktion til operatøren med minimal nedetid.
Spilo gør det muligt at lave standby-klynger via S3-lager med , hvor den binære log PgSQL først gemmes i S3, og derefter hentes af replikken. Men hvad nu hvis du ikke bruger Wal-E i en gammel infrastruktur? Løsningen på dette problem er allerede på Habr.
Logisk replikation af PostgreSQL kommer til hjælp. Men lad os ikke gå ind i detaljerne om, hvordan man opretter publikationer og abonnementer, fordi… vores plan fejlede.
Sagen er, at der var flere belastede tabeller i databasen med millioner af rækker, som desuden konstant blev opdateret og slettet. med copy_data, hvor den nye replik kopierer alt indhold fra masteren, kunne simpelthen ikke følge med masteren. Indholds kopieringen fungerede i en uge, men indhentede aldrig masteren. Til sidst hjalp kolleger fra Avito: man kan overføre data ved hjælp af pg_dump. Jeg vil beskrive vores (lidt modificerede) version af denne algoritme.
Ideen er, at man kan oprette en deaktiveret abonnement knyttet til en specifik replikationsslot, og derefter rette transaktionsnummeret. Der var replikater til produktionen. Dette er vigtigt, fordi replikatet vil hjælpe med at skabe en konsistent dump og fortsætte med at modtage ændringer fra masteren.
I de følgende kommandoer, der beskriver migrationsprocessen, vil følgende betegnelser blive brugt for værter:
- master — den oprindelige server;
- replica1 — stream-replikat på den gamle produktion;
- replica2 — ny logisk replikat.
Migrationsplan
1. Opret abonnement på alle tabeller i skemaet public databasen dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Opret replikationsslot på masteren:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Stop replikationen på den gamle replikat:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Hent transaktionsnummeret fra masteren:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Tag dump fra den gamle replikat. Vi vil gøre dette i flere tråde, hvilket hjælper med at fremskynde processen:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Indlæs dumpet på den nye server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Efter indlæsning af dumpet kan du starte replikationen på stream-replikatet:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Opret abonnement på den nye logiske replikat:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Hent oid af abonnementet:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Antag, at vi har fået oid=1000. Anvend transaktionsnummeret til abonnementet:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Start replikationen:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Kontroller abonnementets status, replikationen skal fungere:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Når replikationen er startet, og databaserne er synkroniseret, kan der foretages en overførsel.
13. Efter at have deaktiveret replikationen, skal sekvenserne rettes. Dette er godt beskrevet .
Takket være denne plan forløb overførslen med minimal forsinkelse.
Konklusion
Kubernetes-operatører gør det muligt at forenkle forskellige handlinger ved at reducere dem til oprettelse af K8s-ressourcer. Men selvom man opnår fantastisk automatisering ved hjælp af dem, er det vigtigt at huske, at det kan medføre en række uventede nuancer, så vælg operatører med omhu.
Efter at have overvejet de tre mest populære Kubernetes-operatører til PostgreSQL, valgte vi projektet fra Zalando. Vi måtte overvinde visse udfordringer, men resultatet var virkelig tilfredsstillende, så vi planlægger at udvide denne erfaring til nogle andre PgSQL-installationer. Hvis du har erfaring med lignende løsninger, vil vi gerne se detaljerne i kommentarerne!
P.S.
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
