

Mit navn er Viktor Yagofarov, og jeg arbejder med udviklingen af Kubernetes-platformen i DomKlik som teknisk leder for udvikling i Ops-teamet (drift). Jeg vil gerne fortælle om vores Dev <-> Ops-processer, om særegenhederne ved at drive et af de største k8s-clustre i Rusland, samt om de DevOps/SRE-praksisser, som vores team anvender.
Ops-teamet
I Ops-teamet arbejder der i øjeblikket 15 personer. Tre af dem ansvar for kontoret, to arbejder i en anden tidszone og er tilgængelige, også om natten. Dermed er der altid nogen fra Ops ved skærmen, klar til at reagere på hændelser af enhver kompleksitet. Vi har ikke nattevagter, hvilket beskytter vores mentale helbred og giver alle mulighed for at få en god nats søvn og tilbringe tid væk fra computeren.
Kompetencerne er forskellige hos alle: netværksspecialister, DBA'er, eksperter i ELK-stakken, Kubernetes-administratorer/-udviklere, overvågningsspecialister, virtualiseringseksperter, hardware-specialister osv. Det, der forener os, er, at hver især i nogen grad kan erstatte en af os: for eksempel introducere nye noder i k8s-clusteret, opdatere PostgreSQL, skrive CI/CD-pipelines + Ansible, automatisere noget i Python/Bash/Go, forbinde hardware i datacenteret. Stærke kompetencer inden for et bestemt område hindrer ikke en ændring af arbejdsretning og begyndelsen på at udvikle sig inden for et andet område. For eksempel startede jeg i virksomheden som PostgreSQL-specialist, men nu er mit primære ansvarsområde Kubernetes-clustre. I teamet bliver enhver vækst kun værdsat, og der er en stærk følelse af tolerance.
Forresten, vi rekrutterer. Kravene til kandidater er ret standard. Personligt er det vigtigt for mig, at personen passer ind i teamet, er konfliktfri, men også kan forsvare sine synspunkter, har lyst til at udvikle sig og ikke er bange for at gøre noget nyt, samt kommer med sine egne ideer. Derudover er færdigheder i programmering med scriptsprog, kendskab til grundlæggende Linux og engelsk nødvendigt. Engelsk er kun for, at personen i tilfælde af problemer kan finde løsningen på nettet på 10 sekunder, og ikke på 10 minutter. Det er svært at finde specialister med dybdegående viden om Linux: det lyder sjovt, men to ud af tre kandidater kan ikke svare på spørgsmålet 'Hvad er Load Average? Hvad består det af?', og spørgsmålet 'Hvordan samler man en core dump fra et C-program' ses som noget fra en superhelteverden... eller dinosaurer. Vi må leve med dette, da folk ofte har andre kompetencer godt udviklet, og vi kan lære dem 'linux'. Svaret på spørgsmålet 'Hvorfor er det nødvendigt for en DevOps-engineer at vide alt dette i nutidens skyverden' må vi lade stå uden for artiklen, men hvis jeg skal opsummere med tre ord: det hele er nødvendigt.
Tools-teamet
Tools-teamet spiller en stor rolle i automatiseringen. Deres hovedopgave er at skabe brugervenlige grafiske og CLI-værktøjer til udviklere. For eksempel gør vores interne udvikling Confer det muligt at rulle en applikation ud i Kubernetes med blot nogle få klik med musen, indstille ressourcer, nøgler fra vault osv. Tidligere brugte vi Jenkins + Helm 2, men vi måtte udvikle vores eget værktøj for at undgå copy-paste og bringe ensartethed ind i softwarelivscyklussen.
Ops-teamet skriver ikke pipelines for udviklerne, men kan rådgive om alle spørgsmål relateret til deres skrivning (nogle har stadig Helm 3).
DevOps
Når det kommer til DevOps, ser vi det på denne måde:
Dev-teamene skriver koden, ruller den ud gennem Confer fra dev -> qa/stage -> prod. Ansvarligheden for at sikre, at koden ikke bremser og ikke genererer fejl, ligger hos Dev- og Ops-teamerne. I dagtimerne skal den pågældende Ops-vagt reagere på hændelser med deres applikation, og om aftenen og natten skal den vagthavende administrator (Ops) vække den vagthavende udvikler, hvis han er sikker på, at problemet ikke ligger i infrastrukturen. Alle metrics og alarmer i monitoreringen vises automatisk eller semi-automatisk.
Ops' ansvarsområde begynder, når applikationen går i produktion, men Dev's ansvar slutter ikke der — vi arbejder på samme projekt og er i samme båd.
Udviklerne rådgiver administratorerne, hvis der er brug for hjælp til at skrive en administrativ mikrotjeneste (f.eks. Go backend + HTML5), og administratorerne rådgiver udviklerne om alle infrastrukturelle spørgsmål eller spørgsmål relateret til k8s.
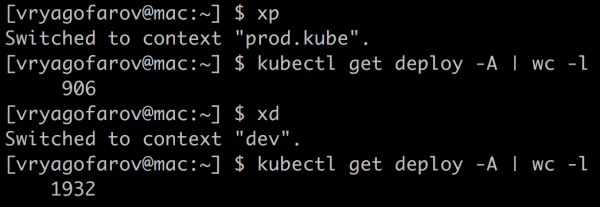
Vi har i øvrigt slet ikke nogen monolit, kun mikrotjenester. Antallet varierer lige nu mellem 900 og 1000 i prod k8s-klusteret, målt på antal. deploymentsAntallet af pods ligger mellem 1700 og 2000. I produktionen er der lige nu cirka 2000 pods.
Jeg kan ikke give præcise tal, da vi overvåger unødvendige mikrotjenester og fjerner dem i et semi-automatisk regime. At holde øje med unødvendige enheder i k8s hjælpes af , hvilket sparer ressourcer og penge.
Ressourcestyring
Overvågning
En solid og informativ overvågning bliver en hjørnesten i driften af et stort kluster. Vi har endnu ikke fundet en universalløsning, der dækker 100 % af alle overvågningsbehov, så vi udvikler periodisk forskellige skræddersyede løsninger i dette miljø.
- Zabbix. Den gode gamle overvågning, som primært er designet til at overvåge den generelle tilstand af infrastrukturen. Den fortæller os, når en node svigter i CPU, hukommelse, disk, netværk osv. Intet overnaturligt, men vi har også en separat DaemonSet af agenter, som vi for eksempel bruger til at overvåge tilstanden af DNS i klusteret: søger efter trægge pods i coredns, tjekker tilgængeligheden af eksterne værter. Det kunne virke unødvendigt, men ved høje trafikmængder er denne komponent et alvorligt svigtpunkt. Tidligere har jeg allerede , hvordan jeg kæmpede med DNS-ydeevnen i klusteret.
- Prometheus Operator. En række forskellige eksportører giver et stort overblik over alle komponenter i klusteret. Derefter visualiserer vi alt dette på store dashboards i Grafana, og til varsler bruger vi alertmanager.
Et andet nyttigt værktøj for os er . Vi skrev det, efter at vi flere gange var stødt på situationen, hvor et teams Ingress-vej blev overskrevet af et andet teams, hvilket forårsagede 50x-fejl. Nu tjekker udviklerne, inden de udruller på produktion, at de ikke rammer nogen, og for mit team er det et godt værktøj til den indledende diagnose af problemer med Ingress. Sjovt nok blev det først skrevet til administratorer og så ret "klodset" ud, men efter at værktøjet blev populært blandt udviklingsteams, har det gennemgået en stor transformation og ser ikke længere ud som "en administrator lavede en webgrænseflade til administratorer". Snart vil vi opgive dette værktøj, og sådanne situationer vil blive valideret før udrulning af pipeline.
Teamressourcer i "Kuben"
Inden vi går videre til eksemplerne, er det værd at forklare, hvordan vi tildeler ressourcer til mikrotjenester.
For at forstå, hvilke teams og i hvilke mængder der bruger deres ressourcer (CPU, hukommelse, lokal SSD), tildeler vi hver team sin egen namespace i "Kuben" og begrænser dens maksimale kapaciteter på CPU, hukommelse og disk, efter at vi har diskuteret teamernes behov. Derfor vil et team, i almindelighed, ikke blokere for udrulningen af hele klyngen ved at tildele sig tusinder af kerner og terabytes af hukommelse. Adgang til namespace tildeles gennem AD (vi bruger RBAC). Namespace og deres grænser tilføjes gennem en pull-request i GIT-repositoriet, og derefter udrulles alt automatisk gennem en Ansible-pipeline.
Eksempel på ressourceallokering til et team:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Requests og limits
I "Kuben" Request — er det antal, der garanteret er reserveret til ressourcer under pod (en eller flere Docker-containere) i klyngen. Limit — er den ikke-garanterede maksimum. Ofte kan man se på graferne, hvordan et team har sat for mange requests for alle deres applikationer og ikke kan udrulle en applikation i "Kuben", da alle request’ene allerede er "brugte" under deres namespace.
Den rette måde at komme ud af en sådan situation på: se på det reelle ressourceforbrug og sammenligne det med det anmodede antal (Request).
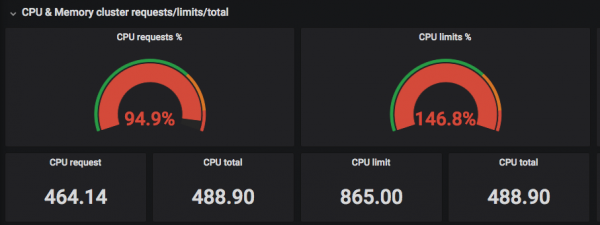
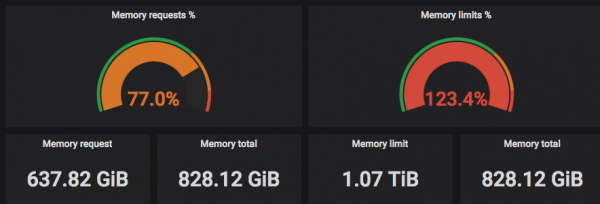
På skærmbillederne ovenfor er det synligt, at de "anmodede" (Requested) CPU’er tilpasser sig det reelle antal tråde, mens Limits kan overstige det reelle antal CPU-tråde =)
Lad os nu se nærmere på en namespace (jeg har valgt namespace kube-system - system namespace til komponenterne af "Kuben") og se på forholdet mellem det reelt anvendte CPU-tid og hukommelse i forhold til det ønskede:
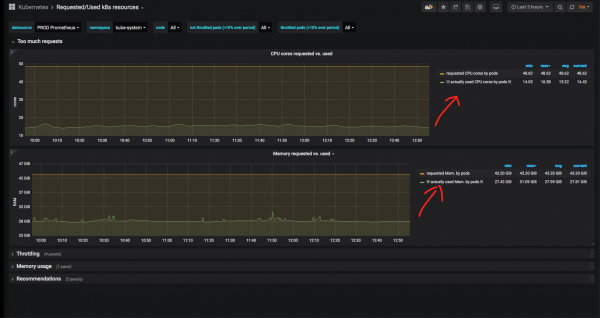
Det er tydeligt, at der er reserveret meget mere hukommelse og CPU til systemtjenester, end der reelt anvendes. I tilfældet med kube-system er dette berettiget: tidvis har nginx ingress controller eller nodelocaldns oplevet spidsbelastning på CPU og indtaget en hel del RAM, så en sådan buffer er berettiget her. Derudover kan vi ikke stole på graferne fra de seneste 3 timer: det er ønskeligt at se historiske metrikker over en længere periode.
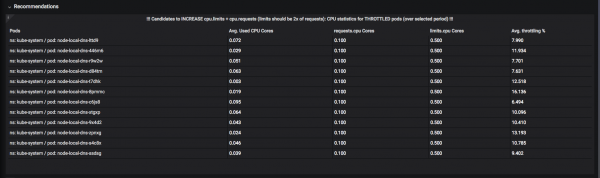
Der er udviklet et system med "anbefalinger". For eksempel kan vi her se, hvilke ressourcer der ville være bedst at hæve "grænserne" (øverste tilladte grænse) for, så vi ikke oplever "throttling": det øjeblik, hvor CPU eller hukommelse allerede er brugt op inden for den tildelte tidskvote og venter på, at det bliver "afrimmet":
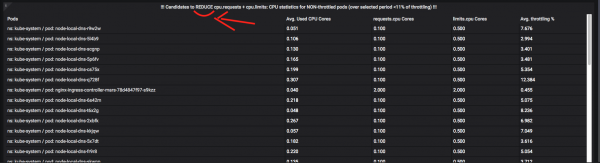
Og her er pods, som burde dæmpe deres appetit:
Om throttling + overvågning af ressourcer kan blive emnet for mange artikler, så stil spørgsmål i kommentarerne. I få ord kan jeg sige, at opgaven med at automatisere sådanne metrikker er ret kompleks og kræver meget tid og finjustering med "vindues" funktioner og "CTEs" i Prometheus / VictoriaMetrics (disse termer er sat i citationstegn, da der næsten ikke findes noget sådant i PromQL, og det bliver nødvendigt at konstruere skrækkelige forespørgsler, som strækker sig over flere skærme og optimere dem).
Som resultat har udviklerne værktøjer til at overvåge deres namespaces i "Kuben", og de kan selv vælge, hvor og hvornår de kan "beskære" ressourcerne for hvilke applikationer, og hvilke pods der kan få lov at bruge hele CPU'en hele natten.
Metodologier
I virksomheden, som nu er moderne, følger vi DevOps og SRE-praksis. Når der i virksomheden er 1000 mikroservices, omkring 350 udviklere og 15 administratorer til hele infrastrukturen, er det nødvendigt at være "moderne": bag alle disse "buzzwords" gemmer sig et presserende behov for at automatisere alt, og administratorerne må ikke være flaskehalsen i processerne.
Som Ops leverer vi forskellige metrikker og dashboards til udviklerne, relateret til svartiderne for tjenesterne og deres fejl.
Vi bruger metodologier som: , og , ved at kombinere dem. Vi forsøger at minimere antallet af dashboards, så man ved et enkelt blik kan se, hvilken service der nedgraderer (for eksempel svarkoder pr. sekund, svar tider i 99. percentilen), osv. Så snart der er behov for nye metrikker til de fælles dashboards, tegner vi dem og tilføjer dem straks.
Jeg har ikke tegnet grafer i en måned. Det er sikkert et godt tegn: det betyder, at de fleste «ønsker» allerede er implementeret. Der var tidspunkter, hvor jeg mindst tegnede en ny graf hver dag i løbet af ugen.
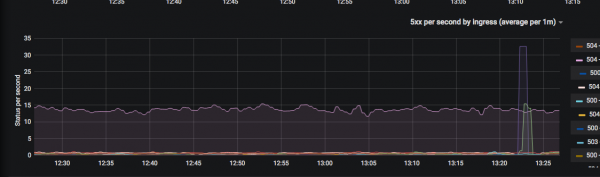
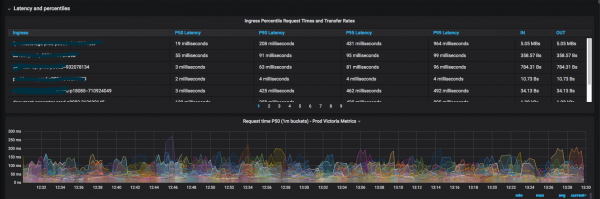
Det resulterende resultat er værdifuldt, fordi udviklerne nu sjældent går til administratorerne med spørgsmål om «hvor man kan se en metrik».
Implementering Service Mesh er lige om hjørnet og skal gøre alles liv meget nemmere; kollegerne fra Tools er allerede tæt på at implementere den abstrakte «sunde Istio»: livscyklussen for hver HTTP(s)-anmodning vil være synlig i overvågningen, og man vil altid kunne forstå «hvor det gik galt» ved inter-service (og ikke kun) interaktion. Tilmeld dig nyhederne fra DomKliks hub. =)
Understøttelse af Kubernetes-infrastruktur
Historisk set har vi brugt en patched version Kubespray — Ansible-rolle til implementering, udvidelse og opdatering af Kubernetes. På et tidspunkt blev understøttelsen af non-kubeadm installationer fjernet fra hovedgrenen, og overgangen til kubeadm blev ikke foreslået. Resultatet blev, at Southbridge lavede sin egen fork (med støtte til kubeadm og hurtige løsninger på kritiske problemer).
Opdateringsprocessen for alle k8s-klynger ser således ud:
- Vi tager Kubespray fra Southbridge, tjekker mod vores gren, mergen.
- Vi ruller opdateringen ud i Stress-«Kube».
- Vi ruller opdateringen ud én node ad gangen (i Ansible er det «serial: 1») i Dev-«Kube».
- Opdaterer Prod lørdag aften én node ad gangen.
I fremtiden er der planer om at erstatte Kubespray med noget hurtigere og gå over til kubeadm.
Vi har tre «Kuber»: Stress, Dev og Prod. Vi planlægger at starte en til (hot standby) Prod-«Kube» i det andet datacenter. Stress og Dev lever i «virtual machines» (oVirt for Stress og VMWare cloud for Dev). Prod-«Kube» lever på «bare metal»: det er ens noder med 32 CPU tråde, 64-128 Gb RAM og 300 Gb SSD RAID 10 — i alt er der 50 stykker. Tre «tynde» noder er tildelt til «masterne» Prod-«Kubes»: 16 Gb RAM, 12 CPU tråde.
Til produktionen foretrækker vi at bruge «bare metal» og undgå unødvendige lag såsom OpenStack: vi har ikke brug for «støjende naboer» og CPU steal time. Og kompleksiteten i administrationen fordobles ved in-house OpenStack.
Til CI/CD af 'Kube'- og andre infrastrukturelle komponenter bruger vi en separat GIT-server, Helm 3 (vi overgik forholdsvis smertefuldt fra Helm 2, men er meget glade for muligheden atomic), Jenkins, Ansible og Docker. Vi elsker feature-branches og deployment til forskellige miljøer fra det samme repository.
Konklusion
Sådan ser DevOps-processen i virksomheden DomClick ud fra en driftsingeniørs perspektiv. Artiklen blev mindre teknisk, end jeg havde forventet: så hold øje med DomClicks nyheder på Habr: der vil komme mere 'hardcore' indhold om Kubernetes og andet.
Kilde: habr.com
