

Vi har allerede fortalt om , som muliggør udvikling af distribuerede applikationer og pakning af dem. Der er kun en lille ting tilbage: at lære at deployere disse applikationer og styre dem. Frygt ikke, vi har tænkt på alt! Vi har samlet alle bedste praksis for arbejde med Tarantool Cartridge og skrevet , der vil installere pakken på serverne, starte instanserne, samle dem i et cluster, konfigurere autorisation, bootstrappe vshard, aktivere automatisk failover og patcher clusterkonfigurationen.
Interesseret? Så følg med, vi vil fortælle og vise alt.
Lad os starte med et eksempel
Vi vil kun gennemgå en del af funktionaliteten af vores rolle. Den fulde beskrivelse af alle dens muligheder og indgangsparametre kan du altid finde i . Men det er bedre at prøve én gang end at se hundrede gange, så lad os deployere en lille applikation.
Tarantool Cartridge har til at oprette en lille Cartridge-applikation, som gemmer oplysninger om bankens kunder og deres konti, samt giver en API til at administrere data via HTTP. I denne applikation beskrives to mulige roller: api og storage, der kan tildeles instanser.
Selve Cartridge siger ikke noget om, hvordan man kører processer, den giver kun mulighed for at konfigurere allerede kørte instanser. Resten skal brugeren selv gøre: placere konfigurationsfiler, starte tjenester og konfigurere topologien. Men vi vil ikke gøre alt dette, det vil Ansible gøre for os.
Fra ord til handling
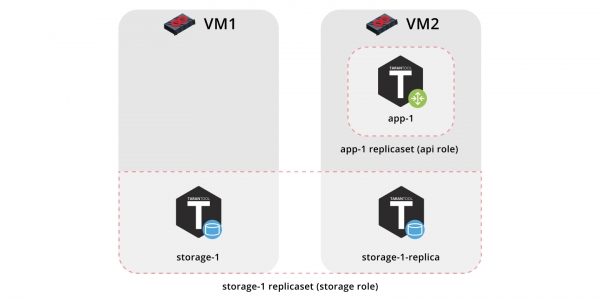
Lad os deployere vores applikation på to virtuelle maskiner og konfigurere en simpel topologi:
- Replicaset
app-1vil implementere rollenapi, som inkluderer rollenvshard-router. Her vil der kun være én instans. - Replicaset
storage-1implementerer rollenstorage(og samtidigvshard-storage), her tilføjer vi to instanser fra forskellige maskiner.
Til at køre eksemplet har vi brug for og (version 2.8 eller ældre).
Selve rollen findes i . Det er et sådant lager, der giver mulighed for at dele sine værker og bruge færdige roller.
Vi kloner repositoriet med eksemplet:
$ git clone https://github.com/dokshina/deploy-tarantool-cartridge-app.git
$ cd deploy-tarantool-cartridge-app && git checkout 1.0.0
Vi starter de virtuelle maskiner:
$ vagrant upInstallerer ansible-rollen Tarantool Cartridge:
$ ansible-galaxy install tarantool.cartridge,1.0.1Kører den installerede rolle:
$ ansible-playbook -i hosts.yml playbook.ymlVi venter på, at playbook'en afsluttes, og går videre til og nyder resultatet:
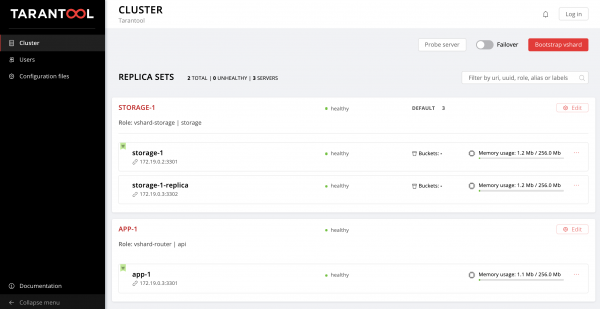
Vi kan begynde at indtaste data. Ret fedt, ikke?
Lad os nu se på, hvordan vi arbejder med dette, og samtidig tilføjer vi endnu et replikasæt til topologien.
Lad os begynde at undersøge
Så hvad skete der?
Vi har oprettet to virtuelle maskiner og kørt en ansible-playbook, der har konfigureret vores cluster. Lad os se indholdet af filen playbook.yml:
---
- name: Deploy my Tarantool Cartridge app
  hosts: all
  become: true
  become_user: root
  tasks:
  - name: Import Tarantool Cartridge role
    import_role:
      name: tarantool.cartridge
Der sker ikke noget interessant her, vi kører ansible-rollen, der hedder tarantool.cartridge.
Alt det vigtigste (specifikt, konfigurationen af clusteret) er i -filen hosts.yml:
---
all:
  vars:
    # common cluster variables
    cartridge_app_name: getting-started-app
    cartridge_package_path: ./getting-started-app-1.0.0-0.rpm  # path to package

    cartridge_cluster_cookie: app-default-cookie  # cluster cookie

    # common ssh options
    ansible_ssh_private_key_file: ~/.vagrant.d/insecure_private_key
    ansible_ssh_common_args: '-o IdentitiesOnly=yes -o UserKnownHostsFile=/dev/null -o StrictHostKeyChecking=no'

  # INSTANCES
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

    app-1:
      config:
        advertise_uri: '172.19.0.3:3301'
        http_port: 8182

    storage-1-replica:
      config:
        advertise_uri: '172.19.0.3:3302'
        http_port: 8183

  children:
    # GROUP INSTANCES BY MACHINES
    host1:
      vars:
        # first machine connection options
        ansible_host: 172.19.0.2
        ansible_user: vagrant

      hosts:  # instances to be started on the first machine
        storage-1:

    host2:
      vars:
        # second machine connection options
        ansible_host: 172.19.0.3
        ansible_user: vagrant

      hosts:  # instances to be started on the second machine
        app-1:
        storage-1-replica:

    # GROUP INSTANCES BY REPLICA SETS
    replicaset_app_1:
      vars:  # replica set configuration
        replicaset_alias: app-1
        failover_priority:
          - app-1  # leader
        roles:
          - 'api'

      hosts:  # replica set instances
        app-1:

    replicaset_storage_1:
      vars:  # replica set configuration
        replicaset_alias: storage-1
        weight: 3
        failover_priority:
          - storage-1  # leader
          - storage-1-replica
        roles:
          - 'storage'

      hosts:   # replica set instances
        storage-1:
        storage-1-replica:
Alt, hvad vi behøver, er at lære at styre instanser og replikasæt ved at ændre indholdet af denne fil. Vi vil derefter tilføje nye sektioner til den. For at undgå forvirring om, hvor de skal tilføjes, kan du tage et kig på den afsluttede version af denne fil, hosts.updated.yml, som findes i eksempeldatabasen.
Håndtering af instanser
I Ansible-termer er hver instans en vært (ikke at forveksle med en fysisk server), dvs. en infrastruktursknude, som Ansible vil styre. For hver vært kan vi angive forbindelsesparametre (såsom ansible_host og ansible_user), samt konfigurationen af instansen. Beskrivelsen af instanserne findes i sektionen hosts.
Lad os se på konfigurationen af instansen storage-1:
all:
  vars:
    ...

  # INSTANSE
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

  ...
I variablen config har vi angivet parametrene for instansen — advertise URI og HTTP port.
Nedenfor er parametrene for instanserne app-1 og storage-1-replica.
Vi skal informere Ansible om forbindelsesparametrene for hver instans. Det virker logisk at gruppere instanserne efter virtuelle maskiner. Derfor er instanserne grupperet i grupper host1 og host2, og i hver gruppe i sektionen vars er angivet værdier ansible_host og ansible_user for en enkelt virtuel maskine. Og i sektionen hosts — værter (de samme er instanser), som tilhører denne gruppe:
all:
  vars:
    ...
  hosts:
    ...
  children:
    # GRUPPER INSTANSER EFTER MASKINER
    host1:
      vars:
        # forbindelsesmuligheder for første maskine
        ansible_host: 172.19.0.2
        ansible_user: vagrant
       hosts:  # instanser der skal startes på første maskine
        storage-1:

     host2:
      vars:
        # forbindelsesmuligheder for anden maskine
        ansible_host: 172.19.0.3
        ansible_user: vagrant
       hosts:  # instanser der skal startes på anden maskine
        app-1:
        storage-1-replica:
Vi begynder at ændre hosts.yml. Vi tilføjer yderligere to instanser, storage-2-replica på den første virtuelle maskine og storage-2 på den anden:
all:
  vars:
    ...

  # INSTANSE
  hosts:
    ...
    storage-2:  # <==
      config:
        advertise_uri: '172.19.0.3:3303'
        http_port: 8184

    storage-2-replica:  # <==
      config:
        advertise_uri: '172.19.0.2:3302'
        http_port: 8185

  children:
    # GRUPPER INSTANSER EFTER MASKINER
    host1:
      vars:
        ...
      hosts:  # instanser der skal startes på første maskine
        storage-1:
        storage-2-replica:  # <==

    host2:
      vars:
        ...
      hosts:  # instanser der skal startes på anden maskine
        app-1:
        storage-1-replica:
        storage-2:  # <==
  ...
Vi kører ansible-playbook:
$ ansible-playbook -i hosts.yml
                   --limit storage-2,storage-2-replica
                   playbook.yml
Læg mærke til indstillingen --limit. Da hver instans i klyngen er en vært i Ansible-termer, kan vi specifikt angive, hvilke instanser der skal konfigureres, når playbooken køres.
Vi logger ind i Web UI og ser vores nye instanser:
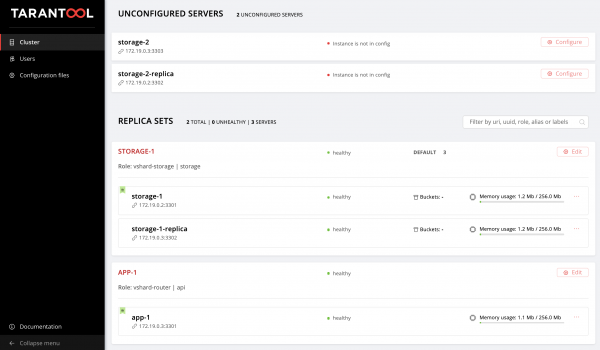
Lad os ikke stoppe her og mestre styring af topologi.
Topology Management
Lad os samle vores nye instanser i et replicaset storage-2. Vi tilføjer en ny gruppe replicaset_storage_2 og beskriver dens variabler med parametrene for replicaset i lighed med replicaset_storage_1. I sektionen hosts angiver vi, hvilke instanser der vil være en del af denne gruppe (dvs. vores replicaset):
---
all:
  vars:
    ...
  hosts:
    ...
  children:
    ...
    # GRUPPER INSTANSSER EFTER REPLIKA SÆT
    ...
    replicaset_storage_2:  # <==
      vars:  # replicaset konfiguration
        replicaset_alias: storage-2
        weight: 2
        failover_priority:
          - storage-2
          - storage-2-replica
        roles:
          - 'storage'

      hosts:   # replicaset instanser
        storage-2:
        storage-2-replica:
Vi kører playbook'en igen:
$ ansible-playbook -i hosts.yml
                   --limit replicaset_storage_2
                   --tags cartridge-replicasets
                   playbook.yml
I parameteren --limit har vi denne gang givet navnet på gruppen, der svarer til vores replicaset.
Lad os se på indstillingen tags.
Vores rolle udfører sekventielt forskellige opgaver, der er markeret med følgende tags:
cartridge-instances: administration af instanser (opsætning, forbindelse til medlemskab);cartridge-replicasets: administration af topologien (styring af replicatsæt og uigenkaldelig fjernelse (expel) af instanser fra klyngen);cartridge-config: administration af andre parametre i klyngen (vshard bootstrapping, automatisk failover tilstand, autorisationsparametre og applikationskonfiguration).
Vi kan eksplicit angive, hvilken del af arbejdet vi ønsker at udføre, så rollen vil springe de øvrige opgaver over. I vores tilfælde ønsker vi kun at arbejde med topologien, derfor angav vi cartridge-replicasets.
Lad os vurdere resultatet af vores anstrengelser. Vi finder det nye replicaset på .
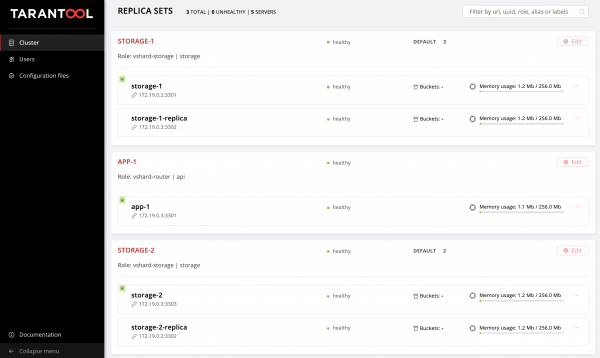
Hurra!
Eksperimentér med at ændre konfigurationen af instanser og replicatsæt og se, hvordan topologien i klyngen ændrer sig. Du kan prøve forskellige driftscenarier, for eksempel eller stigning af memtx_memory. Rollen vil forsøge at udføre dette uden at genstarte instansen for at minimere mulig nedetid for din applikation.
Glem ikke at køre vagrant halt, for at stoppe virtuelbokse, når du er færdig med at arbejde med dem.
Og hvad sker der bag kulisserne?
Her vil jeg forklare nærmere, hvad der skete bag kulisserne i ansible-rollen under vores eksperimenter.
Lad os se på trin for trin deployment af Cartridge-applikationen.
Installation af pakken og opstart af instanser
Først skal du levere pakken til serveren og installere den. I øjeblikket kan rollen arbejde med RPM- og DEB-pakker.
Derefter starter vi instanserne. Her er det meget enkelt: hver instans er en separat systemd-tjeneste. Jeg forklarer med et eksempel:
$ systemctl start myapp@storage-1Denne kommando vil starte instansen storage-1 applikation myapp. Den kørende instans vil søge efter sin i /etc/tarantool/conf.d/. Loggene for instansen kan ses med journald.
Unit-fil /etc/systemd/system/myapp@.sevice for systemd-tjenesten leveres sammen med pakken.
I Ansible er der indbyggede moduler til installation af pakker og styring af systemd-tjenester, så her har vi ikke opfundet noget nyt.
Opsætning af klyngens topologi
Og her begynder det spændende. Enig, det ville være mærkeligt at bruge tid på en speciel ansible-rolle til installation af pakker og opstart systemd-tjenester.
Du kan konfigurere klyngen manuelt:
- Første mulighed: åbner Web UI og trykker på knapperne. Til engangsopstart af flere instanser er det ganske passende.
- Anden mulighed: du kan bruge GraphQl API. Her kan du allerede automatisere noget, for eksempel skrive et script i Python.
- Tredje mulighed (til de stærke af sind): vi logger ind på serveren, forbinder til en af instanserne ved hjælp af
tarantoolctl connectog udfører alle nødvendige manipulationer med Lua-moduletcartridge.
Den primære opgave med vores opfindelse er at udføre denne mest komplekse del af arbejdet for dig.
Ansible gør det muligt at skrive din egen modul og bruge den i en rolle. Vores rolle bruger sådanne moduler til at styre forskellige komponenter i klyngen.
Hvordan virker det? Du beskriver den ønskede tilstand af klyngen i en deklarativ konfiguration, og rollen giver hver modul sin konfigurationssektion. Modulet får den nuværende tilstand af klyngen og sammenligner det med det, der kommer ind. Herefter kører koden via socketen af en af instanserne, hvilket får klyngen til at nå den ønskede tilstand.
Resumé
I dag har vi fortalt og vist, hvordan man deployer din applikation på Tarantool Cartridge og konfigurerer en simpel topologi. Til dette har vi brugt Ansible — et kraftfuldt værktøj, der adskiller sig ved sin brugervenlighed og muligheden for samtidig at konfigurere mange infrastruktur-noder (i vores tilfælde er det instanser af klyngen).
Ovenfor har vi forstået en af de mange måder at beskrive konfigurationen af klyngen ved hjælp af Ansible. Så snart du føler dig klar til at gå videre, skal du studere for at skrive playbooks. Det kan være, du vil finde det nemmere at styre topologien ved hjælp af group_vars og host_vars.
Meget snart vil vi fortælle, hvordan man uigenkaldeligt fjerner (expel) instanser fra topologien, bootstrapper vshard, styrer den automatiske failover-tilstand, konfigurerer godkendelse og patcher den klynge konfiguration. Indtil da kan du selv udforske. og og eksperimentere med at ændre klyngeparametrene.
Hvis noget ikke fungerer, så om problemet. Vi løser det hurtigt!
Kilde: habr.com
