

Oversættelse af Ilya Kosmodemyanskys foredrag fra 2015 "Linux tuning for at forbedre PostgreSQL-ydeevne"
Disclaimer: Jeg bemærker, at dette foredrag er dateret til november 2015 – der er gået mere end 4 år, og der er sket meget siden. Den version, der omtales i foredraget, 9.4, er ikke længere understøttet. I de forløbne 4 år er der blevet udgivet 5 nye versioner af PostgreSQL og 15 nye versioner af Linux-kernen. Hvis vi omskriver disse afsnit, vil resultatet blive et helt andet foredrag. Men her gennemgås den fundamentale tuning af Linux for PostgreSQL, som stadig er relevant i dag.
Mit navn er Ilya Kosmodemyanski. Jeg arbejder for PostgreSQL-Consulting, og nu vil jeg fortælle en smule om, hvad man skal gøre med Linux i forhold til databaser generelt og PostgreSQL specifikt, da principperne er ret ens.
Hvad vil jeg tale om? Hvis du arbejder med PostgreSQL, skal du til en vis grad være UNIX-administrator. Hvad betyder det? Hvis vi sammenligner Oracle og PostgreSQL, skal man i Oracle være 80 % DBA databaseadministrator og 20 % Linux-administrator.
Med PostgreSQL er det lidt mere kompliceret. Med PostgreSQL skal man have en meget bedre forståelse af, hvordan Linux fungerer. Og samtidig skal man følge med i udviklingen, fordi der i den seneste tid er kommet ret mange opdateringer. Nye kerner bliver udgivet, nye funktioner tilføjes, ydeevnen forbedres osv.
Hvorfor taler vi om Linux? Det er ikke blot fordi vi er til Linux-konferencen i St. Petersborg, men fordi det i moderne forhold er en af de mest hensigtsmæssige operativsystemer til drift af databaser generelt og PostgreSQL specifikt – det er Linux. Desværre udvikler FreeBSD sig i en ret underlig retning, hvilket vil medføre problemer hvad angår ydeevne og mange andre ting. Ydeevnen af PostgreSQL på Windows er helt klart et særskilt, alvorligt emne, fordi Windows ikke har den delte hukommelse, som UNIX har, og hele PostgreSQL er afhængig af det, da det er et multiprocessystem.
Og eksotiske systemer som Solaris tror jeg i mindre grad interesserer folk, så lad os komme videre.
Moderne Linux-distributioner har mere end 1.000 syctl-parametre, afhængigt af hvordan kernen er bygget. Hvis vi også ser på forskellige konfigurationer, kan man justere mange aspekter. Der er parametre for filsystemer og hvordan man monterer dem. Hvis der er spørgsmål om, hvordan man starter: hvad man skal aktivere i BIOS, hvordan man konfigurerer hardware osv.
Det er et meget stort emne, som man kan tale om i flere dage, og ikke bare i en kort præsentation, men jeg vil nu fokusere på vigtige punkter, som hvordan man undgår de faldgruber, der med sikkerhed vil forhindre en god brug af databasen på Linux, hvis man ikke retter dem. Og en vigtig detalje er, at mange parametre som standard ikke er indstillet til de indstillinger, der er korrekte for databasen. Det vil sige, at den som standard vil fungere dårligt eller slet ikke fungere.
Hvilke traditionelle tuning mål findes der i Linux? Jeg tænker, at eftersom I alle har med administration af Linux at gøre, så behøver jeg næppe forklare, hvad mål er.
Man kan tune:
- CPU.
- Hukommelse.
- Lager.
- Andet. Dette vil vi tale om til sidst som en afslutning. Selv for eksempel sådanne parametre som energisparepolitikken kan på en meget uforudsigelig og ikke særlig behagelig måde påvirke præstationen.
Hvad er specifikationen for PostgreSQL og databaser generelt? Problemet er, at man ikke kan tune en enkelt lille skrue og se, at præstationen er blevet markant bedre.
Ja, der findes sådanne skruer, men databasen er kompleks. Den interagerer med alle ressourcerne, som serveren har, og foretrækker at interagere fuldt ud. Hvis man ser på de moderne anbefalinger fra Oracle til, hvordan man bruger værts-OS, så er det som i anekdoten om den mongolske astronaut - fodre hunden og røre ved ingenting. Giv databasen alle ressourcerne, så klarer databasen selv resten.
I princippet er situationen med PostgreSQL lige så kompleks. Forskellen er, at databasen ikke selv kan hente alle ressourcer, så nogle steder skal det håndteres på Linux-niveau.
Hovedideen er ikke at vælge et enkelt mål og begynde at tune det, for eksempel hukommelse, CPU eller noget i den stil, men at analysere arbejdsbelastningen og forsøge at forbedre gennemløbsområdet maksimalt, så den arbejdsbyrde, som de dygtige programmører har skabt for os, inklusive vores brugere, kan passere gennem databasen så effektivt som muligt.
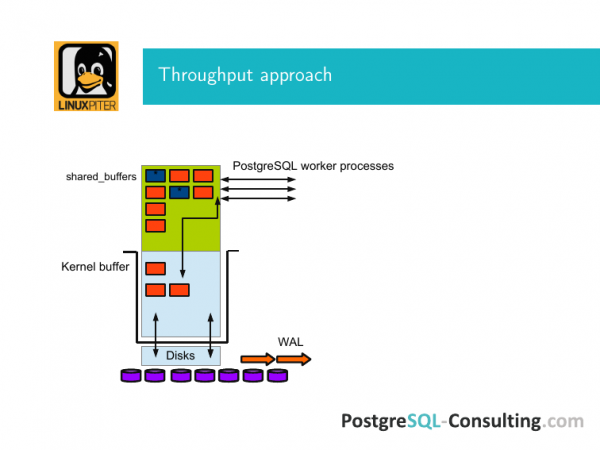
Her er et billede til forklaring af, hvad det er. Der er en Linux OS-buffer og der er delt hukommelse samt delte buffere i PostgreSQL. I modsætning til Oracle arbejder PostgreSQL kun direkte gennem kernens buffer, dvs. for at en side fra disken kan komme ind i dens delte hukommelse, skal den passere gennem kernel-bufferen, og ligesådan tilbage.
Under dette system lever diskene. Jeg har tegnet det som diske. I virkeligheden kan der være en RAID-controller osv.
Og denne input-output sker på den ene eller den anden måde gennem dette.
PostgreSQL er en klassisk database. Indeni findes der sider. Og al input-output sker ved hjælp af sider. Vi løfter blokke op i hukommelsen ved hjælp af sider. Hvis der ikke er sket noget, og vi blot har læst dem, vil de gradvist fra denne cache, fra de delte buffere, synke tilbage til disken.
Hvis vi har ændret noget et sted, vil hele siden blive markeret som snavset. Jeg har markeret dem med blåt her. Og det betyder, at denne side skal synkroniseres med det blokerede lager. Dvs. når vi har gjort den snavset, har vi lavet en post i WAL. Og på et eller andet tidspunkt opstår et fænomen kaldet checkpoint. Og i denne log blev der skrevet information om, at det skete. Det betyder, at alle snavsede sider, der var her på dette tidspunkt i de delte buffere, blev synkroniseret med disken i lageret ved hjælp af fsync gennem kernel-buffer.
Hvad er formålet med det? Hvis der opstår et strømsvigt, vil vi ikke have en situation, hvor alle data går tabt. Den persistente hukommelse, som vi har fået at vide om, er stadig teoretisk i databaser - det er en lysende fremtid, som vi selvfølgelig stræber efter, og som vi godt kan lide, men indtil videre lever de stadig 20 år bagud. Og vi skal selvfølgelig holde øje med det.
Og opgaven med at maksimere båndbredden er at justere på alle disse stadier, så det hele fungerer hurtigt. Den delte hukommelse er primært sidecachen. I PostgreSQL sender vi en select-anmodning om noget, han henter disse data fra disken. De kommer ind i de delte buffere. Derfor, for at det skal fungere bedre, skal der være meget hukommelse.
For everything to work well and quickly, you need to correctly configure the operating system at all stages. Additionally, you must choose balanced hardware, because if there is an imbalance somewhere, you could have a lot of memory, but it will not operate at adequate speed.
Let's take a look at each of these points.
To ensure these pages move back and forth faster, we need to achieve the following:
- Firstly, we need to work more efficiently with memory.
- Secondly, the transition when pages move from memory to disk should be more efficient.
- And thirdly, the disks must be good.
If you have 512 GB of RAM in serveren and all of this ultimately connects to a SATA hard drive without any cache, the entire database server will turn not just into a pumpkin, but into a pumpkin with a SATA interface. You will hit this directly. And nothing will save you.
Regarding the first point with memory, there are three things that can greatly complicate life.
The first of these is NUMA. NUMA is designed to improve performance. Depending on the workload, different things can be optimized. In its new current form, it is not very good for applications like databases that extensively use page cache shared buffers.
In short, how do you know something is wrong with NUMA? You have some unpleasant glitches, suddenly some CPU is overloaded. Meanwhile, you analyze queries in PostgreSQL and see that there is nothing similar there. These queries should not consume CPU so intensively. It can take a long time to catch this. It’s easier to use the right recommendation from the start on how to configure NUMA for PostgreSQL.
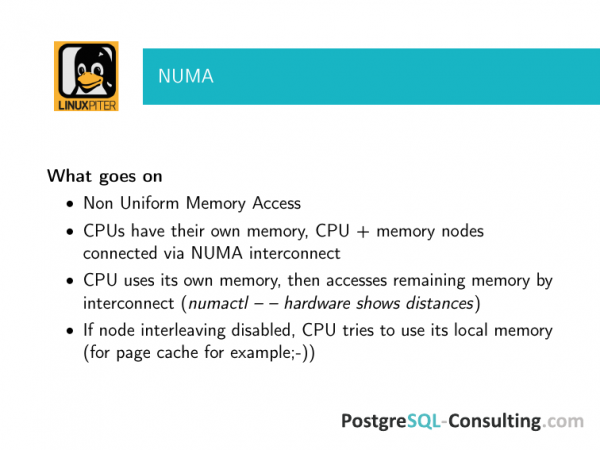
What is actually happening? NUMA stands for Non-Uniform Memory Access. What is its essence? You have a CPU, and next to it is its local memory. And this memory interconnect can access memory from other CPUs.
If you run numactl --hardware, you will get a long output. Among other things, there will be a field for distances. There will be numbers - 10-20, something like that. These numbers represent the number of hops to access and use that remote memory locally. In principle, it’s a good idea. It significantly improves performance under certain loads.
Forestil dig, at du har en CPU, der først forsøger at bruge sit lokale hukommelse, og derefter forsøger at hente anden hukommelse via interconnect til noget. Og på denne CPU kommer hele din page cache fra PostgreSQL – hvor mange gigabyte det nu er. Du får altid den værste situation, fordi der normalt er lidt hukommelse direkte i denne hukommelsesmodul. Al hukommelse, der betjenes, går gennem disse interconnects. Det bliver langsomt og trist. Og du har en processor, der betjener denne node, der konstant er overbelastet. Og adgangstiden til denne hukommelse er dårlig og langsom. Det er den situation, du ikke ønsker, hvis du bruger det til en database.
Derfor er en mere korrekt løsning for databasen, at operativsystemet Linux overhovedet ikke ved, hvad der foregår. Så det vil tilgå hukommelsen som det skal.
Hvorfor er det sådan? Tilsyneladende burde det være omvendt. Det sker af den enkle grund, at vi har brug for meget hukommelse til page cache – flere titusinder, hundreder af gigabyte.
Og hvis vi har allokeret det hele og cached vores data der, vil gevinsten ved at bruge cachen være væsentligt større end gevinsten ved sådan en snedig tilgang til hukommelsen. Og på den måde vil vi vinde uforholdsmæssigt i forhold til, at vi mere effektivt vil tilgå hukommelsen ved at bruge NUMA.
Derfor er der i øjeblikket to tilgange, indtil den lysere fremtid kommer, og databasen selv kan finde ud af, hvilke CPU'er den arbejder med, og hvor den skal hente hvad.
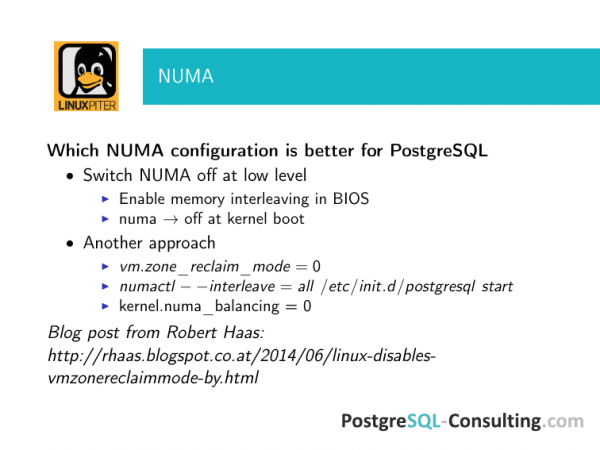
Derfor er den rigtige tilgang helt at deaktivere NUMA, for eksempel ved genstart. I de fleste tilfælde er gevinsterne så store, at spørgsmålet om, hvad der er bedre, slet ikke opstår.
Der er en anden mulighed. Vi bruger den oftere end den første, fordi når en kunde henvender sig til os for support, er det en stor sag for dem at genstarte serveren. Der er forretning, der kører der. Og de oplever problemer på grund af NUMA. Derfor prøver vi at deaktivere det på mindre invasive måder end genstart, men vær her omhyggelig med at kontrollere, at det virkelig er blevet deaktiveret. For som erfaringen viser, fungerer det fint at deaktivere NUMA for PostgreSQL's overordnede proces, men det er ikke nødvendigvis sikkert, at det vil virke. Vi skal kontrollere og sikre, at det virkelig er blevet deaktiveret.
Der er et godt indlæg af Robert Haas. Han er en af udviklerne til PostgreSQL. En af de centrale udviklere bag alle de lavniveau komponenter. Hvis man følger linksene i dette indlæg, beskriver de flere farverige historier om, hvordan NUMA har gjort livet svært for folk. Tag et kig, gennemgå tjeklisten for systemadministratorer over, hvad der skal konfigureres på serveren, så vores database fungerer godt. Disse indstillinger skal noteres og kontrolleres, fordi ellers vil det ikke gå så godt.
Bemærk, at dette gælder for alle de indstillinger, jeg vil tale om. Men normalt samles databaser i master-slave mode for redundans. Glem ikke at foretage disse indstillinger på slave-serveren, for på et tidspunkt vil der opstå en fejl, og du vil skifte til slave, som så bliver master.
I tilfælde af nødssituation, når alt ser skidt ud, ringer telefonen konstant, og chefen kommer styrtende med en stor stok, vil du ikke have tid til at tænke på at kontrollere. Og resultaterne kan være meget triste.
Næste punkt er huge pages. Huge pages er svære at teste isoleret, og der er egentlig ikke megen mening i det, selvom der findes benchmarks, der kan gøre det. De kan let findes på nettet.
Hvad er meningen? Du har en server, der ikke er særlig dyr, og som har meget RAM, for eksempel mere end 30 GB. Du bruger ikke huge pages. Det betyder, at du unægteligt har overhead ved hukommelsesbrugen. Og det overhead er langtfra det mest behagelige.
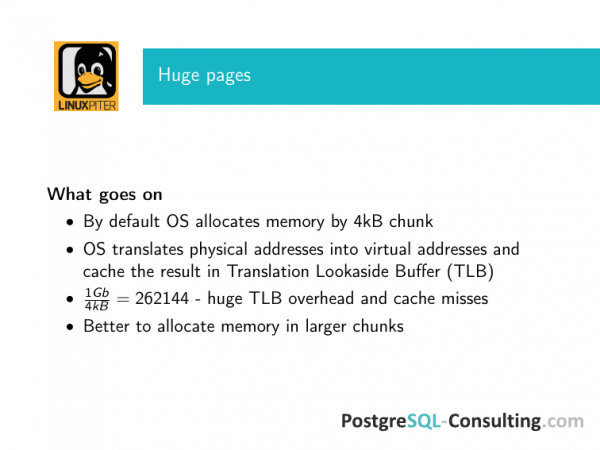
Hvorfor er det sådan? Hvad sker der? Operativsystemet tildeler hukommelse i små bidder. Det er praktisk, det er sådan, det historisk har været. Og hvis man går i dybden, skal OS konvertere virtuelle adresser til fysiske. Og det er ikke den nemmeste proces, så OS cacher resultatet af denne operation i Translation Lookaside Buffer (TLB).
Da TLB er en cache, opstår der alle de problemer, der er forbundet med caching. For det første, hvis du har meget RAM, der er tildelt i små bidder, så bliver bufferen meget stor. Og hvis cachen er stor, tager det længere tid at søge i den. Overheadet er betydeligt, og det optager plads, dvs. noget unødvendigt bruger RAM.
Jo mere cachen vokser i en sådan situation, jo større er chancen for cache misses. Og effektiviteten af denne cache falder hurtigt med større størrelse. Derfor har operativsystemer udviklet en simpel tilgang. I Linux har denne metode længe været anvendt. I FreeBSD er det for nylig blevet introduceret. Men vi taler om Linux. Det er huge pages.
Og her skal det bemærkes, at idéen om huge pages oprindeligt blev fremført af fællesskaber, der inkluderede Oracle og IBM, dvs. producenter af databaser tænkte grundigt over, at dette ville være nyttigt, også for databaser.
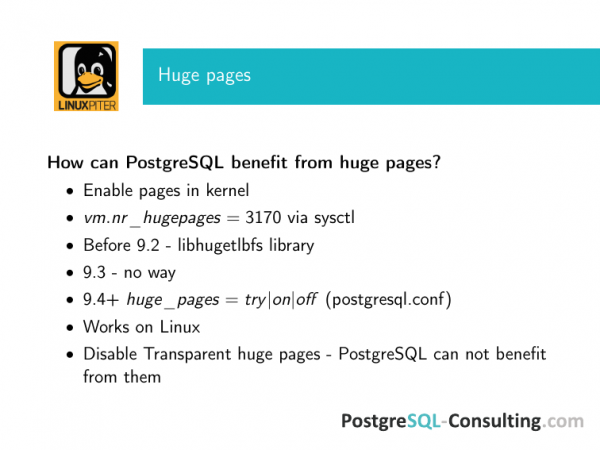
Og hvordan får man det til at fungere med PostgreSQL? For det første skal huge pages være aktiveret i Linux-kernen.
For det andet skal de angives eksplicit med sysctl parameteren - hvor mange der skal være. Tallene her stammer fra en gammel server. Du kan beregne, hvor mange shared buffers du har, så huge pages kan blive indpasset.
Og hvis hele serveren er dedikeret til PostgreSQL, så er et godt udgangspunkt at afsætte enten 25 % af den samlede RAM til shared buffers eller 75 %, hvis du er sikker på, at din database vil passe ind i de 75 %. Dette er dit første udgangspunkt. Hvis du har 256 GB RAM, så vil 64 GB være til shared buffers. Beregn med en smule margen - hvad denne værdi skal sættes til.
Før version 9.2 (hvis jeg ikke tager fejl, fra version 8.2) kunne PostgreSQL integreres med huge pages ved hjælp af et tredjepartsbibliotek. Og dette skal altid gøres. For det første skal kernen kunne allokere huge pages korrekt. Og for det andet skal applikationen, der arbejder med dem, kunne udnytte dem. Det kan ikke gøres uden videre. Da PostgreSQL allokerede hukommelse i stil med system 5, kunne dette gøres med libhugetlbfs - det fulde navn på biblioteket.
I version 9.3 forbedrede vi PostgreSQL's ydeevne ved håndtering af hukommelse og opgav system 5 metoden til hukommelsestildeling. Alle var meget glade, fordi ellers når man prøver at køre to PostgreSQL-instans på én maskine, så siger den, at der ikke er nok delt hukommelse. Og den siger, at man skal justere sysctl. Og der er sådan en sysctl, at man skal genstarte osv. Generelt var alle glade. Men hukommelsestildelingen med mmap brød brugen af huge pages. De fleste af vores kunder bruger store delte buffere. Og vi anbefalede kraftigt ikke at opgradere til 9.3, fordi overheadet begyndte at tælle i gode procenter.
Men community'en lagde mærke til dette problem og i 9.4 arbejdede de virkelig godt med denne udfordring. I 9.4 blev der introduceret en parameter i postgresql.conf, hvor man kan aktivere try, on eller off.
Try er den mest sikre parameter. Ved opstart af PostgreSQL, når den tildeler delt hukommelse, forsøger den at få denne hukommelse fra huge pages. Hvis det ikke er muligt, falder den tilbage til almindelig tildeling. Og hvis du bruger FreeBSD eller Solaris, kan du sætte try, det er altid sikkert.
Hvis on, starter den simpelthen ikke, hvis den ikke kunne tildele fra huge pages. Her er der – hvem der ønsker hvad. Men hvis du har try, så skal du tjekke, at du virkelig har fået tildelt det, du har brug for, fordi der er mange fejlmarginer. Nu fungerer denne funktion kun på Linux.
Endnu et lille bemærkning, før vi går videre. Transparent huge pages handler ikke om PostgreSQL endnu. Den kan ikke drage fordel af dem ordentligt. Og med Transparent huge pages for en arbejdsbyrde, der kræver en stor del delt hukommelse, kommer fordelene kun ved meget store mængder. Hvis du har terabyte hukommelse, kan det spille en rolle. Hvis vi taler om mere almindelige anvendelser, når du har 32, 64, 128, 256 GB hukommelse på maskinen, så er almindelige huge pages Ok, og vi deaktiverer bare Transparent.
Og den sidste ting, der vedrører hukommelse, er ikke direkte relateret til throughput, men den kan virkelig forringe livskvaliteten. Hele båndbredden vil lide stærkt af, at serveren konstant swappes.
Og det vil være meget ubehageligt i en række situationer. Den primære ubehagelighed er, at adfærden i moderne kerner lidt adskiller sig fra de ældre Linux-kerner. Og dette er noget, man helst vil undgå, fordi når vi taler om at arbejde med swap, ender det ikke med en rettidig ankomst af OOM-killeren. Og en OOM-killer, der ikke kommer til tiden og afslutter PostgreSQL, er ubehageligt. Dette får alle til at opdage det, dvs. op til den sidste bruger.
Hvad sker der? I har en stor mængde RAM, alt fungerer godt. Men af en eller anden grund hænger serveren i swap og bliver langsom på grund af det. Det virker som om, der er masser af hukommelse, men sådan går det.
Tidligere rådgav vi at sætte vm.swappiness til nul, dvs. deaktivere swap. Det så ud som om, at 32 GB RAM og de tilsvarende delte buffere var en enorm mængde. Hovedformålet med swap er, at der er et sted at smide en kerne, hvis vi falder fra. Men det blev ikke længere udført. Og hvad skal man så gøre med denne kerne? Det er allerede et problem, hvor det ikke er helt klart, hvorfor swap er nødvendigt, især i så stort omfang.
Men i nyere, dvs. i de tredje versioner af kernen, er adfærden ændret. Og hvis man sætter swap til nul, dvs. slukker det, vil OOM-killeren på et tidspunkt komme, selv med en vis mængde RAM tilbage, for at dræbe de mest intensive forbrugere. Fordi den vil vurdere, at med sådan en arbejdsbelastning har vi kun lidt tilbage, og vi vil gå ned, dvs. ikke dræbe et systemprocess, men dræbe noget mindre vigtigt. Dette mindre vigtige vil være en intens forbruger af delt hukommelse, nemlig postmaster. Og derefter vil det være godt, hvis databasen ikke skal genskabes.
Derfor er standardsætningen nu, så vidt jeg husker, for de fleste distributioner omkring 6, dvs. hvornår man skal begynde at bruge swap afhængigt af hvor meget hukommelse der er tilbage. Vi rådgiver nu at sætte vm.swappiness = 1, fordi det næsten slukker for det, men ikke giver de samme effekter som en uventet ankommet OOM-killer, der afslutter det hele.
Hvad sker der nu? Når vi taler om databases ydeevne og gradvist kommer til diskene, begynder alle at gribe hovedet. For det er en sandhed, som vi har kendt siden barndommen: diske er langsomme, og hukommelse er hurtig. Og alle ved, at der vil være problemer med diskydelsen i databasen.
Det primære problem med PostgreSQL's ydeevne, relateret til checkpoint spikes, opstår ikke fordi disken er langsom. Det skyldes snarere, at båndbredden mellem hukommelse og disk ikke er afbalanceret. Og de kan være ubalancerede på forskellige måder. PostgreSQL er ikke konfigureret korrekt, operativsystemet er ikke konfigureret, hardwaren er ikke korrekt, og hardwaren er forkert. Dette problem opstår kun, hvis alt fungerer som det skal, dvs. enten er der ingen belastning, eller indstillingerne og hardwaren er godt tilpasset.
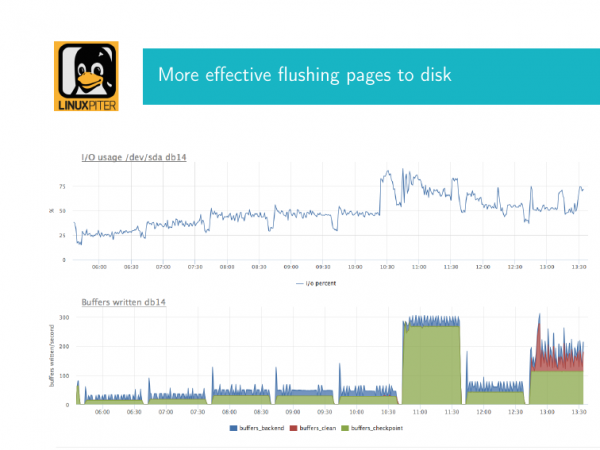
Hvad er det, og hvordan ser det ud? Normalt har folk, der arbejder med PostgreSQL, været igennem dette flere gange. Jeg vil forklare. Som jeg sagde, laver PostgreSQL periodisk checkpoints for at overføre de “beskidte” sider fra den delte hukommelse til disken. Hvis vi har en stor mængde delt hukommelse, så begynder checkpoint at påvirke disken intensivt, fordi det overfører disse sider via fsync. Det kommer ind i kernel buffer og skrives til diskene med fsync. Og hvis omfanget af dette er stort, kan vi observere en ubehagelig effekt, nemlig en meget høj diskudnyttelse.
Her har jeg to billeder. Jeg vil lige forklare, hvad det er. Det er to tidskorrelerede grafer. Den første graf viser diskudnyttelsen. Her når den næsten op på 90 % på dette tidspunkt. Hvis din databaseserver har fysiske diske med en RAID-controller, og udnyttelsen nærmer sig 90 %, er det dårlige nyheder. Det betyder, at hvis det fortsætter, vil det nå 100, og ind- og uddata vil stoppe.
Hvis du har et diskarray, er historien lidt anderledes. Det afhænger af, hvordan det er konfigureret, hvad slags array det er osv.
Samtidig er her konfigureret en grafik fra den interne PostgreSQL-visning, der viser, hvordan checkpoint-processen forløber. Den grønne farve viser, hvor mange buffere, disse 'snuskede' sider, der i øjeblikket kom til dette checkpoint for synkronisering. Og det vigtigste, man her skal vide. Vi kan se, at der er kommet mange sider ind, og på et tidspunkt ramte vi grænsen, dvs. vi har skrevet og skrevet, og det er tydeligt, at diskdrevssystemet er meget optaget. Og vores checkpoint har en stor påvirkning på disken. Ideelt set burde situationen se mere sådan ud, dvs. vi burde have haft mindre skrivning her. Og vi kan justere indstillingerne for at sikre, at det fortsætter sådan. Det vil sige, at udnyttelsen er lille, men der er stadig noget, vi skriver.
Hvad skal der til for at overvinde dette problem? Hvis IO er stoppet under databasen, betyder det, at alle brugere, som forsøger at udføre deres forespørgsler, vil skulle vente.
Set fra et Linux-perspektiv, hvis du har et godt hardware, har konfigureret det korrekt, og har sat PostgreSQL op, så den sjældnere udfører disse checkpoints og spredte dem over tid, så falder du tilbage til de standardparametre, der findes i Debian. For de fleste Linux-distributioner ser situationen sådan her ud: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Hvad betyder det? Siden kerne 2.6 er der en demon, der håndterer flushing. Pdglush, afhængigt af hvilken der anvendes, der beskæftiger sig med baggrunds-kasseren af snuskede sider fra kernel-bufferen og kasserer, når det er nødvendigt at kassere snuskede sider, når baggrunds-kasseringen ikke længere hjælper.
Hvornår opstår baggrunden? Når 10 % af al den tilgængelige RAM, der er på serveren, er optaget af snuskede sider i kernel-bufferen, kaldes der en specifik funktion til at kassere i baggrunden. Hvorfor er den baggrunds? Den tager som parameter, hvor mange sider der skal kasseres. Og eksempelvis kasserer den N sider. Og i en periode går denne enhed i dvale. Og så kommer den tilbage og kasserer et bestemt antal sider igen.
Det er en ganske enkel sag. Her er opgaven som med en swimmingpool, hvor den ene røv fyldes, mens den anden tømmes. Vores checkpoint kom, og hvis den sendte få snuskede sider til kassering, så vil pgflush forsigtigt fordele det hele fra kernel-bufferen.
Hvis disse beskidte sider fortsætter med at opbygge sig, når de når op på 20 %, vil operativsystemet prioritere at skrive dem til disk, fordi strømmen kan gå, og vi vil ende i problemer. Vi vil miste disse data, for eksempel.
Hvad er trikset? Trikset er, at disse parametre i den moderne verden, 20 og 10 % af den samlede RAM i maskinen, langt fra er tilstrækkelige i forhold til kapaciteten af ethvert disk system, du har.
Forestil dig, at du har 128 GB RAM. 12,8 GB kommer til dit disksystem. Uanset hvilken cache eller array du har, kan de ikke håndtere så meget.
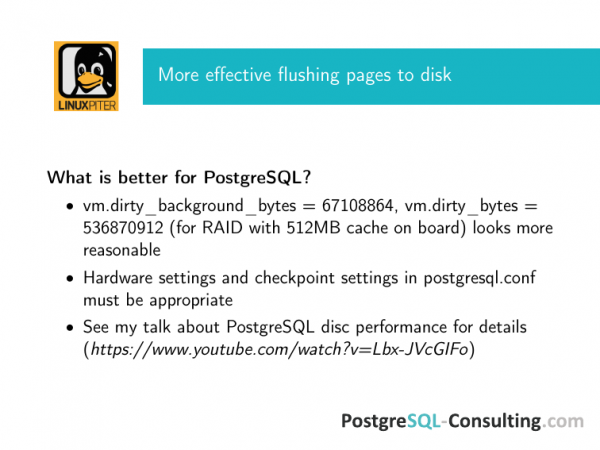
Derfor anbefaler vi, at disse tal straks tilpasses dit RAID-kontrols muligheder. Her er der straks givet en anbefaling til en controller, der har 512 MB cache.
Det regnes meget enkelt. Man kan sætte vm.dirty_background i bytes. Og disse indstillinger ophæver de to foregående. Hvis der er en ratio som standard, eller hvis de, der er i bytes, er aktiveret, vil dem, der er i bytes, virke. Men da jeg er DBA-konsulent og arbejder med forskellige kunder, prøver jeg at være forsigtig, og derfor, hvis det er i bytes, så er det i bytes. Ingen har givet nogen garanti for, at en god admin ikke tilfører mere RAM til serveren, genstarter den, mens tallet forbliver det samme. Bare beregn disse tal for at sikre, at alt passer.
Hvad sker der, hvis du ikke passer ind? Jeg har skrevet, at al flushing stopper effektivt, men i virkeligheden er det en figurativ talemåde. Operativsystemet har et stort problem - det har mange beskidte sider, så den effektive I/O stopper, der genereres af dine klienter, dvs. en applikation er til stede for at sende en SQL-forespørgsel til databasen og venter. Enhver I/O til den - i laveste prioritet, fordi databasen er optaget af checkpoint. Og hvornår det vil være færdigt, er helt uforudsigeligt. Og når du har nået ikke-baggrunds-flushing, betyder det, at al din I/O er optaget af det. Og indtil det er færdigt, kan du ikke gøre noget.
Der er også to vigtige punkter, der går ud over denne præsentation. Disse indstillinger skal matche indstillingerne i postgresql.conf, dvs. checkpoint-indstillinger. Og dit disksystem skal være korrekt konfigureret. Hvis du har cache på RAID, skal der være et batteri på det. Folk køber RAID med god cache uden batteri. Hvis du har SSD i RAID, skal de være serverklasse, der skal være kondensatorer på. Her er en detaljeret tjekliste. På dette link findes min præsentation om, hvordan man konfigurerer diskperformance i PostgreSQL. Der er alle disse tjeklister.
Hvad andet kan virkelig komplicere livet? Det er to parametre. De er relativt nye. De kan som standard være aktiveret i forskellige applikationer. Og de kan gøre livet mindst lige så besværligt, hvis de er forkert aktiveret.
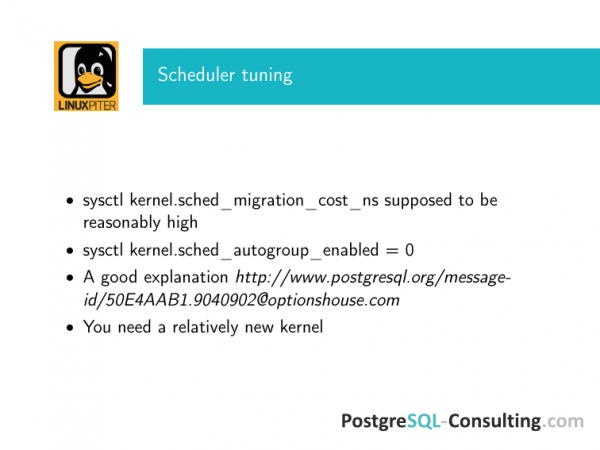
Der er to relativt nye funktioner. De er allerede dukket op i tredje kerner. Det er sched_migration_cost i nanosekunder og sched_autogroup_enabled, som som standard er en.
Og hvordan ødelægger de livet? Hvad er sched_migration_cost? Linux scheduler kan migrere en proces fra en CPU til en anden. Og for PostgreSQL, som udfører forespørgsler, er migration til en anden CPU helt uforståeligt. Set fra operativsystemets perspektiv, når du skifter vinduer mellem openoffice og terminalen, kan det være godt, men for databasen er det meget dårligt. Derfor er en fornuftig politik at sætte migration_cost til en stor værdi, mindst et par tusind nanosekunder.
Hvad vil det betyde for scheduler? Det vil tro, at i denne periode er denne proces stadig 'hot'. Det vil sige, hvis du har en lang transaktion, som beskæftiger sig med noget, vil scheduler forstå dette. Han vil tro, at så længe timeout ikke er passeret, er der ikke behov for at migrere denne proces. Hvis processen udfører noget, vil den ikke blive migreret, den vil roligt fortsætte på den CPU, der er tildelt. Og resultatet bliver fremragende.
Det andet punkt er autogroup. Der er en god idé til specifikke arbejdsbelastninger, der ikke har noget at gøre med moderne databaser – at gruppere processer efter den virtuelle terminal, de er startet fra. Det er praktisk til visse opgaver. I praksis er PostgreSQL et multiprocessing-system med prefork, der starter fra ét terminalvindue. Du har lock writer, checkpoint, og alle dine klientforespørgsler vil blive grupperet på én scheduler, på én CPU. Og de vil alle vente sammen på, at den bliver ledig, hvilket gør, at de forstyrrer hinanden og optager ressourcen længere. Denne situation er slet ikke nødvendig ved sådan en belastning, og derfor skal det slukkes.
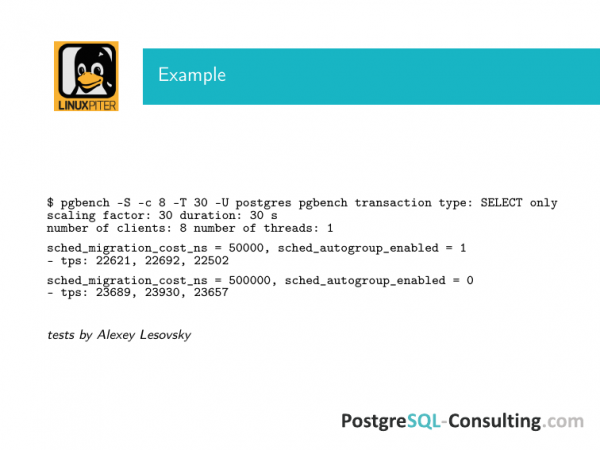
Min kollega Aleksej Lesovskij har lavet tests med et enkelt pgbench, hvor han forøgede migration_cost med en orden og slukkede autogroup. Forskellen på dårlig hardware var næsten 10 %. Der er en diskussion i PostgreSQL-listen, hvor folk præsenterer resultater om, hvordan sådanne ændringer på forespørgsels hastigheden påvirkede 50 %. Der er mange sådanne historier.
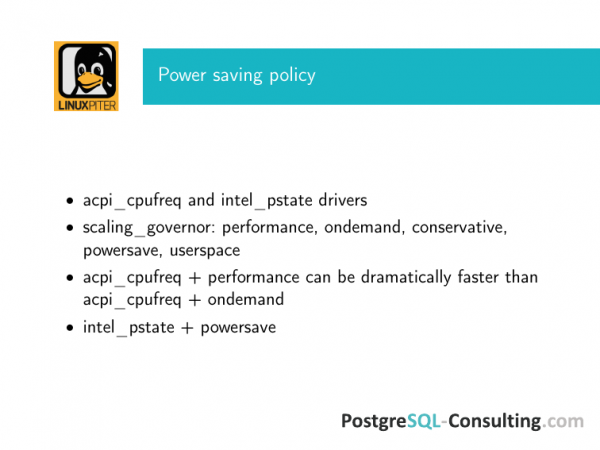
Og til sidst om strømbesparende politik. Det er godt, at Linux nu kan bruges på en bærbar computer. Og den skulle angiveligt have et godt batteriforbrug. Men pludselig viser det sig, at det samme også kan være tilfældet på servere.
Desuden, hvis du lejer servere fra en eller anden host, så sørger de "venlige" hoster ikke for, at du har en bedre ydeevne. Deres mål er at maksimere udnyttelsen af deres hardware. Derfor kan de som standard have aktiveret bærbar energisparetilstand på operativsystemet.
Hvis du bruger dette på en server med en database under intensiv belastning, er dit valg – acpi_cpufreq + performance. Selv med ondemand vil der allerede være problemer.
Intel_pstate er allerede en lidt anden driver. Og nu gives der præference til denne, da den er nyere og fungerer bedre.
Derfor bør governor være performance. Ondemand, powersave og alt det andet – det er ikke for dig.
Resultaterne fra explain analyze i PostgreSQL kan variere med flere ordrer, hvis du aktiverer powersave, fordi CPU'en under databasen vil blive planlagt på en helt uforudsigelig måde.
Disse indstillinger kan være aktiveret som standard. Tjek om de er aktiveret som standard. Det kan være en virkelig stor udfordring.
Og til sidst vil jeg gerne sige tak til gutterne fra vores DBA-team PosgreSQL-Consulting, særligt Maks Boguk og Alexey Lesovsky, som hver dag arbejder hårdt på dette område. Vi forsøger at gøre det så godt som muligt for vores kunder, så deres systemer fungerer optimalt. Det er lidt ligesom med instrukser for luftfartssikkerhed. Her står alt skrevet med blod. Hver eneste skrue er blevet opdaget under forskellige problemer. Jeg deler dem gladeligt med jer.
Spørgsmål:
Tak! Hvis en virksomhed for eksempel ønsker at spare penge og placere databasen og logs for applikationen på én server, eller hvis virksomheden følger den moderne tendens med mikrotjenestearkitekturer, hvor PostgreSQL kører i en container. Hvad er tricket? Sysctl påvirker globalt hele kernen. Jeg har ikke hørt, at sysctl bliver virtualiseret, så de fungerer separat i containeren. Der er kun cgroup, og der er kun kontrol på dele. Hvordan kan man leve med det? Eller hvis du ønsker ydeevne, så kør PostgreSQL på en dedikeret server og optimér den?
Vi har svaret på dit spørgsmål på cirka tre måder. Hvis det ikke handler om en dedikeret server, der kan optimeres osv., så slap af, det vil fungere fint uden de indstillinger. Hvis du oplever en belastning, der kræver disse indstillinger, så vil du komme til den dedikerede server, før du behøver disse indstillinger.
Hvad er problemet? Hvis det er en virtuel maskine, vil du sandsynligvis have mange problemer, f.eks. med, at latency på de fleste virtuelle maskiner er ret inkonsistent. Selv hvis diskens båndbredde er god, kan en enkelt mislykket I/O-transaktion, der ikke påvirker den gennemsnitlige båndbredde nævneværdigt, ske under et checkpoint eller under skrivning til WAL, hvilket kan medføre store problemer for databasen. Og du vil lægge mærke til det, før du støder ind i disse problemer.
Hvis du har NGINX på den samme server, vil du også have det samme problem. Den vil kæmpe om delt hukommelse. Og du vil ikke nå de problemer, der er beskrevet her.
Men på den anden side vil nogle af disse parametre stadig være relevante for dig. For eksempel at sætte dirty_ratio med sysctl, så det ikke bliver så ekstremt – det vil hjælpe uanset hvad. På en eller anden måde vil du have interaktion med disken. Og det vil ske efter en forkert skema. Det er generelt standard de parametre, jeg viste. Og i hvert fald er det bedre at ændre dem.
Der kan være problemer med NUMA. VmWare fungerer for eksempel godt med NUMA med helt modsatte indstillinger. Og her skal man vælge – er det en fysisk server eller ikke.
Jeg har et spørgsmål relateret til Amazon AWS. De har forudkonfigurerede billeder. Et af dem hedder Amazon RDS. Er der nogle tilpassede indstillinger for deres operativsystem?
Der findes indstillinger, men det er andre indstillinger. Her konfigurerer vi operativsystemet fra perspektivet af, hvordan databasen vil bruge dette. Og der er parametre, der bestemmer, hvor vi skal gå nu, sådan en shaping. Altså, vi har brug for så mange ressourcer, og vi vil forbruge dem nu. Efter dette tilslutter Amazon RDS disse ressourcer, og derefter falder ydeevnen. Der er særskilte historier om, hvordan folk begynder at eksperimentere med dette. Nogle gange med ret stor succes. Men det har ikke noget at gøre med OS-indstillingerne. Det er som en slags hacking af skyen. Det er en anden historie.
Hvorfor giver Transparent huge pages ikke effekt sammenlignet med Huge TLB?
De giver ikke. Dette kan forklares på mange måder. Men i virkeligheden giver de slet ikke effekten. Hvad er historien om PostgreSQL? Det allokerer en stor del delt hukommelse ved opstart. Om de er transparente eller ikke – det er fuldstændig irrelevant. Det faktum, at de allokeres ved opstart, forklarer alt. Og hvis der er meget hukommelse og det er nødvendigt at omkonfigurere shared_memory segmentet, så vil Transparent huge pages være relevant. Hos PostgreSQL er det simpelthen afsat en enorm del ved opstart, og der sker ikke noget særlig derefter. Man kan selvfølgelig bruge dem, men der er en risiko for at få beskadiget shared_memory, når den skal genallokeres. PostgreSQL ved jo ikke noget om det.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish