

Et vigtigt aspekt ved drift af distribuerede systemer er fejlhåndtering. Kubernetes hjælper med dette ved at bruge controllere, der overvåger status for dit system og genstarter de tjenester, der er blevet inaktive. Dog kan Kubernetes også tvinge dine applikationer til at stoppe for at sikre systemets samlede levedygtighed. I denne serie vil vi se på, hvordan vi kan hjælpe Kubernetes med at udføre sit arbejde mere effektivt og reducere nedetid for applikationer.
Før implementeringen af containere kørte de fleste applikationer på virtuelle eller fysiske maskiner. Hvis en applikation fejlede eller hang, tog det lang tid at afslutte den kørende opgave og genlæse programmet. I værste fald måtte nogen løse problemet manuelt om natten, på de mest ubelejlige tidspunkter. Hvis en vigtig opgave blev udført af kun 1-2 arbejdsstationer, var en sådan fejl i driften helt uacceptabel.
Derfor begyndte man i stedet for manuel genstart at anvende procesovervågning for automatisk at genstarte applikationen i tilfælde af, at den sluttede uventet. Hvis programmet fejlede, fanger overvågningsprocessen exit-koden og genstarter serveren. Med fremkomsten af systemer som Kubernetes er denne form for reaktion på systemfejl blot blevet integreret i infrastrukturen.
Kubernetes bruger en begivenhedsløkke af "overvågning – registrering af forskelle – udførelse af handlinger" for at sikre, at ressourcerne forbliver operationelle fra containere til selve noderne.
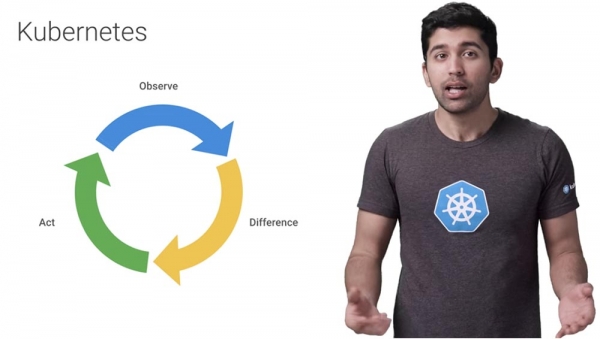
Dette betyder, at du ikke længere behøver at starte procesovervågning manuelt. Hvis en ressource ikke består Health Check, vil Kubernetes automatisk give den en erstatning. Samtidig gør Kubernetes meget mere end blot at overvåge dine applikationers nedbrud. Det kan oprette flere kopier af applikationen til drift på flere maskiner, opdatere applikationen eller samtidig køre flere versioner af din applikation.
Der er mange grunde til, at Kubernetes kan afbryde en helt sund container. For eksempel, når du opdaterer din distribution, vil Kubernetes langsomt stoppe de gamle pods, mens nye startes. Hvis du deaktiverer en node, vil Kubernetes stoppe alle pods på denne node. Endelig, hvis en node løber tør for ressourcer, vil Kubernetes deaktivere alle pods for at frigive disse ressourcer.
Det er derfor meget vigtigt, at din applikation stopper med minimal indvirkning på slutbrugeren og minimal genoprettelsestid. Det betyder, at den skal gemme alle nødvendige data, lukke alle netværksforbindelser, afslutte resterende arbejde og have tid til at udføre andre presserende opgaver, før den slukkes.
I praksis betyder det, at din applikation skal kunne håndtere SIGTERM-beskeden – en procesafslutningssignal, der er standard signalet for kill-kommandoen i Unix-baserede operativsystemer. Når applikationen modtager denne besked, skal den lukke ned.
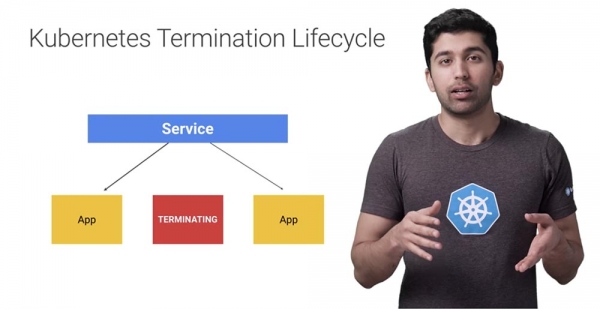
Når Kubernetes har besluttet at stoppe en pod, sker der en række begivenheder. Lad os se på hvert skridt, som Kubernetes tager, når det lukker en container eller pod.
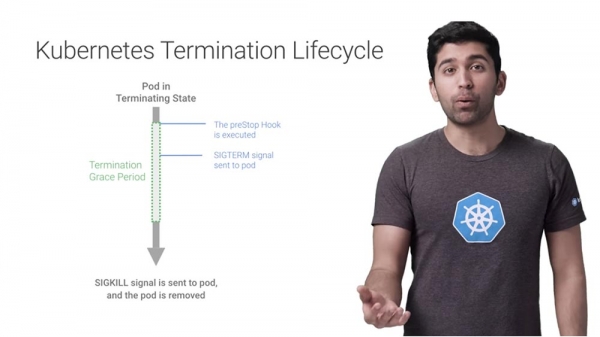
Lad os antage, at vi ønsker at afslutte en af pods. På dette tidspunkt vil den stoppe med at modtage ny trafik – de kørende containere i pod'en vil ikke blive påvirket, men al ny trafik vil være blokeret.
Lad os se på preStop-hooket — en speciel kommando eller HTTP-anmodning, der sendes til containerne i pod'en. Hvis din applikation ikke lukker korrekt ved modtagelse af SIGTERM, kan du bruge preStop til at sikre en korrekt nedlukning.
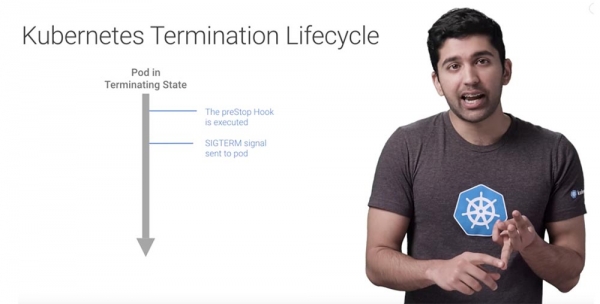
De fleste programmer afslutter deres arbejde korrekt ved modtagelse af SIGTERM-signalet, men hvis du bruger tredjepartskode eller et system, som du ikke kan kontrollere fuldt ud, fungerer preStop-hooket som en fremragende måde at sikre en smidig nedlukning uden at ændre applikationen.
Når dette hook er udført, vil Kubernetes sende et SIGTERM-signal til containerne i pod'en, hvilket giver dem besked om, at de snart vil blive lukket ned. Ved modtagelsen af dette signal vil din kode begynde nedlukningsprocessen. Denne proces kan inkludere stop af eventuelle langvarige forbindelser, såsom forbindelsen til databasen eller WebSocket-strømmen, samt gemme den nuværende tilstand og lignende.
Selv hvis du bruger preStop-hacken, er det meget vigtigt at kontrollere, hvad der sker med din applikation, når du sender den et SIGTERM-signal, hvordan den reagerer, så begivenheder eller ændringer i systemets drift forårsaget af nedlukningen af pod'en ikke kommer som en overraskelse for dig.
I dette øjeblik, før du tager yderligere skridt, vil Kubernetes vente i den angivne tid, kaldet terminationGracePeriodSecond, eller perioden for korrekt nedlukning ved modtagelse af SIGTERM-signalet.
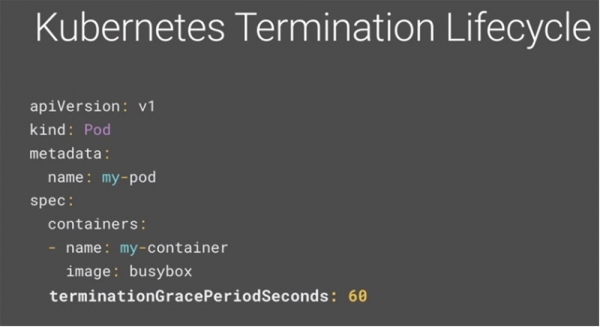
Som standard varer denne periode 30 sekunder. Det er vigtigt at bemærke, at den løber parallelt med preStop-hooken og SIGTERM-signalet. Kubernetes vil ikke vente på, at preStop-hooken og SIGTERM afsluttes — hvis din applikation afslutter, før terminationGracePeriod er ovre, vil Kubernetes straks gå videre til næste trin. Derfor skal du sikre dig, at værdien af denne periode i sekunder ikke er mindre end den tid, der kræves til korrekt nedlukning af pod'en, og hvis den overstiger 30 sekunder, skal du forøge perioden til den nødvendige værdi i YAML. I det givne eksempel er den 60 sekunder.
Og endelig, det sidste skridt — hvis containerne stadig kører efter terminationGracePeriod, vil de sende et SIGKILL-signal og blive tvunget til at lukke. På dette tidspunkt vil Kubernetes også rydde alle andre objekter tilhørende pod'en.
Kubernetes stopper pod'er af mange grunde, så sørg for, at din applikation korrekt afsluttes under alle omstændigheder for at sikre stabil drift af tjenesten.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
