

For each Kubernetes resource, there is the possibility to configure two types of requirements — Requests and Limits. The first describes the minimum node resource requirements necessary to start a container or pod, while the second strictly limits the resources available to the container.
When Kubernetes schedules a pod, it is essential that the containers have sufficient resources for normal operation. If you plan to deploy a large application on a node with limited resources, it is quite possible that it will not function due to insufficient memory or CPU power on that node. In this article, we will look at how to address resource shortages using resource requests and limits.
Requests and Limits are mechanisms that Kubernetes uses to manage resources such as CPU and memory. Requests are what guarantee that a container receives the requested resource. If a container requests a resource, Kubernetes will only schedule it on a node that can provide it. Limits control that the resources requested by the container will never exceed a certain value.
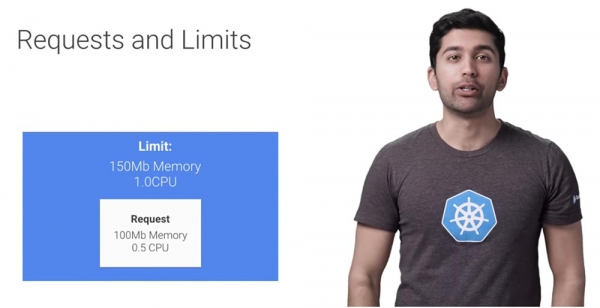
A container can only scale its computational power up to a certain limit, after which it will be restricted. Let's look at how this works. There are two types of resources — CPU and memory. The Kubernetes scheduler uses data about these resources to determine where to run your pods. A typical resource specification for a pod looks like this.
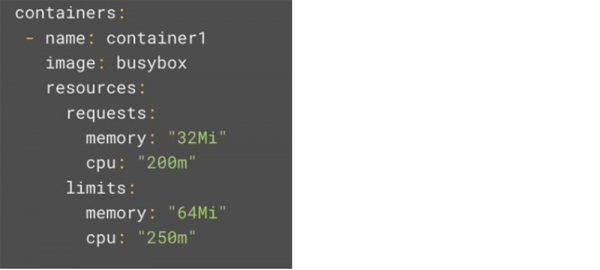
Hver container i en pod kan angive sine egne anmodninger og begrænsninger, og alt dette er additivt. CPU-ressourcerne defineres i millikere. Hvis din container har brug for to fulde kerner til drift, indstiller du værdien til 2000m. Hvis containeren derimod kun har brug for ¼ kerne, vil værdien være 250m. Vær opmærksom på, at hvis du tildeler en CPU-ressourceværdi, der overstiger antallet af kerner på den største node, vil din pod ikke blive planlagt til at køre overhovedet. En lignende situation vil opstå, hvis du har en pod, der kræver fire kerner, men dit Kubernetes-kluster kun består af to primære virtuelle maskiner.
Medmindre din applikation er specielt designet til at udnytte fordelene ved flere kerner (som komplekse videnskabelige beregninger og databaseoperationer), er den bedste praksis at indstille CPU Requests til 1 eller mindre, for derefter at køre flere replikaer for skalerbarhed. Denne løsning vil give systemet større fleksibilitet og pålidelighed.
Når det kommer til CPU-begrænsninger, bliver det mere interessant, da det betragtes som en komprimerbar ressource. Hvis din applikation begynder at nærme sig grænsen for CPU-kraft, vil Kubernetes begynde at dæmpe din container ved at anvende CPU Throttling — nedskæring af CPU-frekvensen. Det betyder, at CPU'en vil blive kunstigt begrænset, hvilket kan give applikationen dårligere ydeevne, men processen vil ikke blive stoppet eller afbrudt.
Hukommelsesressourcerne defineres i bytes. Normalt måles værdien i indstillingerne i mebibytes (Mib), men du kan angive enhver værdi fra bytes til petabytes. Her gælder det samme som for CPU — hvis du anmoder om en mængde hukommelse, der overstiger den tilgængelige hukommelse på dine noder, vil udførelsen af denne pod ikke blive planlagt. Men i modsætning til CPU-ressourcer kan hukommelse ikke komprimeres, fordi der ikke er nogen måde at begrænse dens brug på. Derfor vil udførelsen af containeren stoppe, så snart den overskrider den tildelte hukommelse.
Det er vigtigt at huske, at du ikke kan konfigurere forespørgsler, der overstiger størrelsen af de ressourcer, som dine noder kan levere. Specifikationerne for de delte ressourcer til GKE-virtuelle maskiner kan findes via linkene under denne video.
I en ideel verden vil standardindstillingerne for containeren være tilstrækkelige til, at arbejdsprocesserne forløber glat. Men den virkelige verden er ikke sådan; folk glemmer let at konfigurere ressourceanvendelse, eller hackere opsætter forespørgsler og grænser, der overstiger infrastrukturens faktiske kapacitet. For at forhindre sådanne scenarier kan der konfigureres ressourcekvoter med ResourceQuota og grænseområder med LimitRange.
Efter oprettelsen af navnerum kan de blive låst med kvoter. For eksempel, hvis du har navnerummene prod og dev, anvendes en skabelon, hvor kvoterne for produktion slet ikke findes, mens kvoterne for udvikling er meget strenge. Dette giver prod muligheden for at tage alle eksisterende ressourcer i tilfælde af en pludselig trafikstigning, hvilket helt låser dev.
Ressourcekvoten kan se sådan ud. I dette eksempel er der 4 afsnit – det er de 4 nederste linjer af koden.
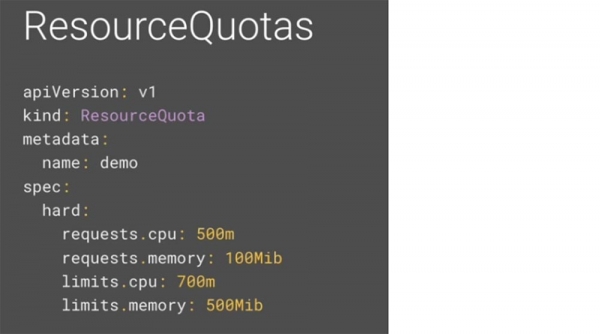
Lad os se nærmere på hver enkelt. Requests.cpu er det maksimale antal kombinerede CPU-ressourceforespørgsler, der kan komme fra alle containere i navnerummet. I dette eksempel kan du have 50 containere med forespørgsler på 10m, fem containere med forespørgsler på 100m eller blot én container med en forespørgsel på 500m. Så længe det samlede antal requests.cpu i dette navnerum er mindre end 500m, er alt i orden.
Den anmodede hukommelse requests.memory er den maksimale kombinerede mængde hukommelsesforespørgsler, som alle containere i navnerummet kan have. Som i det tidligere tilfælde kan du have 50 containere med 2 MiB, fem containere med 20 MiB eller én enkelt container med 100 MiB, så længe det samlede antal anmodet hukommelse i navnerummet er mindre end 100 Mebibyte.
Limits.cpu er den maksimale samlede værdi af CPU-ressourcer, som alle containere i navnerummet kan bruge. Det kan betragtes som grænsen for CPU-ressourceforespørgsler.
Endelig er limits.memory det maksimale beløb af samlet hukommelse, som alle containere i navnerummet kan bruge. Denne begrænsning omfatter de samlede hukommelsesforespørgsler.
Som standard arbejder containere i Kubernetes-clusteret med ubegrænsede beregningsressourcer. Med ressourcetræk kan clusteradministratorer begrænse ressourceforbrug og -oprettelse baseret på navnerum. I navnerummet kan en pod eller container forbruge så meget CPU- og hukommelsesmagt som angivet i navnerummets ressourcetræk. Der er dog bekymringer for, at en enkelt pod eller container kan monopolisere alle tilgængelige ressourcer. For at forhindre denne situation anvendes Limit Range – en politik for begrænsning af ressourcefordeling (for pods eller containere) i navnerummet.
Limit Range giver begrænsninger, der kan:
- sikre minimums- og maksimumsforbrug af beregningsressourcer for hver pod eller container i navnerummet;
- tvinge minimums- og maksimumsforespørgsel af lager Storage Request for hver PersistentVolumeClaim i navnerummet;
- tvinge forholdet mellem forespørgsel Request og begrænsning Limit for ressourcen i navnerummet;
- sætte standard Requests/Limits for beregningsressourcer i navnerummet og automatisk anvende dem i containere ved kørslen.
Dermed kan du oprette en limit range i dit navnerum. I modsætning til kvoten, som gælder for hele navnerummet, anvendes Limit Range på individuelle containere. Dette kan forhindre, at brugere opretter meget små eller derimod gigantiske containere inde i navnerummet. Et limit range kan se således ud.
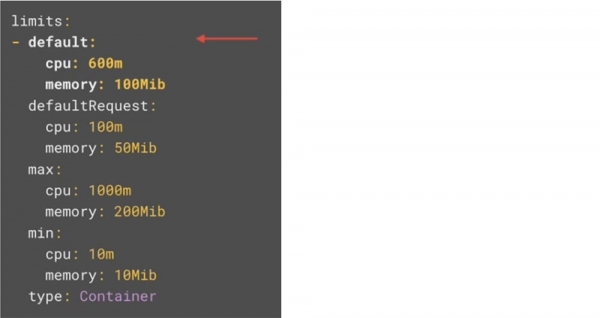
Som i det tidligere tilfælde kan vi her fremhæve 4 sektioner. Lad os se nærmere på hver enkelt.
I default-sektionen fastsættes standardgrænser for containere i en pod. Hvis du angiver disse værdier i limits-området, vil alle containere, for hvilke disse værdier ikke er blevet angivet eksplicit, følge standardværdierne.
I sektionen defaultRequest er der konfigureret standardanmodninger for containeren i pod'en. Igen, hvis du indstiller disse værdier til de maksimale grænser, vil enhver container, hvor disse parametre ikke er angivet, bruge disse værdier som standard.
I sektionen max er de maksimale begrænsninger angivet, som kan indstilles for containeren i pod'en. Værdierne i sektionen default og begrænsningerne for containeren kan ikke indstilles højere end denne grænse. Det er vigtigt at bemærke, at hvis der er indstillet en max værdi, og sektionen default mangler, bliver den maksimale værdi standardværdien.
I sektionen min er de minimale anmodninger angivet, som kan indstilles for containeren i pod'en. Værdierne i sektionen default og anmodningerne for containeren kan ikke indstilles lavere end denne grænse.
Igen er det vigtigt at bemærke, at hvis denne værdi er indstillet, og default værdien ikke er det, så bliver minimumsværdien anmodningen som standard.
Disse ressourceanmodninger bruges af Kubernetes-planlæggeren til at udføre dine arbejdsbelastninger. For at du kan konfigurere dine containere korrekt, er det meget vigtigt at forstå, hvordan dette fungerer. Antag, at du ønsker at køre flere moduler i dit cluster. Givet at pod-specifikationerne er gyldige, vil Kubernetes-planlæggeren bruge cyklisk belastningsbalancering til at vælge en node til at køre arbejdsbelastningen.
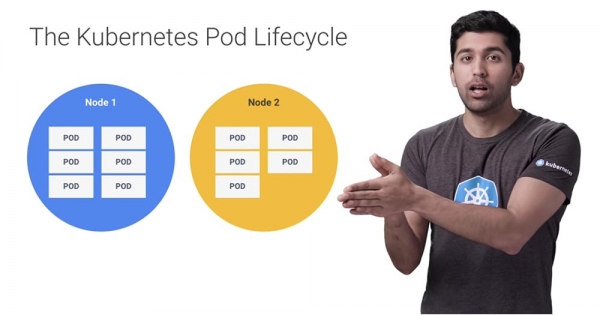
Kubernetes vil kontrollere, om der er tilstrækkelige ressourcer på Node 1 til at håndtere containeranmodningerne fra pod'en, og hvis ikke, vil den gå videre til den næste node. Hvis ingen af noderne i systemet kan opfylde anmodningerne, vil pod'erne gå ind i en ventende tilstand. Med funktioner som automatisk skalering af noder i Google Kubernetes Engine kan GKE automatisk identificere ventetilstanden og oprette yderligere noder.
Hvis der senere skulle opstå overskydende kapacitet på noderne, vil den automatiske skaleringsfunktion reducere antallet af dem for at spare penge. Det er derfor, at Kubernetes planlægger pod'er baseret på anmodninger. Dog kan grænsen være højere end anmodningerne, og i nogle tilfælde kan en node faktisk løbe tør for ressourcer. Vi kalder denne tilstand overcommitment state.
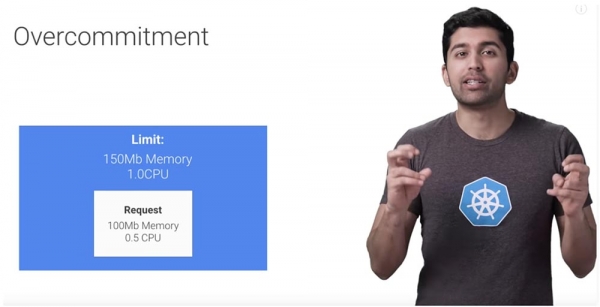
Som jeg allerede har sagt, hvis det handler om processoren, vil Kubernetes begynde at begrænse pods. Hver pod vil få det, den har anmodet om, men hvis den ikke når grænsen, vil throttling træde i kraft.
Når det kommer til hukommelsesressourcer, er Kubernetes tvunget til at tage beslutninger om, hvilke pods der skal slettes, og hvilke der skal beholdes, indtil du frigiver systemressourcer. Ellers vil hele systemet kollaps.
Lad os forestille os et scenarie, hvor du har en maskine, der har nået sin hukommelsesgrænse – hvordan vil Kubernetes så reagere?
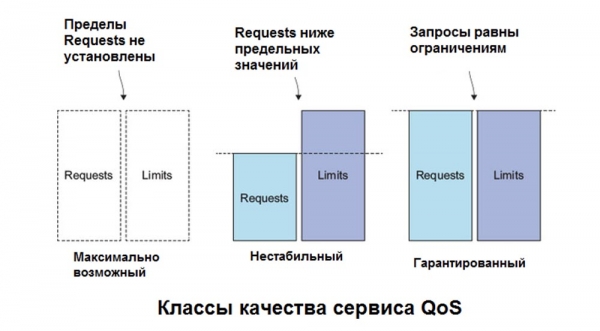
Kubernetes vil lede efter pods, der bruger mere ressourcer, end de anmodede om. Så hvis dine containere overhovedet ikke har anmodninger, betyder det, at de som standard bruger mere, end de bad om, simpelthen fordi de overhovedet ikke har bedt om noget! Sådanne containere bliver de primære kandidater til at blive lukket ned. De næste kandidater er containere, der har opfyldt alle deres anmodninger, men stadig ligger under den maksimale grænse.
Så hvis Kubernetes finder flere pods, der har overskredet deres anmodningsparametre, vil det sortere dem efter prioritet og derefter fjerne de lavest prioriterede moduler. Hvis alle moduler har samme prioritet, vil Kubernetes stoppe de pods, der har overskredet deres anmodninger mere end de andre pods.
I meget sjældne tilfælde kan Kubernetes stoppe pods, der stadig er inden for deres anmodninger. Dette kan forekomme, når sådanne kritiske systemkomponenter som Kubelet-agenten eller Docker begynder at forbruge mere ressourcer, end der er blevet reserveret til dem.
Så i de tidlige faser af små virksomheders drift kan et Kubernetes-kluster fungere glimrende uden installation af ressourceanmodninger og -grænser, men efterhånden som dine teams og projekter vokser, risikerer du at støde på problemer på dette område. At tilføje anmodninger og grænser til dine moduler og navnerum kræver meget lidt ekstra indsats og kan spare dig for mange problemer.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
