

Når du begynder at oprette flere og flere Kubernetes-tjenester, bliver de enkle opgaver, der engang var enkle, mere komplekse. For eksempel kan udviklingsteams ikke oprette tjenester eller implementeringer med det samme navn. Hvis du har tusind pods, vil det tage lang tid bare at opregne dem, for ikke at nævne at sikre ordentlig administration. Og dette er kun toppen af isbjerget.
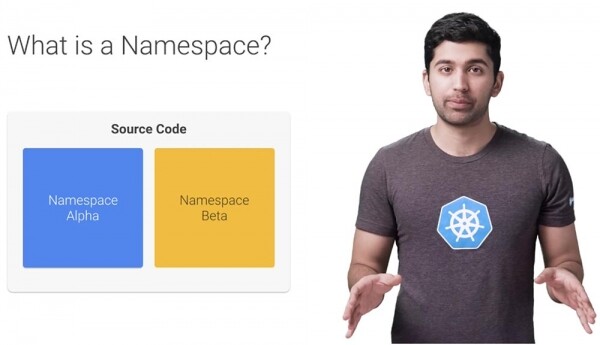
Lad os se på, hvordan navneområder gør det lettere at administrere Kubernetes-ressourcer. Så hvad er et navneområde? Et navneområde kan betragtes som et virtuelt kluster inden for dit Kubernetes-kluster. Du kan have flere isolerede navneområder inden for et enkelt Kubernetes-kluster. De kan virkelig hjælpe dig og dine teams med organisering, sikkerhed og endda systemets præstation.
I de fleste Kubernetes-distributioner kommer klustret "ud af boksen" med et navneområde, der hedder "default". Der findes faktisk tre navneområder, som Kubernetes beskæftiger sig med: default, kube-system og kube-public. I øjeblikket bruges kube-public ikke så ofte.
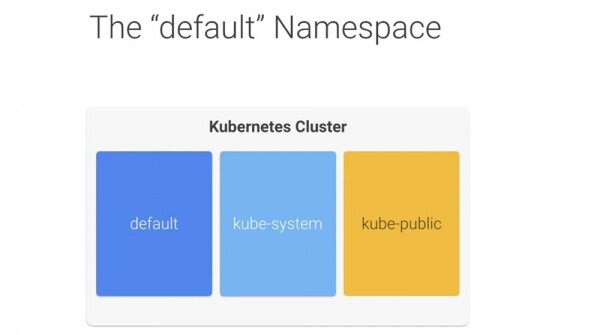
Det er en god idé ikke at røre ved kube-navneområdet, især i et administreret system som Google Kubernetes Engine. Det bruger "default"-navneområdet som stedet, hvor dine tjenester og applikationer oprettes. Der er absolut ikke noget specielt ved det, bortset fra at Kubernetes "ud af boksen" er konfigureret til at bruge det, og du kan ikke slette det. Det er godt til at komme i gang og til systemer med lav kapacitet, men jeg vil ikke anbefale at bruge default-navneområdet i større produktionssystemer. I sidstnævnte tilfælde kan et udviklingsteam nemt overskrive en andens kode og forstyrre et andet teams arbejde uden at være klar over det.
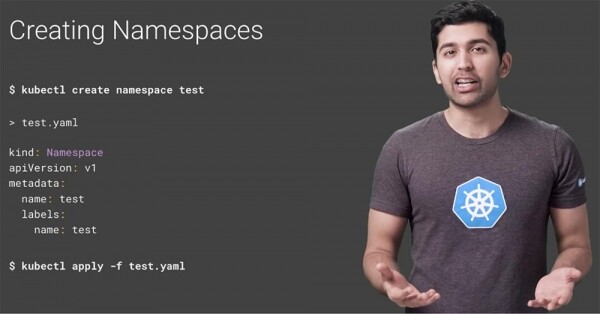
Derfor bør du skabe flere navneområder og bruge dem til at segmentere dine tjenester i administrerede enheder. Et navneområde kan oprettes med en enkelt kommando. Hvis du vil oprette et navneområde med navnet test, skal du bruge kommandoen $ kubectl create namespace test eller blot oprette en YAML-fil og bruge den ligesom enhver anden Kubernetes-ressource.
For at se alle navneområder kan du bruge kommandoen $ kubectl get namespace.
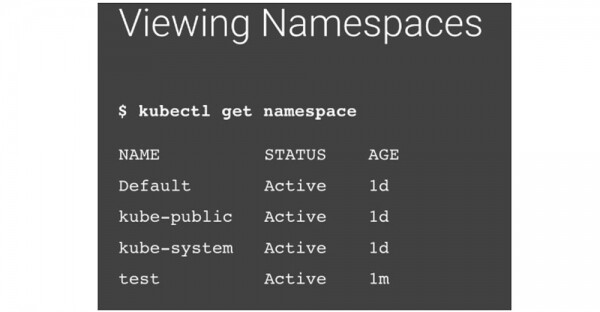
Når du har udført dette, vil du se tre indbyggede navnerum og et nyt navnerum ved navn «test». Lad os se på en enkel YAML-fil, der er beregnet til at oprette en pod. Du vil bemærke, at der ikke er nogen omtale af navnerummet i den.
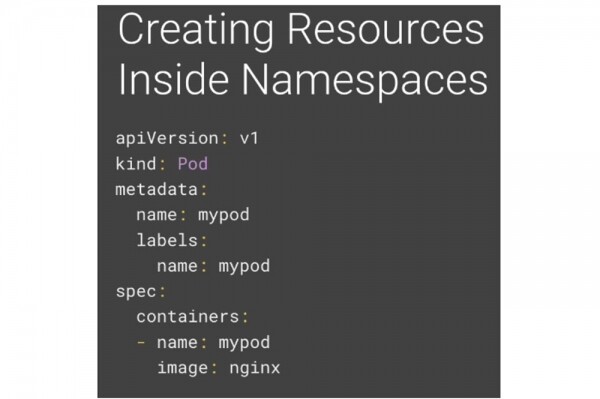
Hvis du bruger kubectl til at køre denne fil, vil den oprette modulet mypod i det aktuelle aktive navnerum. Dette vil være standardnavnerummet, indtil du ændrer det. Der er to måder at fortælle Kubernetes, hvilket navnerum du ønsker at oprette din ressource i. Den første måde er at bruge navnerum-flaget, når du opretter ressourcen.

Den anden måde er at angive navnerummet i YAML-deklarationen.
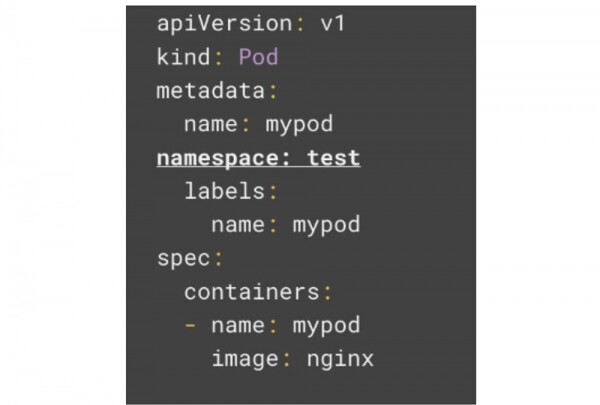
Hvis du angiver navnerummet i YAML, vil ressourcen altid blive oprettet i dette navnerum. Hvis du forsøger at bruge et andet navnerum med navnerum-flaget, vil kommandoen fejle. Nu, hvis du prøver at finde din pod, vil du ikke være i stand til at gøre det.
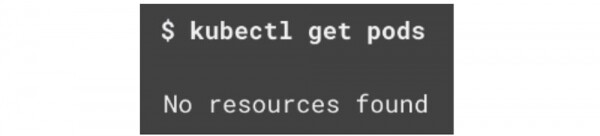
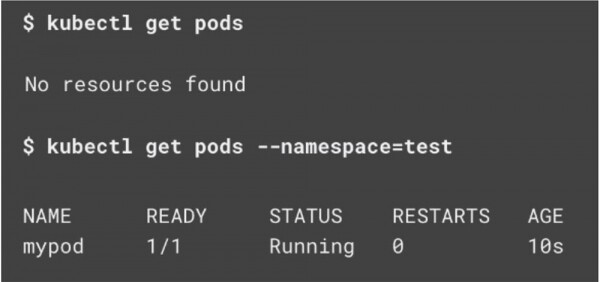
Dette skyldes, at alle kommandoer køres uden for det aktuelle aktive navnerum. For at finde din pod skal du bruge navnerum-flaget, men det kan hurtigt blive besværligt, især hvis du arbejder som udvikler i en gruppe, der bruger sit eget navnerum og ikke ønsker at bruge dette flag for hver enkelt kommando. Lad os se på, hvordan vi kan løse dette.
Som standard hedder dit aktive navnerum default. Hvis du ikke angiver navnerum i YAML-ressourcen, vil alle Kubernetes-kommandoer bruge dette aktive default-navnerum. Desværre kan det være vanskeligt at håndtere det aktive navnerum med kubectl. Men der er et rigtig godt værktøj kaldet Kubens, der gør denne proces meget lettere. Når du kører kommandoen kubens, kan du se alle navnerum med det aktive navnerum fremhævet.
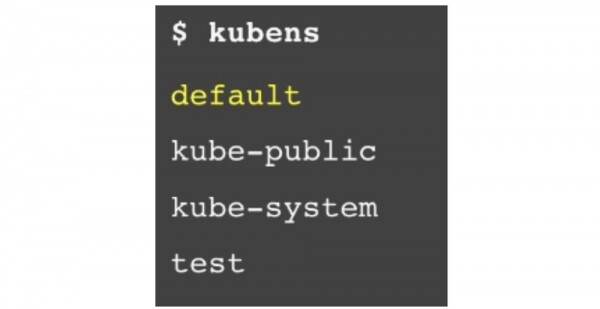
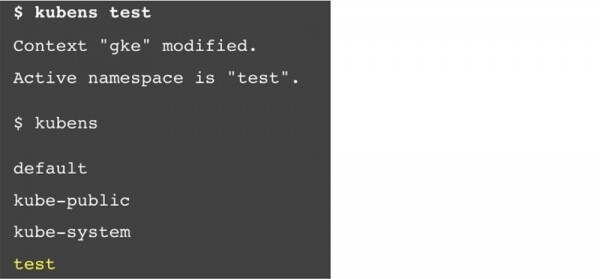
For at skifte det aktive navnerum til navnerummet test skal du blot køre kommandoen $ kubens test. Hvis du derefter igen skriver kommandoen $ kubens, kan du se, at det nu fremhæver det nye aktive navnerum – test.
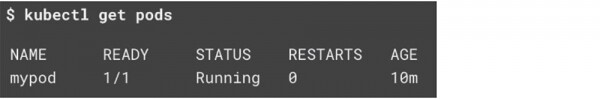
Det betyder, at du ikke har brug for et navneområdeflag for at se pod'en i navneområdet test.
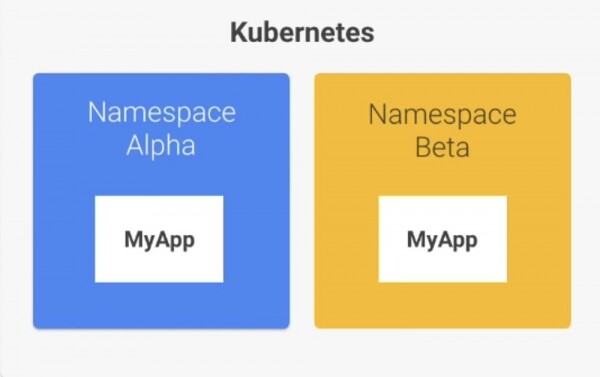
På denne måde er navneområder skjult for hinanden, men ikke isoleret fra hinanden. En tjeneste fra et navneområde kan ganske let kommunikere med en tjeneste i et andet navneområde, hvilket ofte er meget nyttigt. Muligheden for kommunikation mellem forskellige navneområder betyder, at din udviklerteams tjeneste kan interagere med en tjeneste fra et andet dev-team i et andet navneområde.
Som regel, når din applikation ønsker at få adgang til en Kubernetes-tjeneste, bruger du den indbyggede DNS-opdagelsestjeneste og angiver blot tjenestens navn til din applikation. Men du kan dog oprette en tjeneste med samme navn i flere navneområder, hvilket ikke er tilladt.
Heldigvis er det nemt at omgå dette ved at bruge den udvidede form af DNS-adressen. Tjenester i Kubernetes eksponerer deres slutpunkter ved hjælp af et fælles DNS-mønster. Det ser omtrent sådan ud:

Som regel behøver du kun tjenestens navn, og DNS vil automatisk bestemme den fulde adresse.

Men hvis du har brug for at få adgang til en tjeneste i et andet navneområde, skal du blot bruge tjenestens navn plus navneområdet:

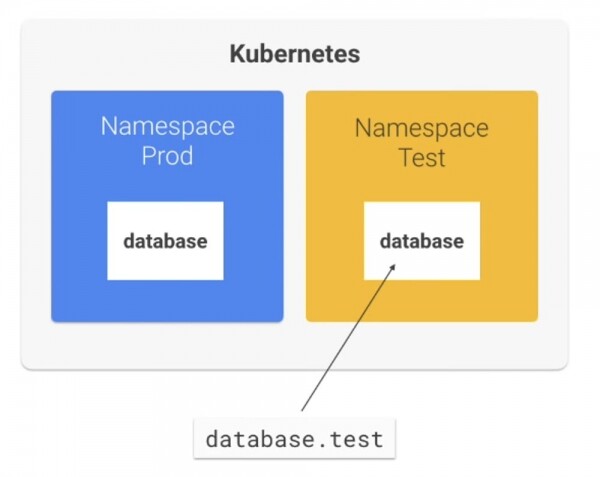
For eksempel, hvis du ønsker at oprette forbindelse til databasen for tjenesten i testnavneområdet, kan du bruge database.test
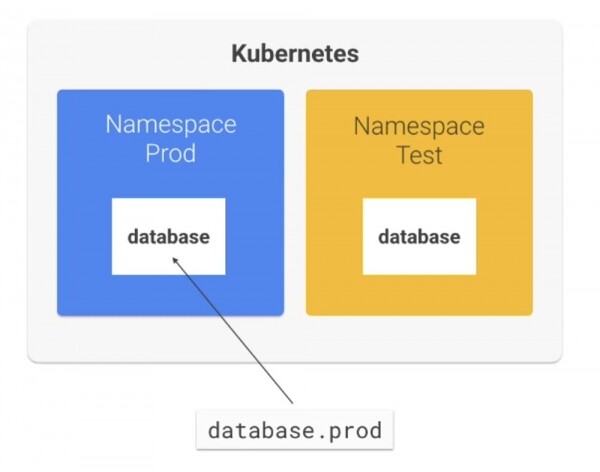
Hvis du derimod ønsker at oprette forbindelse til databasen for tjenesten i navneområdet prod, bruger du database.prod.
Hvis du virkelig ønsker at isolere og begrænse adgangen til navneområdet, tillader Kubernetes det ved hjælp af Kubernetes Netværkspolitikker. Dette vil jeg tale om i den næste serie.
Jeg bliver ofte spurgt, hvor mange navneområder der skal oprettes, og til hvilke formål? Hvad udgør et administreret datastykke?
Hvis du opretter for mange navnerum, vil de blot være til hinder for dig. Hvis derimod er de for få, mister du alle fordelene ved en sådan løsning. Jeg mener, at der er fire grundlæggende faser, som hver virksomhed gennemgår i processen med at opbygge sin organisationsstruktur. Afhængigt af udviklingsstadiet for dit projekt eller din virksomhed, kan du anvende en passende strategi for oprettelse af navnerum.
Forestil dig, at du er en del af et lille team, der arbejder på udviklingen af 5-10 mikrotjenester, og du nemt kan samle alle udviklerne i et rum. I denne situation giver det mening at køre alle prod-tjenester i navnerummet default. Selvfølgelig, for mere fleksibilitet kan du bruge 2 navnerum — et til prod og et til dev. Og sandsynligvis tester du din udvikling på din lokale computer ved hjælp af noget som Minikube.
Antag, at omstændighederne har ændret sig, og nu har du et hurtigt voksende team, der samtidig arbejder på mere end 10 mikrotjenester. Der kommer et tidspunkt, hvor det er nødvendigt at bruge flere klynger eller navnerum, separat til prod og dev. Du kan opdele teamet i flere undergrupper, så hver af dem har sine egne mikrotjenester, og hver af disse grupper kan vælge sit eget navnerum for at lette styringen af udviklings- og udgivelsesprocessen.
Efterhånden som hver medlem af teamet får en forståelse for, hvordan systemet fungerer, bliver det sværere og sværere at koordinere hvert ændring med de andre udviklere. At forsøge at rulle den komplette stak ud på din lokale computer bliver hver dag mere udfordrende.
I store store so they don’t know who works on what. Teams communicate through service contracts or use Service mesh technology, which adds a layer of abstraction over the network, like the configuration tool Istio. Attempting to run the entire stack locally is simply impossible. I strongly recommend using a continuous delivery (CD) platform like Spinnaker in Kubernetes. Thus, the moment comes when each team certainly needs its own namespace. Each team can even choose multiple namespaces for the dev and prod environments.
Finally, there are large entrepreneurial companies where one group of developers doesn’t even know about the existence of other groups. Such a company may even hire third-party developers who interact through well-documented APIs. Each of these groups has several teams and multiple microservices. In this case, it is necessary to use all the tools I mentioned earlier.
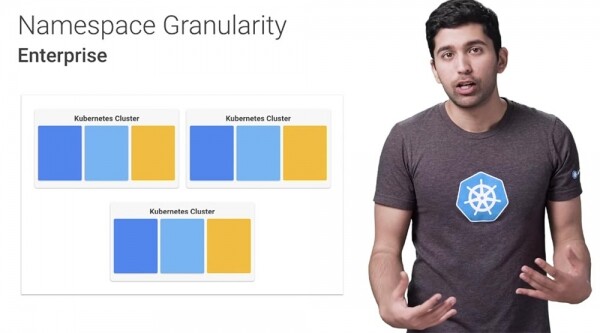
Programmers should not deploy services manually and should not have access to namespaces that are not relevant to them. At this stage, it is reasonable to have multiple clusters to reduce the 'blast radius' of badly configured applications, to simplify billing processes, and to manage resources.
Thus, the proper use of namespaces by your organization allows Kubernetes to be more manageable, controllable, secure, and flexible.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
