

Hello, Habr! Vi inviterer Data Engineers og specialister inden for Machine Learning til en gratis demo-lektion . Vi offentliggør også en artikel af Luca Monno – leder af Financial Analytics hos CDP SpA.
En af de mest nyttige og simple metoder inden for maskinlæring er Ensemble Learning. Ensemble Learning er en metode, der ligger til grund for XGBoost, Bagging, Random Forest og mange andre algoritmer.
Der er mange fantastiske artikler på Towards Data Science, men jeg har valgt to historier ( og ), som jeg bedst kunne lide. Så hvorfor skrive endnu en artikel om EL? Fordi jeg vil vise dig, hvordan det fungerer med et simpelt eksempel, som fik mig til at indse, at der ikke er nogen magi involveret.
Da jeg første gang så EL i aktion (arbejdende med flere meget simple regressionsmodeller), kunne jeg ikke tro mine egne øjne, og jeg husker stadig den professor, der lærte mig denne metode.
Jeg havde to forskellige modeller (to svage læringsalgoritmer) med out-of-sample R² værdier på henholdsvis 0,90 og 0,93. Før jeg så resultatet, tænkte jeg, at jeg ville få en R² værdi et sted imellem de to oprindelige værdier. Med andre ord, jeg troede, at EL kunne bruges til at få modellen til at performe ikke så dårligt som den dårligste, men heller ikke så godt som den bedste model kunne. Til min store overraskelse gav resultaterne fra simpel gennemsnitsdannelse af forudsigelser en R² værdi på 0,95.
Først begyndte jeg at lede efter fejlen, men så tænkte jeg, at der måtte være en eller anden magi gemt her!
Hvad er Ensemble Learning
Med EL kan man kombinere forudsigelser fra to eller flere modeller for at opnå en mere pålidelig og effektiv model. Der er mange metodologier til at arbejde med model-ensembler. Her vil jeg berøre to af de mest nyttige for at give en generel forståelse.
regression
Ved hjælp af man kan gennemsnitliggøre resultaterne fra de tilgængelige modeller. klassifikation
Ved hjælp af kan man lade modellerne vælge labels. Den label, der oftest vælges, er den, som den nye model vil vælge. Hvorfor fungerer EL bedre
Hvorfor EL fungerer bedre
Den primære grund til, at EL fungerer bedre, er, at hver forudsigelse har en fejl (vi kender dette fra sandsynlighedsteori), og kombinationen af to forudsigelser kan hjælpe med at reducere fejlen og dermed forbedre præstationen (RMSE, R² osv.).
I det følgende diagram kan man se, hvordan to svage algoritmer arbejder med et datasæt. Den første algoritme har en højere hældning, end der er behov for, mens den anden næsten er lig med nul (måske på grund af overdreven regularisering). Men ensemble viser et meget bedre resultat.
Ser vi på R² værdien, vil den for den første og den anden træningsalgoritme være -0,01¹, 0,22, henholdsvis, mens den for ensemblet vil være 0,73.
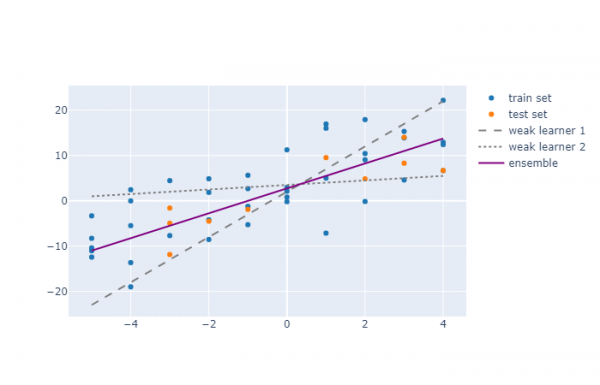
Der er mange grunde til, at en algoritme kan vise sig at være en dårlig model, selv i et så grundlæggende eksempel som dette: måske har du valgt at bruge regularisering for at undgå overfitting, eller du har besluttet ikke at udelukke nogle anomalier, eller måske har du brugt polynomiel regression og valgt en forkert grad (for eksempel ved at bruge et polynomium af anden grad, mens der i testdataene er en klar asymmetri, for hvilken tredje grad ville være bedre).
Når EL fungerer bedre
Lad os se på to træningsalgoritmer, der arbejder med de samme data.
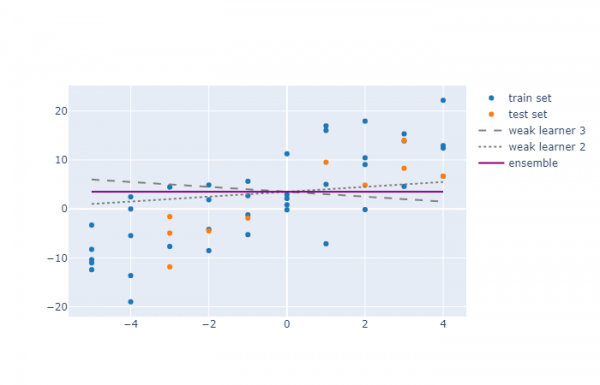
Her kan man se, at kombinationen af de to modeller ikke forbedrede præstationen nævneværdigt. Oprindeligt var R² værdierne for de to træningsalgoritmer -0,37 og 0,22, henholdsvis, mens ensemblet havde en værdi på -0,04. Det vil sige, at EL modellen fik et gennemsnitligt resultat.
Men der er en stor forskel mellem disse to eksempler: i det første eksempel var fejlene fra modellerne negativt korrelerede, mens de i det andet var positivt korrelerede (koefficienterne for de tre modeller blev ikke vurderet, men blev blot valgt af forfatteren som eksempel).
Derfor kan Ensemble Learning bruges til at forbedre balancen mellem bias/variance i alle tilfælde, men når fejlene fra modellerne ikke er positivt korrelerede, kan brugen af EL føre til en forbedring af præstationen..
Homogene og heterogene modeller
Ensemble Learning (EL) bruges ofte på homogene modeller (som i dette eksempel eller i random forest), men du kan faktisk kombinere forskellige modeller (lineær regression + neuralt netværk + XGBoost) med forskellige sæt af forklarende variable. Dette vil sandsynligvis føre til ukorrelerede fejl og forbedret ydeevne.
Sammenligning med porteføljediversificering
EL fungerer analogt med diversificering i porteføljeteori, men det er kun til vores fordel.
Ved diversificering forsøger du at reducere spredningen af dine resultater ved at investere i ukorrelerede aktier. En godt diversificeret aktieportefølje vil yde bedre end den dårligste enkelte aktie, men aldrig bedre end den bedste.
Citerer Warren Buffett:
«Diversificering er en beskyttelse mod uvidenhed; for den, der ikke ved, hvad han laver, giver det [diversificering] meget lidt mening.»
I maskinlæring hjælper EL med at reducere spredningen af din model, men det kan føre til at skabe en model med en samlet ydeevne bedre end den bedste oprindelige model.
Lad os opsummere
At kombinere flere modeller til én er en relativt enkel metode, som kan føre til løsningen af bias-variance-problemet og forbedre ydeevnen.
Hvis du har to eller flere modeller, der fungerer godt, så vælg ikke mellem dem: brug dem alle (men med forsigtighed)!
Er du interesseret i at udvikle dig inden for dette område? Tilmeld dig et gratis demo-klassetrin og deltag i — Maskinlæringsingeniør hos Mail.ru Group.
Kilde: habr.com
