

Ding ding ding! Klokken er 3 om natten, du ligger og ser en vidunderlig drøm, og pludselig — et opkald. Denne uge er det din vagt, og åbenbart er der sket noget. Det automatiserede system kalder på dig for at finde ud af, hvad der er sket. Dette er et vigtigt aspekt af styring af moderne computersystemer, men lad os se på, hvordan vi kan gøre notifikationer mere brugervenlige.
Mød overvågningsfilosofien, der er blevet til i løbet af flere årtiers vagttjeneste i forskellige overvågningsteams. Den er i høj grad inspireret af Rob Evaschuks ægte bibel. (Min filosofi om notifikationer), der er inkluderet i bogen om , og bogen af John Alspaugh. (Overvejelser vedrørende opsætning af alarmer).
, og — tak for hjælpen med at redigere indlægget.
Hvad er CASE?
Jeg besluttede at finde på en flot forkortelse, ligesom eller . Jeg kalder det CASE-metoden. Den beskriver fire aspekter, som man skal være opmærksom på, når man arbejder med automatiseret overvågning:
- (kontextafhængig)
- (handlingsorienteret)
- (symptomfokuseret)
- (vurderet)
Hvis du bruger CASE, nærmer du dig notifikationer med en sund ligegyldighed og forstyrrer ikke folk om natten. Det er nødvendigt at vurdere overvågningen regelmæssigt for dets nytte og effektivitet. Når en person modtager en notifikation, vil han have bedre mentale modeller og mere selvtillid.
For at huske det lettere, forestil dig, at du har brug for en CASE [dvs. en sag, årsag — note fra oversætteren] for at retfærdiggøre hver alarm. :sunglasses:
Og hvad så?
. Af mange grunde. Og CASE vil ikke fjerne alle dem. Men med den vil du vågne op til mere kvalitetsnotifikationer om natten. Denne metode dækker forskellige organisatoriske processer, der også vil hjælpe i denne henseende.
Skønheden ved RED- og USE-metoderne er, at de ikke kun beskriver, hvordan vi arbejder, men også giver os et fælles sprog. Jeg håber, at det bliver nemmere at diskutere de notifikationer, som beskytter vores systemer, men som også kan være forstyrrende for vores kolleger.
Essensen er, at vi skal skabe en kultur i organisationen, hvor meddelelser tages med en sund ligegyldighed. Meddelelser kan oprettes af en grund, men det er ikke sikkert, at de senere mister værdi. Hvorfor har vi indstillet denne meddelelse? Er kriterierne blevet gennemgået for nylig? Med CASE kan man finde svar på disse spørgsmål.
Context-Heavy — kontekstbundne tilknytninger
Klokken 3 om morgenen er ikke det bedste tidspunkt at læse beskeder fyldt med komplekse ord. For at reagere effektivt har man brug for information. Ideelt set skal det være information om et specifikt problem, hvor konteksten er klar, og meddelelserne skal konfigureres, så dette er muligt. Dette er "observation" og "orientering" fra . Denne indstilling er det værd at bruge tid på, fordi det er endnu dyrere at konstant aflede en person. Lad os respektere hinanden.
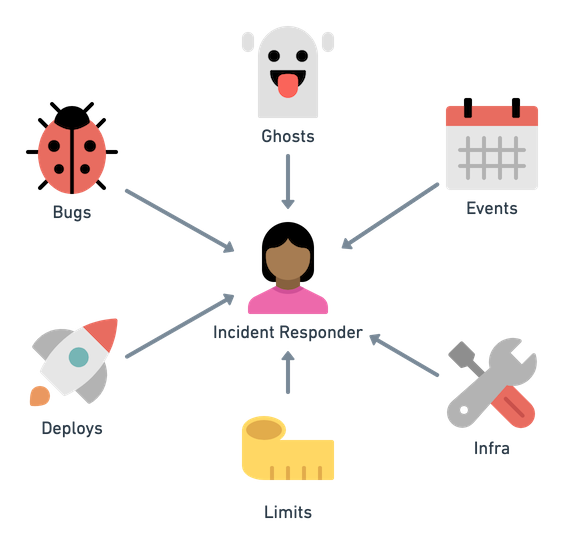
Der er mange kilder til problemer. Især spøgelser.
Hvordan kan vi hjælpe den vagtansvarlige? først og fremmest ser vagtansvarlige meddelelsen, så alle hypoteser bygges på dens basis. Derefter ser de instruktioner og dashboards, men er der altid data for den specifikke meddelelse, og ikke bare generel information? Olspo anbefaler at "tænke over, hvordan man kan fortolke meddelelsen eller reagere på den" (slide 29). En god meddelelse er rettet mod den vagtansvarlige, og ikke bare baseret på en tærskelværdi.
Derfor her er nogle idéer til, hvordan man kan forbedre konteksten for meddelelserne:
- Vis brugeren noget nyttigt og skræddersyet, ikke bare almindelige instruktioner eller et dashboard. Tidligere brugte vi dashboards til undersøgelser, tilpasset specifikke meddelelser. Dette hjælper, hvis problemet er kendt, men kan forvirre i andre tilfælde. Her skal der findes en balance.
- Fortæl om historien bag meddelelsen: er den ny? Aktiveres den ofte? Er den sæsonbestemt?
- Vis nylige ændringer i systemstatus. Er der blevet ændret noget for nylig? (For eksempel deployment eller aktivering/deaktivering af funktionalitet.)
- Vis relationer og giv oplysninger til den mentale model: systemafhængigheder skal være klare, helst med angivelse af driftstatus.
- Forbind brugeren hurtigt med teamet: ser han aktuelle hændelser eller kan han finde ud af, hvem der ellers i virksomheden har modtaget meddelelsen? Programmet aktiveret?
Ideelt set giver programmet til hændelseshåndtering råd om, hvordan man kan forbedre konteksten i meddelelser ved undersøgelsen af hændelser. Der er altid plads til forbedringer!
Handlingsbar — praktisk værdi
Skal vagtlægen gøre noget som svar på meddelelsen? Hvis der ikke er noget, der skal gøres, eller det ikke er klart, hvad der skal gøres, hvorfor vække dem? Undgå meddelelser, der forstyrrer vagterne og ikke kræver handling.
Hvad skal der gøres? Hvad er nødvendigt?
Tidligere, når systemerne var enkle, og teams var små, indstillede vi overvågning for blot at være opmærksomme på situationen. En meddelelse om, at belastningen på en bunke er steget, giver os kontekst, hvis tjenesten senere fejler. I stor skala vil sådanne meddelelser kun forvirre, fordi vores systemer altid fungerer i en tilstand af degradering i varierende grad. Det fører hurtigt til og selvfølgelig til tab af følsomhed. Derfor ignorerer vagtlægen eller filtrerer sådanne meddelelser og reagerer ikke altid som nødvendigt. Gå ikke i denne fælde! Indstil ikke alle meddelelser på én gang for derefter at sende dem til en glemt mappe i din e-mail.
Sådan ser en meddelelse med praktisk værdi ud:
- Meddelelsen kræver handling, ikke blot en nyhedsopdatering.
- Denne handling er svær eller risikabel at automatisere. Hvis handlingen kan automatiseres, så gør det, lad være med at generte folk!
- Meddelelsen indeholder presserende anbefalinger i form af (SLA) eller (RTO). Så kan vagtlægen involvere hændelseshåndteringsprogrammet i organisationen.
Jeg vil gerne præcisere: Jeg siger ikke, at meddelelser kun skal komme om de vigtigste SLO'er (service level objectives, service niveau mål) for API'er. Overvågning af SLO'er opdeles konstant og kræver en ensartet tilgang til alle tjenester. Det er klart, at du vil overvåge de vigtigste SLO'er for kunder, der betaler dig. Men SLO'er for infrastrukturen, såsom databaser, skal også overvåges. Snart vil du skulle tage dig af interne kunder og støtte dem. Og så videre i det uendelige.
Symptom-baseret — fokus på symptomer
Uanset om du kan lide det eller ej, arbejder du i et distribueret system (Kavadj). Som et resultat bruger du forskellige taktikker til at isolere tjenester og beskytte dem mod nedbrud (Trainor et al.).3. Og selvom langvarig garbage collection eller en hængende databaseanmodning indikerer problemer, skal du ikke kaste dig over at løse dem, hvis brugerne ikke har problemer i den nærmeste fremtid.
Disse er vigtige signaler, og de kan have praktisk værdi, men hvis de ikke generer brugerne, er det ikke så presserende, at det skal aflede opmærksomheden fra vagten. Årsagsbaserede meddelelser er snapshots af vores mentale modeller om systemfejl. Det er bedre at overvåge vigtige symptomer end at forsøge at opremse alle mulige årsager til fejl.
For at meddelelser skal have praktisk værdi, skal du fokusere på , der er vigtige for brugerne. Evashchuk kalder det "overvågning for brugerne". Husk, at denne filosofi skal anvendes i hele organisationen. Hvis der opstår presserende problemer et sted dybt i infrastrukturen, vil det relevante team tage sig af det. At beskytte systemer mod sådanne fejl er et helt separat spørgsmål (Trainor et al., sektion om strategier til at minimere kritiske afhængigheder).
Symptomerne er ikke så variable
Richard Cook minder om, at der i komplekse systemer er et væld af mangler, defekter og problemer. At forsøge at opremse alle mulige årsager er en Sisyphean opgave. Du prøver at beskrive problemer, men de ændrer sig hele tiden. Cindy Shridharan mener, at "systemer ikke nødvendigvis skal være i perfekt stand hvert sekund", og det er bedre at anvende en mere menneskelig tilgang ( ("Overvågning af distribuerede systemer"), 7).
Undgå at sende meddelelser ved hændelser
Ofte er meddelelser, der indstilles til årsager, nødvendig for at rette op på hændelser. Og disse begrænsede meddelelser om, hvad der er sket, skaber en falsk følelse af sikkerhed, da systemet konstant finder nye måder at bryde ned på.
Tænk ikke, at meddelelser om årsager vil narre dig. Bedre at overveje:
- Hvorfor opdagede en symptom-baseret meddelelse ikke problemet?
- Vil det være nyttigt at forbedre konteksten for brugeren?
- Hvordan forbedrer man overvågningsværktøjer, så man hurtigere kan stille diagnoser i stedet for at samle notifikationer om, hvad der er sket?
Overvågningsværktøjer til diagnose hjælper kun, hvis du betragter dem som en måde at gå fra symptom til løsning. Uden denne feedback vil du blot blive overvældet af forsinkede notifikationer og grafer over fortidens fejl — og ingen ord om fremtidige problemer. For organisationen er dette en fremragende mulighed for at skifte fra defensiv til offensiv. Og udviklere samt produktledere vil have de samme forventninger og klare mål. Sagen — CASE (:wink:) — er tydelig for hver notifikation.
Notifikationer baseret på årsager er tolerable i moderate mængder.
Nogle gange efterlader vores system næsten ingen valg, når det kommer til notifikationer baseret på årsager. Andre gange forstår vagtholdet tydeligt, at et symptom nødvendigvis vil føre til en fejl, og derfor har det praktisk værdi. Måske er du bare ikke sikker på, hvad der foregår, og indstiller notifikationer som en sikkerhedsforanstaltning. Lad os håbe, at denne handling kun er midlertidig, indtil vi ændrer systemet for at tage hånd om problemerne med ydeevnen.
Husk på de andre komponenter i CASE, når du håndterer sådanne situationer. Hvis det er midlertidigt, betyder det ikke, at man ikke skal tænke klart.
Evaluated — evaluering.
Enhver ændring i systemet (ny kode, ny infrastruktur, hvad som helst nyt) udvider spektret af fejl (Cook, 3). Virker denne notifikation stadig som forventet? Klare og relevante mentale modeller af systemer og erfaring med at reagere på visse notifikationer understøtter — dette er nøglekendetegnene . Defekter i systemerne udvikler sig konstant, og vi skal følge med.
Det er nødvendigt løbende at evaluere kvaliteten af hver notifikation, så de fungerer som forventet. Kære ledere! Det bliver meget lettere for jeres teams, hvis I hjælper dem med at etablere denne proces! Her er nogle idéer til evaluering:
- Brug , eller andre metoder til test af notifikationer. Teamet kan gøre dette selv uden at inddrage et tungt system til håndtering af hændelser!
- Aktivér indsamling af data om alle meddelelser relateret til hændelser i hændelsesstyringsprogrammet. Marker nyttige, skadelige, irrelevante, uforståelige osv. Brug dem som feedback.
- Korrekte meddelelser udløses sjældent og er omhyggeligt kontrolleret. Sørg for, at alle links fungerer, peger på den rigtige kontekst osv.
- Hvis en meddelelse aldrig udløses eller udløses alt for ofte, er der noget galt med den. Reparer eller slet den. Vær opmærksom på overdreven passivitet eller aktivitet!
- Indstil tidsstemplet for meddelelser med en udløbsdato. Hvis udløbsdatoen er udløbet, skal du evaluere meddelelsen ved hjælp af CASE-metoden og opdatere tidsstemplet. Tjek regelmæssigt udløbsdatoen, ligesom med mad.
- Forenkle processen med at forbedre meddelelser. Brug overvågning som kode og opbevar meddelelser i et Git-repositorium. Pull-requests hjælper med at inddrage teamet, og du får et historisk overblik over tidligere meddelelser. Og du vil ikke længere være bange for at ændre meddelelser eller spørge om tilladelse fra dem, der er ansvarlige.
- Etabler feedback for meddelelser, selvom det bare er , så vagterne kan markere meddelelser som unødvendige eller irriterende. Integrer et link eller en opfordring til handling i selve meddelelsen og gennemgå regelmæssigt feedback.
- Sæt et regelsæt i teamet — lad vagterne arbejde på at forenkle vagten, når der er lidt arbejde. Lad alt blive en smule bedre efter dig, end det var før.
Konklusion
Jeg mener, at CASE-metoden hjælper udviklere og organisationer med at diskutere konfiguration og afsendelse af automatiske meddelelser. En udvikler kan begynde at evaluere meddelelser ved hjælp af CASE-metoden, og derefter kan hele organisationen samle andre udviklere, ledelsen og hændelsesstyringsprogrammer for at holde meddelelserne i god stand. Der kræves ikke særlige værktøjer eller komplekse processer.
Hele branchen bør overveje den menneskelige faktor i løbet af vagten uden at gå på kompromis med førsteklasses kundeservice. Alle disse værktøjer og praksisser kan og bør forbedres. Jeg håber, at CASE-metoden vil hjælpe med dette.
Nyd de forbedrede meddelelser!
Kilde: habr.com
