

I denne artikel præsenteres en metode til uskarp induktion udviklet af forfatteren, som kombinerer principperne fra uskarp matematik og fraktal teori. Begrebet graden af rekursion af et uskarpt sæt introduceres, og beskrivelsen af den ufuldstændige rekursion af sættet præsenteres som dets fraktionelle dimension til modellering af emneområdet. Anvendelsesområdet for den foreslåede metode og de vidensmodeller, der er baseret på den, som uskarpe sæt, overvejes inden for styring af livscyklussen for informationssystemer, inklusive udvikling af brugsscenarier og test af software.
Relevans
I design-, udviklings-, implementerings- og driftsfasen af informationssystemer er det nødvendigt at akkumulere og systematisere data, oplysninger og informationer, der indsamles udefra eller opstår i hvert trin af livscyklussen for software. Dette er en nødvendig informations- og metodisk støtte til projekter og beslutningstagning, især i situationer med høj usikkerhed og i svagt strukturerede miljøer. Den vidensbase, der formes som resultat af akkumuleringen og systematiseringen af sådanne ressourcer, skal ikke kun være en kilde til nyttig erfaring opnået af projektgruppen under arbejdet med at oprette informationssystemet, men også et maksimal simpelt middel til at modellere nye visioner, metoder og algoritmer til løsning af projektopgaver. Med andre ord er en sådan vidensbase et lager af intellektuel kapital og samtidig et værktøj til vidensforvaltning [3, 10].
Effektiviteten, nytten og kvaliteten af vidensbasen som værktøj korrelerer med ressourceforbruget i vedligeholdelsen af den og resultatet af udvindingen af viden. Jo enklere og hurtigere indsamlingen og registreringen af viden i basen er, og jo mere relevante resultaterne fra forespørgslerne er, jo bedre og mere pålideligt er selve værktøjet [1, 2]. Ikke desto mindre gælder diskrete metoder og midler til strukturering, som er anvendelige for systemer. database management, herunder normalisering af relationelle databaser, gør det umuligt at beskrive eller modellere semantiske komponenter, fortolkninger, intervall og kontinuerlige semantiske mængder [4, 7, 10]. For dette kræves en metodologisk tilgang, der generaliserer specifikke tilfælde af endelige ontologier og nærmer videnmodellen til kontinuiteten i beskrivelsen af det informationsteknologiske systems domæne.
En sådan tilgang kan være at sammenflette aspekterne af teori for uskarp matematik og begrebet fraktal dimension [3, 6]. Ved at optimere beskrivelsen af viden i forhold til graden af kontinuitet (trin størrelse for diskretisering af beskrivelsen) under betingelser med begrænsninger i henhold til Gödels ufuldstændighedsprincip (i informationssystemet – den principielle ufuldstændighed af ræsonnering, viden, der er udledt fra dette system under betingelse af dets konsistens), ved at udføre en sekventiel fuzzifikation (førelse til uskarphed), opnår vi en formaliseret beskrivelse, der så komplet og sammenhængende som muligt afspejler en given mængde viden og med hvilken man samtidig kan udføre enhver operation af informationsprocesser – indsamling, lagring, behandling og transmission [5, 8, 9].
Definition af rekursionen af et uskarpt sæt
Lad X være mængden af værdier for en given egenskab ved det modellerede system:
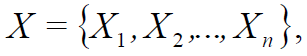 (1)
hvor n = [N ≥ 3] – antallet af værdier for en sådan egenskab (mere end det elementære sæt (0; 1) – (falsk; sand)).
Lad X = B, hvor B = {a,b,c,…,z} – et mængde af ækvivalenter, element-for-element svarende til mængden af værdier for egenskaben X.
Således er det uskarpe sæt  , der svarer til det uskarpe (i almindelighed) begreb, der beskriver egenskaben X, kan repræsenteres som:
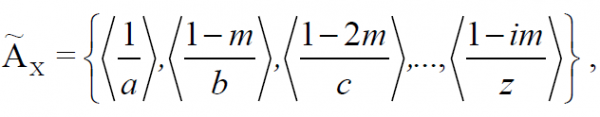 (2)
hvor m – trin størrelse for diskretiseringen af beskrivelsen, i tilhører N – multiplicitets trin.
Overensstemmende, for at optimere vidensmodellen for det informationsteknologiske system i henhold til kriteriet for kontinuitet (blødhed) i beskrivelsen, mens vi holder os indenfor rammerne af rummet af ufuldstændighed af ræsonnering, vil vi indføre graden af rekursionen af det uskarpe sæt  og få følgende variant af dets repræsentation:
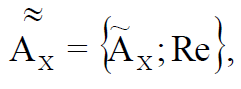 (3)
hvor  – en mængde der svarer til det uskarpe begreb, der i almindelighed mere fuldt beskriver egenskaben X end mængden
 , i forhold til kriteriet for blødhed; Re – graden af rekursion i beskrivelsen.
Det bør bemærkes, at 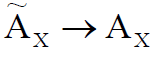 (reduceret til et klart sæt) i en særlig situation ved behov.
Indledning til fraktionel dimension
Ved Re = 1 er sættet  et almindeligt uskarpt sæt af 2. grad, som inkluderer uskarpe sæt (eller deres klare repræsentationer), der beskriver alle værdier af karakteristikken X [1, 2]:
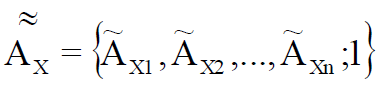 (4)
Dog er dette et degenereret tilfælde, og i den mest fulde præsentation kan en del af elementerne  være sæt, mens de resterende er triviale (meget simple) objekter. Derfor er det nødvendigt at indføre fraktionel rekursion – analog til fraktionel dimension af rummet (i denne sammenhæng – rummet for ontologi indenfor et bestemt emneområde) [3, 9].
Ved fraktionel Re får vi følgende notation  :
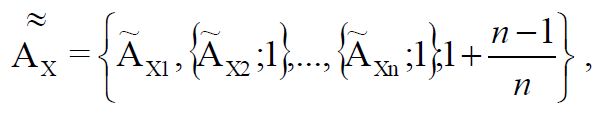 (5)
hvor  – uskarpt sæt for værdien X1,
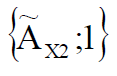 – uskarpt sæt for værdien X2 osv.
I så fald bliver rekursionen i bund og grund fraktal, og beskrivelsessætene bliver selvselvlig.
Definition af sættet af funktionelle muligheder for modulet
Arkitekturen af det åbne informationssystem forudsætter en modulær tilgang, der muliggør skalering, replikation, tilpasning og emergens i systemet. Modulær konstruktion gør det muligt at nærme sig den teknologiske implementering af informationsprocesser i deres naturlige objektive manifestation i den virkelige verden, at udvikle de mest praktiske midler med hensyn til deres funktionelle egenskaber, som ikke er beregnet til at erstatte mennesker, men effektivt hjælpe dem med at styre viden.
Modulet repræsenterer en særskilt enhed indenfor informationssystemet, som kan være obligatorisk eller valgfri for systemets eksistens, men i enhver henseende sikrer et unikt sæt funktioner indenfor systemets rammer.
Det enorme mangfoldighed af funktionelle muligheder for moduler kan beskrives med tre typer operationer: oprettelse (registrering af nye data), redigering (ændring af tidligere registrerede data), sletning (sletning af tidligere registrerede data).
Lad X være en vis karakteristik af sådanne funktionelle muligheder, så det tilsvarende sæt X kan præsenteres som:
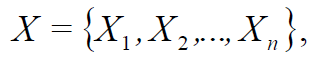 (6)
hvor X1 – oprettelse, X2 – redigering, X3 – sletning,
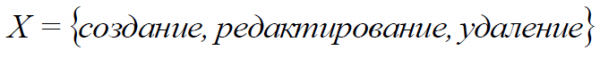 (7)
De funktionelle muligheder for enhver modul er sådan, at oprettelsen af data ikke er selvligende (realiseret uden rekursion - oprettelsesfunktionen gentager ikke sig selv), mens redigering og sletning generelt kan omfatte både elementbaseret implementering (udførsel af operationen på udvalgte elementer af datamængder) og selv inkludere lignende operationer.
Det skal bemærkes, at hvis operationen for den funktionelle mulighed X i dette modul ikke udføres (ikke er implementeret i systemet), så betragtes det tilsvarende mængde som tomt.
Således kan en beskrivelse af det vage begreb (udsagnet) "modulet tillader udførelse af operationen med det tilsvarende datasæt i informationssystemets mål" beskrives som et vagt mængde. 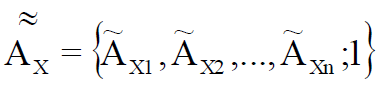 I den simpleste form kan det repræsenteres som:
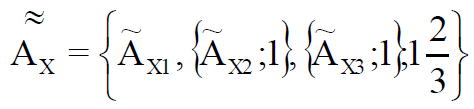 (8)
Sådan en mængde har generelt en rekursionsgrad på 1,6(6) og er både fraktal og vag samtidigt.
Forberedelse af brugsscenarier og test af modulet
I udviklings- og driftsfaserne af informationssystemet er særlige scenarier nødvendige, som beskriver rækkefølgen og indholdet af operationer til brug af modulerne i henhold til deres funktionelle formål (brugs- og testscenarier).
Under hensyntagen til de tidligere præsenterede ideer kan arbejdsprocessen med sådanne scenarier beskrives som følger.
For modulet dannes en vag mængde 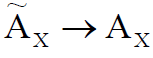 :
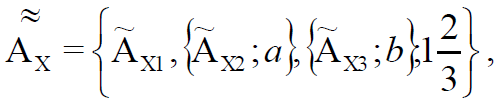 (9)
hvor
 – vag mængde for oprettelse af data ud fra den funktionelle mulighed X;
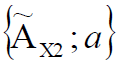 – vag mængde for redigering af data ud fra den funktionelle mulighed X, idet rekursionsgraden a (funktionens indlejring) er et naturligt tal og i det trivielle tilfælde er lig med 1;
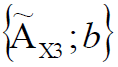 – vag mængde for sletning af data ud fra den funktionelle mulighed X, idet rekursionsgraden b (funktionens indlejring) er et naturligt tal og i det trivielle tilfælde er lig med 1.
Sådan en mængde beskriver, hvad præcist (hvilke dataobjekter) der oprettes, redigeres og/eller slettes ved enhver brug af modulet.
Derefter oprettes et sæt brugsscenarier for funktionaliteten X for den pågældende modul, hvor hver af dem beskriver, hvorfor (for hvilken forretningsopgave) man opretter, redigerer og/eller sletter de dataobjekter, der er beskrevet af et væld af  , og i hvilken rækkefølge:
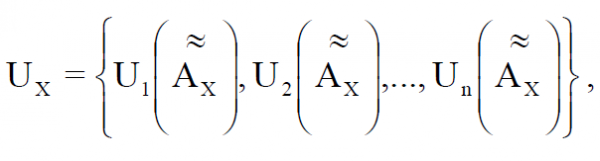 (10)
hvor n er antallet af brugsscenarier for X.
Derefter udarbejdes et sæt testscenarier Tx for funktionaliteten X for hvert brugsscenarie i den pågældende modul. Testscenariet beskriver, hvilke værdier der anvendes, og i hvilken rækkefølge under udførelsen af brugsscenariet, samt hvilket resultat der skal opnås:
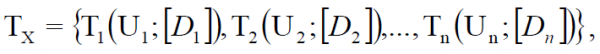 (11)
hvor [D] er et array af testdata, n er antallet af testscenarier for X.
I den beskrevne tilgang er antallet af testscenarier lig med antallet af tilsvarende brugsscenarier, hvilket gør arbejdet med at beskrive og opdatere dem enklere i takt med systemets udvikling. Desuden kan en sådan algoritme bruges til at automatisere testningen af softwaremoduler i informationssystemet.
Konklusion
Den præsenterede metode til uklar induktion kan implementeres på forskellige stadier af livscyklussen for ethvert modulært informationssystem, både med henblik på at opbygge den beskrivende del af vidensbasen og med fokus på arbejdet med brugsscenarier og test af moduler.
Desuden hjælper uklar induktion med at syntetisere viden baseret på opnåede uklare beskrivelser, ligesom en "kognitiv kalejdoskop", hvor nogle elementer forbliver klare og entydige, mens andre anvender det angivne antal gange i henhold til selv-similaritetsreglen for hvert sæt af kendte data. Sammen danner de opnåede uklare mængder en model, der kan anvendes både til informationssystemets formål og til søgning efter ny viden generelt.
Denne form for metodologi kan betragtes som en særlig form for "kunstig intelligens", idet de syntetiserede mængder ikke må modsætte sig princippet om ufuldstændighed i ræsonnering og er designet til at støtte menneskelig intelligens snarere end at erstatte den.
Litteraturliste
- Borissov V.V., Fedulov A.S., Zernov M.M., "Grundlæggerne af teorien om uskarpe mængder". M.: Hot Line – Telekom, 2014. – 88 s.
- Borissov V.V., Fedulov A.S., Zernov M.M., "Grundlæggerne af teorien om uskarp logisk slutning". M.: Hot Line – Telekom, 2014. – 122 s.
- Demenok S.L., "Fraktal: mellem myte og håndværk". Spb: Akademiet for kulturforskning, 2011. – 296 s.
- Zade L., "Grundlæggende tilgangen til analysen af komplekse systemer og beslutningsprocesser" / "Matematik i dag". M.: "Viden", 1974. – S. 5 – 49.
- Krants S., "Den foranderlige natur af matematisk bevis". M.: Laboratorium for viden, 2016. – 320 s.
- Mavrikidi F.I., "Fraktal matematik og naturen af forandring" / "Delfis", nr. 54 (2/2008), .
- Mandelbrot B., "Fraktal geometri i naturen". M.: Institut for computerforskning, 2002. – 656 s.
- "Grundlæggende om teorien om uskarpe mængder: Metodiske retningslinjer", red. Korobova I.L., Dyakov I.A. Tambov: Udgivelse af Tambov stat. tekn. universitet, 2003. – 24 s.
- Uspensky V.A., "Forsvar for matematik". M.: Alpina Non-fiktion, 2017. – 622 s.
- Zimmerman H. J. "Fuzzy Set Theory – og dens anvendelser", 4. udgave. Springer Science + Business Media, New York, 2001. – 514 s.
Kilde: habr.com
