

Ærligt talt grinede Ivan ofte af sine kollegers forgæves bestræbelser i overvågningsafdelingen. De gjorde en stor indsats for at implementere de metrikker, som virksomhedens ledelse bestilte. De var så optaget, at de ikke havde lyst til at lave noget som helst for andre.
Men ledelsen var aldrig tilfreds – de bestilte konstant nye og nye metrikker, og de stoppede hurtigt med at bruge dem, der allerede var lavet.
Den seneste tid talte alle kun om LeadTime – leveringstiden for forretningsfunktioner. Metrikken viste et vanvittigt tal – 200 dage for at levere én opgave. Hvordan de alle udbrød og rækkede hænderne mod himlen!
Efter noget tid tog støjen gradvist af, og ledelsen bestilte endnu en metrik.
Ivan vidste helt klart, at den nye metrik også ville dø stille og roligt i et mørkt hjørne.
Faktisk tænkte Ivan, at antallet overhovedet ikke siger noget til nogen. 200 dage eller 2 dage – der er ingen forskel, fordi man ikke kan bestemme årsagen ud fra tallene og forstå, om det er godt eller dårligt.
Dette er den typiske faldgrube med metrikker: Det virker som om, den nye metrik vil afsløre livets essens og forklare en hemmelighed. Alle håber på det, men af en eller anden grund sker der ingenting. Fordi hemmeligheden skal ikke findes i metrikkerne!
For Ivan var det et afsluttet kapitel. Han forstod, at til målinger, og alle hemmeligheder skal findes i , dvs. det, der former denne metrik.
For en webshop vil påvirkningsobjektet være dens kunder, der bringer penge, mens det for DevOps er de teams, der skaber og ruller distributioner ud ved hjælp af et pipeline.
En dag, da han satte sig komfortabelt i en stol i lobbyen, besluttede Ivan at tænke grundigt over, hvordan han gerne ville se DevOps-metrikker, under hensyntagen til at påvirkningsobjektet er teams.
Målet med DevOps-metrikker
Det er klart, at alle ønsker at reducere leveringstiden. 200 dage er selvfølgelig ikke acceptabelt.
Men hvordan, det er spørgsmålet?
I virksomheden arbejder der hundreder af teams, og der passerer tusinder af distributioner gennem DevOps-pipelinen hver dag. Den reelle leveringstid vil se ud som en fordeling. Hver af teams vil have sin egen tid og sine egne særegenheder. Hvordan kan man finde noget som helst blandt dette kaos?
Svaret kom af sig selv – vi skal finde de problematiske teams og forstå, hvad der sker, og hvorfor det tager så lang tid, og fra de "gode" teams lære, hvordan man gør det hele hurtigt. Og for at gøre dette er det nødvendigt at måle den tid, som holdene bruger på hver af DevOps-standene:
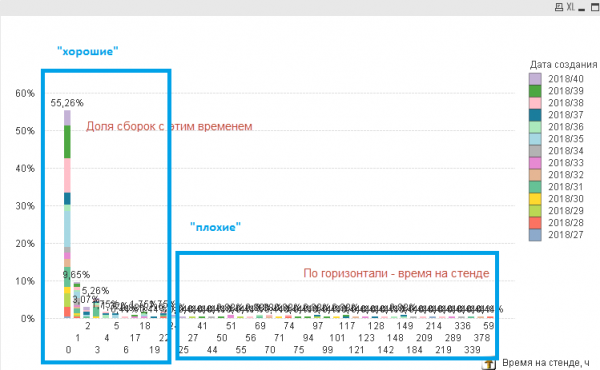
"Systemets mål vil være at udvælge teams baseret på den tid, de bruger på standene, dvs. vi skal i sidste ende have en liste over teams med den valgte tid, ikke et tal.
Hvis vi får indsigt i, hvor meget tid der samlet set er brugt på standen, og hvor meget tid der er brugt på spildtid mellem standene, kan vi finde holdene, ringe til dem og få en mere detaljeret forståelse af årsagerne og fjerne dem," tænkte Ivan.
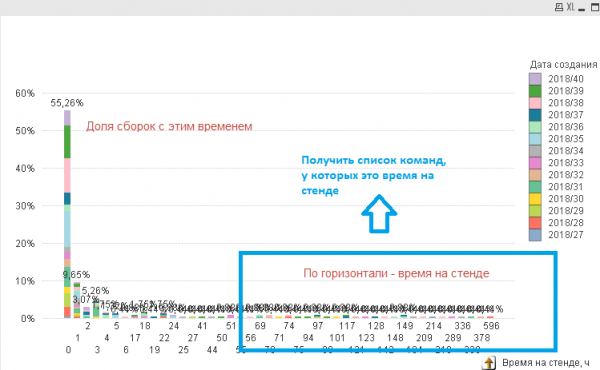
Hvordan man beregner leveringstiden for DevOps
For at beregne dette var det nødvendigt at dykke dybere ned i DevOps-processen og dens entiteter.
Virksomheden bruger et begrænset antal systemer, og oplysninger kan kun fås fra dem og ikke andre steder.
Alle opgaver i virksomheden blev registreret i Jira. Når en opgave blev taget til behandling, blev der oprettet en branch, og efter implementeringen blev der lavet et commit i BitBucket og Pull Request. Ved godkendelse af PR (Pull Request) blev der automatisk oprettet en distribution og gemt i Nexus-lageret.

Derefter blev distributionen rullet ud på flere stande ved hjælp af Jenkins til at kontrollere korrektheden af installation, automatisk og manuel testning:
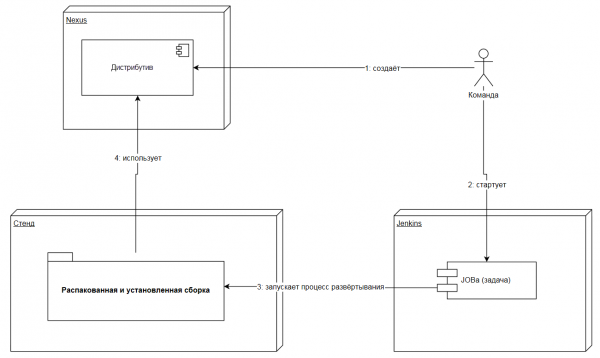
Ivan skitserede, fra hvilke systemer der kan hentes information for at beregne tiden på standene:
- Fra Nexus – Tiden for oprettelse af distributionen og navnet på mappen, hvor holdets kode blev gemt.
- Fra Jenkins – Starttid, varighed og resultatet af hver job, navnet på standen (i jobparameterne), stadier (jobtrin), linket til distributionen i Nexus.
- Ivan besluttede ikke at inkludere Jira og BitBucket i processen, da de mere relaterede til udviklingsfasen og ikke til udrulningen af den færdige distribution på standene.
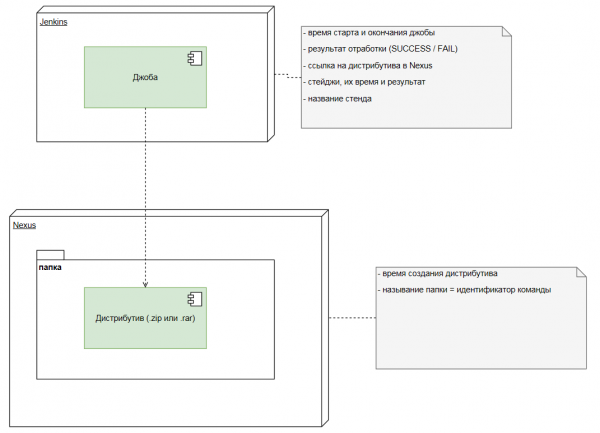
Baseret på de tilgængelige oplysninger blev der tegnet sådan et diagram:
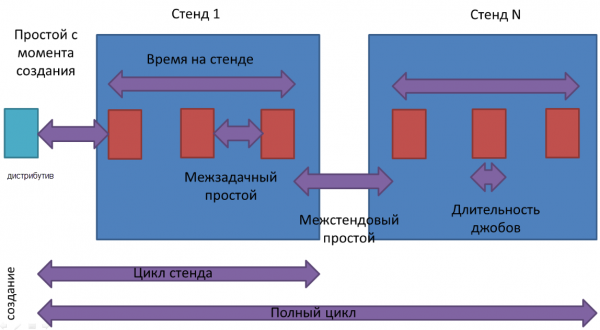
Ved at vide, hvor lang tid det tager at oprette distributioner, og hvor lang tid der bruges på hver af dem, kan man nemt beregne de samlede omkostninger for at gennemløbe hele DevOps-processen (den komplette cyklus).
Her er de DevOps-metrikker, som Ivan i sidste ende fik:
- Antallet af skabte distributioner
- Andelen af distributioner, der "kom ind" på standen og "gik igennem" standen
- Tiden brugt på standen (standcyklus)
- Fuldt cyklus (total tid på alle stande)
- Varighed af jobs
- Ventetid mellem stande
- Ventetid mellem jobstart på én stand
På den ene side beskrev metrikkerne meget godt DevOps-pipelinen med hensyn til tid, mens de på den anden side blev betragtet som meget enkle.
Glad for det veludførte arbejde, lavede Ivan en præsentation og gik for at præsentere den for ledelsen.
Han kom tilbage med et vædre ansigt og hængende hænder.
— Dette er et fiasko, brormand — smilede en ironisk kollega …
Fortsæt læsningen i artiklen «».
Kilde: habr.com
