

Med Apache Cassandra-databasen og behovet for dens drift inden for en infrastruktur baseret på Kubernetes støder vi regelmæssigt på udfordringer. I dette materiale deler vi vores syn på de nødvendige trin, kriterier og eksisterende løsninger (herunder en oversigt over operatører) til migrering af Cassandra til K8s.
»Den, der kan styre en kvinde, kan også styre en stat«
Hvem er så Cassandra? Det er et distribueret lagersystem, der er designet til at håndtere store datamængder, samtidig med at det sikrer høj tilgængelighed uden et enkelt fejlsætningspunkt. Projektet behøver næppe en lang introduktion, så jeg vil kun nævne de vigtigste funktioner ved Cassandra, som vil være relevante i forhold til denne artikel:
- Cassandra er skrevet i Java.
- Cassandra-topologien omfatter flere niveauer:
- Node — en enkelt instance af Cassandra;
- Rack — en gruppe af Cassandra-instanser, der er samlet efter et kriterium, som befinder sig i et datacenter;
- Datacenter — summen af alle grupper af Cassandra-instanser, der er placeret i et datacenter;
- Cluster — summen af alle datacentre.
- For at identificere en node bruger Cassandra IP-adressen.
- For hurtigere skrive- og læseoperationer opbevarer Cassandra nogle af dataene i hukommelsen.
Nu — til selve den potentielle flytning til Kubernetes.
Tjekliste til migrering
Når vi taler om migrering af Cassandra til Kubernetes, håber vi, at flytningen vil gøre det lettere at administrere den. Hvad er nødvendigt for dette, og hvad kan hjælpe i processen?
1. Lagringsplads til data
Som allerede nævnt opbevarer en del af dataene fra Cassandra i hukommelsen — i Memtable. Men der er også en anden del data, der gemmes på disken — i form af SSTable. Til disse data tilføjes en entitet, Commit Log — optegnelser over alle transaktioner, som også gemmes på disken.
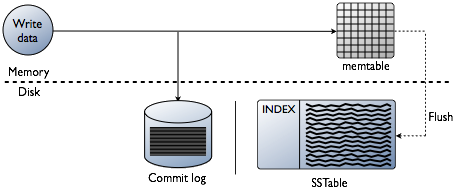
Skema for skrive-transaktioner i Cassandra
I Kubernetes kan vi bruge PersistentVolume til at opbevare data. Takket være veludviklede mekanismer bliver det lettere at arbejde med data i Kubernetes hvert år.
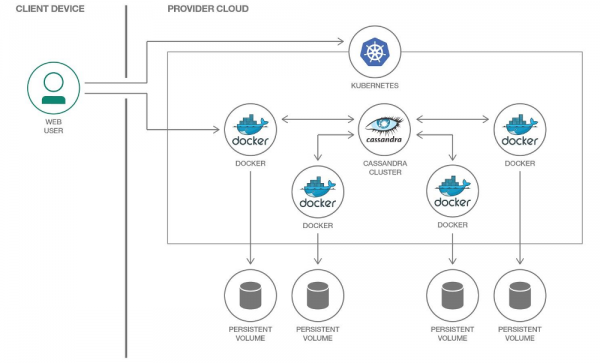
Hver pod med Cassandra får sin egen PersistentVolume tildelt.
Det er vigtigt at bemærke, at Cassandra i sig selv indebærer datareplication ved at tilbyde indbyggede mekanismer for dette. Derfor, hvis du opretter et Cassandra-klynge bestående af mange noder, er der ikke behov for at bruge distribuerede systemer som Ceph eller GlusterFS til datalagring. I dette tilfælde vil det være logisk at gemme data på nodens disk ved hjælp af eller montering hostPath.
Et andet spørgsmål er, hvis du ønsker at oprette et separat miljø for udviklere for hver feature-gren. I dette tilfælde vil den rette tilgang være at starte én Cassandra-node, mens data gemmes i et distribueret lager, dvs. de nævnte Ceph og GlusterFS vil blive din mulighed. På den måde vil udvikleren være sikker på, at han ikke mister testdata, selv ved tab af én af noderne i Kubernetes-klyngen.
2. Overvågning
Næsten uden alternativ er Prometheus det bedste valg til at implementere overvågning i Kubernetes. (vi har udførligt beskrevet dette i ). Hvordan klarer Cassandra sig med metrics-eksportører til Prometheus? Og, hvad der endda er vigtigere, hvordan står det til med de passende dashboards til Grafana?
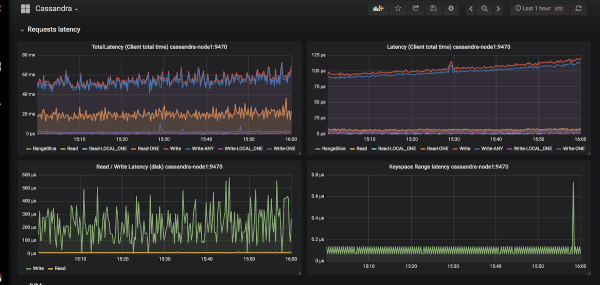
Et eksempel på, hvordan grafer i Grafana ser ud for Cassandra
Der er i alt to eksportører: og .
Vi har valgt den første for os, fordi:
- JMX Exporter vokser og udvikler sig, mens Cassandra Exporter ikke har fået den nødvendige opbakning fra fællesskabet. Cassandra Exporter understøtter stadig ikke de fleste versioner af Cassandra.
- Det kan startes som en javaagent ved at tilføje flaget
-javaagent:<plugin-dir-name>/cassandra-exporter.jar=--listen=:9180. - For det er der , som ikke er kompatibelt med Cassandra Exporter.
3. Valg af Kubernetes-primitive
Ifølge den ovenfor beskrevne struktur af Cassandra-klyngen, lad os forsøge at oversætte alt, hvad der er beskrevet der, til Kubernetes-terminologi:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → en pool af StatefulSets
- Cassandra Cluster → ???
Det ser ud til, at der mangler en ekstra enhed til at administrere hele Cassandra-klyngen på én gang. Men hvis noget mangler, kan vi oprette det! I Kubernetes er der en mekanisme til at definere brugerdefinerede ressourcer — .
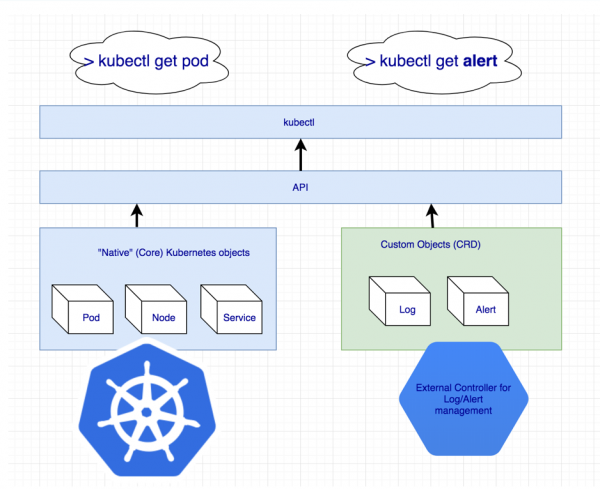
Deklaration af yderligere ressourcer til logs og alarmer
Men selve Custom Resource betyder ikke noget: der er brug for en controller. Måske må vi søge hjælp fra …
4. Identifikation af pods
Som punktet ovenfor er vi enige om, at én Cassandra-node svarer til én pod i Kubernetes. Men IP-adresserne på pod'erne vil hver gang være forskellige. Og identifikationen af en node i Cassandra sker netop baseret på IP-adressen... Det betyder, at efter hver sletning af en pod, vil Cassandra-klusteret tilføje en ny node.
Der er løsninger, og ikke kun én:
- Vi kan holde styr på værts-id'er (UUID'er, der unikt identificerer Cassandra-forekomster) eller på IP-adresser og gemme alt dette i nogle strukturer/tabeller. Metoden har to hovedulemper:
- Risiko for en kapløbssituation ved samtidig nedbrud af to noder. Efter genoprettelse vil Cassandra-noderne samtidig forsøge at anmode om en IP-adresse fra tabellen og konkurrere om den samme ressource.
- Hvis en Cassandra-node har mistet sine data, kan vi ikke længere identificere den.
- Den anden løsning virker som en lille hack, men alligevel: vi kan skabe en Service med ClusterIP for hver Cassandra-node. Problemerne med denne implementering:
- Hvis der er mange noder i Cassandra-klusteret, skal vi oprette mange Service'er.
- Muligheden for ClusterIP er implementeret gennem iptables. Dette kan blive et problem, hvis der er mange (1000… eller måske endda 100?) noder i Cassandra-klusteret. Selvom kan løse dette problem.
- Den tredje løsning er at bruge netværk af noder til Cassandra i stedet for dedikeret netværk af pods ved at aktivere indstillingen
hostNetwork: true. Denne metode pålægger visse begrænsninger:- Ved udskiftning af noder. Det er nødvendigt, at den nye node har præcis den samme IP-adresse som den tidligere (i skyer som AWS, GCP er dette næsten umuligt);
- Ved at bruge cluster-node-netværket begynder vi at konkurrere om netværksressourcer. Derfor vil det være problematisk at placere mere end én pod med Cassandra på en cluster-node.
5. Sikkerhedskopier
Vi ønsker at gemme en fuld version af dataene for én Cassandra-node efter en tidsplan. Kubernetes tilbyder en praktisk mulighed ved brug af , men her stopper Cassandra os.
Jeg vil minde om, at dele af dataene i Cassandra opbevares i hukommelsen. For at lave en fuld sikkerhedskopiering skal dataene fra hukommelsen (Memtables) overføres til disk (SSTables). På dette tidspunkt stopper Cassandra-noden med at acceptere forbindelser og slukkes helt fra klustret.
Derefter tages sikkerhedskopien (snapshot) og skemaet gemmes (keyspace). Og her finder vi ud af, at en simpel backup ikke giver os noget: vi skal gemme dataidentifikatorerne, som Cassandra-noden var ansvarlig for - det er specielle tokens.
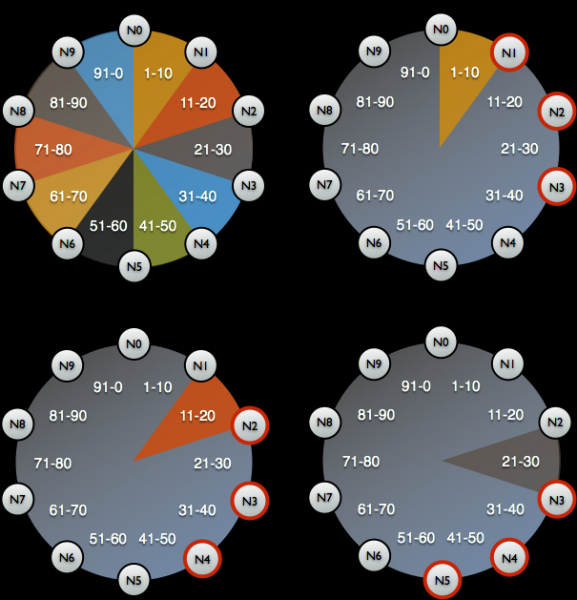
Fordeling af tokens for at identificere, hvilke data Cassandra-noderne er ansvarlige for
Et eksempel på et script til at tage backup af Cassandra fra Google i Kubernetes kan findes på . Det eneste punkt, som scriptet ikke tager højde for, er nulstillingen af data på noden før snapshot'et tages. Det vil sige, at backup udføres ikke for den nuværende tilstand, men for tilstanden fra lidt tidligere. Men dette hjælper med ikke at tage noden ud af drift, hvilket virker meget logisk.
set -eu

if [[ -z "$1" ]]; then
  info "Angiv venligst et keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Fejl under oprettelse af snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk 'Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Et eksempel på et bash-script til at tage backup fra en Cassandra-node
Færdige løsninger til Cassandra i Kubernetes
Hvad bruger man aktuelt til at implementere Cassandra i Kubernetes, og hvad passer bedst til de angivne krav?
1. Løsninger baseret på StatefulSet eller Helm-diagrammer
At bruge de grundlæggende funktioner i StatefulSets til at starte et Cassandra-klynge er en god mulighed. Ved hjælp af et Helm-diagram og Go-skabeloner kan man give brugeren et fleksibelt interface til at implementere Cassandra.
Normalt fungerer det fint... indtil noget uventet sker - som f.eks. en noden, der fejler. Standardværktøjer i Kubernetes kan simpelthen ikke tage højde for alle disse nævnte aspekter. Desuden er denne tilgang meget begrænset i, hvor meget den kan udvides til mere komplekse anvendelser: udskiftning af noder, backup, gendannelse, overvågning osv.
Repræsentanter:
- ;
- .
Begge diagrammer er lige gode, men de er begge udsat for de ovenfor beskrevne problemer.
2. Løsninger baseret på Kubernetes Operator
Disse muligheder er mere interessante, fordi de giver omfattende muligheder for at administrere klyngen. Til designet af Cassandra-operatøren, ligesom enhver anden database, ser et godt mønster ud som Sidecar Controller CRD:
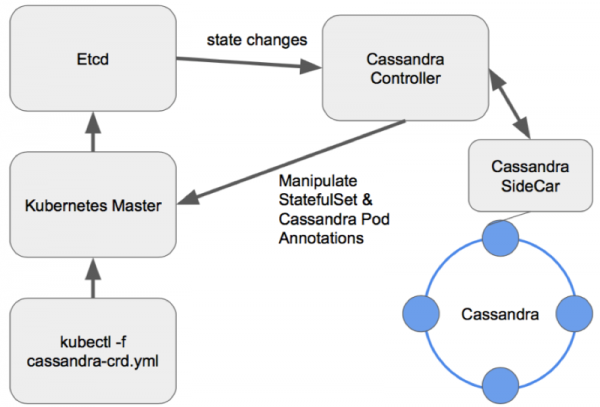
Diagram over styringen af noder i en korrekt designet Cassandra-operatør
Lad os se på de eksisterende operatører.
1. Cassandra-operator fra instaclustr
- Berettigelse: Alpha
- License: Apache 2.0
- Implementeret i: Java
Dette er virkelig et lovende og aktivt udviklingsprojekt fra et firma, der tilbyder administrerede Cassandra-implementeringer. Det bruger, som nævnt ovenfor, en sidecontainer, der modtager kommandoer via HTTP. Det er skrevet i Java, hvilket nogle gange gør, at det mangler mere avancerede funktioner i client-go-biblioteket. Desuden understøtter operatøren ikke forskellige racks for et enkelt datacenter.
Til gengæld har operatøren fordele såsom understøttelse af overvågning, høj-niveau cluster management ved hjælp af CRD og endda dokumentation til backup.
2. Navigator fra Jetstack
- Berettigelse: Alpha
- License: Apache 2.0
- Implementeret i: Golang
En operatør designet til at implementere DB-as-a-Service. I øjeblikket understøtter det to databaser: Elasticsearch og Cassandra. Den har interessante løsninger som adgangskontrol til databasen via RBAC (hvorfor en separat navigator-apiserver oprettes). Et interessant projekt, som er værd at holde øje med; dog blev den sidste commit lavet for halvandet år siden, hvilket klart mindsker dens potentiale.
3. Cassandra-operator fra vgkowski
- Berettigelse: Alpha
- License: Apache 2.0
- Implementeret i: Golang
Vi tog ikke dette ‘seriøst’, da den sidste commit til repository var mere end et år siden. Udviklingen af operatøren er blevet forladt: den sidste version af Kubernetes, som blev påstået at være understøttet, er 1.9.
4. Cassandra-operator fra Rook
- Berettigelse: Alpha
- License: Apache 2.0
- Implementeret i: Golang
Operatøren, hvis udvikling ikke går så hurtigt, som man kunne ønske. Den har en gennemtænkt CRD-struktur til cluster management, løser problemet med identifikation af noder ved hjælp af Service med ClusterIP (den velkendte 'hack')... men indtil videre er det alt. Der er ikke indbygget overvågning og backup lige nu (for resten tog vi os af overvågningen). ). Et interessant aspekt er, at man også kan implementere ScyllaDB ved hjælp af denne operatør.
NB: Denne operatør, med nogle mindre tilpasninger, blev brugt i et af vores projekter. Der blev ikke bemærket problemer med operatørens funktion under hele driften (~4 måneders drift).
5. CassKop fra Orange
- Berettigelse: Alpha
- License: Apache 2.0
- Implementeret i: Golang
Den yngste operatør på listen: den første commit blev lavet den 23. maj 2019. Den har allerede nu et stort antal funktioner fra vores liste, som kan findes i projektets repository. Operatøren er bygget på den populære operator-sdk. Understøtter overvågning ‘ud af boksen’. Hovedforskellen fra andre operatører er brugen , implementeret i Python og brugt til kommunikation mellem Cassandra-noder.
Konklusioner
Antallet af tilgange og mulige metoder til at flytte Cassandra til Kubernetes taler for sig selv: emnet er populært.
På dette tidspunkt kan man prøve noget af det ovenfor beskrevne på egen risiko: ingen af udviklerne garanterer 100 % funktionalitet i produktionsmiljøet. Men allerede nu ser mange produkter lovende ud til at blive brugt i udviklingsmiljøer.
Jeg tænker, at denne kvinde på skibet vil være nyttig i fremtiden!
P.S.
Læs også på vores blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
