

19. september i Moskva den første temamøde HUG (Highload++ User Group), der var dedikeret til mikrotjenester. Der blev præsenteret et foredrag med titlen «Drift af mikrotjenester: størrelse betyder noget, selvom du har Kubernetes», hvor vi delte omfattende erfaringer fra virksomheden «Flant» inden for drift af projekter med en mikrotjeneste-arkitektur. Det vil primært være nyttigt for alle udviklere, der overvejer at anvende denne tilgang i deres nuværende eller fremtidige projekt.
Vi præsenterer (50 minutter, væsentligt mere informativt end artiklen), samt en hovedopsummering i tekstform.
NB: Video og præsentation er også tilgængelige i slutningen af denne publikation.
Introduktion
Som regel har en god historie en opbygning, hovedplot og opløsning. Dette foredrag minder mere om en tragisk opbygning. Det er også vigtigt at bemærke, at det præsenterer et syn på mikrotjenester fra siden af udnyttelse.
Lad mig begynde med en sådan graf, hvis forfatter (i 2015) er Martin Fowler:
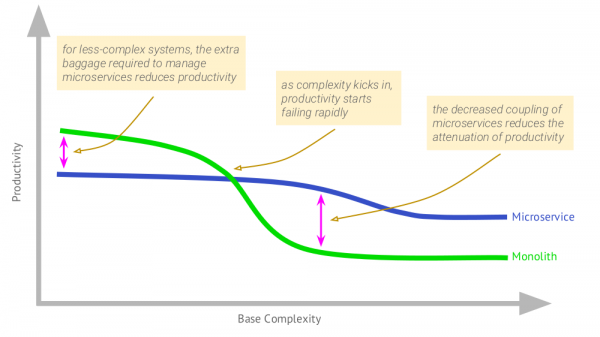
Grafen viser, hvordan produktiviteten for en monolitisk applikation, der når en vis størrelse, begynder at falde. Mikrotjenester adskiller sig ved, at den oprindelige produktivitet med dem er lavere, men efterhånden som kompleksiteten vokser, er degradationen af effektivitet ikke så mærkbar.
Jeg vil supplere denne graf for brug af Kubernetes:
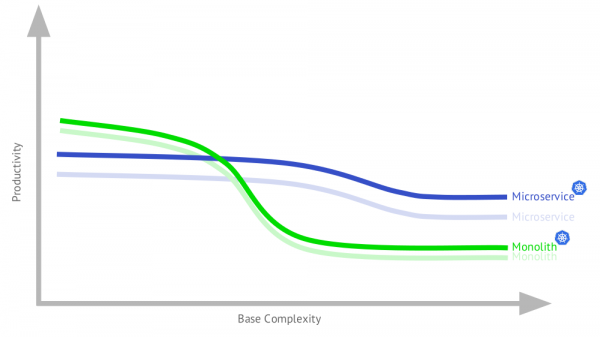
Hvorfor har applikationen med mikrotjenester fået det bedre? Fordi en sådan arkitektur stiller alvorlige krav til arkitekturen, som i mellemtiden bliver fremragende opfyldt af Kubernetes' muligheder. På den anden side vil noget af denne funktionalitet også være nyttig for monolitten, især fordi en typisk monolit i dag ikke rigtig er en ren monolit (detaljer følger i foredraget).
Som det ses, adskiller den endelige graf (når både monolitiske og mikrotjenesteapplikationer køres i en Kubernetes-infrastruktur) sig ikke meget fra den oprindelige. Herefter vil der blive talt om applikationer, der drives ved hjælp af Kubernetes.
Nyttig og skadelig mikrotjenestearkitektur
Her er den vigtigste tanke:
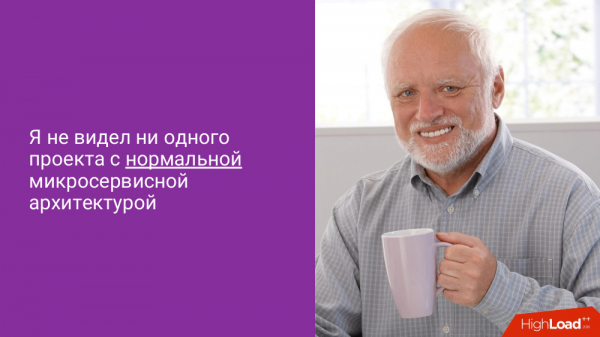
Hvad er normal mikrotjenestearkitektur? Den skal give dig reelle fordele ved at øge arbejdseffektiviteten. Hvis vi vender tilbage til grafen, ser vi den her:
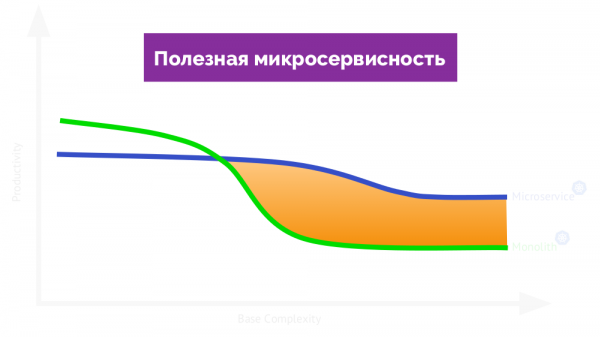
Hvis vi kalder den nyttig, vil der på den anden side af grafen være skadelig mikrotjenestearkitektur (hæmmer arbejdet):
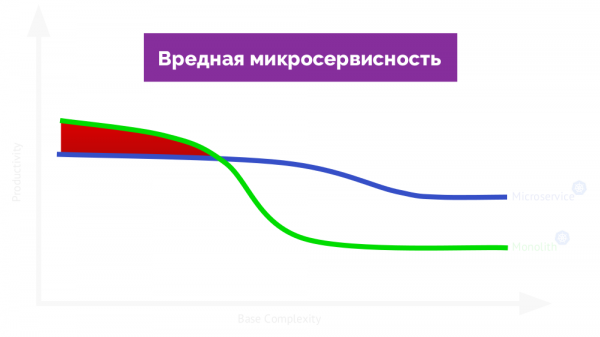
Når vi vender tilbage til "den centrale tanke": Skal jeg overhovedet stole på min erfaring? Siden starten af dette år har jeg set 85 projekter. Ikke alle har været mikrotjenester (omkring en tredjedel til halvdelen havde sådan en arkitektur), men det er stadig et stort antal. Vi (firmaet "Flant") som outsourcere har mulighed for at se et bredt udvalg af applikationer, der udvikles både i små virksomheder (med 5 udviklere) og i store (~500 udviklere). En ekstra fordel er, at vi ser, hvordan disse applikationer lever og udvikler sig over mange år.
Hvorfor mikrotjenester?
Der er fra den nævnte Martin Fowler:
- klare grænser for modulære deler;
- uafhængig deployment;
- frihed til at vælge teknologier.
Jeg har talt meget med arkitekter og softwareudviklere og spurgt, hvorfor de har brug for mikrotjenester. Og jeg har lavet min liste over deres forventninger. Her er, hvad jeg kom frem til:
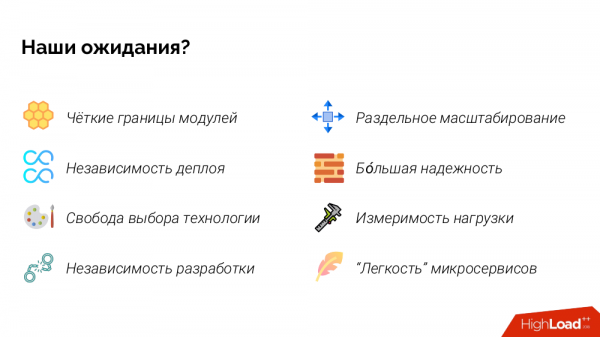
Hvis jeg skal beskrive "følelserne" omkring nogle af punkterne, så:
- klare grænser for moduler: vi har et skræmmende monolit, og nu vil alt blive pænt organiseret i Git-repositorier, hvor alt er "på hylder", ikke blandet varme med bløde;
- uafhængighed af deployment: vi kan implementere tjenester uafhængigt, så udviklingen går hurtigere (parallel offentliggøre nye funktioner);
- uafhængighed af udviklingen: vi kan overdrage denne mikrotjeneste til et team/udvikler, og den anden til en anden, hvilket gør det muligt for os at udvikle hurtigere;
- bfleste afstørre pålidelighed: hvis der opstår en delvis nedgang (hvis en mikrotjeneste falder ud af 20), så stopper kun én knap med at fungere, mens systemet fortsætter med at fungere generelt.
Typisk (skadelig) mikrotjeneste arkitektur
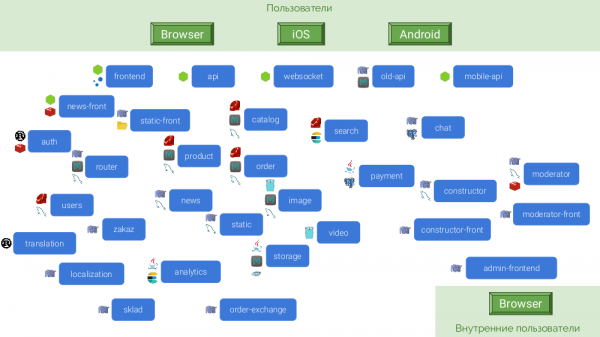
For at forklare, hvorfor virkeligheden ikke er, som vi forventer, vil jeg præsentere et samlet billede af mikrotjeneste arkitekturen baseret på erfaringer fra mange forskellige projekter.
Et eksempel vil være en abstrakt internetbutik, der ønsker at konkurrere med Amazon eller i det mindste OZON. Dens mikrotjeneste arkitektur ser således ud:
Af forskellige årsager er disse mikrotjenester skrevet på forskellige platforme:

Da hver mikrotjeneste skal have autonomi, har mange af dem brug for deres egen database og cache. Den endelige arkitektur ser således ud:
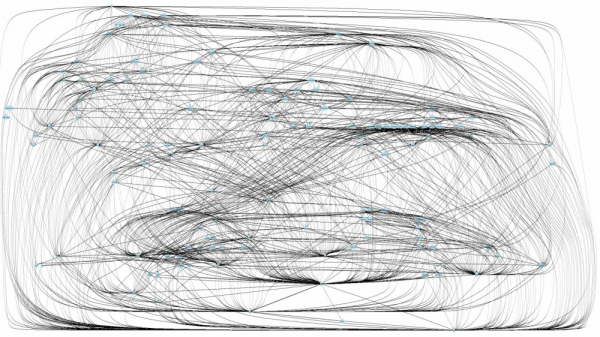
Hvad er konsekvenserne?
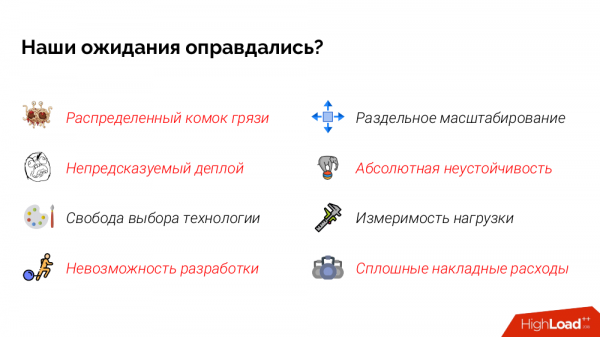
Hos Fowler er der en artikel om dette Lad os se, om vores forventninger er blevet opfyldt.
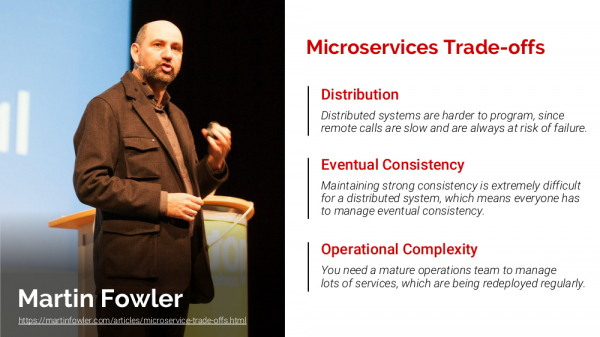
Klare grænser for moduler…
hvor mange mikrotjenester skal vi faktisk rette
Men , for at implementere ændringen? Kan vi overhovedet forstå, hvordan det hele fungerer, uden en distribueret sporingsmekanisme (da enhver forespørgsel behandles af halvdelen af mikrotjenesterne)?Der findes et mønster af "
et stort klumpet rodUafhængighed af implementering…
Teknisk set er den opnået: vi kan rulle hver mikrotjeneste ud separat. Men i praksis skal vi tage højde for, at der altid rulles
flere mikrotjenester ud , og vi skal tage højde forrækkefølgen af deres udrulning . Ideelt set skal vi overhovedet teste i et separat miljø for at sikre, at vi ruller ud i den rigtige rækkefølge.Valgfrihed vedrørende teknologi…
Den er der. Men husk, at frihed ofte grænser op til anarki. Det er meget vigtigt her ikke kun at vælge teknologier for at "lege" med dem.
Uafhængighed af udvikling…
Hvordan kan man skabe et testmiljø for hele applikationen (fra så mange komponenter)? Og man skal også holde det opdateret. Alt dette fører til, at
det reelle antal testmiljøer , som vi i princippet kan vedligeholde,viser sig at være minimalt Og for at implementere alt dette lokalt?.. Det viser sig, at udvikleren ofte arbejder uafhængigt, men "på gefühl", fordi han er nødt til at vente på, at testmiljøet bliver ledigt..
Separat skalering…
Ja, men det er begrænset af de anvendte databaser. I det givne eksempel vil der ikke være problemer med Cassandra, men der vil være med MySQL og PostgreSQL.
Større pålidelighed…
Ikke alene er det sådan, at nedbruddet af en mikrotjeneste ofte bryder den korrekte funktion af hele systemet, men der er også et nyt problem:fleste afdet er meget svært at gøre hver mikrotjeneste fail-sikker
. Fordi der anvendes forskellige teknologier i mikrotjenester (memcache, Redis osv.), skal der tænkes grundigt over og implementeres en løsning for hver, hvilket selvfølgelig er muligt, men kræver enorme ressourcer. Det er meget vanskeligt at gøre hver mikrotjeneste fejltolerant.. Fordi der bruges forskellige teknologier i mikrotjenester (memcache, Redis osv.), skal der tænkes grundigt over hver enkelt, og det skal implementeres, hvilket selvfølgelig er muligt, men kræver enorme ressourcer.
Måle belastning...
Det er virkelig alt godt med dette.
«Letheden» ved mikroservices...
Vi har ikke kun fået enorme netværksomkostninger (øget DNS-anmodninger mv.), men også på grund af mange underanmodninger er vi begyndt at replikere data (opbevare caches), hvilket har ført til betydelige lagerbehov.
Og her er resultatet af vores forventninger:
Men det er ikke alt!
Fordi:
- Vi får sandsynligvis brug for en meddelelsesbus.
- Hvordan laver man et konsistent backup på det ønskede tidspunkt? Den eneste reelle mulighed er at stoppe trafikken for dette. Men hvordan gør man det i produktion?
- Når det handler om at understøtte flere regioner, er det en meget ressourcekrævende opgave at organisere robusthed i hver af dem.
- Der opstår et problem med at foretage centraliserede ændringer. For eksempel, hvis vi skal opdatere PHP-versionen, skal der gøres et commit i hver repository (og der er mange).
- Væksten af operationel kompleksitet synes at være eksponentiel.
Hvad skal vi gøre ved alt dette?
Begynd med den monolitiske applikation. Fowler's erfaring med, at stort set alle succesfulde mikroservice-applikationer startede som en monolit, der blev for stor, hvorefter den blev opdelt. Samtidig har stort set alle systemer, der blev bygget som mikroservices fra starten, oplevet alvorlige problemer før eller siden.
En anden værdifuld tanke er, at for at et projekt med mikroservice-arkitektur skal være succesfuldt, skal du have meget gode kendskaber til både emneområdet og hvordan man laver mikroservices.Og den bedste måde at lære emneområdet på er at lave en monolit.
Men hvad skal man gøre, hvis vi allerede er i en sådan situation?
Det første skridt mod at løse ethvert problem er at acceptere det og forstå, at det er et problem, at vi ikke længere ønsker at lide.
Hvis vi skærer et voksende monolit af (når vi ikke længere kan købe ressourcer til det), så er det i dette tilfælde omvendt: når overdreven mikroservice-hed ikke længere hjælper, men hinder — skær det overflødige og forenkl!
For eksempel til den ovenfor beskrevne samlede figur...
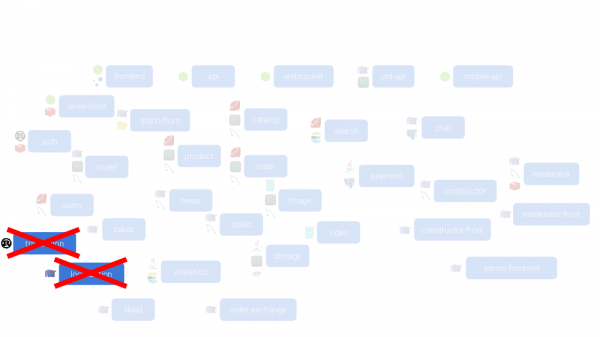
Lad være med at bruge de mest tvivlsomme mikroservices:
Flet alle mikroservices, der er ansvarlige for frontend-genereringen:
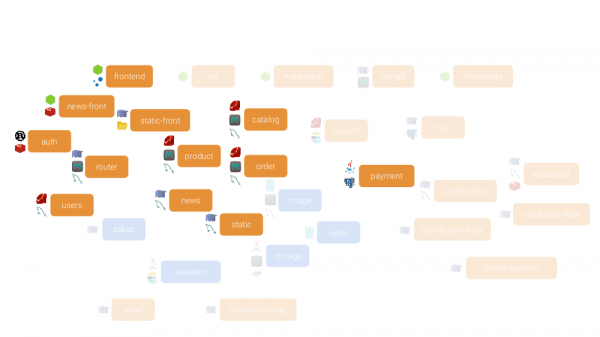
… i én mikrotjeneste, skrevet på et (moderne og fornuftigt, som du selv mener) sprog/framework:
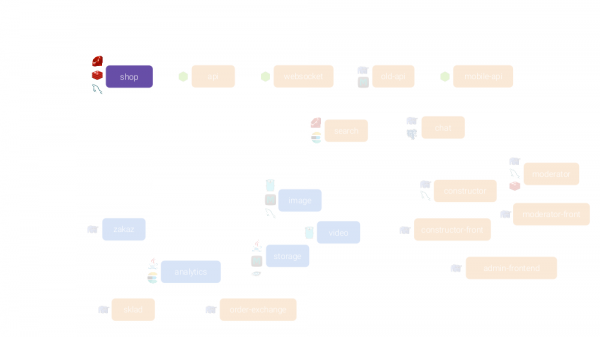
Den vil have én ORM (én DBMS) og først et par applikationer:
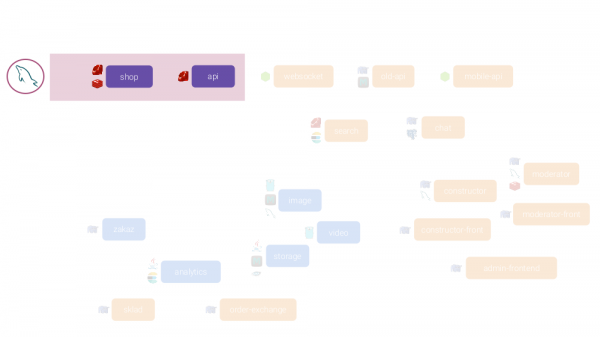
… men generelt kan der flyttes meget mere, hvilket giver dette resultat:
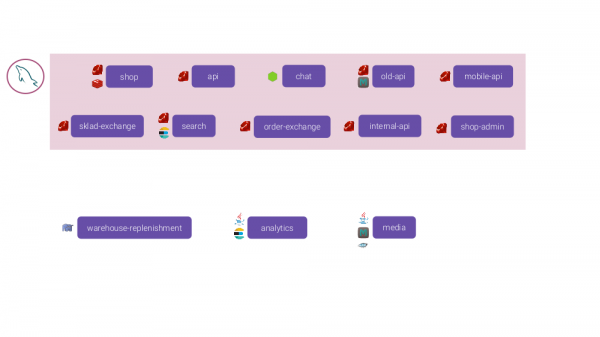
Desuden kører vi alt dette i Kubernetes som separate instanser, hvilket betyder, at vi stadig kan måle belastningen og skalere dem individuelt.
Sammenfatning
Se på billedet fra et bredere perspektiv. Meget ofte opstår alle disse problemer med mikrotjenester, fordi nogen tog deres opgave, men ville "lege med mikrotjenester".
I ordet "mikrotjenester" er delen "mikro" overflødig.. De er "mikro" kun fordi de er mindre end et stort monolit. Men man skal ikke tænke på dem som noget lille.
Og for den afsluttende tanke, lad os vende tilbage til den oprindelige graf:
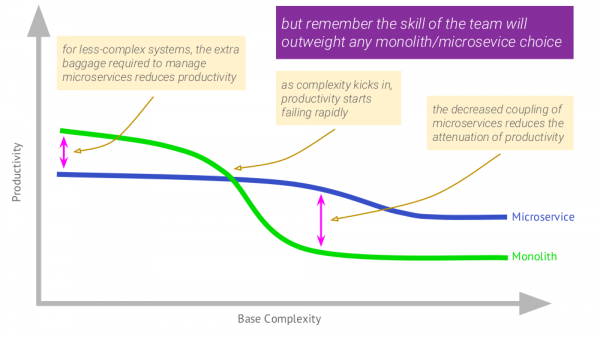
Den tilknyttede bemærkning (øverst til højre) kan opsummeres til, at færdighederne i det team, der laver dit projekt, altid er primære — det er dem, der vil spille en nøglerolle i dit valg mellem mikrotjenester og monolit. Hvis teamet mangler kompetencer, men går i gang med mikrotjenester, vil historien helt sikkert ende fatalt.
Video og slides
Video fra oplægget (~50 minutter; desværre formidler den ikke de mange følelser hos deltagerne, som i høj grad bestemte stemningen i foredraget, men sådan er det):
Præsentation af oplægget:
P.S.
Andre oplæg på vores blog:
- «» (Dmitry Stolyarov; 28. maj 2018 på RootConf);
- «» (Dmitry Stolyarov; 7. november 2017 på HighLoad++);
- «» (Dmitry Stolyarov; 6. juni 2017 på RootConf);
- «» (Dmitry Stolyarov; 8. november 2016 på HighLoad++);
- «» (Dmitry Stolyarov; 31. maj 2016 på RootConf).
Måske er du også interesseret i følgende publikationer:
- «»;
- «»;
- «».
Kilde: habr.com
