

Hej alle sammen! Jeg er CV-udvikler hos KROK. I tre år har vi arbejdet med projekter inden for CV. I den tid har vi lavet mange forskellige ting, blandt andet: overvåget chauffører for at sikre, at de ikke drikker, ryger, taler i telefon eller ser på noget andet end vejen; registreret dem, der kører i de busser, der ikke er tilladt, og tager flere pladser på parkeringspladsen; holdt øje med, at ansatte bærer hjelme, handsker osv.; identificeret medarbejdere, der vil have adgang til området; talt alt, hvad der kan tælles.
Hvor vil jeg hen med alt dette?
Under implementeringen af projekterne har vi gjort os mange erfaringer, flere end man kunne forvente, og nogle problemer kender du måske allerede, eller vil lære at kende i fremtiden.
Lad os modellere en situation
Forestil dig, at vi er ansatte i et ungt firma “N”, hvis aktivitet er relateret til ML. Vi arbejder på et ML (DL, CV) projekt, men på grund af forskellige årsager skifter vi til et andet arbejde, i det hele taget tager vi en pause og vender tilbage til vores eget eller andres neurale netværk.
- Det rette øjeblik er kommet, og man skal finde ud af, hvor man stoppede, hvilke hyperparametre man testede, og vigtigst af alt, hvilke resultater de førte til. Der kan være mange måder at gemme information om alle kørsel på: i hovedet, i konfigurationerne, i en notesbog, i et arbejdsrum i skyen. Jeg har set et tilfælde, hvor hyperparametre blev gemt som kommenterede linjer i koden, en sand fantasi. Og så forestil dig, at du ikke er tilbage til dit eget projekt, men til et projekt af en person, der forlod firmaet, og du har arvet koden og modellen kaldet model_1.pb. For at understrege situationen, lad os forestille os, at du også er en nybegynder.
- Lad os gå videre. For at køre koden har vi og alle, der skal arbejde med den, brug for at oprette et miljø. Ofte er det sådan, at det heller ikke blev givet videre til os af en eller anden grund. Dette kan også blive en ikke-triviel opgave. Man ønsker ikke at bruge tid på dette trin, gør man?
- Vi træner en model (for eksempel en bildetektor). Vi når til det punkt, hvor den er blevet ganske god — det er tid til at gemme resultatet. Lad os kalde den car_detection_v1.pb. Derefter træner vi endnu en — car_detection_v2.pb. Nogle tid senere træner vores kolleger eller vi selv yderligere med forskellige arkitekturer. I sidste ende dannes en bunke af artefakter, som vi skal indsamle omhyggeligt (men det gør vi senere, for vi har jo mere presserende opgaver).
- Og det var det! Vi har en model! Vi kan begynde at træne den næste model, udvikle arkitekturen til at løse en ny opgave, eller skal vi tage en kop te? Og hvem skal deploye det?
Identifikation af problemer
Arbejdet med et projekt eller produkt er resultatet af mange menneskers indsats. Med tiden kommer folk og går, og antallet af projekter stiger, og projekterne bliver mere komplekse. Så eller på en anden måde vil situationer fra den beskrevne cyklus (og ikke kun) optræde i forskellige kombinationer fra iteration til iteration. Alt dette fører til spild af tid, forvirring, nervøsitet, mulig utilfredshed fra kunden, og i sidste ende — tabt indtjening. Selvom vi alle ofte går i de samme gamle fælder, er jeg sikker på, at ingen ønsker at opleve disse øjeblikke igen og igen.
Så vi har gennemgået en udviklingscyklus og ser, at der er problemer, som skal løses. For dette er der brug for:
- at gemme arbejdsresultaterne på en praktisk måde;
- at gøre processen for involvering af nye medarbejdere enkel;
- at forenkle udrulningsprocessen for udviklingsmiljøet;
- at etablere en proces for versionering af modeller;
- at have en praktisk måde at validere modeller;
- at finde et værktøj til at håndtere modellernes tilstand;
- at finde måder at levere modeller til produktion.
Det ser ud til, at vi skal opfinde et workflow, der let og bekvemt kan håndtere denne livscyklus? En sådan praksis kaldes MLOps.
MLOps, eller DevOps for maskinlæring, gør det muligt for teams af dataanalyse- og IT-specialister at samarbejde og øge hastigheden på udvikling og udrulning af modeller ved hjælp af overvågning, test og en administrationssystem for maskinlæringsmodeller.
Du kan , hvad fyrene fra Google mener om det hele. Fra artiklen fremgår det, at MLOps er et ret omfattende emne.
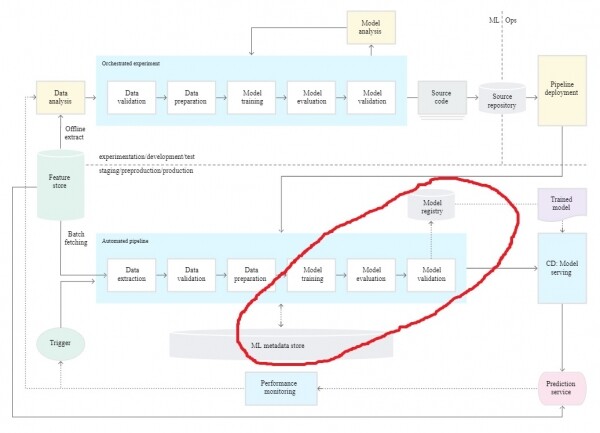
I den følgende artikel beskriver jeg kun en del af processen. For implementeringen vil jeg bruge værktøjet MLflow, da det er et open-source projekt, der kræver en lille mængde kode for at oprette forbindelse, og der er integration med populære ML-rammer. Du kan søge på internettet efter andre værktøjer som Kubeflow, SageMaker, Trains osv., og muligvis finde det, der passer bedre til dine behov.
"Bygger" MLOps med eksemplet på brugen af værktøjet MLFlow
MLFlow er en open-source platform til styring af livscyklussen for ML-modeller ().
MLflow inkluderer fire komponenter:
- MLflow Tracking - dækker spørgsmålet om registrering af resultater og de parametre, der førte til disse resultater;
- MLflow Project - giver mulighed for at pakke kode og reproducere den på enhver platform;
- MLflow Models - ansvarlig for deployering af modeller i produktion;
- MLflow Registry - giver mulighed for at opbevare modeller og styre deres tilstand i et centralt lager.
MLflow arbejder med to enheder:
- kørsel - det komplette træningsforløb, parametre og metrikker, som vi ønsker at registrere;
- eksperiment - et "emne", som kørselerne er samlet omkring.
Alle trin i eksemplet er implementeret på operativsystemet Ubuntu 18.04.
1. Opsætter serveren
For at vi nemt kan styre vores projekt og få al nødvendig information, opsætter vi serveren. MLflow tracking server har to hovedkomponenter:
- backend store - ansvarlig for opbevaring af information om registrerede modeller (understøtter 4 DBMS: mysql, mssql, sqlite og postgresql);
- artifact store - ansvarlig for opbevaring af artefakter (understøtter 7 lagermuligheder: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP-server, SFTP-server, NFS, HDFS).
Som artifact store for enkelhedens skyld vælger vi en SFTP-server.
- opretter gruppe
$ sudo groupadd sftpg - tilføjer bruger og indstiller hans adgangskode
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - justerer et par adgangsindstillinger
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - tilføjer et par linjer i /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - genstarter tjenesten
$ sudo systemctl restart sshd
Som backend store vi vælger postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Opret ny bruger: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Indtast navn på rollen der skal tilføjes: mlflow_user
Indtast adgangskode for den nye rolle: mlflow
Indtast det igen: mlflow
Skal den nye rolle være en superbruger? (y/n) n
Skal den nye rolle have lov til at oprette databaser? (y/n) n
Skal den nye rolle have lov til at oprette flere nye roller? (y/n) n
# Opret database mlflow_bd ejet af mlflow_user
$ createdb -O mlflow_user mlflow_db
For at starte serveren skal følgende Python-pakker installeres (det anbefales at oprette et separat virtuelt miljø):
pip install mlflow
pip install pysftp
Lad os starte vores server
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Tilføj tracking
For at sikre, at resultaterne af vores træninger ikke går tabt, sådan at fremtidige generationer af udviklere kan forstå, hvad der overhovedet foregik, og at de mere erfarne samt du kan analysere træningsprocessen frit, skal vi tilføje tracking. Med tracking menes der at gemme parametre, metrikker, artefakter og enhver yderligere information om afviklingen af træningen, i vores tilfælde, på serveren.
Som eksempel har jeg oprettet et lille i Keras til segmentering af alt, hvad der findes i . For at tilføje tracking har jeg oprettet filen mlflow_training.py.
Her er linjerne, hvor det virkelig bliver interessant:
def run(self, epochs, lr, experiment_name):
        # henter id'et af eksperimentet, opretter et eksperiment i tilfælde af at det ikke findes
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # opretter et "run" og får dets id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # angiver at vi vil gemme resultaterne på en fjernserver
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Her er self.remote_server en lille indpakning omkring metoderne mlflow.tracking. MlflowClient (jeg lavede det for nemheds skyld), som jeg bruger til at oprette eksperimenter og køre dem på serveren. Derefter angiver jeg, hvor resultaterne af kørselen skal sendes hen (mlflow.set_tracking_uri(self.tracking_uri)). Jeg aktiverer automatisk logning med mlflow.keras.autolog(). Indtil videre understøtter MLflow Tracking automatisk logning for TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Hvis du ikke fandt dit framework eller bibliotek, kan du altid logge det eksplicit. Vi starter træningen. Vi registrerer tags og indgangsparametre på den fjernbetjente server.
Et par linjer, og du, ligesom alle andre interesserede, har adgang til information om alle kørselserne. Fedt?
3. Vi opretter projektet
Nu gør vi det lettere end nogensinde at starte projektet. Til dette tilføjer vi en MLproject-fil og conda.yaml til projektets rod.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'liste over kategorier fra coco datasættet'}
        epochs: {type: int, help: 'antallet af epoker under træning'}

        lr: {type: float, default: 0.001, help: 'læringsrate'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'eksempel resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'serverens adresse'}
        experiment_name: {type: str, default: 'My_experiment', help: 'fjern- og lokal eksperimentnavn'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow-projektet har flere egenskaber:
- Name — navnet på dit projekt;
- Environment — i mit tilfælde indikerer conda_env, at Anaconda bruges til kørsel, og beskrivelsen af afhængigheder findes i filen conda.yaml;
- Entry Points — angiver, hvilke filer og med hvilke parametre vi kan køre (alle parametre, når træningen startes, logges automatisk)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Som kørselmiljø kan du bruge docker, for mere information, kontakt venligst .
4. Vi starter træningen
Vi kloner projektet og går ind i projektmappen:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
For at køre det skal du installere bibliotekerne
pip install mlflow
pip install pysftp
Da jeg i eksemplet bruger conda_env, skal Anaconda være installeret på din computer (men dette kan omgås ved at installere de nødvendige pakker selv og lege med opstartsparametrene).
Alle forberedende trin er afsluttet, og vi kan påbegynde træningen. Fra roden af projektet:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Efter at have indtastet kommandoen oprettes et conda-miljø automatisk, og træningen starter.
I det ovenstående eksempel har jeg angivet antallet af epoker til træning, kategorierne vi ønsker at segmentere (den fulde liste kan ses ) og adressen til vores eksterne server.
Den fulde liste af mulige parametre kan ses i filen MLproject.
5. Vurderer træningsresultaterne
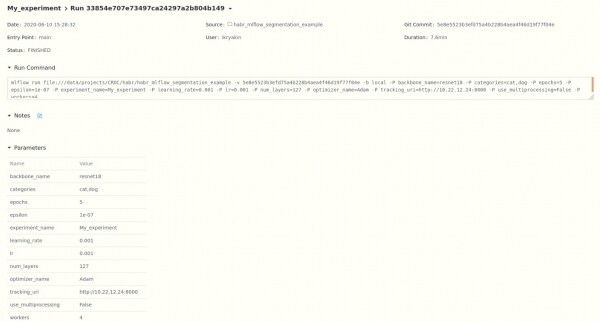
Når træningen er afsluttet, kan vi gå til adressen på vores server i browseren
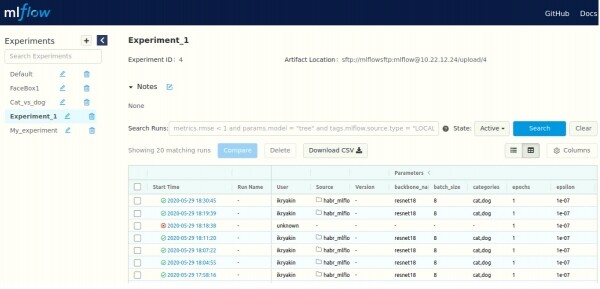
Her ser vi listen over alle eksperimenter (øverst til venstre) samt information om kørselerne (i midten). Vi kan se mere detaljeret information (parametre, metrikker, artefakter og en smule ekstra information) om hver kørsel.
For hver metrik kan vi observere historikken for ændringer.
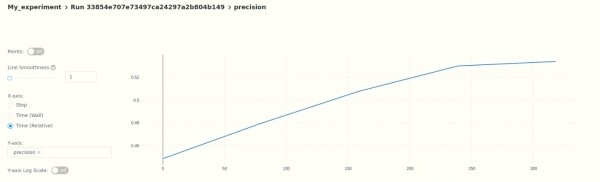
Det vil sige, at vi i øjeblikket kan analysere resultaterne i "manuelt" mode, og du kan også opsætte automatisk validering ved hjælp af MLflow API.
6. Registrerer modellen
Når vi har analyseret vores model og besluttet, at den er klar til brug, går vi videre til at registrere den; for dette vælger vi den aktuelle kørsel (som vist i det foregående punkt) og ruller ned.
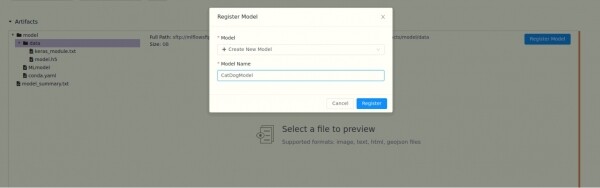
Når vi har givet vores model et navn, får den en version. Ved at gemme en anden model med det samme navn, vil versionen automatisk blive opgraderet.
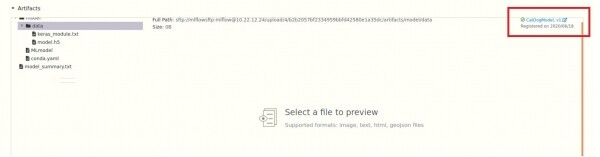
For hver model kan vi tilføje en beskrivelse og vælge en af tre tilstande (Staging, Production, Archived). Senere kan vi via API'en tilgå disse tilstande, hvilket sammen med versionering giver ekstra fleksibilitet.
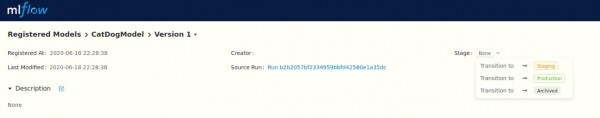
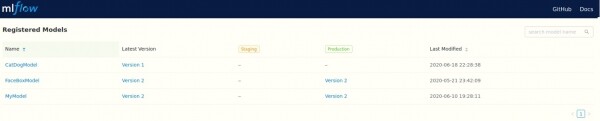
Vi har også nem adgang til alle modellerne
og deres versioner.
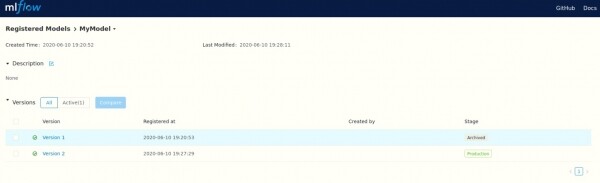
Som i det forrige punkt kan alle operationer udføres via API.
7. Udrulning af modellen
På dette stadium har vi allerede en trænet (keras) model. Et eksempel på, hvordan den kan bruges:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Her er self.registry igen en lille omskrivning over mlflow.tracking.MlflowClient for nemheds skyld. Det handler om, at jeg tilgår en fjernserver og leder efter en model med det angivne navn, nemlig den nyeste produktionsversion. Derefter downloader jeg artefakten lokalt til mappen .\/model og bygger modellen fra denne mappe mlflow.keras.load_model(local_path). Nu kan vi bruge vores model. CV (ML) udviklere kan trygt arbejde på at forbedre modellen og publicere nye versioner.
Afslutningsvis
Jeg har præsenteret et system, der muliggør:
- centralt at opbevare information om ML-modeller, træningsforløb og resultater;
- hurtigt at opsætte udviklingsmiljøer;
- at følge med i og analysere arbejdet med modeller;
- nemt at håndtere versionering og administrere modelstatus;
- let at deployere de opnåede modeller.
Dette eksempel er konstrueret som en lege-model og fungerer som et udgangspunkt for at bygge dit eget system, som muligvis vil inkludere automatisering af resultatvurdering og registrering af modeller (punkt 5 og 6 henholdsvis) eller at du tilføjer versionering af datasæt, eller måske noget andet? Jeg forsøgte at formidle ideen om, at du har brug for MLOps generelt; MLflow er blot et middel til at nå målet.
Skriv hvilke problemer, du har stødt på, som jeg ikke har dækket?
Hvad ville du tilføje til systemet for at opfylde dine behov?
Hvilke værktøjer og tilgange bruger du til at dække alle eller dele af problemerne?
P.S. Jeg efterlader et par links:
github projekt —
MLflow —
Min arbejds-e-mail til spørgsmål — ikryakin@croc.ru
I vores virksomhed afholdes der jævnligt forskellige arrangementer for it-specialister. For eksempel vil der den 8. juli kl. 19:00 Moskva-tid blive afholdt en meetup om CV i online-format. Hvis du er interesseret, kan du deltage; tilmelding er tilgængelig. .
Kilde: habr.com
