

Introduktion
For some time now, I have been tasked with developing a fault-tolerant cluster for , operating in several data centers connected by fiber optics within one city, and capable of withstanding the failure (for example, a power outage) of one data center. As the software responsible for fault tolerance, I chose , because it is the official solution from RedHat for building fault-tolerant clusters. It is good in that RedHat provides support for it, and because this solution is universal (modular). With its help, it will be possible to ensure fault tolerance not only for PostgreSQL but also for other services, either by using standard modules or by creating them for specific needs.
A reasonable question arose regarding this solution: how fault-tolerant will the fault-tolerant cluster actually be? To investigate this, I developed a test setup that simulates various failures on the nodes of the cluster, waits for recovery, restores the failed node, and continues testing in a cycle. Initially, this project was called hapgsql, but over time I grew tired of the name with only one vowel. Therefore, I began to name the fault-tolerant databases (and the float IPs pointing to them) krogan (a character from a computer game who has all vital organs duplicated), while the nodes, clusters, and the project itself are called tuchanka (the planet where the krogan live).
Now the management has allowed . The README will soon be translated into English (because it is expected that the main users will be developers of Pacemaker and PostgreSQL), and I decided to format the old Russian version of the README (partially) as this article.
Clusters are deployed on virtual machines . A total of 12 virtual machines will be deployed (36GiB in total), forming 4 fault-tolerant clusters (different options). The first two clusters consist of two PostgreSQL servers, which are located in different data centers, and a common server witness c quorum device (located on a cheap virtual machine in the third data center), which resolves uncertainty 50%/50%, giving its vote to one of the parties. The third cluster spans three data centers: one master, two slaves, without quorum device. Klyngen består af fire PostgreSQL-servere, to per datacenter: en master og de øvrige replikaer, og benytter også witness c quorum device. Klyngen kan tåle at to servere eller et datacenter fejler. Denne løsning kan, om nødvendigt, skaleres til et større antal replikaer.
Tidsynkroniseringstjeneste er også omkonfigureret for redundans, men den bruger metoden med ntpd (orphan mode). Den centrale server witness funker som en central NTP-server, der distribuerer sin tid til alle klynger, hvilket synchroniserer alle serverne indbyrdes. Hvis witness den fejler eller isoleres, så vil en af klyngens servere (inden for klyngen) begynde at distribuere sin tid. En supplementary caching HTTP proxy er også oprettet på witness, som gør det muligt for de øvrige virtuelle maskiner at få adgang til Yum-repositories. I virkeligheden vil sådanne tjenester som tidsynkronisering og proxy sandsynligvis være placeret på dedikerede servere, mens de i denne opstilling er placeret på witness kun for at spare på antallet af virtuelle maskiner og plads.
Versioner
v0. Arbejder med CentOS 7 og PostgreSQL 11 på VirtualBox 6.1.
Klyngeopbygning
Alle klynger er designet til at være placeret i flere datacentre, bundet sammen i et fladt netværk og skal kunne modstå nedbrud eller netværksisolering af et datacenter. Derfor ikke er muligt bruger standard teknologien Pacemaker til at beskytte mod split-brain teknologi kaldet STONITH (Shoot The Other Node In The Head) eller fencing. Dens essens: hvis noderne i klyngen begynder at mistænke, at en nod er i problemer, ikke svarer eller opfører sig unormalt, vil de tvinge den til at lukke ned via "eksterne" enheder, såsom en IPMI-kontrolkort eller UPS. Men dette vil kun virke i tilfælde, hvor i tilfælde af en enkelt serverfejl fortsætter IPMI eller UPS med at fungere. Her planlægges der beskyttelse mod en meget mere katastrofal fejl, når hele datacentret fejler (for eksempel mister strøm). Ved en sådan fejltagelse vil alle stonith-enheder (IPMI, UPS osv.) heller ikke fungere.
I stedet bygger systemet på en kvorum-ide. Alle noder har stemmerettighed, og kun de, der kan se mere end halvdelen af alle noder, kan fungere. Antallet "halvdel + 1" kaldes kvorum. Hvis kvorum ikke kan oprettes, beslutter noden, at den er i netværksisolering og skal deaktivere sine ressourcer, dvs. det er sådan en beskyttelse mod split-brain. Hvis softwaren, der styrer denne adfærd, ikke fungerer, skal en watchdog aktiveres, for eksempel baseret på IPMI.
Hvis antallet af noder er lige (klyngen i to datacentre), kan der opstå det, der kaldes usikkerhed 50%/50% (fifty-fifty), når netværksisoleringen opdeler klyngen præcist i to. Derfor tilføjes quorum device — en ubesværet daemon, der kan køres på den billigste virtuelle maskine i det tredje datacenter. Den giver sin stemme til en af sektionerne (som den ser), og derved afklarer usikkerheden 50%/50%. Serveren, hvor quorum-enheden skal køres, har jeg kaldt witness (terminologi fra repmgr, som jeg kan lide).
Ressourcer kan flytte fra sted til sted, for eksempel fra defekte servere til fungerende, eller på ordre fra systemadministratorer. For at kunderne skal vide, hvor deres nødvendige ressourcer er (hvor skal de forbinde?), bruges der flydende IP (float IP). Dette er IP-adresser, som Pacemaker kan flytte mellem noder (alt er i et fladt netværk). Hver af dem symboliserer en ressource (tjeneste) og vil være der, hvor der skal forbindes for at få adgang til denne tjeneste (i vores tilfælde databasen).
Tuchanka1 (schema med tæthed)
Struktur
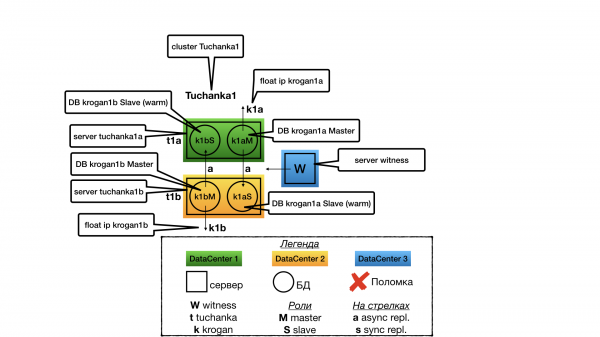
Idéen var, at vi har mange små databaser med lav belastning, for hvilke det ikke er rentabelt at opretholde en dedikeret slave-server i hot standby-tilstand til read-only-transaktioner (der er ikke behov for sådan en ressourcespild).
Der er én server i hver datacenter. På hver server er der to PostgreSQL-instanser (i PostgreSQL-terminologi kaldes de kløfter, men for at undgå forvirring vil jeg kalde dem instanser (analogt med andre databaser) og kalde klustrene kun for Pacemaker-klustre). En instans kører i master-tilstand, og kun den leverer tjenester (kun denne har et float IP). Den anden instans fungerer som slave for det andet datacenter og vil kun levere tjenester, hvis dens master fejler. Da der kun vil være én instans, der leverer tjenester (behandler forespørgsler) det meste af tiden (master), optimeres serverens ressourcer til masteren (hukommelse tildeles til cache shared_buffers osv.), men så der også er tilstrækkelige ressourcer til den anden instans (selv om det kun er til suboptimal drift gennem filsystemets cache) i tilfælde af svigt i et af datacentrene. Slaven leverer ikke tjenester (behandler ikke read only-forespørgsler) under normal drift af klyngen for at undgå ressourcekonflikter med masteren på samme maskine.
I tilfælde af to noder er høj tilgængelighed kun mulig ved asynkron replikation, da en synkron fejlfunktion på slaven vil resultere i stop af masteren.
Fejl witness
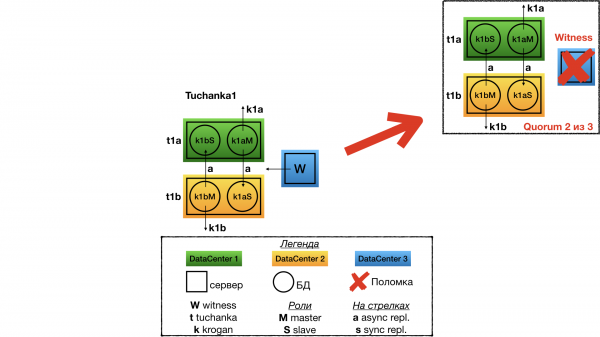
Fejl witness (quorum device) vil jeg kun overveje for klyngen Tuchanka1, historien er den samme for alle andre. Ved fejl på witness ændres der ikke noget i klynge-strukturen, alt fortsætter med at fungere som før. Men quorum vil være lig med 2 ud af 3, og derfor vil enhver efterfølgende fejl være fatal for klyngen. Det skal hastigt repareres.
Fejl Tuchanka1
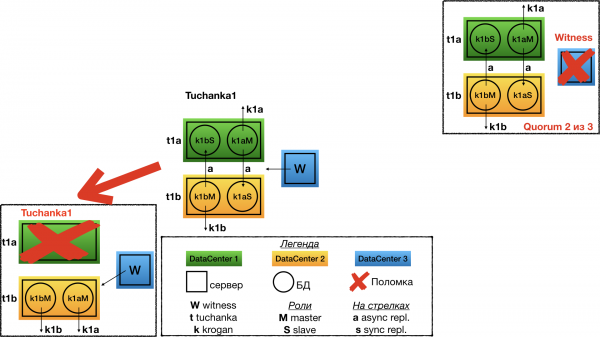
Fejl på et af datacentrene for Tuchanka1. I dette tilfælde witness stemmer denne for den anden node i det andet datacenter. Her bliver den tidligere slave omdannet til master, hvilket resulterer i, at begge mastere kører på én server, og begge deres float IP peger på dem.
Tuchanka2 (klassisk)
Struktur
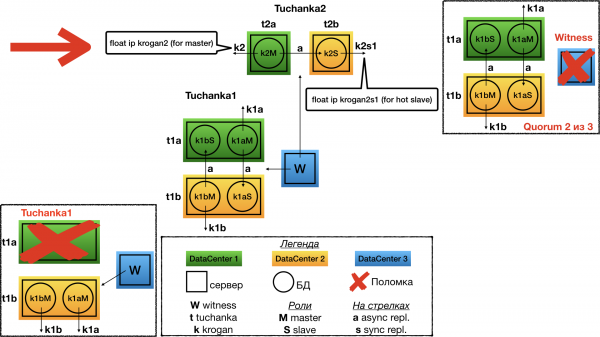
Den klassiske konfiguration bestående af to noder. På den ene kører master, og på den anden er der en slave. Begge kan håndtere forespørgsler (slaven kun read only), derfor peger begge på et float IP: krogan2 — på master, krogan2s1 — på slaven. Der vil være høj tilgængelighed både for masteren og slaven.
I tilfælde af to noder er høj tilgængelighed kun mulig ved asynkron replikation, fordi en synkron fejlfunktion på slaven vil resultere i stop af masteren.
Fejl Tuchanka2
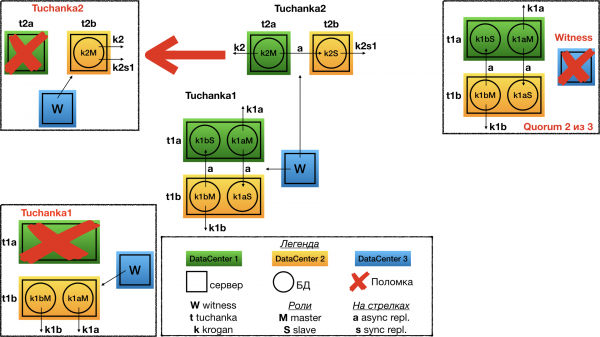
Ved fejl på et af datacentrene witness stemmer imod den anden. På det eneste fungerende datacenter vil master blive oprettet, og begge float IP'er: master og slave vil pege på det. Selvfølgelig skal instansen være konfigureret således, at den har tilstrækkelige ressourcer (grænser for forbindelser osv.) til samtidig at håndtere alle forbindelser og anmodninger fra både master og slave float IP. Det vil sige, at den skal have et tilstrækkeligt overskud af grænser under normal drift.
Tuchanka4 (mange slaver)
Struktur
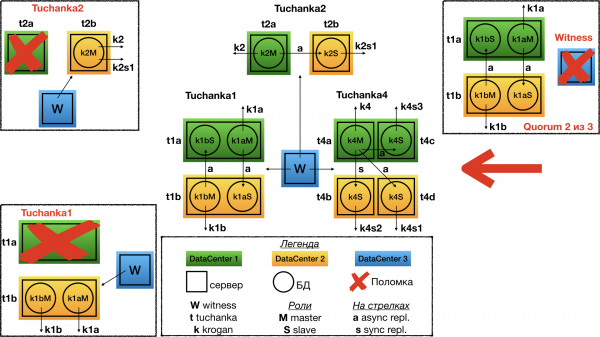
Der er allerede en anden ekstrem. Der er databaser, som har mange read-only anmodninger (et typisk tilfælde af en højbelastet hjemmeside). Tuchanka4 er en situation, hvor der kan være tre eller flere slaver til at håndtere sådanne anmodninger, men ikke mere end det. Ved et meget stort antal slaver skal der opfindes et hierarkisk replikationssystem. I det mindste tilfælde (på billedet) er der to servere i hvert af de to datacentre, hvor hver har en instans PostgreSQL.
En anden funktion ved denne ordning er, at der allerede kan organiseres en synkron replikation. Den er konfigureret til at replikere, så vidt det er muligt, til et andet datacenter, og ikke til en kopi i det samme datacenter som master. Master og hver slave peger på float IP. Ideelt set skal der mellem slaverne laves en belastningsbalancering af anmodninger på en eller anden måde. sql proxy, for eksempel på klientsiden. Forskellige typer af klienter kan kræve forskellige typer sql proxy, og kun klientudviklerne ved, hvem der har brug for hvad. Denne funktionalitet kan implementeres både som et eksternt demon og som et klientbibliotek (forbindelsespool) osv. Alt dette ligger uden for emnet for det fejltolerante DB-kluster (fejltolerance SQL proxy kan implementeres uafhængigt, sammen med klientens fejltolerance).
Fejl Tuchanka4
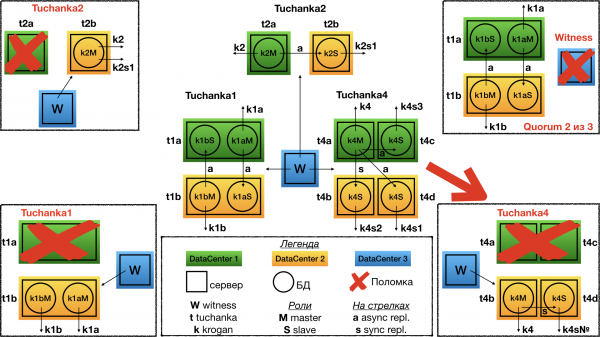
Ved fejlen på et datacenter (dvs. de to servere) stemmer witness for den anden. Som et resultat fungerer der to servere i det andet datacenter: på den ene kører master, og den peger på master float IP (til modtagelse af read-write anmodninger); og på den anden server kører en slave med synkron replikation, og den peger på en af slave float IP'er (til read only-anmodninger).
Det første, man skal bemærke: de fungerende slave float IP'er vil ikke være alle, men kun én. Og for korrekt brug af den, skal det være sådan, at sql proxy omdirigerede alle forespørgsler til den eneste tilbageværende float IP; og hvis sql proxy nej, så kan man opdatere alle float IP'er for slaverne med komma i URL'en for forbindelsen. I så fald libpq vil forbindelsen ske til den første fungerende IP, som det er gjort i testsystemet. Det er muligt, at det ikke fungerer på samme måde i andre biblioteker, f.eks. JDBC, og det er nødvendigt sql proxy. Det er gjort sådan, fordi der er forbud mod at have flere float IP'er for slaverne kørende på samme server, så de bliver jævnt fordelt på slave-serverne, hvis der er flere i drift.
Det andet: selv i tilfælde af fejl i datacenteret vil den synkrone replikation blive bevaret. Og selv hvis der sker en sekundær fejl, altså hvis en af de to servere i det tilbageværende datacenter går ned, vil klyngen, selvom den stopper med at yde service, stadig gemme information om alle bekræftede transaktioner, som den har givet en bekræftelse om kommittering (der vil ikke være tab af information ved sekundær fejl).
Tuchanka3 (3 datacentre)
Struktur
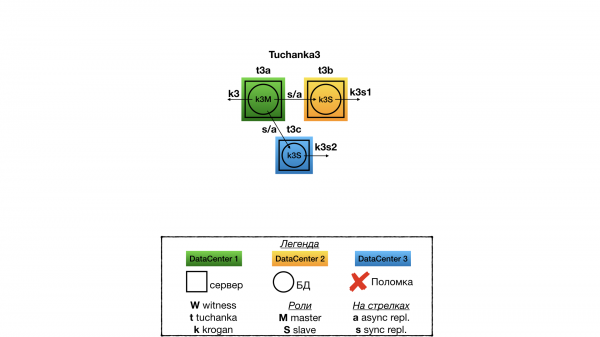
Dette er en klynge for situationen, hvor der er tre fuldt operationelle datacentre, hvor hver har en fuldt operationel DB-server. I dette tilfælde quorum device er ikke nødvendig. I ét datacenter kører masteren, i de to andre — slaverne. Replikationen er synkron, type ANY (slave1, slave2), hvilket betyder, at klienten vil modtage en bekræftelse på kommitteringen, når nogen af slaverne først svarer, at de har accepteret kommitteringen. Der peges på en float IP for masteren og to for slaverne. I modsætning til Tuchanka4 er alle tre float IP'er fejl tolerante. Til belastningsbalancering af read-only SQL-forespørgsler kan man bruge sql proxy (med separate fejl tolerancer), eller den ene halvdel af kunderne får tildelt én slave float IP, og den anden halvdel en anden.
Fejl Tuchanka3
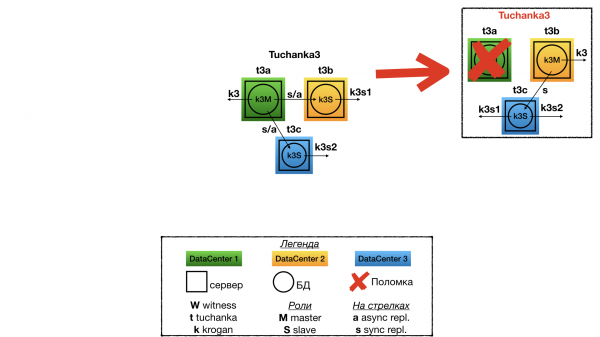
Ved fejl i et af datacentrene forbliver der to. I ét kører masteren og float IP'en fra masteren, i det andet — slaven og begge slave float IP'er (instansen skal have dobbelt så mange ressourcer for at kunne modtage alle forbindelser fra begge slave float IP'er). Mellem masterne og slaven er der synkron replikation. Desuden vil klyngen gemme information om bekræftede og accepterede transaktioner (der vil ikke være tab af information) i tilfælde af ødelæggelse af to datacentre (hvis de ikke ødelægges samtidigt).
Jeg har valgt ikke at inkludere en detaljeret beskrivelse af filstrukturen og deployment. Den, der ønsker at lege med det, kan læse alt dette i README. Jeg giver kun en beskrivelse af automatiseret testning.
Automatiseret testsystem
For at teste fejltolerance i klynger med simulering af forskellige fejl er der oprettet et automatiseret testsystem. Det startes med et script test/failure. Scriptet kan tage som parametre numrene på de klynger, der ønskes testet. For eksempel vil denne kommando:
test/failure 2 3teste kun den anden og tredje klynge. Hvis der ikke angives parametre, vil alle klynger blive testet. Alle klynger testes parallelt, og resultatet vises i tmux-panelet. Tmux bruger en dedikeret tmux-server, så scriptet kan startes fra standard tmux, hvilket vil resultere i indlejret tmux. Jeg anbefaler at bruge terminalen i et stort vindue med lille skrift. Før testningen begynder, bliver alle virtuelle maskiner rullet tilbage til det øjebliksbillede, der blev taget ved afslutningen af scriptet. setup.
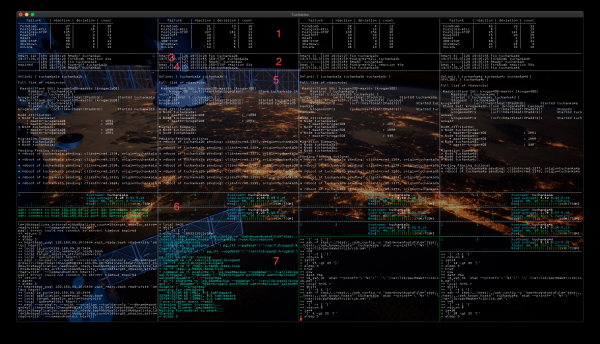
Terminalen er opdelt i kolonner svarende til antallet af testede klynger, som i standard (på skærmbilledet) er fire. Indholdet af kolonnerne vil jeg beskrive med eksemplet Tuchanka2. Panelerne på skærmbilledet er nummererede:
- Her vises statistikken for testene. Kolonnerne:
- failure — navnet på testen (funktionen i scriptet), der simulerer fejlen.
- reaction — det aritmetiske gennemsnit af tiden i sekunder, hvori klyngen genoprettede sin funktionalitet. Det måles fra starten af scriptet, der simulerer fejlen, indtil klyngen genopretter sin funktionalitet og kan fortsætte med at levere tjenester. Hvis tiden er meget kort, for eksempel seks sekunder (det sker i klynger med flere slaver (Tuchanka3 og Tuchanka4)), betyder det, at fejlen blev på en asynkron slave og ikke påvirkede funktionaliteten, der var ingen tilstandsskift i klyngen.
- deviation — viser spredningen (præcisionen) af værdien reaction metoden "standardafvigelse".
- count — hvor mange gange denne test er blevet udført.
- En kort log giver mulighed for at vurdere, hvad klyngen laver på nuværende tidspunkt. Der vises iterationsnummeret (testen), tidsstempel og operationens navn. En for lang udførelse (> 5 minutter) indikerer et problem.
- heart (hjerte) — den aktuelle tid. For visuel vurdering af driftssikkerhed mester i hans tabel skrives den aktuelle tid konstant ved anvendelse af mesterens float IP. Ved succes vises resultatet i denne panel.
- slag (puls) — «den aktuelle tid», som tidligere blev optaget af scriptet heart i mester, nu læses fra slave gennem hans float IP. Muliggør visuel vurdering af slaveoperabilitet og replikering. I Tuchanka1 er der ingen slaver med float IP (ingen slaver, der leverer tjenester), men der er to instanser (DB), så der vil blive vist ikke slag, og heart den anden instans.
- Overvågning af klyngens tilstand ved hjælp af værktøjet
pcs mon. Viser strukturen, ressourcefordelingen på noderne og anden nyttig information. - Her vises systemovervågning fra hver virtuel maskine i klyngen. Der kan være flere af disse paneler — svarende til antallet af virtuelle maskiner i klyngen. To grafer CPU Belasting (hver virtuel maskine har to processorer), navnet på den virtuelle maskine, System Belastning (benævnt som Load Average, fordi det er gennemsnittet over 5, 10 og 15 minutter), data om processer og hukommelsesfordeling.
- Sporing af scriptet, der udfører test. I tilfælde af fejl — pludselig afbrydelse af arbejdet eller en uendelig ventecyklus — kan årsagen til sådan adfærd ses her.
Testen udføres i to faser. Først går scriptet gennem alle typer tests, der tilfældigt vælger en virtuel maskine, til hvilken testen anvendes. Derefter udføres en uendelig testcyklus, hvor virtuelle maskiner og fejl hver gang vælges tilfældigt. Pludselig afslutning af testscriptet (den nederste panel) eller en uendelig ventecyklus på noget (> 5 minutters udførelsestid for en operation, dette ses i sporing) indikerer, at en af tests i denne klynge er fejlet.
Hver test består af følgende operationer:
- Udførelse af funktionen, der simulerer en fejl.
- Klar? — ventetid for genopretning af klyngen (når alle tjenester leveres).
- Viser ventetiden for genopretning af klyngen (reaction).
- Fix — klyngen «repareres». Derefter skal den vende tilbage til en fuldt operativ tilstand og være klar til næste fejl.
Her er en liste over tests med beskrivelse af, hvad de gør:
- ForkBomb: skaber "Out of memory" ved hjælp af en fork-bombe.
- OutOfSpace: fylder harddisken. Men testen er snarere symbolsk, da belastningen, der skabes under testningen, er ubetydelig, og ved overflow af harddisken opstår der normalt ikke noget nedbrud i PostgreSQL.
- Postgres-KILL: dræber PostgreSQL med kommandoen
killall -KILL postgres. - Postgres-STOP: hænger PostgreSQL med kommandoen
killall -STOP postgres. - PowerOff: "slukker" virtuelt maskine med kommandoen
VBoxManage controlvm "virtuelt maskine" poweroff. - Reset: genstarter den virtuelle maskine med kommandoen
VBoxManage controlvm "virtuelt maskine" reset. - SBD-STOP: hænger SBD-dæmonen med kommandoen
killall -STOP sbd. - ShutDown: sender kommando til den virtuelle maskine via SSH
systemctl poweroff, systemet afslutter arbejdet korrekt. - UnLink: netværksisolering, kommando
VBoxManage controlvm "virtuelt maskine" setlinkstate1 off.
Afslutning af testningen enten med den standardkommando tmux "kill-window" Ctrl-b &, eller kommandoen "detach-client" Ctrl-b d: her afsluttes testningen, tmux lukker, de virtuelle maskiner slukkes.
Problemer fundet under testningen
I øjeblikket watchdog dæmon sbd håndterer stop af de overvågede dæmoner, men ikke deres hængning. Og som følge heraf håndteres fejl ikke korrekt, hvilket fører til hængning kun Corosync og Pacemaker, men samtidig hænger ikke sbd. For at kontrollere Corosync allerede , accepteret i gren master. De lovede (i PR#83), at der også vil komme noget lignende til Pacemaker, og jeg håber, at det vil være klar til RedHat 8 . Men sådanne "fejl" er teoretiske, let kan simuleres kunstigt ved hjælp af for eksempel
killall -STOP corosync, men forekommer aldrig i virkeligheden.Ved Pacemaker i versionen til CentOS 7 er sync_timeout sat forkert , hvilket resulterer i af quorum deviceat når én node fejler, genstarter den anden node med en vis sandsynlighed under implementeringen (i scriptet , hvilket resulterer i af quorum device setup/setup1
). Denne ændring blev ikke accepteret af udviklerne, i stedet lovede de at genoverveje infrastrukturen på en sådan måde (i en udefineret fremtid), at denne timeout automatisk bliver beregnet. PacemakerHvis der under konfigurationen af databasen angives, atLC_MESSAGES
(tekstbeskeder) kan bruge Unicode, for eksempelru_RU.UTF-8, så ved kørseli et miljø, hvor locale ikke er UTF-8, antageligt i et tomt miljø (her postgres pacemaker pgsqlms+(paf) starteri loggen vil der i stedet for UTF-8-bogstaver være spørgsmålstegn postgres), så LC_MESSAGES=en_US.UTF-8LC_MESSAGES=da_DK.UTF-8ved konfiguration (oprettelse) af en DB-instans.Hvis wal_receiver_timeout er indstillet (standard er 60s), så sker der ingen genopkobling af replikationen til den nye master under testen PostgreSQL-STOP på masteren i klyngerne tuchanka3 og tuchanka4. Jeg har sjældent observeret hængning af replikationen i PostgreSQL under testen ForkBomb (hukommelsesoverbelastning).
Efter ForkBomb kan slaver nogle gange ikke genopkoble til den nye master. Billedet af kroganen er taget fra
Deviant Art Introduktion For nogen tid siden blev jeg bedt om at udvikle en fejltolerant klynge for PostgreSQL.
Kilde: habr.com
