

Jeg vil dele min første succesoplevelse med at genoprette den fulde funktionalitet af Postgres-databasen. Jeg blev bekendt med DBMS Postgres for et halvt år siden, og jeg havde ingen erfaring med databaseadministration før det.
Jeg arbejder som semi-DevOps ingeniør i et stort IT-firma. Vores virksomhed udvikler software til højt belastede tjenester, og jeg er ansvarlig for driften, vedligeholdelse og deployment. Jeg blev givet en standardopgave: at opdatere applikationen på en server. Applikationen er skrevet i Django, og under opdateringen udføres migrationer (ændring af database-strukturen), og inden denne proces tager vi et fuldt dump af databasen via det standardprogram pg_dump, bare for en sikkerheds skyld.
Under dump-processen opstod der en uventet fejl (Postgres-version – 9.5):
pg_dump: Oumping of contents of table "ws_log_smevlog" failed: PQgetResult() failed.
pg_dump: Fejlmeddelelse fra serveren: ERROR: invalid page in block 4123007 of relation base/16490/21396989
pg_dump: Kommandoen var: COPY public.ws_log_smevlog [...]
pg_dump: [parallel archiver] a worker process died unexpectedly
Fejl "invalid page in block" indikerer problemer på filsystemniveau, hvilket er meget alvorligt. Forskellige fora foreslog at gøre FULL VACUUM med indstillingen zero_damaged_pages for at løse dette problem. Nå, lad os prøve…
Forberedelse til genopretning
ADVISORY! Sørg for at lave en sikkerhedskopi af Postgres før enhver forsøg på at genoprette databasen. Hvis du har en virtuel maskine, skal du stoppe databasen og tage et snapshot. Hvis du ikke kan tage et snapshot, skal du stoppe databasen og kopiere indholdet af Postgres-kataloget (inklusive wal-filer) til et sikkert sted. Det vigtigste i vores arbejde er ikke at gøre det værre. Læs .
Da databasen generelt fungerede for mig, begrænsede jeg mig til et almindeligt database-dump, men udelukkede tabellen med beskadigede data (mulighed -T, —exclude-table=TABLE i pg_dump).
Serveren var fysisk, og det var umuligt at tage et snapshot. Backup er taget, lad os komme videre.
Kontrol af filsystemet
Før vi forsøger at genoprette databasen, skal vi sikre os, at vi har styr på filsystemet selv. Og i tilfælde af fejl skal vi rette dem, ellers kan vi kun gøre det værre.
I mit tilfælde var filsystemet med databasen monteret i "/srv" og typen var ext4.
Stop databasen: systemctl stop postgresql@9.5-main.service og vi kontrollerer, at filsystemet ikke er i brug af nogen, og at det kan afmonteres med kommandoen lsof:
lsof +D /srv
Jeg måtte også stoppe redis-databasen, da den også var i brug "/srv". Herefter afmonterede jeg /srv (umount).
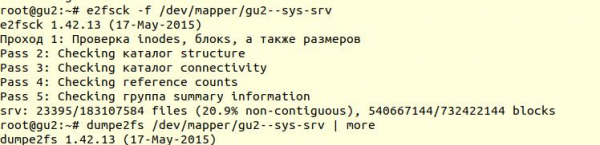
Filsystemkontrollen blev udført med værktøjet e2fsck med flaget -f (Tvinger kontrol selvom filsystemet er markeret som rent):
Herefter brugte jeg værktøjet dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) kan man bekræfte, at kontrollen faktisk er blevet udført:
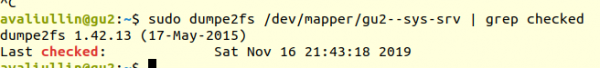
e2fsck den angiver, at der ikke er fundet problemer på ext4-filsystemniveau, hvilket betyder, at vi kan fortsætte med at forsøge at gendanne databasen, eller rettere vende tilbage til vacuum full (selvfølgelig skal filsystemet monteres tilbage, og databasen skal startes op igen).
Hvis din server er fysisk, så tjek venligst diskens tilstand (via smartctl -a /dev/XXX) eller RAID-controlleren for at sikre, at problemet ikke ligger på hardware-niveau. I mit tilfælde viste RAID sig at være "hardware", så jeg bad den lokale administrator om at kontrollere RAID's tilstand (serveren var flere hundrede kilometer væk). Han sagde, at der ikke var fejl, hvilket betyder, at vi helt sikkert kan begynde gendannelsen.
Forsøg 1: zero_damaged_pages
Vi forbinder til databasen via psql med en konto, der har superbrugerrettigheder. Vi har brug for en superbruger, da zero_damaged_pages kun han kan ændre denne indstilling. I mit tilfælde er det postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Mulighed zero_damaged_pages skal bruges for at ignorere læsefejl (fra postgrespro-webstedet):
Når en beskadiget sideoverskrift opdages, rapporterer Postgres Pro normalt en fejl og afbryder den aktuelle transaktion. Hvis parameteren zero_damaged_pages er aktiveret, giver systemet i stedet en advarsel, nulstiller den beskadigede side i hukommelsen og fortsætter behandlingen. Denne adfærd ødelægger data, specifikt alle rækker i den beskadigede side.
Aktiverer indstillingen og prøver at lave full vacuum af tabellen:
VACUUM FULL VERBOSE 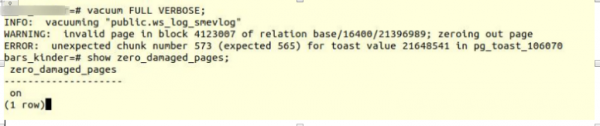
Desværre, fejlet.
Vi stødte på en lignende fejl:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mekanismen til lagring af "lange data" i Postgres, hvis de ikke passer ind i en enkelt side (normalt 8kB).
Forsøg 2: reindex
Den første anbefaling fra Google hjalp ikke. Efter et par minutters søgning fandt jeg den anden anbefaling - at lave reindex den beskadigede tabel. Dette råd har jeg set mange steder, men det har ikke givet mig tillid. Lad os lave en reindex:
reindex table ws_log_smevlog 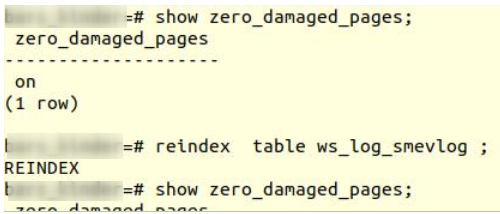
reindex blev afsluttet uden problemer.
Men det hjalp ikke, VACUUM FULL et nødslutning med lignende fejl. Da jeg var vant til fiaskoer, begyndte jeg at lede efter råd online og stødte på en ret interessant .
Forsøg 3: SELECT, LIMIT, OFFSET
I den ovenfor nævnte artikel blev det foreslået at se på tabellen række for række og fjerne problematiske data. Først skulle alle rækker gennemgås:
for ((i=0; i /dev/null || echo $i; doneI mit tilfælde indeholdt tabellen 1 628 991 rækker! Læremæssigt skulle man tage sig af , men det er et emne for en separat diskussion. Det var lørdag, jeg satte denne kommando igang i tmux og gik i seng:
for ((i=0; i /dev/null || echo $i; doneTil morgen besluttede jeg at tjekke, hvordan det stod til. Til min overraskelse opdagede jeg, at der på 20 timer kun var blevet scannet 2% af dataene! Jeg ønskede ikke at vente 50 dage. Endnu et totalt nedbrud.
Men jeg gav ikke op. Jeg blev nysgerrig efter, hvorfor scanningen tog så lang tid. Fra dokumentationen (igen på postgrespro) fandt jeg ud af:
OFFSET angiver, hvor mange rækker der skal springes over, før systemet begynder at returnere rækker.
Hvis både OFFSET og LIMIT er angivet, springer systemet først OFFSET-rækker over og begynder derefter at tælle rækkerne for at begrænse LIMIT.Det er vigtigt at anvende LIMIT sammen med en ORDER BY-klausul, så resultatrækkerne returneres i en bestemt rækkefølge. Ellers vil der blive returneret uforudsigelige delmængder af rækker.
Det er tydeligt, at den ovenstående kommando var fejlagtig: for det første, der var ikke noget order by, resultatet kunne være forkert. For det andet, Postgres skulle først scanne og springe OFFSET-rækkerne over, og med stigningen OFFSET ville ydeevnen falde endnu mere.
Forsøg 4: tage et dump i tekstformat
Dernæst fik jeg en tilsyneladende genial idé: at tage et dump i tekstformat og analysere den seneste indsatte række.
Men først, lad os se på tabellens struktur ws_log_smevlog:
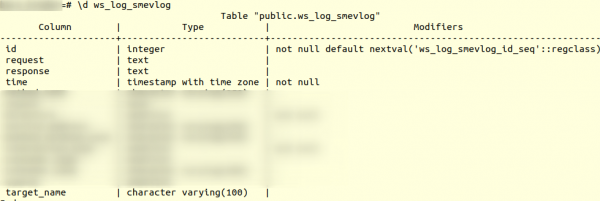
I vores tilfælde har vi en kolonne "id", som indeholdt en unik identifikator (tæller) for rækken. Planen var:
- Vi begynder at tage et dump i tekstformat (som SQL-kommandoer)
- På et givent tidspunkt ville dumpningen være blevet afbrudt på grund af en fejl, men tekstfilen ville stadig blive gemt på disken.
- Vi ser på slutningen af tekstfilen, så vi finder identifikatoren (id) for den sidste række, der blev taget succesfuldt.
Jeg begyndte at tage dumpen i tekstformat:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpDumpningen blev som forventet afbrudt med den samme fejl:
pg_dump: Fejlmeddelelse fra server: ERROR: invalid page in block 4123007 of relation base/16490/21396989 Derefter, efter tail så kiggede jeg på slutningen af dumpen (tail -5 ./my_dump.dump) og opdagede, at dumpningen var blevet afbrudt ved rækken med id 186 525. "Så problemet ligger i rækken med id 186 526, den er beskadiget, og den skal slettes!" tænkte jeg. Men efter at have lavet en forespørgsel i databasen:
«select * from ws_log_smevlog where id=186529» viste det sig, at alt var i orden med denne række… Rækkerne med indeks 186 530 — 186 540 fungerede også uden problemer. Yet en "genial idé" var mislykket. Senere forstod jeg, hvorfor det skete: ved sletning eller ændring af data fra tabellen slettes de ikke fysisk, men markeres som "døde tuples", og derefter kommer autovacuum og markerer disse rækker som slettet og tillader genbrug af disse rækker. For at forstå, hvis dataene i tabellen ændres og autovacuum er aktiveret, så opbevares de ikke sekventielt.
Forsøg 5: SELECT, FROM, WHERE id=
Modgang gør os stærkere. Man skal aldrig give op, man skal gå til ende og tro på sig selv og sine evner. Derfor besluttede jeg at prøve endnu en mulighed: bare at gennemgå alle posterne i databasen én ad gangen. Med kendskab til strukturen af min tabel (se ovenfor), har vi et id-felt, som er unikt (primærnøgle). Der er 1.628.991 rækker i tabellen og id de er i rækkefølge, og det betyder, at vi ganske enkelt kan gennemgå dem én ad gangen:
for ((i=1; i/dev/null || echo $i; doneHvis nogen ikke forstår, fungerer kommandoen som følger: den gennemgår tabellen linje for linje og sender stdout til /dev/null, men hvis SELECT-kommandoen fejler, vises fejlmeddelelsen (stderr sendes til konsollen) og vises linjen, der indeholder fejlen (takket være ||, som betyder, at der var problemer med select (returkoden for kommandoen er ikke 0)).
Jeg havde held, jeg havde oprettet indekser på feltet id:
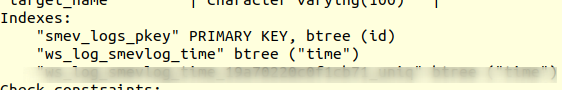
Og det betyder, at finde rækken med det nødvendige id ikke bør tage meget tid. Teoretisk set skulle det virke. Nå, lad os køre kommandoen. tmux og vi går i seng.
Til morgen opdagede jeg, at omkring 90.000 poster var blevet set, hvilket er lidt over 5%. Et fremragende resultat, hvis man sammenligner med den tidligere metode (2%)! Men jeg ville ikke vente 20 dage...
Forsøg 6: SELECT, FROM, WHERE id >= and id <
Kunden havde tildelt en fremragende server til databasen: en dual-processor Intel Xeon E5-2697 v2, og vi havde hele 48 tråde til rådighed! Serverbelastningen var gennemsnitlig, vi kunne uden problemer tage omkring 20 tråde. Der var også rigeligt med RAM: hele 384 gigabyte!
Derfor var det nødvendigt at parallelisere kommandoen:
for ((i=1; i/dev/null || echo $i; doneHer kunne man have skrevet et smukt og elegant script, men jeg valgte den hurtigste metode til parallelisering: at opdele området 0-1628991 manuelt i intervaller af 100.000 poster og køre 16 kommandoer af følgende slags:
for ((i=N; i/dev/null || echo $i; doneMen det er ikke alt. I teorien tager tilslutningen til databasen også noget tid og systemressourcer. At tilslutte 1.628.991 var ikke særlig fornuftigt, enige? Så lad os i stedet udtrække 1.000 rækker ad gangen med én tilslutning. I sidste ende blev kommandoen til dette:
for ((i=N; i=$i and id/dev/null || echo $i; doneVi åbner 16 vinduer i en tmux-session og kører kommandoerne:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Efter en dag fik jeg de første resultater! Det vil sige (værdierne XXX og ZZZ er ikke længere gemt):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
Det betyder, at der er tre rækker, der indeholder en fejl. id for den første og anden problematiske post lå mellem 829.000 og 830.000, id for den tredje - mellem 146.000 og 147.000. Herefter skulle vi blot finde de præcise id-værdier for de problematiske poster. Til dette gennemgår vi vores område med problematiske poster med et skridt på 1 og identificerer id:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Lykkelig slutning
Vi har fundet problematiske rækker. Vi tilgår databasen via psql og forsøger at slette dem:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Til min overraskelse blev posterne slettet uden problemer, selv uden mulighederne zero_damaged_pages.
Derefter tilsluttede jeg mig databasen og lavede VACUUM FULL (jeg tror det var unødvendigt), og til sidst tog jeg med succes et backup ved hjælp af pg_dump. Dumpet blev taget uden fejl! Problemet blev løst på denne ret primitive måde. Der var ingen grænser for glæden, efter så mange mislykkede forsøg lykkedes det endelig at finde en løsning!
Tak og konklusion
Dette blev min første erfaring med at gendanne en virkelig Postgres-database. Denne oplevelse vil jeg huske i lang tid.
Og til sidst vil jeg gerne sige tak til PostgresPro for den oversatte dokumentation til russisk og for , som hjalp mig meget under analysen af problemet.
Kilde: habr.com
