

Vi begyndte at overveje oprettelsen af et overvågningssystem i forbindelse med dannelsen af vores produktteams. Det blev klart, at vores felt — drift — ikke bliver en del af disse teams. Hvorfor er det sådan?
Faktisk er alle vores teams bygget op omkring separate informationssystemer, mikrotjenester og frontend-løsninger, så de ser ikke den overordnede sundhedstilstand af systemet som helhed. For eksempel kan de være uvidende om, hvordan en lille del i den dybe backend påvirker frontend-delen. Deres interesseområde er begrænset til de systemer, som deres system er integreret med. Hvis teamet og deres service A næsten ikke er relateret til service B, så er denne service næsten usynlig for teamet.
Vores team arbejder derimod med systemer, der er meget tæt integrerede med hinanden: der er mange forbindelser mellem dem, og det er en ret stor infrastruktur. Og arbejdet i vores internetbutik afhænger af alle disse systemer (som vi i øvrigt har i stort antal).
Så det ender med, at vores afdeling ikke hører til et bestemt team, men befinder sig lidt på sidelinjen. I hele denne historie er vores opgave at forstå i kompleksitet, hvordan informationssystemerne fungerer, deres funktionalitet, integrationer, software, netværk, hardware, og hvordan alt dette hænger sammen.
Platformen, som vores internetbutikker fungerer på, ser således ud:
- frontend
- middle-office
- back-office
Uanset hvor meget vi ønsker det, findes der ikke noget, der fungerer perfekt, og hvor alle systemer kører glat. Det kommer igen an på antallet af systemer og integrationer — i vores tilfælde er nogle hændelser uundgåelige, uanset kvaliteten af testningen. Dette gælder både internt i et enkelt system samt i relation til deres integration. Derudover skal vi holde øje med hele platformens tilstand som helhed, ikke kun med én separat del af den.
Ideelt set bør overvågningen af hele platformens sundhed automatiseres. Og vi er nået frem til overvågning som en uundgåelig del af denne proces. I starten blev det kun oprettet for frontend-delen, mens der faktisk har været og stadig er egne overvågningssystemer på lagene for netværksfolk, softwareadministratorer og hardware. Alle disse personer holdt øje med overvågningen kun på deres eget niveau, og der var heller ikke nogen samlet forståelse.
For example, if a virtual machine crashes, in most cases only the administrator responsible for the hardware and the virtual machine is aware of this. The front team, in such cases, saw the fact that the application crashed, but they had no data regarding the virtual machine's failure. The administrator might know who the client is and have a rough idea of what is currently running on this virtual machine, provided that it is a large project. For smaller ones, he probably doesn't know. In any case, the administrator needs to go to the owner, ask what was on this machine that needs to be restored and what needs to be changed. If something very serious broke down, there would be a frenzy going in circles—because no one saw the system as a whole.
Ultimately, such fragmented stories affect the entire frontend, the users, and our core business function—online sales. Since we are not part of the teams and deal with the operation of all e-commerce applications within the online store, we took on the task of creating a comprehensive monitoring system for the e-commerce platform.
System Structure and Stack
We started by highlighting several monitoring layers for our systems, within which we need to collect metrics. All of this needed to be unified, which we accomplished in the first phase. Now, for this phase, we are working on the most high-quality collection of metrics across all our layers to establish correlations and understand how systems influence each other.
The absence of comprehensive monitoring during the initial stages of application launch (as we began building it when most systems were already in operation) led to a significant technical debt regarding the configuration of monitoring across the platform. We couldn't afford to focus on setting up monitoring for a single IS and elaborate on it in detail, as the other systems would remain without monitoring for some time. To address this challenge, we identified a list of the most necessary metrics for assessing the state of the information system by layers and began its implementation.
Therefore, we decided to tackle the elephant in parts.
Our system consists of:
- hardware;
- operating system;
- software;
- UI-komponenter i overvågningsapplikationen;
- forretningsmetrik;
- integrationsapplikationer;
- informationssikkerhed;
- netværk;
- lastbalancer.
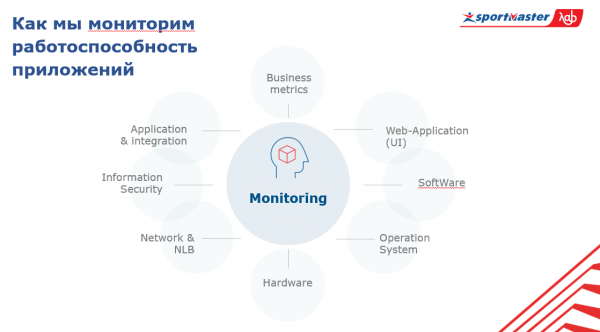
I centrum af dette system er selve overvågningen. For at forstå status for hele systemet, er det nødvendigt at vide, hvad der sker med applikationerne på alle disse niveauer og i forhold til hele mængden af applikationer.
Så lad os tale om stakken.
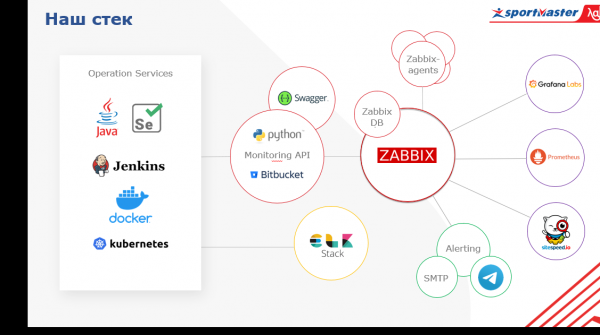
Vi bruger open source-software. I centrum har vi Zabbix, som vi primært bruger som alarmeringssystem. Det er velkendt, at det er ideelt til overvågning af infrastrukturen. Hvad menes der med det? Præcis de lavniveau metrikker, som hver virksomhed har, der har sit eget datacenter (og Sportmaster har sine egne datacentre) — servertemperatur, hukommelsestilstand, RAID-status, metrikker for netværksenheder.
Vi har integreret Zabbix med messengerne Telegram og Microsoft Teams, som aktivt bruges i teams. Zabbix dækker lag af den faktiske netværk, hardware og delvist software, men det er ikke en universalløsning. Vi beriger disse data med nogle andre tjenester. For eksempel, for hardwarens niveau, forbinder vi direkte via API i vores virtualiseringssystem og henter data.
Hvad mere. Udover Zabbix bruger vi Prometheus, som muliggør overvågning af metrikker i applikationer i dynamiske miljøer. Det betyder, at vi kan få applikationsmetrikker via HTTP-endpoint og ikke bekymre os om, hvilke metrikker der skal indlæses, og hvilke ikke. Baseret på disse data kan vi arbejde med analytiske forespørgsler.
Datakilderne for de øvrige lag, f.eks. forretningsmetrikker, er opdelt i tre komponenter.
For det første er det eksterne forretningssystemer, Google Analytics, vi indsamler metrikker fra logfiler. Herfra får vi data om aktive brugere, konverteringer og alt andet relateret til forretningen. For det andet er det UI-overvågningssystemet. Det bør beskrives nærmere.
Engang startede vi med manuel testning, som voksede til automatiserede tests af funktionalitet og integrationer. Herfra udviklede vi overvågningen og beholdt kun den grundlæggende funktionalitet og bundet os til de markører, der er mest stabile og ikke ofte ændrer sig over tid.
Den nye teamstruktur indebærer, at al aktivitet vedrørende applikationer fokuseres omkring produktteams, så vi er stoppet med ren testning. I stedet har vi lavet UI-overvågning skrevet i Java, Selenium og Jenkins (som bruges som styresystem for kørsel og rapportgenerering).
Vi havde mange tests, men i sidste ende besluttede vi at fokusere på hovedvejen, den overordnede metrik. Og hvis vi har mange specifikke tests, vil det være svært at opretholde datavaliditeten. Hver efterfølgende udgivelse vil drastisk ændre hele systemet, og vi vil kun fokusere på at reparere det. Derfor har vi fokuseret på helt grundlæggende ting, som sjældent ændrer sig, og monitorerer kun dem.
Endelig, for det tredje, er datakilden et centralt loggingssystem. Vi bruger Elastic Stack til logs, og derefter kan vi trække disse data ind i vores overvågningssystem for forretningsmetrikker. Derudover fungerer vores egen Monitoring API-service, skrevet i Python, som spørger API'er fra forskellige tjenester og henter data ind i Zabbix.
En anden uundgåelig komponent i overvågning er visualisering. Vores bygger på Grafana. Blandt andre visualiseringssystemer skiller den sig ud ved, at dashboardet kan visualisere metrikker fra forskellige datakilder. Vi kan samle overordnede metrikker fra en online butik, for eksempel antallet af ordreafgivninger i den seneste time fra databasen, OS-ydeevnemetrikker, hvorpå denne online butik kører, fra Zabbix, og metrikker fra instanserne af applikationen fra Prometheus. Alt dette vil være på ét dashboard. Tydeligt og tilgængeligt.
Jeg vil nævne sikkerhed – vi er i gang med at forbedre et system, som vi senere vil integrere med et globalt overvågningssystem. Efter min mening er de største udfordringer, som e-handel står overfor inden for informationssikkerhed, relateret til bots, parserne og brute-force angreb. Det er vigtigt at holde øje med dette, da det kan få kritiske konsekvenser både for vores applikationers drift og for vores omdømme fra et forretningsperspektiv. Og med den valgte techstack dækker vi disse opgaver effektivt.
En vigtig ting er, at applikationsniveauet indsamles af Prometheus. Den er også integreret med Zabbix. Derudover har vi sitespeed, en tjeneste, som gør det muligt for os at monitorere parametre såsom indlæsningstid for vores side, flaskehalse, side-rendering, scriptindlæsning osv., som også er integreret via API. Så vores metrics indsamles i Zabbix, og vi sender også alarmer derfra. Alle alarmer går indtil videre via de primære kommunikationsmetoder (for nu er det e-mail og telegram, vi har for nylig tilføjet MS Teams). Vi planlægger at forbedre alarmerne, så intelligente bots fungerer som en tjeneste og giver information om overvågning til alle de produktteam, der ønsker det.
For os er metrics vigtige ikke kun for individuelle informationssystemer, men også for de samlede metrics for hele den infrastruktur, som applikationerne bruger: klustre fysiske servere, hvor virtuelle maskiner kører, trafikbelastningsaflastere, Network Load Balancere, selve netværket og udnyttelsen af kommunikationskanaler. Plus metrics fra vores egne datacentre (vi har flere, og infrastrukturen er ret betydelig).
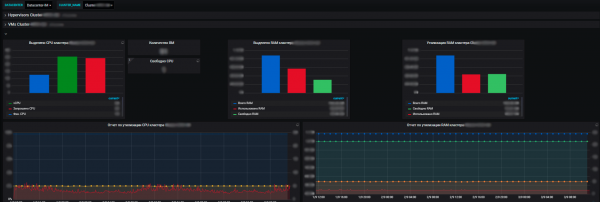
Fordelene ved vores overvågningssystem er, at vi med det kan se tilstanden af alle systemers funktionalitet, vurdere deres indflydelse på hinanden og på de samlede ressourcer. Og i sidste ende giver det os mulighed for at planlægge ressourcer, hvilket også falder inden for vores ansvarsområde. Vi administrerer serverressourcer — en pulje inden for e-commerce, tilføjer og fjerner nyt udstyr, køber nyt, foretager revisions af ressourceudnyttelse osv. Hvert år planlægger teamene nye projekter, udvikler deres systemer, og det er vigtigt for os at sikre, at de har de nødvendige ressourcer.
Og ved hjælp af metrics kan vi se tendenser i ressourceforbruget fra vores informationssystemer. Og baseret på dem kan vi planlægge noget. På virtualiseringsniveauet indsamler vi data og ser information om det tilgængelige antal ressourcer i forhold til datacentrene. Og inden i datacentret kan vi se både udnyttelsen og den faktiske fordeling og forbrug af ressourcer. Både for standalone-servere og virtuelle maskiner samt klustre af fysiske servere, hvor disse virtuelle maskiner kører effektivt.
Udsigter
Vi har nu grundlaget for systemet klar, men der er stadig mange områder, vi skal arbejde på. Mindst én af dem er lag af informationssikkerhed, men det er også vigtigt at få styr på netværket, udvikle alarmering og løse korrelationsspørgsmålet. Vi har mange lag og systemer, og på hvert lag er der en række metrikker. Det bliver en matrjøske på niveau af matrjøske.
Vores opgave er i sidste ende at skabe de rigtige alarmer. For eksempel, hvis der opstår et problem med hardware, igen med den virtuelle maskine, hvor der var en vigtig applikation, og servicen ikke var i nogen form for reserve. Vi opdager, at den virtuelle maskine er død. Derefter vil der blive alarmeret om forretningsmetrikker: brugerne er forsvundet, der er ingen konvertering, UI i grænsefladen er utilgængelig, og software og services er også døde.
I dette scenario vil vi få spam fra alarmerne, og det falder ikke ind under en korrekt overvågningssystem format. Spørgsmålet om correlation opstår. Derfor, i ideelt set, skal vores overvågningssystem sige: "Folkens, I har mistet den fysiske maskine, og samtidig er denne applikation og disse metrikker døde," alt sammen med én alarm i stedet for at bombardere os med hundrede alarmer. Den skal informere om hovedårsagen, da dette fremmer hurtig problemløsning ved at lokalise den.
Vores alarmeringssystem og håndtering af alarmer er bygget op omkring en 24-timers hotline. Alle alarmer, som vi anser for at være must-haves og som indgår i tjeklisten, sendes dertil. Hver alarm skal have en beskrivelse: hvad der skete, hvad det betyder, og hvad det påvirker. Desuden skal der være et link til dashboardet og en instruktion om, hvad man skal gøre i denne situation.
Det er alt, hvad der angår kravene til alarmering. Herefter kan situationen udvikle sig i to retninger - enten er der et problem, og det skal løses, eller der er opstået en fejl i overvågningssystemet. Men i begge tilfælde skal man undersøge sagen.
I gennemsnit får vi omkring hundrede alarmer om dagen, dette er under forudsætning af, at alarmkorrelationen endnu ikke er ordentligt konfigureret. Og hvis der skal udføres tekniske arbejdet, og vi tvangsafbryder noget, stiger antallet mange gange.
Udover overvågning af de systemer, vi driver, og indsamling af metrics, som vi anser for vigtige, giver vores overvågningssystem mulighed for at samle data til produktteams. De kan have indflydelse på de metrics, der overvåges i vores informationssystemer.
Vores kolleger kan komme og anmode om at tilføje en metric, der viser sig at være nyttig for både os og teamet. Eller for eksempel kan teamet finde, at de grundlæggende metrics, vi har, ikke er tilstrækkelige, og de har brug for at overvåge en specifik metric. I Grafana opretter vi et rum for hvert team og giver dem admin-rettigheder. Hvis teamet har brug for dashboards, og de ikke selv kan/ved hvordan man gør det, hjælper vi dem.
Da vi ikke er en del af værdiskabelsesstrømmen for teamet, deres udgivelser og planlægning, når vi gradvist til et punkt, hvor udgivelserne af alle systemer er problemfrie, og de kan rulles ud dagligt uden at koordinere det med os. Det er vigtigt for os at overvåge disse udgivelser, fordi de potentielt kan påvirke applikationens funktionalitet og forårsage fejl, hvilket er kritisk. Til styring af udgivelser bruger vi Bamboo, hvor vi via API får data og kan se, hvilke udgivelser der er blevet foretaget i hvilke informationssystemer, og deres status. Og det vigtigste - på hvilket tidspunkt. Udgivelsesmarkører pålægges de vigtigste kritiske metrics, hvilket visuelt setter fokus på problemer i tilfælde af fejl.
På denne måde kan vi se korrelationen mellem nye udgivelser og opståede problemer. Hovedideen er at forstå, hvordan systemet fungerer på alle lag, hurtigt lokalisere problemet og lige så hurtigt løse det. For ofte tager det mere tid at finde årsagen end at løse problemet.
Og derfor ønsker vi i fremtiden at fokusere på proaktivitet inden for dette område. Ideelt set ville vi gerne vide om en kommende problemstilling på forhånd, i stedet for at handle efter faktum, så vi kan forebygge det i stedet for at skulle løse det. Nogle gange sker der falske alarmer i overvågningssystemet, både på grund af menneskelige fejl og ændringer i applikationen. Og vi arbejder på dette, justerer systemet og forsøger at advare brugerne, der arbejder sammen med os, før vi foretager nogen manipulationer med overvågningssystemet, eller gennemfører disse aktiviteter i tekniske vinduer.
Så systemet er startet op og har fungeret succesfuldt siden begyndelsen af foråret… og viser et ganske reelt overskud. Selvfølgelig er det ikke den endelige version, vi vil implementere mange flere nyttige funktioner. Men lige nu, med så mange integrationer og applikationer, kan man faktisk ikke undvære automatisering af overvågningen.
Hvis du også overvåger store projekter med et betydeligt antal integrationer — så skriv i kommentarerne, hvilken sølvkugle du har fundet til dette.
Kilde: habr.com
