

I dag på vores projekt, bortset fra monolitisk kode, fungerer der dusinvis af mikrotjenester. Hver enkelt kræver overvågning. At gøre dette i så store mængder er problematisk for DevOps-ingeniører. Vi har udviklet et overvågningssystem, der fungerer som en tjeneste for udviklere. De kan selv skrive målinger til overvågningssystemet, bruge dem, bygge dashboards baseret på dem og tilknytte alarmer, der aktiveres ved tærskelværdier. DevOps-ingeniørerne har kun ansvar for infrastrukturen og dokumentationen.
Dette indlæg er en transskription af mit foredrag fra vores på RIT++. Mange har bedt os om at lave tekstversioner af oplæggene derfra. Hvis du var til konferencen eller så videoen, vil du ikke finde noget nyt. Til alle andre - velkommen under kat. Jeg vil fortælle, hvordan vi kom til dette system, hvordan det fungerer, og hvordan vi planlægger at opdatere det.
Fortiden: skemaer og planer
Hvordan kom vi frem til det nuværende overvågningssystem? For at besvare dette spørgsmål skal vi tage tilbage til 2015. Sådan så det ud dengang:
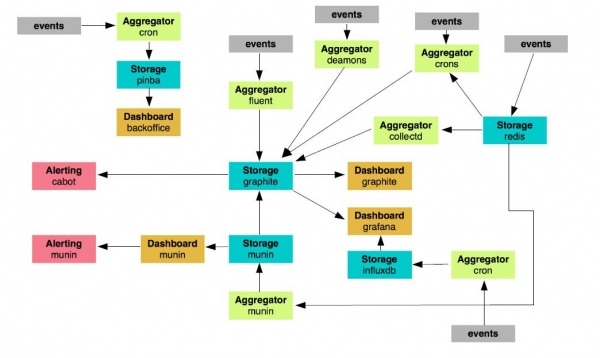
Vi havde omkring 24 noder, der var ansvarlige for overvågningen. Her er der en hel bunke forskellige cron-jobs, scripts og dæmoner, der på en eller anden måde overvåger noget, sender beskeder, udfører funktioner. Vi mente, at jo længere vi kom, desto mindre levedygtig ville et sådan system være. Det gav ikke mening at videreudvikle det: det var for voluminøst.
Vi besluttede at vælge de overvågningselementer, som vi ville beholde og udvikle, og dem vi ville opgive. Det endte med at være 19. Kun grafitter, aggregatorer og Grafana som dashboard blev tilbage. Men hvordan vil det nye system se ud? Sådan her:
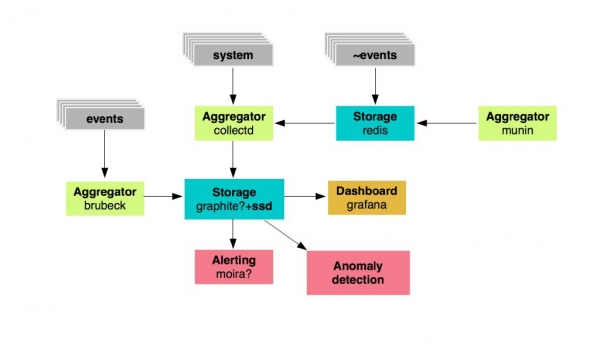
Vi har et lager af målinger: det er grafitter, der vil være baseret på hurtige SSD-diske, og det er bestemte aggregatorer for målinger. Dernæst - Grafana til at vise dashboards og Moira til alarmering. Vi ønskede også at udvikle et system til at finde anomalier.
Standard: Overvågning 2.0
Sådan så planerne ud i 2015. Men vi skulle ikke kun forberede infrastrukturen og selve tjenesten, men også dokumentationen til den. Vi udviklede et internt standard, som vi kaldte overvågning 2.0. Hvilke krav var der til systemet?
- konstant tilgængelighed;
- intervaller for opbevaring af målinger = 10 sekunder;
- struktureret opbevaring af metrics og dashboards;
- SLA > 99,99%
- indsamling af events-metrics via UDP (!).
Vi havde brug for UDP, da vi har et stort flow af trafik og events, der genererer metrics. Hvis vi skulle sende dem alle til Graphite på én gang, ville lageret kollapse. Vi valgte også niveau 1 præfikser for alle metrics.
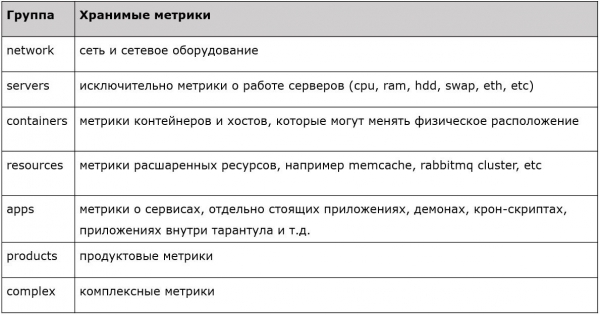
Hver af præfiksene har en særlig egenskab. Der er metrics for servere, netværk, containere, ressourcer, applikationer og så videre. Vi har implementeret en klar, striks, typet filtrering, hvor vi accepterer niveau 1 metrics, mens de andre blot droppes. Sådan planlagde vi dette system i 2015. Hvordan ser det ud nu?
Nutiden: interaktionsskema for monitoreringskomponenter
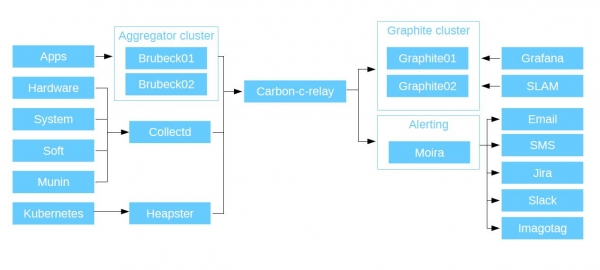
Først og fremmest overvåger vi applikationer: vores PHP-kode, applikationer og mikrotjenester — med andre ord alt, hvad vores udviklere skriver. Alle applikationer sender metrics til aggregatoren Brubeck via UDP (statsd, omskrevet i C). Det viste sig at være den hurtigste i de syntetiske tests. Og den sender allerede aggregerede metrics til Graphite via TCP.
Den har en type metrics kaldet timere. Det er en meget praktisk ting. For eksempel, når en bruger forbinder sig til tjenesten, sender du en metric med response time til Brubeck. En million svar er kommet ind, men aggregatoren har kun givet 10 metrics. Du har antallet af ankomne brugere, maksimal, minimal og gennemsnitlig svartid, median og 4 percentiler. Dataene sendes derefter til Graphite, og vi ser dem alle live.
Vi har også aggregation for metrics relateret til hardware, software, system metrics og vores gamle monitoreringssystem Munin (som fungerede for os indtil 2015). Alt dette indsamler vi via C daemon CollectD (som har en hel bunke forskellige plugins indbygget, den kan forespørge alle ressourcer på host-systemet, hvor den er installeret, blot angiv i konfigurationen, hvor dataene skal skrives) og skriver dataene til Graphite via den. Den understøtter også python- og shell-script plugins, så du kan skrive dine egne brugerdefinerede løsninger: CollectD vil indsamle disse data fra lokale eller fjerntliggende værter (lad os sige, at der er Curl) og sende dem til Graphite.
Derefter sender vi alle de metrics, vi har indsamlet, til Carbon-c-relay. Dette er Carbon Relay-løsningen fra Graphite, forbedret med C. Det er en router, der samler alle de metrics, vi sender fra vores aggregater og omdirigerer dem til noderne. I fasen for omdirigering kontrollerer den også validiteten af metrics. For det første skal de overholde det schema med præfikser, som jeg viste tidligere, og for det andet være valide for Graphite. Ellers bliver de droppet.
Derefter sender Carbon-c-relay metrics til Graphite-klyngen. Vi bruger Carbon-cache som vores primære metrics-lager, omskrevet i Go. Go-carbon overgår Carbon-cache i ydeevne på grund af dets multithreading. Det modtager data og skriver dem til diske ved hjælp af whisper-pakken (den standard, der er skrevet i Python). For at læse data fra vores lagre bruger vi Graphite API. Det fungerer hurtigere end den standard Graphite WEB. Hvad sker der med dataene bagefter?
De går til Grafana. Som vores primære datakilde bruger vi vores Graphite-klynger, plus vi har Grafana som webgrænseflade til visning af metrics og opbygning af dashboards. For hver af deres tjenester opretter udviklerne deres egne dashboards. Derefter opbygger de grafer, der viser de metrics, de skriver fra deres applikationer. Udover Grafana har vi også SLAM. Dette er en Python-dæmon, der beregner SLA baseret på data fra Graphite. Som jeg allerede har nævnt, har vi flere dusin mikrotjenester, hver med deres egne krav. Med SLAM går vi ind i dokumentationen og sammenligner den med det, der er i Graphite, og vurderer, hvor godt kravene stemmer overens med tilgængeligheden af vores tjenester.
Lad os gå videre: alerting. Dette er organiseret ved hjælp af et stærkt system — Moira. Den er uafhængig, fordi den har sin egen Graphite under motorhjelmen. Den er udviklet af folkene fra SKB "Kontur", skrevet i Python og Go, og er helt open source. Moira modtager hele det samme flow, der går til Graphite. Hvis dit lager af en eller anden grund skulle stoppe med at fungere, så vil din alerting stadig fungere.
Vi har implementeret Moira i Kubernetes, hvor den bruger et Redis-serverkluster som sin primære database. Resultatet er et fejltolerant system. Det sammenligner metrics strømmen med en liste over triggere: hvis der ikke er nogen omtaler i den, droppes metric. På den måde kan den håndtere gigabytes af metrics pr. minut.
Derudover har vi tilknyttet et corporate LDAP, som gør det muligt for hver bruger af det corporate system at oprette notifikationer baseret på eksisterende (eller nyoprettede) triggere. Da Moira indeholder Graphite, understøtter den alle dens funktioner. Derfor kopierer du først en linje ind i Grafana. Du ser, hvordan dataene vises på graferne. Derefter kopierer du den samme linje ind i Moira, sætter den op med grænser, og modtager alerts som output. Du har ikke brug for nogen specielle færdigheder for at gøre alt dette. Moira kan sende alerts via SMS, e-mail, Jira, Slack... Den understøtter også udførelse af brugerdefinerede scripts. Når den udløser en trigger og er tilmeldt et brugerdefineret script eller binær, kører den det og sender JSON til stdin til denne binær. Din program skal derfor kunne parse den. Hvad du vil gøre med denne JSON, er op til dig. Vil du sende den til Telegram, eller åbne opgaver i Jira, gør hvad du vil.
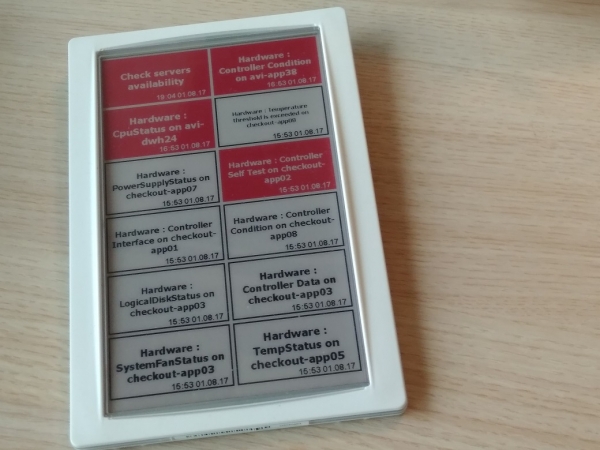
Vi bruger også vores egen udvikling til alerts — Imagotag. Vi har tilpasset et panel, der normalt bruges til elektroniske prisskilt i butikker, til vores behov. Vi har trukket triggere fra Moira op på det. Her fremgår, hvilken tilstand de er i, og hvornår de fandt sted. Nogle af udviklerne har fravalgt notifikationer i Slack og e-mail til fordel for dette panel.
Og da vi er et progressivt firma, har vi også overvåget Kubernetes i dette system. Vi har inkluderet det i systemet via Heapster, som vi installerede i klyngen, som indsamler data og sender dem til Graphite. Resultatet ser således ud:
Overvågningskomponenter
Her er en liste over links til de komponenter, vi har brugt til denne opgave. Alle er open-source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistik
Og her er nogle tal om, hvordan systemet fungerer hos os.
Aggregator (brubeck)
Antal metrikker: ~ 300 000 / sek
Frekvens for sending af metrikker til Graphite: 30 sek
Serverressourceforbrug: ~ 6% CPU (dette gælder for fuldgyldige servere); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Antal metrikker: ~ 1 600 000 / min
Opdateringsfrekvens for metrikker: 30 sek
Opbevaringsskema for metrikker: 30sek 35d, 5min 90d, 10min 365d (giver indblik i, hvad der sker med tjenesten over lang tid)
Serverressourceforbrug: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Fleksibilitet
Vi værdsætter fleksibiliteten i vores overvågningstjeneste hos Avito. Hvorfor er det blevet sådan? For det første er dets bestanddele udskiftelige: både selve komponenterne samt deres versioner. For det andet — vedligeholdeligheden. Da hele projektet er bygget på open source, kan du selv redigere koden, lave ændringer og implementere funktioner, der ikke er tilgængelige ud af boksen. Der anvendes ret almindelige stakke, hovedsageligt Go og Python, så det er relativt nemt at gøre.
Her er et eksempel på et reelt problem, der opstod. En metrik i Graphite er en fil. Den har et navn. Filnavnet = metrikens navn. Og der er en sti til det. Filnavne i Linux er begrænset til 255 tegn. Og vi har (som "interne kunder") folk fra databasedepartementet. De siger til os: "Vi vil overvåge vores SQL-forespørgsler. Og de er ikke 255 tegn, men 8 MB hver. Vi vil have dem vist i Grafana, se parametrene for denne forespørgsel, og endnu bedre, vi vil se toppen af sådanne forespørgsler. Det ville være fantastisk, hvis det kunne vises i realtid. Og det ville være helt fantastisk at få dem med i alerting."
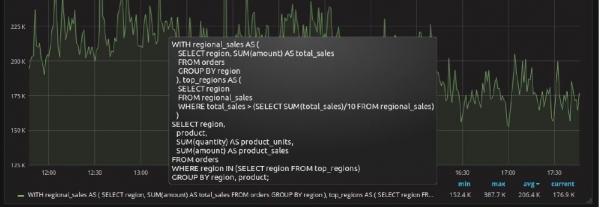
Eksemplet på SQL-forespørgslen er taget som eksempel fra
Vi opsætter Redis-serveren og vores Collectd-plugins, der henter data fra Postgres og sender målinger til Graphite. Men vi ændrer navnet på målingen til hasher. Denne hash sender vi samtidig til Redis som nøgle, og hele SQL-forespørgslen som værdi. Vi skal have Grafana til at kunne hente information fra Redis. Vi åbner Graphite API, da det er det primære grænseflade til interaktion mellem alle overvågningskomponenter og Graphite, og vi indfører en ny funktion, der hedder aliasByHash() - fra Grafana får vi målingens navn og bruger det i forespørgslen til Redis som nøgle, hvorved vi får værdien af nøglen, som er vores “SQL-forespørgsel”. Således har vi fået SQL-forespørgslen vist i Grafana, hvilket principielt ikke kunne gøres deri, sammen med statistikker om den (calls, rows, total_time, …).
Resumé
Tilgængelighed. Vores overvågningstjeneste er tilgængelig 24/7 fra enhver applikation og enhver kode. Hvis du har adgang til lagerpladserne, kan du skrive data til tjenesten. Sproget er ligegyldigt, løsningerne er ligegyldige. Du skal blot vide, hvordan man åbner en socket, sender målingen og lukker socketen.
Pålidelighed. Alle komponenter er fejlstore og håndterer vores belastninger godt.
Lav adgangsbarriere. For at bruge dette system skal du ikke lære programmeringssprog eller forespørgsler i Grafana. Bare åbn din applikation, indtast socketen, der sender målinger til Graphite, lukker den, åbner Grafana, opretter dashboards der og overvåger adfærden af dine målinger, mens du modtager meddelelser gennem Moira.
Selvstændighed. Alt dette kan gøres selvstændigt, uden hjælp fra DevOps-ingeniører. Og det er overkill, fordi du kan overvåge dit projekt lige nu, uden at skulle spørge nogen - hverken for at starte arbejdet eller for ændringer.
Hvad stræber vi efter?
Alt det nedenfor er ikke blot abstrakte tanker, men det, vi allerede har taget de første skridt hen imod.
- Anomalidetektor. Vi ønsker at udvikle en tjeneste, der vil gå ind i vores Graphite-lagre og kontrollere hver måling efter forskellige algoritmer. Der er allerede algoritmer, vi ønsker at overvåge, vi har data, og vi ved, hvordan vi skal arbejde med dem.
- Metadata. Vi har mange tjenester, som ændrer sig over tid, ligesom de mennesker, der arbejder med dem. At holde dokumentationen manuel er ikke en mulighed. Derfor integreres metadata nu i vores mikrotjenester. Her står der, hvem der har udviklet den, hvilke sprog den interagerer med, SLA-krav, og hvor og til hvem notifikationer skal sendes. Ved deployment af tjenesten oprettes alle data entiteter selvstændigt. Resultatet er, at du får to links – et til triggers og et andet til dashboards i Grafana.
- Overvågning i hvert hjem. Vi mener, at alle udviklere bør bruge et sådant system. På den måde ved du altid, hvor din trafik er, hvad der sker med den, hvor den falder, og hvor dens svage punkter er. Hvis der for eksempel sker noget, der overbelaster din tjeneste, vil du ikke finde ud af det under et opkald fra en manager, men fra et alert, og med det samme kan du åbne de friske logs og se, hvad der er sket.
- Høj ydeevne. Vores projekt vokser konstant, og i dag behandles der cirka 2.000.000 metrics værdier per minut. For et år siden var dette tal 500.000. Og væksten fortsætter, hvilket betyder, at Graphite (whisper) snart vil begynde at belaste disk subsystemet meget. Som jeg allerede har nævnt, er dette overvågningssystem ret universelt på grund af udskifteligheden af komponenterne. Nogen vedligeholder specifikt Graphite og udvider konstant deres infrastruktur, men vi har besluttet at gå en anden vej: at bruge som lager for vores metrics. Denne overgang er næsten afsluttet, og snart vil jeg fortælle mere om, hvordan det blev gjort: hvilke udfordringer der var, og hvordan de blev overvundet, hvordan migreringsprocessen forløb, samt beskrive de valgte omsluttende komponenter og deres konfigurationer.
Tak for opmærksomheden! Stil dine spørgsmål om emnet, jeg vil forsøge at svare her eller i de næste indlæg. Måske har nogen erfaring med at opbygge et lignende overvågningssystem eller overgangen til Clickhouse i en tilsvarende situation – del venligst det i kommentarerne.
Kilde: habr.com
