

Vores virksomhed har siden 2008 arbejdet primært med at administrere infrastrukturer og døgnet rundt teknisk support til webprojekter: vi har over 400 kunder, hvilket udgør cirka 15% af e-handel i Rusland. Derfor er der meget forskelligartet arkitektur i vores support. Hvis noget falder ned, er vi forpligtet til at ordne det inden for 15 minutter. Men for at forstå, at en nødsituation er opstået, er det nødvendigt at overvåge projektet og reagere på hændelser. Men hvordan gør man det?
Jeg mener, at i organisationen af det rette overvågningssystem opstår der problemer. Hvis der ikke var problemer, ville mit oplæg bestå af ét punkt: «Installer venligst Prometheus + Grafana og plugins 1, 2, 3». Desværre fungerer det ikke længere sådan. Og det primære problem er, at alle fortsætter med at tro på noget, der eksisterede i 2008, hvad angår softwarekomponenter.
Når det kommer til organisering af overvågningssystemet, tør jeg sige, at... der ikke findes projekter med ordentlig overvågning. Og situationen er så dårlig, at hvis noget falder ned, er der en risiko for, at det forbliver uset — alle er jo overbeviste om, at «alt overvåges».
Måske overvåges alt. Men hvordan?
Vi har alle været i en lignende situation: en devops, en admin, og så kommer et udviklerteam og siger - «vi har release, nu skal du overvåge». Hvad skal overvåges? Hvordan fungerer det?
Okay. Vi overvåger på gammeldags måde. Men det ændrer sig allerede, og det viser sig, at du har overvåget service A, som er blevet service B, som interagerer med service C. Men udviklerteamet siger til dig: «Sæt softwaren op, den skal overvåge alt!»
Hvad er ændret? - Alt er ændret!
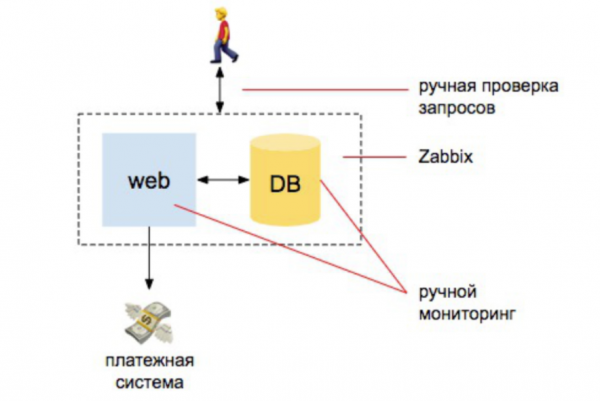
2008. Alt er fantastisk.
Der er et par udviklere, én server, én database server. Herfra starter det hele. Vi har nogle oplysninger, vi installerer Zabbix, Nagios, Cacti. Og derefter opretter vi forståelige alarmer for CPU, for diskens arbejde, for plads på diskene. Vi laver også et par manuelle tjek for at sikre, at hjemmesiden svarer, og at ordrer kommer ind i databasen. Og det er det - vi er mere eller mindre beskyttede.
Sammenlignet med den arbejdsbyrde, som systemadministratoren tidligere udførte for at sikre overvågning, var 98% af det automatiseret: en person, der beskæftiger sig med overvågning, skal forstå, hvordan man installerer Zabbix, hvordan man konfigurerer det og indstiller alarmer. De resterende 2% handler om eksterne kontroller: om siden svarer og foretager forespørgsler til databasen, og om nye bestillinger er kommet.
2010. Belastningen stiger.
Vi begynder at skalere websiderne, tilføjer en søgemaskine. Vi vil være sikre på, at produktkataloget indeholder alle varer. Og at produkt søgningen fungerer. At databasen fungerer, at ordrer bliver oprettet, at siden svarer eksternt og svarer korrekt. servere Og brugeren ikke bliver smidt af siden, mens den genbalanceres til en anden server, osv. Antallet af enheder vokser.
Derudover forbliver enheden, der relaterer til infrastrukturen, stadig den største i administratorens hoved. Ideen om, at personen der gør overvågning, er den, der installerer Zabbix og kan konfigurere det, sidder stadig fast.
Men der opstår også opgaver i forbindelse med udførelse af eksterne kontroller, oprettelse af et sæt scripts til forespørgsler for søgeindeksering, et sæt scripts til at kontrollere, at søgningen ændrer sig under indeksering, et sæt scripts, som kontrollerer, at varer bliver sendt til leveringsservice osv.
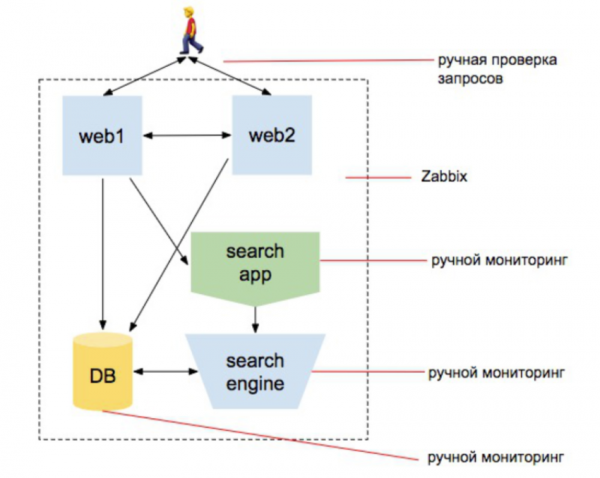
Bemærk: Jeg har skrevet "sæt scripts" tre gange. Det vil sige, at den ansvarlige for overvågning ikke længere bare er den, der installerede Zabbix. Det er en person, der begynder at kode. Men i teamet ændrer man stadig ikke tankegang.
Til gengæld ændrer verden sig og bliver mere kompleks. Lag af virtualisering tilføjes, flere nye systemer. De begynder at interagere med hinanden. Hvem sagde "det lugter af mikroservices?" Men hver service ser stadig ud som en separat hjemmeside. Vi kan kontakte den og forstå, at den leverer de nødvendige oplysninger og fungerer af sig selv. Og hvis du er administrator og konstant arbejder med et projekt, der udvikler sig i 5-7-10 år, akkumuleres disse viden: et nyt niveau - du forstår det, et andet niveau - du forstår det...
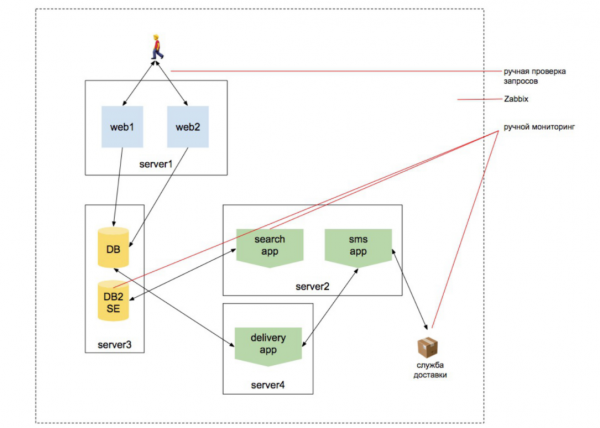
Men sjældent er der nogen, der følger et projekt i 10 år.
Resume for overvågningsmanden.
Forestil dig, at du er kommet ind i en ny startup, der straks har samlet 20 udviklere, skrevet 15 mikrotjenester, og du er administratoren, der får at vide: "Byg CI/CD. Vær så venlig." Du har bygget CI/CD og pludselig hører du: "Det er svært for os at arbejde med produktionen i 'kuben', uden at forstå, hvordan applikationen vil fungere der. Lav en sandkasse i denne samme 'kube'.
Du laver en sandkasse i denne kube. De siger straks: "Vi vil have en stage-database, der opdateres hver dag fra produktionen, så vi kan forstå, at det fungerer på databasen, men ikke ødelægger produktionsdatabasen."
Du lever i alt dette. Der er 2 uger tilbage til udgivelsen, og de siger: "Nu skal alt dette overvåges..." Det vil sige, overvåge den klustrede infrastruktur, overvåge mikrotjenestearkitekturen, overvåge arbejdet med eksterne tjenester...
Kollegerne trækker en velkendt skema op af hatten og siger: "Så her er alt klart! Sæt et program op, der kan overvåge det hele." Ja, ja: Prometheus + Grafana + plugins.
Og de tilføjer samtidig: "Du har to uger, sørg for, at alt er pålideligt."
I en hel række projekter, som vi ser, tildeles én person overvågning. Forestil dig, at vi ønsker at ansætte en person i 2 uger, der skal fokusere på overvågning, og vi laver et CV til ham. Hvilke færdigheder skal denne person have, hvis man tager alt det, vi tidligere har sagt, i betragtning?
- Han skal forstå overvågning og specifikationen for den fysiske infrastruktur.
- Han skal forstå overvågningens specifikationer for Kubernetes (og alle vil have det i 'kuben', fordi man kan abstrahere fra alting, gemme sig, for resten klarer administratoren) - selve Kubernetes, dets infrastruktur, og forstå, hvordan man overvåger applikationer indeni.
- Han skal forstå, at tjenester kommunikerer på særlige måder, og vide om de specifikke interaktioner mellem tjenesterne. Det er fuldt ud muligt at se et projekt, hvor nogle tjenester kommunikerer synkront, fordi det ikke kan gøres på andre måder. For eksempel, backend går via REST, via gRPC til katalogtjenesten, henter en liste over varer og returnerer det. Her kan man ikke vente. Men med andre tjenester arbejder han asynkront. Overføre en bestilling til leveringstjenesten, sende en e-mail osv.
Du er måske allerede faldet af hele dette? Og administratoren, der skal overvåge det, er endnu mere forvirret. - Han skal kunne planlægge og planlægge korrekt — da arbejdet bliver mere og mere.
- Han skal derfor skabe en strategi for den oprettede service for at forstå, hvordan man konkret overvåger den. Han har brug for en forståelse af projektets arkitektur og dets udvikling + forståelse for de teknologier, der bruges i udviklingen.
Lad os huske et absolut normalt tilfælde: en del services på php, en del services på Go, en del services på JS. De arbejder på en eller anden måde sammen. Heraf kommer termen «mikroservice»: antallet af separate systemer er blevet så stort, at udviklerne ikke kan forstå projektet som helhed. En del af teamet skriver services på JS, som fungerer uafhængigt og ikke ved, hvordan resten af systemet fungerer. En anden del skriver services på Python og involverer sig ikke i, hvordan de andre services fungerer, de er isolerede inden for deres område. Den tredje del skriver services på php eller noget andet.
Alle disse 20 personer er delt op i 15 services, og der er kun én admin, der skal forstå alt dette. Stop! Vi har lige opdelt systemet i 15 mikroservices, fordi 20 personer ikke kan forstå hele systemet.
Men det skal overvåges på en eller anden måde...
Hvad er resultatet? Resultatet er, at der er én person, der forstår alt, hvad et helt team af udviklere ikke kan forstå, og samtidig skal han også vide og kunne det, vi har angivet ovenfor — den fysiske infrastruktur, Kubernetes-infrastrukturen osv.
Hvad kan man sige... Houston, vi har et problem.
Overvågning af et moderne softwareprojekt er et softwareprojekt i sig selv.
Fra en falsk sikkerhed om, at overvågning er software, opstår der en tro på mirakler. Og sådanne mirakler er desværre ikke til. Man kan ikke bare installere Zabbix og forvente, at alt fungerer. Der er ikke nogen mening i at installere Grafana og håbe, at alt bliver fint. Størstedelen af tiden vil blive brugt på at organisere tjek af, hvordan services fungerer, og deres interaktion med hinanden, samt tjek af, hvordan eksterne systemer fungerer. Faktisk vil 90% af tiden gå ikke på at skrive scripts, men på udviklingen af software. Og det skal udføres af et team, der forstår projektets arbejde.
Hvis man i denne situation kaster én person over overvågningen, vil der ske en katastrofe. Og det sker overalt.
For eksempel er der flere tjenester, der kommunikerer med hinanden gennem Kafka. En bestilling kommer ind, vi sender besked om bestillingen til Kafka. Der er en tjeneste, der lytter til informationen om bestillingen og håndterer forsendelsen af varerne. Der er en tjeneste, der lytter til informationen om bestillingen og sender en e-mail til brugeren. Og så dukker der flere tjenester op, og vi begynder at forvirre os.
Og hvis du også overdrager dette til administratoren og udviklerne i en fase, hvor der kun er kort tid tilbage til udgivelsen, skal personen forstå hele dette protokol. Det vil sige, et projekt af denne skala tager betydelig tid, og det skal tages i betragtning i systemets udvikling.
Men meget ofte, især i starten af opstartsfirmaer, ser vi, hvordan overvågningen bliver udskudt. "Lad os først lave et Proof of Concept, lade os lancere det, så lad det falde – vi er villige til at ofre det. Og så vil vi overvåge det hele." Når (eller hvis) projektet begynder at generere indtægter, ønsker virksomheden at udvikle endnu flere funktioner — fordi det allerede fungerer, så der skal tjenes mere! Og du befinder dig på et punkt, hvor du først skal overvåge alt det tidligere, hvilket tager mere end 1% af tiden, men betydeligt mere. Og for resten kræver overvågningen udviklere, og det er nemmere at lade dem fokusere på nye funktioner. I sidste ende skrives nye funktioner, alt kompliceres, og du er i en uendelig deadlock.
Hvordan kan man overvåge et projekt fra starten, og hvad skal man gøre, hvis du har fået et projekt, der skal overvåges, men du ikke ved, hvor du skal begynde?
For det første skal man planlægge.
En lyrisk afvigelse: man begynder ofte med at overvåge infrastrukturen. For eksempel har vi Kubernetes. Lad os starte med at installere Prometheus med Grafana, installere plugins til overvågning af 'kuben'. Ikke kun udviklerne, men også administratorerne har en beklagelig praksis: "Vi installerer denne plugin, og den ved sikkert, hvordan man gør det." Folk elsker at starte med enkle og forståelige ting, snarere end med vigtige handlinger. Og overvågning af infrastrukturen er bare det.
For starters, decide what and how you want to monitor, and then choose a tool, because other people can't think for you. And should they? Others have thought about themselves, about a universal system — or didn't think at all when they wrote this plugin. Just because this plugin has 5,000 users does not mean it provides any value. You might become the 5001st simply because there were already 5000 people before you.
If you have started monitoring the infrastructure and the backend of your application stops responding, all users will lose connection to the mobile app. An error will pop up. People will come to you and say, "The app isn't working, what are you doing here?" — "We are monitoring." — "How are you monitoring if you don't see that the app isn't working?!"
- I believe that monitoring should start right from the user's entry point. If the user doesn't see that the app is working — that's a failure. And the monitoring system should warn about this first and foremost.
- Only after that can we monitor the infrastructure. Or do it in parallel. Monitoring infrastructure is easier — here we can finally just set up Zabbix.
- And now we need to dig into the application's roots to understand where things are not working.
My main point is that monitoring should run parallel to the development process. If you pull the monitoring team onto other tasks (like creating CI/CD, sandboxes, reorganizing infrastructure), monitoring will start to lag behind and you may never catch up with development (or sooner or later, you'll have to stop it).
Everything in levels
Here's how I see the organization of the monitoring system.
1) Application level:
- monitoring business logic of the application;
- monitoring health metrics of services;
- integration monitoring.
2) Infrastructure level:
- monitoring the orchestration level;
- monitoring system software;
- monitoring hardware level.
3) Again, the application level — but now as an engineering product:
- collecting and observing application logs;
- APM;
- tracing.
4) Alerting:
- organization of the notification system;
- organization of the duty system;
- organization of the knowledge base and incident handling workflow.
Det er vigtigt: Vi går ikke til alerting efterfølgende, men straks! Det er ikke nødvendigt at starte overvågningen og tænke på, hvem der skal modtage alerterne senere. For hvad er formålet med overvågning: at forstå, hvor i systemet noget ikke fungerer som det skal, og informere de relevante personer. Hvis det overlades til sidst, vil de relevante personer kun høre om, at noget er galt, når de får et opkald med beskeden: 'vores system fungerer ikke'.
Applikationsniveau — overvågning af forretningslogik
Her taler vi om at kontrollere, om applikationen fungerer for brugeren.
Dette niveau skal etableres i udviklingsfasen. For eksempel har vi en hypotetisk Prometheus: den henter data fra serveren, som udfører kontroller, kalder endpointet, og endpointet går videre med at kontrollere API'en.
Når man ofte beder om at overvåge forsiden for at sikre, at hjemmesiden fungerer, tilbyder programmører et endpoint, som kan kaldes hver gang man skal bekræfte, at API'en fungerer. Samtidig begynder programmører også at skrive /api/test/helloworld.
Den eneste måde at sikre, at alt fungerer? — Nej!
- At oprette sådanne kontroller er i det væsentlige udviklernes opgave. Unit-tests skal skrives af programmører, der skriver koden. For hvis du overlader det til en administrator med besked om: 'Hey, her er en liste over API-protokoller for alle 25 funktioner, venligst overvåg alt!' — vil det ikke fungere.
- Hvis du skriver print 'hello world', vil ingen nogensinde vide, at API'en skal og faktisk fungerer. Hver ændring af API'en skal medføre en tilsvarende ændring i kontrollerne.
- Hvis du allerede står i denne situation - stop funktionerne og tildel udviklere til at skrive disse kontroller, eller resignér med tabene, acceptere at intet bliver kontrolleret, og at der vil ske nedbrud.
Tekniske råd:
- Sørg for at organisere en ekstern server til kontrollerne - du skal være sikker på, at dit projekt er tilgængeligt for omverdenen.
- Organiser kontrol på hele API-protokollen, ikke kun på enkelte endpoints.
- Opret et prometheus-endpoint med resultaterne af kontrollerne.
Applikationsniveau — overvågning af sundhedsmetrikker
Nu handler det om eksterne sundhedsmetrikker for tjenester.
Vi har besluttet, at vi overvåger alle "endpoints" i applikationen ved hjælp af eksterne kontroller, som vi kalder fra et eksternt overvågningssystem. Men det er netop de "endpoints", som brugeren "ser". Vi vil gerne være sikre på, at vores tjenester fungerer. Her ser det bedre ud: i K8s er der health checks, så i det mindste kan "boksen" bekræfte, at tjenesten fungerer. Men halvdelen af de checks, jeg har set, er det samme print "hello world". Det vil sige, den hiver én gang efter deployment, og hvis den får et svar om, at alt er godt – så er det det. Men for en service, der udleverer sit API via REST, er der et stort antal indgange til det samme API, som også skal overvåges, fordi vi vil vide, at det fungerer. Og vi overvåger det allerede indefra.
Hvordan implementeres dette teknisk korrekt: hver service tilvejebringer en endpoint om sin nuværende funktionalitet, og i graferne i Grafana (eller en hvilken som helst anden applikation) ser vi status for alle tjenester.
- Hver ændring af API'et skal føre til en ændring af kontrollerne.
- Opret nye tjenester straks med health-metrics.
- En administrator kan henvende sig til udviklerne og bede om "tilføj et par funktioner, så jeg kan forstå det hele og tilføje information til mit overvågningssystem". Men udviklerne svarer normalt: "Vi vil ikke tilføje noget to uger før udgivelsen."
Lad udviklingslederne vide, at der vil være sådanne tab, og lad også udviklingsledernes ledelse vide besked. Fordi når alt går ned, vil der altid være nogen, der ringer og kræver overvågning af den "stadig-nedlagte service". - For resten, sørg for at afsætte udviklere til at skrive plugins til Grafana – det vil være en stor hjælp til administratorerne.
Applikationsniveau – Integrationsovervågning
Integrationsovervågning fokuserer på overvågning af kommunikationen mellem kritiske forretningssystemer.
For eksempel er der 15 tjenester, der kommunikerer med hinanden. Det er ikke længere separate sites. Det vil sige, vi kan ikke bare kalde en service, få /helloworld og bekræfte, at tjenesten fungerer. Fordi webtjenesten til ordreplacering skal sende oplysninger om ordren til bus-systemet – fra bus-systemet skal lagertjenesten modtage denne besked og arbejde videre med den. E-mail-service skal behandle dette på en eller anden måde og så videre.
Derfor kan vi ikke forstå, når vi trykker på hver enkelt tjeneste, hvordan det hele fungerer. Fordi vi har en slags bus, som alt kommunikerer og interagerer gennem.
Så dette trin skal markere testen af tjenester i forhold til deres interaktion med andre tjenester. Man kan ikke, kun ved at overvåge meddelelsesbroker, organisere overvågning af kommunikationen. Hvis der er en tjeneste, der udsender data, og en anden, der modtager dem, vil vi i overvågningen af broker kun se de data, der flyver frem og tilbage. Selvom vi er lykkedes med at overvåge interaktionen af disse data — at en eller anden producerer data, og nogen læser dem, mens strømmen fortsætter i Kafka — vil det stadig ikke give os information, hvis den ene tjeneste sendte meddelelsen i en version, og den anden tjeneste ikke forventede denne version og derfor gik glip af den. Det vil vi ikke finde ud af, da vores tjenester siger, at alt fungerer.
Sådan anbefaler jeg at gøre:
- For synkron kommunikation: endpointet udfører anmodninger til relaterede tjenester. Det vil sige, at vi tager dette endpoint, kører et lille script inden i tjenesten, som går gennem alle punkterne og siger: «jeg kan tage fat der, og der, jeg kan tage fat…»
- For asynkron kommunikation: indgående meddelelser — endpointet tjekker busserne for testmeddelelser og giver en status for behandlingen.
- For asynkron kommunikation: udgående meddelelser — endpointet sender testmeddelelser til busserne.
Som det sædvanligvis sker: vi har en tjeneste, der skyder data til bussen. Vi kommer ind i denne tjeneste og beder om at få at vide om dens integrationsstatus. Og hvis tjenesten skal producere en meddelelse et eller andet sted (WebApp), så producerer den denne testmeddelelse. Og hvis vi trækker tjenesten fra siden af OrderProcessing, så poster den først det, som den kan poste uafhængigt, og hvis der er nogle afhængige ting — så læser den fra bussen en række testmeddelelser, forstår hvad den kan håndtere, meddeler det, og om nødvendigt poster dem videre, og så siger den — alt er fint, jeg er i live.
Vi hører ofte spørgsmålet: "hvordan kan vi teste dette på produktionsdata?" For eksempel handler det om den samme bestillingstjeneste. Ordren sender meddelelser til lageret, hvor varer bliver afskrevet: vi kan ikke teste dette på produktionsdata, fordi "jeg får varerne afskrevet!" Løsningen: planlæg hele denne test i de tidlige faser. Du har enhedstest, der laver mocks. Så det skal gøres på et dybere niveau, hvor du har en kommunikationskanal, der ikke skader forretningen.
Infrastruktur niveau
Overvågning af infrastruktur er noget, der længe har været anset som selve overvågningen.
- Overvågning af infrastruktur kan og bør starte som en separat proces.
- Det er ikke en god idé at starte overvågningen af infrastrukturen på et aktivt projekt, selvom man har lyst. Dette er et problem for alle DevOps. "Først overvåger jeg klyngen, derefter overvåger jeg infrastrukturen" – det vil sige, man overvåger først det, der ligger nederst, men går ikke ind i applikationen. For applikationen er en uklar ting for DevOps. Det blev givet til ham, og han forstår ikke, hvordan det fungerer. Men han forstår infrastrukturen og starter der. Men nej – man skal altid overvåge applikationen først.
- Overdriv ikke med antallet af advarsler. Givet kompleksiteten i moderne systemer, kommer advarslerne konstant, og man skal finde en måde at leve med denne bunke af advarsler på. Og en on-call person, der ser på hundrede nye advarsler, vil tænke "jeg vil ikke tænke på det." Advarsler bør kun informere om kritiske ting.
Applikationsniveau som forretningsenhed
Nøglepunkter:
- ELK. Dette er industristandard. Hvis du ikke aggregerer logs af en eller anden grund, så begynd med det straks.
- APM. Eksterne APM som en hurtig måde at lukke overvågningen af applikationen (NewRelic, BlackFire, Datadog). Du kan midlertidigt installere dette for at få en forståelse af, hvad der sker.
- Tracing. I dusinvis af mikrotjenester skal du trace alt, fordi forespørgslen ikke lever alene. At tilføje det senere er meget svært, så det er bedre at planlægge tracing tidligt i udviklingen – det er et arbejde og et værktøj for udviklerne. Hvis det ikke er implementeret endnu – så implementer det! Se Jaeger/Zipkin.
Advarsel
- Organisering af varslingssystemet: under monitoreringen af mange ting skal der være et samlet system til udsendelse af varsler. Det kan gøres i Grafana. I Vesten bruger alle PagerDuty. Varslerne skal være klare (for eksempel, hvor de kommer fra…). Og det er ønskeligt at kontrollere, at varslerne virkelig når frem.
- Organisering af vagtordninger: alerter må ikke sendes til alle (ellers vil alle reagere i flok, eller ingen vil reagere). Oncall skal være for udviklerne: definer tydeligt ansvarsområder, lav klare instruktioner, og skriv i dem, hvem der konkret skal kontaktes om mandagen og om onsdagen, og hvem om tirsdagen og om fredagen (ellers vil ingen kontakte dem, selv i tilfælde af en stor nødsituation — de vil være bange for at forstyrre: folk elsker generelt ikke at ringe og vække andre, især om natten). Og forklar, at det at bede om hjælp ikke er et tegn på inkompetence ("jeg beder om hjælp — så er jeg en dårlig medarbejder"); opmuntrer til anmodninger om hjælp.
- Organisering af "vidensbasen" og arbejdsgangen ved håndtering af hændelser: for hver alvorlig hændelse skal der planlægges en postmortem, som en midlertidig foranstaltning skal de handlinger, der løser hændelsen, dokumenteres. Indfør en praksis, hvor gentagne alerter er en synd; de skal rettes i koden eller infrastrukturarbejdet.
Teknologisk stack
Lad os forestille os, at vores stack er følgende:
- dataindsamling — Prometheus + Grafana;
- loganalyse — ELK;
- til APM eller Tracing — Jaeger (Zipkin).

Valgmulighederne er ikke kritiske. Fordi, hvis du i starten forstod, hvordan du skulle overvåge systemet og lagde en plan, så begynder du derefter at vælge værktøjer efter dine behov. Spørgsmålet er, hvad du valgte at overvåge i begyndelsen. Fordi det kan være, at det værktøj, du valgte i starten, slet ikke opfylder dine krav.
Nogle tekniske punkter, som jeg ser overalt for tiden:
Prometheus presses ind i Kubernetes — hvem fandt på det?! Hvis din klynge falder, hvad vil du så gøre? Hvis du har en kompleks klynge indeni, så skal der være et eller andet overvågningssystem indeni klyngen, og et andet — udenfor, som samler data fra indersiden af klyngen.
Inden i klyngen samler vi logs og alt andet. Men systemet til overvågning skal være udenfor. Meget ofte i et cluster, hvor der er Promtheus installeret indeni, står der også systemer, der udfører eksterne checks af webstedets drift. Og hvis dine forbindelser til omverdenen falder, og applikationen ikke fungerer? Så er alt godt indeni, men det hjælper ikke brugerne.
Konklusioner
- Udviklingen af overvågning er ikke installation af værktøjer, men udvikling af et softwareprodukt. 98% af den nuværende overvågning er kodning. Kodning i tjenester, kodning af eksterne kontroller, kontrol af eksterne tjenester, og alt muligt andet.
- Spar ikke tid for udviklerne på overvågning: det kan tage op til 30% af deres arbejde, men det er det værd.
- DevOps, vær ikke bekymret over, at du ikke kan overvåge noget, for nogle ting er en helt anden tankegang. Du har ikke været programmør, og overvågningsarbejdet er netop deres arbejde.
- Hvis projektet allerede kører og ikke er overvåget (og du er leder) — afsæt ressourcer til overvågning.
- Hvis produktet allerede er i produktion, og du er DevOps, der har fået besked om "at opsætte overvågning" — prøv at forklare ledelsen det, jeg har skrevet om.
Dette er en udvidet version af præsentationen på konferencen Saint Highload++.
Hvis du er interesseret i mine idéer og tanker om it og relaterede emner, så kan du 🙂
Kilde: habr.com
