

Ingeniør - oversat fra latin - inspireret.
Ingeniøren kan alt. (c) R. Diesel.
Epigrafen.
Eller historien om, hvorfor databaseadministratoren skal huske sin programmørfortid.
Forord
Alle navne er ændret. Sammenfald er tilfældige. Materialet præsenterer udelukkende forfatterens personlige mening.
Fraskrivelse af garantier: i den planlagte artikelcyklus vil der ikke være detaljerede og nøjagtige beskrivelser af de anvendte tabeller og scripts. Materialerne kan ikke umiddelbart bruges "AS IS".
For det første på grund af det store materialeomfang,
for det andet på grund af tilpasningen til den virkelige kundes produktionsdatabase.
Derfor vil artiklerne kun indeholde ideer og beskrivelser i meget generelle termer.
Det kan være, at systemet i fremtiden vokser til niveauet for at blive lagt op på GitHub, eller måske ikke. Tiden vil vise.
Begyndelsen på historien - "».
Hvad der kom ud af det, i meget generelle træk - "»
Hvorfor skal jeg alt dette?
For det første for at huske det selv, mens jeg holder op med at arbejde og mindes de gode gamle dage.
For det andet for at systematisere det skrevne. For jeg begynder selv nogle gange at blive forvirret og glemme enkelte dele.
Og vigtigst af alt - måske kan det være til hjælp for nogen og forhindre dem i at opfinde hjulet forfra og samle skrald. Med andre ord, forbedre sin karma (ikke den, der findes på Habr). For det mest værdifulde i denne verden er idéer. Det vigtigste er at finde idéen. At realisere idéen i virkeligheden er allerede et rent teknisk spørgsmål.
Så lad os begynde, stille og roligt...
Problemstilling.
Der er:
PostgreSQL database (10.5), hybrid belastningstype (OLTP + DSS), median-lav belastning, placeret i AWS cloud.
Databaseovervågning mangler, infrastruktur overvågning er repræsenteret i form af standard AWS-værktøjer i minimal konfiguration.
Påkrævet:
At overvåge ydeevnen og tilstanden af databasen, finde og have grundlæggende oplysninger til optimering af tunge forespørgsler til databasen.
Kort forord eller analyse af løsningsmuligheder
Lad os først forsøge at analysere løsningsmulighederne ud fra et komparativt synspunkt af fordele og ulemper for ingeniøren, mens fordelene og tabene for ledelsen må håndteres af dem, der er ansvarlige ifølge organisationens skema.
Mulighed 1 - "Working on demand"
Vi lader alt være som det er. Hvis kunden er utilfreds med noget i funktionaliteten eller ydeevnen af databasen eller applikationen, informerer han DBAs ingeniører via e-mail eller opretter en hændelse i ticket-systemet.
Ingeniøren, der modtager notifikationen, undersøger problemet, foreslår en løsning eller lægger problemet på hylden, i håbet om at det løser sig selv, og om lidt bliver alt glemt.
Småkager og donuts, blå mærker og bulerSmåkager og donuts:
1. Man skal ikke gøre noget overflødigt.
2. Der er altid mulighed for at slippe af sted med det.
3. En masse tid, som man kan bruge, som man vil.
Blå mærker og buler:
1. Før eller siden vil kunden tænke over livets essens og universets retfærdighed i denne verden og igen stille sig selv spørgsmålet - hvorfor betaler jeg dem mine penge? Konsekvenserne er altid de samme - spørgsmålet er kun, hvornår kunden bliver træt og vinker farvel. Og foderbrønden vil være tom. Det er trist.
2. Ingeniørens udvikling - nul.
3. Problemer med planlægning af arbejde og belastning
Variant 2 - 'Danser med trommerne, sælger og skuffer.'
Punkt 1-Hvorfor har vi et overvågningssystem, vi vil modtage alting via forespørgsler. Vi starter en masse forskellige forespørgsler til datakataloget og dynamiske visninger, tænder for forskellige tællere, samler alt i tabeller, analyserer periodisk lister og tabeller. Resultatet er smukke eller mindre smukke grafer, tabeller, rapporter. Det vigtigste er, at der er så meget som muligt.
Punkt 2-Vi genererer aktivitet - starter analysen af det hele.
Punkt 3-Vi forbereder et eller andet dokument, kalder dette dokument blot - 'hvordan vi organiserer databasen.'
Punkt 4-Kunden, som ser dette pragt af grafer og tal, er i en barnlig naiv tro - nu vil alt fungerer, snart. Og han skiller sig let og smertefrit af med sine penge. Ledelsen er også overbevist - ingeniørerne arbejder fantastisk. Belastningen er på maksimum.
Punkt 5-Gentag regelmæssigt Punkt 1.
Småkager og donuts, blå mærker og bulerSmåkager og donuts:
1. Livet for ledere og ingeniører er enkelt, forudsigeligt og fyldt med aktivitet. Alt suser, alle er optaget.
2. Livet for kunden er også rimeligt - han er altid sikker på, at han bare skal have lidt tålmodighed, så løser alt sig. Det løser sig ikke, nå, hvad skal man gøre - det er en uretfærdig verden, næste liv - mon ikke han er heldigere.
Blå mærker og buler:
1. Før eller siden vil der blive fundet en mere effektiv leverandør af tilsvarende tjenester, som tilbyder det samme, men til en lavere pris. Og hvis resultatet er det samme, hvorfor betale mere? Dette vil igen føre til, at fødekilden forsvinder.
2. Det er kedeligt. Ligesom enhver meningsløs aktivitet.
3. Som i den tidligere mulighed — der er ingen udvikling. Men for ingeniøren er ulempe, at man i modsætning til den første mulighed konstant skal generere dokumentation. Og det tager tid. Tid, der kunne bruges til noget nyttigt for en selv. For hvis man ikke tager sig af sig selv, er alle ligeglade.
Mulighed 3 - Man skal ikke opfinde cyklen på ny, man skal købe den og køre på den.
Ingeniører fra andre selskaber spiser ikke for ingenting pizza med øl (ah, de gode tider i Sankt Petersborg i 90'erne). Lad os bruge overvågningssystemer, der er lavet, testet og fungerer, og som faktisk bringer brugbarhed (i det mindste for dem, der har lavet dem).
Småkager og donuts, blå mærker og bulerSmåkager og donuts:
1. Man skal ikke spilde tid på at finde på det, der allerede er opfundet. Tag det og brug det.
2. Overvågningssystemer skrives ikke af idioter, og de er selvfølgelig nyttige.
3. Funktionelle overvågningssystemer giver som regel brugbar filtreret information.
Blå mærker og buler:
1. Ingeniøren er i dette tilfælde ikke en ingeniør, men blot en bruger af et andres produkt. Eller en bruger.
2. Kunden skal overtales til at købe noget, som han i grunden ikke ønsker at forstå, og som han heller ikke burde og overhovedet er budgettet godkendt for året, og det vil ikke ændre sig. Så skal man afsætte separate ressourcer og konfigurere til et specifikt system. Dvs. først skal man betale, betale og betale igen. Men kunden er nærig. Det er normen i dette liv.
Hvad skal man så gøre - Tjernysjov? Dit spørgsmål er yderst relevant. (c)
I dette konkrete tilfælde og i den aktuelle situation kan man gøre det lidt anderledes — lad os lave vores eget overvågningssystem.
Nå, ikke et system i ordets fulde forstand, det ville være for dramatisk og selvbevidst, men vi kan i det mindste lette opgaven og indsamle flere oplysninger til at løse problemer med ydeevnen. Så man ikke havner i situationen - "gå derhen, jeg ved ikke hvor, find det, jeg ved ikke hvad".
Hvad er fordele og ulemper ved denne mulighed:
Fordele:
1. Det er interessant. I det mindste mere interessant end konstant at "shrink datafile, alter tablespace, etc."
2. Dette er nye færdigheder og ny udvikling. Hvad der på sigt, før eller senere, vil give fortjente belønninger og muligheder.
Ulemper:
1. Du må arbejde. Arbejde meget.
2. Du skal regelmæssigt forklare meningen og perspektiverne for hele aktiviteten.
3. Du må give afkald på noget, da den eneste ressource, som ingeniøren har adgang til - tid - er begrænset af universet.
4. Det mest skræmmende og ubehagelige — kan i sidste ende resultere i noget som "Ikke en mus, ikke en frø, men et ukendt væsen."
Den, der ikke risikerer, får ikke champagne.
Så — det mest interessante begynder.
Den overordnede idé — skematisk
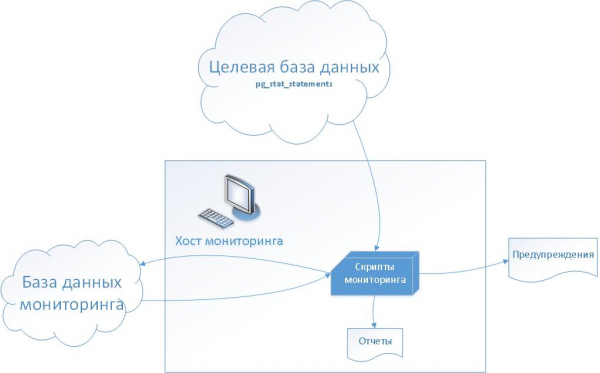
(Illustrationen er taget fra artiklen «»)
Forklaring:
- I den målrettede database installeres standardudvidelsen PostgreSQL — “pg_stat_statements”.
- I overvågningsdatabasen opretter vi et sæt service tabeller til at gemme historikken for pg_stat_statements i starten og til indstilling af metrikker og overvågning senere.
- På overvågningsværten opretter vi et sæt bash-scripts, også til at generere hændelser i ticketsystemet.
Servicetabeller
For at starte med en skematisk og forenklet ERD, hvad kom der ud af det:
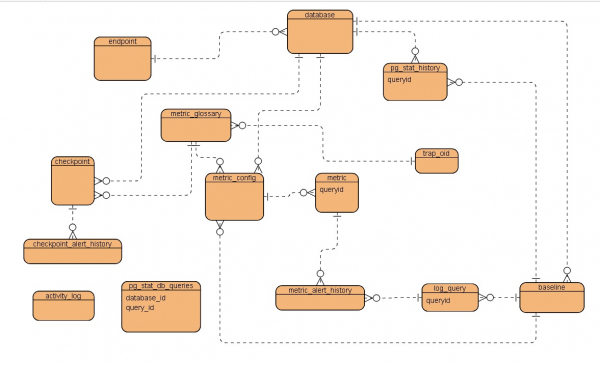
Kort beskrivelse af tabellerneendpoint — værten, forbindingspunktet til instansen
database — parametre for databasen
pg_stat_history — historisk tabel til opbevaring af tidsbilleder af visningen pg_stat_statements i den målrettede database
metric_glossary — ordbog over ydeevnemetrikker
metric_config — konfiguration af enkelte metrikker
metric — en specifik metrisk for den overvågede anmodning
metric_alert_history — historik over ydeevneadvarsler
log_query — systemtabel til opbevaring af analyserede poster fra logfilen PostgreSQL, der uploades fra AWS
baseline — parametre for den tidsperiode, der anvendes som baseline
checkpoint — konfiguration af metrikker for database-tilstandskontrol
checkpoint_alert_history — historik over advarsler for metrikker for database-tilstandskontrol
pg_stat_db_queries — systemtabel for aktive forespørgsler
activity_log — systemtabel for aktivitetslog
trap_oid — systemtabel for trap-konfiguration
Trin 1 — indsamle statistisk information om ydeevne og få rapporter
Til opbevaring af statistisk information anvendes tabellen pg_stat_history
Strukturen af tabellen pg_stat_history
                                          Tabel "public.pg_stat_history"
       Kolonne        |            Type             |                          Modifikatorer
---------------------+-----------------------------+-------------------------------------------
 id                  | integer                     | not null default nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | timestamp uden tidszone |
 database_id         | integer                     |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | bigint                      |
 query               | text                        |
 calls               | bigint                      |
 total_time          | double precision            |
 min_time            | double precision            |
 max_time            | double precision            |
 mean_time           | double precision            |
 stddev_time         | double precision            |
 rows                | bigint                      |
 shared_blks_hit     | bigint                      |
 shared_blks_read    | bigint                      |
 shared_blks_dirtied | bigint                      |
 shared_blks_written | bigint                      |
 local_blks_hit      | bigint                      |
 local_blks_read     | bigint                      |
 local_blks_dirtied  | bigint                      |
 local_blks_written  | bigint                      |
 temp_blks_read      | bigint                      |
 temp_blks_written   | bigint                      |
 blk_read_time       | double precision            |
 blk_write_time      | double precision            |
 baseline_id         | integer                     |
Indekser:
    "pg_stat_history_pkey" PRIMARY KEY, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Udenlandske nøglebegrænsninger:
    "database_id_fk" FOREIGN KEY (database_id) REFERENCES database(id) ON DELETE CASCADE
Som det fremgår, repræsenterer tabellen blot kumulative data for visningen pg_stat_statements i den målrettede database.
Brugen af denne tabel er meget enkel
pg_stat_history vil repræsentere den samlede statistik for udførelsen af forespørgsler hver time. I starten af hver time, efter at tabellen er udfyldt, nulstilles statistikken pg_stat_statements ved hjælp af pg_stat_statements_reset().
Bemærk: statistikken indsamles for forespørgsler, der har en udførelsestid på mere end 1 sekund.
Udfyldningen af tabellen pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'NY SHAPSHOT SKABES';

		--Forbind til måldatabasen
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % and dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Oprettelse af snapshot af pg_stat_statements for database %',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Oprettelse af snapshot af pg_stat_statements for forespørgsler med min_tid større end 1000ms';

        FOR pg_stat_snapshot IN
          --Alle forespørgsler med max_tid større end 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
Som følge af en periode vil vi i tabellen pg_stat_history have et sæt snapshots af tabelindholdet pg_stat_statements i den målrettede database.
Egentlig rapportering
Ved at bruge enkle forespørgsler kan der opnås nyttige og interessante rapporter.
Aggerede data for den angivne periode
Forespørgsel
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) AS temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
DB Tid
to_char(interval '1 millisecond' * pg_total_stat_history_rec.total_time, 'HH24:MI:SS.MS')
I/O Tid
to_char(interval '1 millisecond' * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), 'HH24:MI:SS.MS')
TOP10 SQL efter total_tid
Forespørgsel
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL EFTER TOTAL UDFØRELSESTID | #| queryid| calls| calls %| total_time (ms) | dbtime % +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL efter total I/O tid
Forespørgsel
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL EFTER TOTAL I/O TID | #| forespørgsels-id| opkald| opkald %| I/O tid (ms)|db I/O tid % +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL efter maksimal udførelsestid
Forespørgsel
SELECT
  id AS snapshotid ,
  forespørgsels-id ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  forespørgsels-id IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL EFTER MAKSIMAL UDFØRELSISTID | #| snapshot| snapshotID| forespørgsels-id| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL efter DELT buffer læsning/skrivning
Forespørgsel
SELECT
  id AS snapshotid ,
  forespørgsels-id ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  forespørgsels-id IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( shared_blks_read > 0 OR shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL EFTER DELT BUFFER LÆSNING/SKRIVNING | #| snapshot| snapshotID| queryid| delte blokke læst| delte blokke skrevet +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histogram over forespørgsler efter maksimal udførelsestid
Anmodninger
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id =DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| MAX_TIME HISTOGRAM
| TOTAL CALLS : 33851920
| MIN TIME  : 00:00:01.063
| MAX TIME  : 00:02:01.869
---------------------------------------------------------------------------------
|                      min varighed|                      max varighed|     opkald
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Snapshots efter forespørgsler pr. sekund
Anmodninger
--pg_qps.sql
--Beregn Spørgsmål Pr. Sekund
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'ERROR - Ikke fundet pg_stat_history for id = %',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Snapshots sorteret efter QueryPerSeconds-nummer
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          snapshot| snapshotID|      opkald|                      samlet dbtid|        QPS|                          I/O tid| I/O tid %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Time-for-time udførelseshistorik med QueryPerSeconds og I/O tid
Forespørgsel
SELECT
  id ,
  snapshot_timestamp ,
  opkald ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| TIMERETNING HISTORIK MED QueryPerSeconds og I/O Tid
-----------------------------------------------------------------------------------------------------------------------------------------------
| SPØRGSMÅL PER SEKUND HISTORIK
|    #|          snapshot| snapshotID|      opkald|                      total dbtime|        QPS|                          I/O tid| I/O tid %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Tekst af alle SQL-selects
Forespørgsel
VÆLG
  queryid ,
  forespørgsel
FRA
  pg_stat_history
HVOR
  queryid IKKE ER NULL OG
  database_id = DATABASE_ID  OG
  snapshot_timestamp MELLEM BEGIN_TIMEPOINT OG END_TIMEPOINT
GROUP BY queryid , forespørgsel
Resultat
Som det fremgår, kan man med ganske enkle midler få en betydelig mængde nyttig information om belastningen og tilstanden på databasen.
Bemærkning:Hvis vi registrerer queryid i forespørgslerne, får vi historik for den enkelte forespørgsel (for at spare plads er rapporter for den enkelte forespørgsel udeladt).
Således findes der statistiske data om forespørgselsydelse — de indsamles.
Første trin "indsamling af statistiske data" — afsluttet.
Vi kan gå videre til anden fase - "opsætning af ydelsesmål".
Men det er en helt anden historie.
Fortsætter…
Kilde: habr.com
