

Det er kendt, at en CTO's kompetence kun vurderes ved anden udførelse af denne rolle. For det er én ting at arbejde i en virksomhed i flere år, at udvikle sig sammen med den og gradvist få mere ansvar i samme kulturelle kontekst. Og noget helt andet er at komme direkte ind i stillingen som teknisk direktør i en virksomhed med et stort legacy-bagland og mange problemer, der pænt er fejet ind under tæppet.
I den forbindelse er erfaringen fra Leon Feier, som han delte ved , ikke ligefrem unik, men givet hans erfaring og mængden af forskellige roller, han har haft i 20 år, er den meget nyttig. Under er en tidslinje for begivenhederne de første 90 dage og mange anekdoter, som det er sjovt at grine af, når de sker for andre, men som ikke er så sjove at opleve personligt.
Leon fortæller meget farverigt på russisk, så hvis du har 35-40 minutter, anbefaler jeg at se videoen. Den tekstuelle version er lavet for at spare tid nedenfor.
Den første version af præsentationen var en velstruktureret beskrivelse af arbejdet med mennesker og processer, indeholdende nyttige anbefalinger. Men den formidlede ikke alle overraskelserne, der opstod på vejen. Derfor ændrede jeg formatet og præsenterede de problemer, der pludselig opstod i den nye virksomhed, som en djævel fra en tobaksæske, og metoderne til at løse dem i kronologisk rækkefølge.
En måned før
Som mange gode historier, begyndte denne med alkohol. Vi sad med bekendte på en bar, og som det er sædvanligt blandt it-folk, klagede alle over deres problemer. En af dem havde lige skiftet job og fortalte om sine udfordringer med både teknologi, mennesker og teamet. Jo længere jeg lyttede, jo mere indså jeg, at han bare skulle ansætte mig, fordi netop de problemer har jeg løst de sidste 15 år. Sådan sagde jeg det til ham, og næste dag mødtes vi allerede i en arbejdssituation. Virksomheden hed Teaching Strategies.
Teaching Strategies er førende på markedet for uddannelsesprogrammer til meget små børn - fra fødsel til tre år. Den traditionelle "papir" virksomhed har eksisteret i næsten 40 år, mens den digitale SaaS-version af platformen har eksisteret i 10 år. For nylig begyndte processen med at tilpasse digital teknologi til virksomhedens standarder. Den "nye" version blev lanceret i 2017 og var næsten som den gamle, men fungerede dårligere.
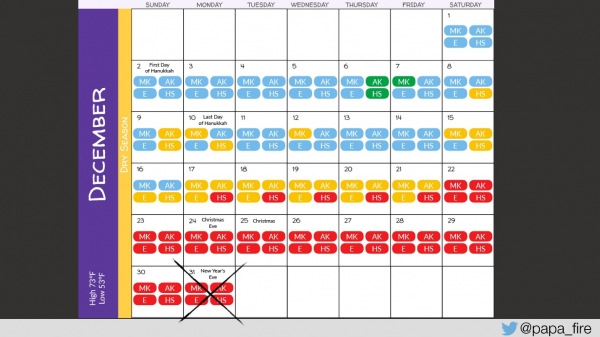
Det mest interessante er, at trafikken for denne virksomhed er meget forudsigelig - dag for dag, år for år kan man klart forudsige, hvor mange mennesker der kommer, og hvornår. For eksempel mellem kl. 13 og 15 går alle børnene i børnehaverne til at sove, mens lærerne begynder at indtaste oplysninger. Og sådan er det hver dag, undtagen i weekenden, fordi næsten ingen arbejder i weekenden.
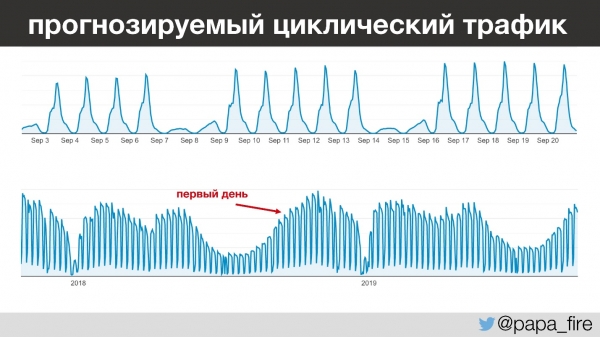
For at springe lidt frem bemærker jeg, at jeg begyndte mit arbejde i den periode med det største årlige trafik, hvilket er interessant af forskellige grunde.
Platformen, som tilsyneladende kun havde eksisteret i to år, havde en usædvanlig teknologistak: ColdFusion & SQL Server fra 2008. ColdFusion, hvis du ikke ved det, og det gør du nok ikke, er et enterprise PHP, der blev introduceret i midten af 90'erne, og siden da har jeg ikke hørt om det. Der var også: Ruby, MySQL, PostgreSQL, Java, Go, Python. Men den primære monolit kørte på ColdFusion og SQL Server.
Problemer
Jo mere jeg talte med virksomhedens medarbejdere om arbejdet og de problemer, der opstod, jo mere indså jeg, at problemerne ikke kun var tekniske. Okay, teknologien er gammel - og vi har arbejdet med endnu ældre, men der var problemer med teamet og processerne, og virksomheden begyndte at forstå det.
Traditionelt sad deres teknikere i hjørnet og lavede deres eget arbejde. Men mere og mere af forretningen begyndte at finde sted gennem den digitale version. Derfor kom der nye: en bestyrelse, CTO, CPO og QA-direktør i virksomheden det sidste år før jeg begyndte at arbejde. Det vil sige, virksomheden begyndte at investere i den teknologiske sfære.
Spor af tungt arv var ikke kun i systemerne. Virksomheden havde legacy-processer, legacy-mennesker, legacy-kultur. Alt dette skulle ændres. Jeg tænkte, at jeg bestemt ikke ville kede mig, og besluttede at prøve.
To dage før
To get ready for the start of my new job, I arrived at the office two days early, completed the final paperwork, met the team, and discovered that they were currently struggling with a problem. The issue was that the average page loading time had jumped to 4 seconds, which is twice as long.
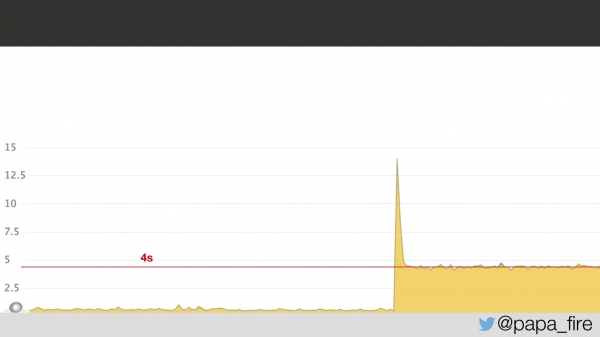
Judging by the chart, something clearly happened, though it was unclear what. It turned out the problem was network latency in the data center: 5 ms latency in the data center turned into 2 seconds for users. I didn’t know why this happened, but it became clear that the issue was in the data center.
Day One
Two days passed, and on my first working day, I found that the problem was still there.
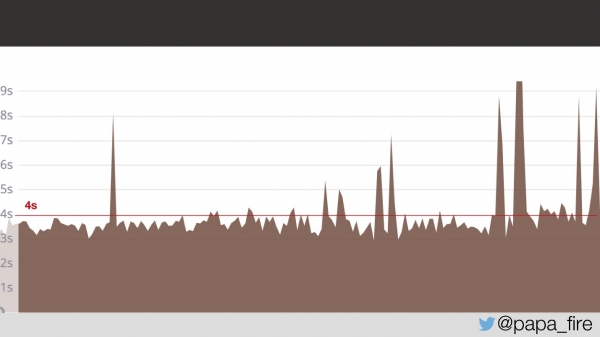
For two days, users experienced an average page load time of 4 seconds. I asked if they had found out what the problem was.
— Yes, we opened a ticket.
— And?
— Well, they haven’t replied yet.
At this point, I understood that everything I had been told before was just the tip of the iceberg that needed to be addressed.
There is a good quote that fits this situation well:
“Sometimes to change technology, you need to change the organization.”
But since I started working at the busiest time of the year, I had to look at both short-term and long-term solutions to the problem, starting with what was critical right now.
Day Three
So, the load time is 4 seconds, and from 1 PM to 3 PM, the spikes are the highest.
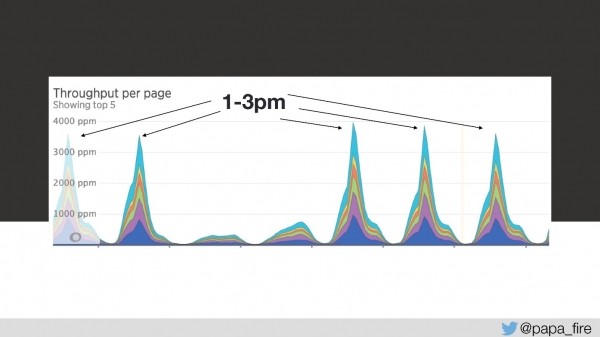
On the third day, during this period, the loading speed looked like this:
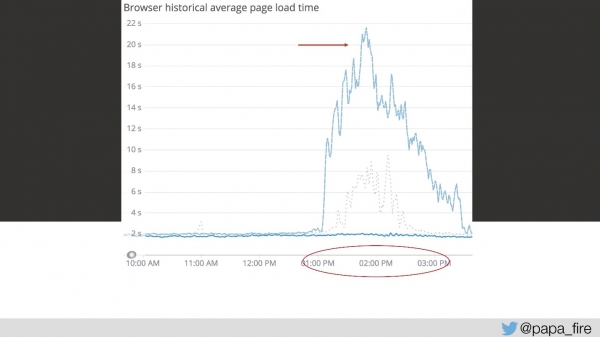
From my perspective, nothing was really working. From everyone else’s point of view, it was just a bit slower than usual. But it can’t just be like that — it’s a serious problem.
I tried to convince the team, but they replied that we just needed more servers. That is indeed a solution to the problem, but not always the only and most effective one. I asked why we were short on servers and what the traffic volume was. I extrapolated the data and found that we had about 150 requests per second, which is generally within reasonable limits.
But one must not forget that before getting the right answer, you need to ask the right question. My next question was: how many frontend servers do we have? The answer somewhat puzzled me — we had 17 frontend servers!
— Jeg er lidt genert ved at spørge, men 150 delt med 17, giver det cirka 8? Vil du sige, at hver server håndterer 8 forespørgsler i sekundet, og hvis der i morgen vil være 160 forespørgsler i sekundet, skal vi så bruge 2 ekstra servere?
Selvfølgelig havde vi ikke brug for ekstra servere. Løsningen lå i selve koden, og den var åbenlys:
var currentClass = classes.getCurrentClass();
return currentClass;
Der var en funktion getCurrentClass(), fordi alt på siden fungerer i konteksten af klassen — korrekt. Og på denne ene funktion havde vi på hver side 200+ forespørgsler.
Løsningen var derfor meget simpel, vi behøvede ikke engang at skrive noget om: vi skulle bare undgå at anmode om de samme oplysninger igen.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
    REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Jeg blev meget glad, fordi jeg troede, at jeg efter blot tre dage havde fundet hovedproblemet. Hvor naiv jeg var; det var kun ét ud af mange problemer.
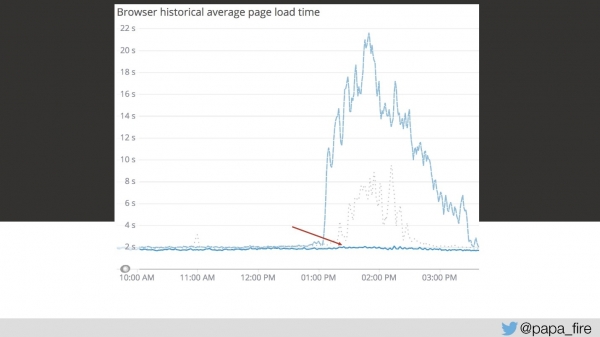
Men at løse dette første problem sænkede grafen betydeligt.
Samtidig arbejdede vi på andre optimeringer. Der var mange synlige ting, der kunne repareres. For eksempel opdagede jeg på den samme tredje dag, at der faktisk var caching i systemet (jeg troede først, at alle forespørgsler kom direkte fra databasen). Når jeg tænker på caching, forestiller jeg mig standard Redis eller Memcached. Men det tænkte kun jeg, for i det system blev der anvendt MongoDB og SQL Server til caching — den samme, som lige havde læst dataene.
Tiende dag
I den første uge arbejdede jeg med problemer, der skulle løses med det samme. Omkring den anden uge kom jeg for første gang til standup for at tale med teamet, se hvad der foregik, og hvordan hele processen gik.
Igen viste der sig noget interessant. Teamet bestod af: 18 udviklere; 8 testere; 3 ledere; 2 arkitekter. Og alle deltager i de fælles ritualer, det vil sige mere end 30 personer kom til standup hver morgen og fortalte, hvad de gjorde. Det var tydeligt, at mødet ikke tog 5 eller 15 minutter. Ingen lyttede til nogen, fordi alle arbejdede i forskellige systemer. I denne form var 2-3 tickets på en grooming session allerede et godt resultat.
Det første, vi gjorde, var at opdele teamet i flere produktlinjer. For de forskellige sektioner og systemer tildelte vi separate teams, som omfattede udviklere, testere, produktledere og forretningsanalytikere.
Resultatet var:
- Forkortelse af stand-ups og møder.
- Faglig viden om produktet.
- Ejerskab. Da folk tidligere ofte skiftede mellem systemer, var de klar over, at det var sandsynligt, at det ville være nogen andre, der skulle arbejde med deres fejl, men ikke dem selv.
- Samarbejde mellem grupper. Det er unødvendigt at nævne, at QA og programmører ikke tidligere kommunikerede meget; produktet blev gjort uafhængigt osv. Nu har de en fælles ansvarszone.
Vi fokuserede hovedsageligt på effektivitet, præstation og kvalitet - disse problemer forsøgte vi at løse ved at transformere teamet.
Dag elleve
Under ændringen af teamstrukturen opdagede jeg, hvordan de beregner StoryPoints. 1 SP svarede til en dag, og hver ticket indeholdt SP både til udvikling og til QA, altså mindst 2 SP.
Hvordan opdagede jeg dette?
Vi fandt en fejl: I en af rapporterne, hvor start- og slutdatoen for perioden, der kræves for rapporten, bliver indtastet, er den sidste dag ikke inkluderet. Det vil sige, at der et sted i forespørgslen stod ikke <=, men blot <. Jeg fik at vide, at dette var tre Story Points, altså 3 dage.
Derefter gjorde vi:
- Vi reviderede systemet til vurdering af Story Points. Nu når små fejl, som hurtigt kan gå igennem systemet, bliver rettet, når de hurtigere når brugeren.
- Vi begyndte at samle relaterede tickets til udvikling og test. Tidligere var hver ticket, hver fejl et lukket økosystem, der ikke var knyttet til noget andet. Ændring af tre knapper på én side kunne være tre forskellige tickets med tre forskellige QA-processer i stedet for én automatisk test på siden.
- Vi begyndte at arbejde med udviklerne om tilgangen til vurdering af arbejdsindsats. Tre dage for at ændre en knap - det er ikke sjovt.
Dag tyve
Omkring midten af den første måned stabiliserede situationen sig en smule. Jeg fandt ud af, hvad der hovedsageligt foregik, og jeg begyndte allerede at se mod fremtiden og tænke på langsigtede løsninger.
Langsigtede mål:
- En administreret platform. Hundredvis af anmodninger på hver side - det er ikke seriøst.
- Forudsigelige tendenser. Der var periodiske trafiktoppe, der ved første øjekast ikke korrelerede med andre metrikker - det var nødvendigt at forstå, hvorfor det skete, og lære at forudsige det.
- Udvidelse af platformen. Virksomheden vokser konstant, flere brugere kommer til, og trafikken øges.
Tidligere blev der ofte sagt: „Lad os genkende alt til [sprog/framework], så vil alt fungere bedre!“
I de fleste tilfælde virker det ikke; det er godt, hvis det, der er genkendt, overhovedet fungerer. Derfor var vi nødt til at skabe en roadmap - en konkret strategi, der illustrerer trin for trin, hvordan vi vil nå forretningsmålene (hvad vi vil gøre og hvorfor), som:
- afspejler projektets mission og mål;
- prioriterer de vigtigste mål;
- indeholder en tidsplan for deres opnåelse.
Indtil nu havde ingen talt med teamet om, hvilken målsetting der var bag de ændringer, der blev foretaget. Til dette er de rigtige succeskriterier nødvendige. For første gang i virksomhedens historie satte vi KPI'er for det tekniske team, og disse målinger blev knyttet til de organisatoriske.
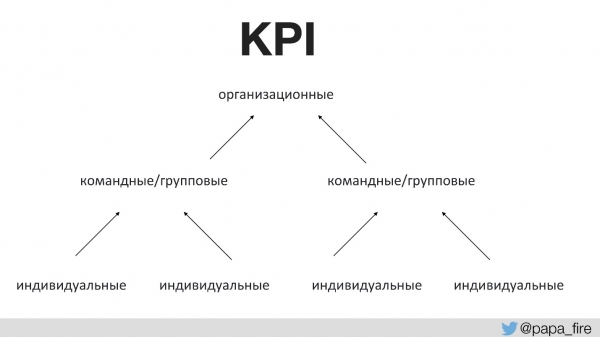
Det vil sige, at de organisatoriske KPI'er understøttes af teamene, og teamets KPI'er understøttes af individuelle. Ellers, hvis de teknologiske KPI'er ikke stemmer overens med de organisatoriske, trækker alle tæppet til sig.
For eksempel er en af de organisatoriske KPI'er at øge markedsandelen gennem nye produkter.
Hvordan kan målet om at have flere nye produkter understøttes?
- For det første ønsker vi at bruge mere tid på at udvikle nye produkter i stedet for at rette defekter. Dette er en logisk løsning, der let kan måles.
- For det andet ønsker vi at understøtte stigningen i transaktionsvolumen, fordi jo større markedsandel, jo flere brugere, og dermed mere trafik.
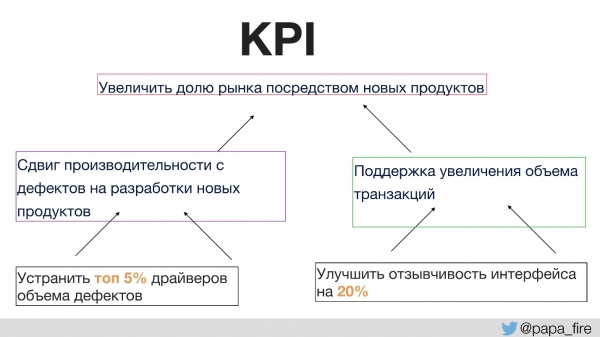
Så de individuelle KPI'er, der kan udføres i gruppen, vil for eksempel være det punkt, hvor de fleste defekter opstår. Hvis vi fokuserer på netop denne sektion, kan vi få antallet af defekter til at falde betydeligt, og så øges tiden til udvikling af nye produkter og igen støtte de organisatoriske KPI'er.
Således skal hver beslutning, herunder at genkende koden, understøtte de specifikke mål, som virksomheden har sat for os (vækst af organisationen, nye funktioner, ansættelse af personale).
I denne proces opdagede jeg noget interessant, som blev en nyhed ikke kun for techfolkene, men generelt i virksomheden: alle billetter skal være rettet mod mindst én KPI. Så hvis produktet siger, at de vil lave en ny funktion, skal det første spørgsmål være: "Hvilken KPI understøtter denne funktion?" Hvis der ikke er nogen, så undskyld — det ser ud til, at det er en unødvendig funktion.
Den tredivte dag
I slutningen af måneden opdagede jeg en anden nuance, nemlig at ingen fra mit ops-team nogensinde havde set de kontrakter, vi indgår med kunderne. Du kunne spørge, hvad formålet er med at se kontrakterne.
- For det første, fordi SLA'er er angivet i kontrakterne.
- For det andet, SLA'er er forskellige. Hver kunde kom med sine krav, og salgsafdelingen underskrev uden at kigge.
En anden interessant nuance — i kontrakten med en af de største kunder står der, at alle versioner af softwaren, som platformen understøtter, skal være n-1, det vil sige ikke den nyeste version, men den næstsidste.
Det er klart, hvor langt vi var fra n-1, når platformen kørte på ColdFusion og SQL Server fra 2008, som i juli ikke længere blev understøttet.
Den femogfyrre dage
Omtrent midtvejs i den anden måned fik jeg tilstrækkeligt med tid til at sætte mig ned og gøre valuestreammapping helt for hele processen. Dette er de nødvendige skridt, der skal tages, fra produktets oprettelse til leveringen til forbrugeren, og de skal beskrives så detaljeret som muligt.
Du opdeler processen i små dele og ser, hvad der tager for lang tid, hvad der kan optimeres, forbedres osv. For eksempel, hvor lang tid det tager fra produktanmodningen går gennem grooming, indtil den når til billetten, som udvikleren kan tage, QA osv. Du ser så detaljeret på hvert enkelt trin og overvejer, hvad der kan optimeres.
Da jeg gjorde dette, stod to ting klart:
- den høje procentdel af billetter, der returneres fra QA til udviklerne;
- pull request-gennemgange tog for meget tid.
Problemet var, at det var konklusioner som: det tager tilsyneladende meget tid, men vi er ikke sikre på, hvor meget præcist.
"Man kan ikke forbedre det, man ikke kan måle."
Hvordan kan man argumentere for, hvor alvorligt problemet er? Tager det dage eller timer?
For at måle dette, har vi tilføjet et par skridt i Jira-processen: «klar til udvikling» og «klar til QA», for at måle, hvor lang tid hver ticket venter, og hvor mange gange den vender tilbage til et bestemt skridt.
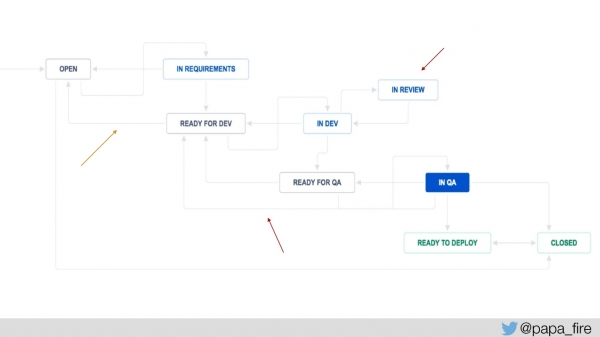
Vi har også tilføjet «under gennemgang», så vi kan se, hvor længe tickets i gennemsnit er på review, og arbejde derfra. Vi havde systemmetrikker, nu har vi tilføjet nye metrikker, og vi måler:
- Effektiviteten af processen: produktivitet og planlagt/leveret.
- Kvaliteten af processen: antal defekter, defekter fra QA.
Dette hjælper virkelig med at forstå, hvad der går godt, og hvad der går dårligt.
Den femtiende dag
Alt dette er selvfølgelig godt og interessant, men tættere på slutningen af den anden måned skete der noget, som i princippet var forudsigeligt, selvom jeg ikke havde forventet en så stor skala. Folk begyndte at forlade, fordi ledelsen ændrede sig. Nye personer kom ind i ledelsen, som begyndte at ændre alt, og de gamle sagde op. Normalt i en virksomhed, der har eksisteret i flere år, kender alle hinanden og er venner.
Dette var forventeligt, men det uventede var skalaen af afskedigelserne. For eksempel, på en uge sagde to teamledere samtidig op af egen vilje. Så jeg måtte ikke bare glemme de andre problemer, men fokusere på at skabe et team. Det er et langvarigt og vanskeligt problem, men det skulle håndteres, fordi jeg ønskede at bevare de mennesker, der var tilbage (eller de fleste af dem). Jeg måtte finde en måde at reagere på, at folk var gået, for at opretholde moralen i teamet.
I teorien er det godt: en ny person kommer ind, har frit spil til at vurdere teamets færdigheder og kan erstatte medarbejdere. I virkeligheden kan man ikke bare sådan bringe nye mennesker ind af mange grunde. Der er altid behov for balance.
- Mellem det gamle og det nye. Man skal bevare de gamle folk, der kan ændre sig og understøtte missionen. Men samtidig skal der komme ny blod, om det vil vi tale senere.
- Erfaring. Jeg har snakket meget med gode juniorer, som brændte for at arbejde hos os. Men jeg kunne ikke ansætte dem, fordi der ikke var tilstrækkeligt med seniorer til at støtte juniorerne og være mentorer for dem. Vi måtte først rekruttere ledelsen og derefter ungdommen.
- Pisk og gulerod.
Jeg har ikke noget godt svar på spørgsmålet om, hvad der er den rigtige balance, hvordan man opretholder den, hvor mange folk man skal have, og hvor hårdt man skal presse. Det er en rent individuel proces.
Dag enoghalvfjerds
Jeg begyndte at kigge nærmere på teamet for at forstå, hvem jeg har, og kom igen til at tænke på:
«De fleste problemer er problemer med mennesker».
Jeg opdagede, at der i teamet, både blandt udviklerne og Ops, er tre store problemer:
- Tilfredshed med den nuværende situation.
- Manglende ansvarlighed — fordi ingen nogensinde har relateret resultaterne fra medarbejdernes arbejde til indflydelse på forretningen.
- Frygt for forandringer.
Forandringer bringer altid folk ud af deres komfortzone, og jo yngre folk er, desto mere kan de ikke lide forandringer, fordi de ikke forstår, hvorfor, og de forstår ikke, hvordan. Den mest hyppige kommentar, jeg har hørt, er: «Vi har aldrig gjort det sådan før». Faktisk nåede det til en fuldstændig absurditet — selv små ændringer kunne ikke ske uden, at nogen protesterede. Og det var ligegyldigt, hvor meget ændringerne påvirkede deres eget arbejde, folk sagde: «Nej, hvorfor? Det vil ikke fungere».
Men man kan ikke blive bedre uden at ændre noget.
Jeg havde en fuldstændig absurd samtale med en medarbejder, jeg fortalte ham mine idéer til optimering, hvorefter han sagde til mig:
— Åh, har du ikke set, hvad vi havde sidste år!
— Og hvad så?
— Det er meget bedre nu, end det var.
— Så kan det ikke blive endnu bedre?
— Hvorfor skulle det?
Godt spørgsmål — hvorfor? Som om, hvis det nu er bedre, end det var, så er alt tilstrækkeligt godt. Det fører til en mangel på ansvarlighed, hvilket i princippet er helt normalt. Som jeg sagde, var tech-teamet lidt sidelæns. Virksomheden mente, at de skulle være der, men ingen har nogensinde fastsat standarder. I supporten har de aldrig set et SLA, så for gruppen var det helt »acceptabelt« (og det chokerede mig mest):
- 12 sekunders indlæsning;
- 5-10 minutters nedetid hver udgivelse;
- fejlretning af kritiske problemer tager dage og uger;
- mangel på vagt 24/7 / on-call.
Ingen har nogensinde forsøgt at spørge, hvorfor vi ikke gør det bedre, og ingen har nogensinde forstået, at det ikke skal være sådan.
Som et bonus var der endnu et problem: mangel på erfaring. Seniorerne forlod, og det unge team, der var tilbage, voksede op under de gamle forhold og blev forgiftet af dem.
Desuden var folk også bange for at fejle, eller at virke inkompetente. Det kommer til udtryk ved, at de for det første, under ingen omstændigheder beder om hjælp. Hvor mange gange har vi talt i grupper og enkeltvis, og jeg har sagt: "Stil et spørgsmål, hvis du ikke ved, hvordan du skal gøre noget." Jeg har selvtillid og ved, at jeg kan løse ethvert problem, men det tager tid. Så hvis man kan spørge nogen, der ved, hvordan man løser det på 10 minutter, så ville jeg spørge. Jo mindre erfaring du har, jo mere frygter du at stille spørgsmål, fordi du tror, at folk vil anse dig for inkompetent.
Denne frygt for at stille spørgsmål viser sig på interessante måder. For eksempel spørger du: "Hvordan står det til med denne opgave?" - "Jeg har et par timer tilbage, jeg er snart færdig." Den næste dag spørger du igen, og du får svaret, at alt er okay, men der er én lille problem, dog vil det blive færdiggjort inden dagen er omme. Endnu en dag går, og indtil du presser dem op ad væggen og tvinger dem til at tale med nogen, fortsætter det sådan. Personen ønsker at løse opgaven selv, og de mener, at hvis de ikke klarer det selv, vil det være en stor fiasko.
Netop derfor udviklerne overvurderede estimaterne. Det var en sjov anekdote, da vi diskuterede en bestemt opgave, og jeg blev præsenteret for et estimat, der overraskede mig meget. Hvad jeg fik at vide var, at udvikleren inkludere tid, som billetterne vil bruge til at komme tilbage fra QA, fordi de vil finde fejl der, tid til at PR'en skal behandles, og tid, mens folk, der skal se på det, er optaget - altså alt, hvad der overhovedet kan være.
For det andet er folk, der frygter at fremstå inkompetente, overdrevne i deres analyser. Når du siger, hvad der konkret skal gøres, begynder de: "Nej, hvad nu hvis vi tænker over det her?" I denne henseende er vores virksomhed ikke unik, det er et standardproblem blandt unge.
Som svar indførte jeg følgende praksisser:
- 30-minutters reglen. Hvis du ikke kan løse problemet inden for en halv time, så bed om hjælp fra nogen. Det fungerer med varierende succes, fordi folk stadig ikke spørger, men i det mindste er processen begyndt.
- Udeluk alt, hvad der ikke er essentielt,i vurderingen af tidsrammen for opgaven, det vil altså sige kun at tage højde for den tid, det tager at skrive koden.
- Løbende læring for dem, der overanalyserer. Det er simpelthen en konstant arbejde med folk.
Den tresindstyvende dag
Mens jeg arbejdede med alt det her, kom tiden til at få styr på budgettet. Selvfølgelig fandt jeg en masse interessante ting om, hvor vi brugte penge. For eksempel havde vi et helt rack i et separat datacenter, hvor der stod en FTP-server, som blev brugt af én kunde. Det viste sig, at „... vi flyttede, og den blev bare stående, vi har ikke ændret den“. Det var for 2 år siden.
Den særlige interesse var regningen for cloud-tjenester. Jeg er sikker på, at den primære årsag til den høje regning for cloud-tjenester er udviklerne, der for første gang i deres liv har ubegribelig adgang til serverne. De behøver ikke at spørge: „Giv mig venligst en testserver“ — de kan tage én selv. Plus, udviklerne ønsker altid at bygge et så fedt system, at Facebook og Netflix bliver misundelige.
Men udviklerne har ikke erfaring med indkøb af servere eller færdigheder til at bestemme den nødvendige serverstørrelse, fordi de ikke har haft brug for det før. Og normalt forstår de ikke helt forskellen mellem scalability og performance.
Resultaterne af inventaret:
- Vi er blevet lukket ud af ét datacenter.
- Vi har opsagt kontrakten med 3 log-tjenester. Fordi vi havde 5 af dem — hver udvikler, der begyndte at eksperimentere med noget, tog en ny.
- Vi slukkede 7 AWS-systemer. Igen, døde projekter blev aldrig stoppet, de fortsatte bare med at køre.
- Vi har reduceret softwareomkostningerne med 6 gange.
Dag fem og tres
Tiden gik, og efter to et halvt måned skulle jeg mødes med bestyrelsen. Vores bestyrelse er ikke bedre eller værre end andre, de vil ligesom alle bestyrelser vide alt. Folk investerer penge og vil forstå, hvordan det, vi laver, passer ind i de satte KPI'er.
Bestyrelsen modtager mange oplysninger hver måned: antallet af brugere, deres vækst, hvilke tjenester de bruger og hvordan, endelig performance og produktivitet, samt den gennemsnitlige indlæsningstid på siden.
Problemet er kun, at jeg mener, at gennemsnittet er ren ondskab. Men det er meget svært at forklare bestyrelsen det. De er vant til at arbejde med aggregerede tal, ikke for eksempel spredningen af indlæsningstid i sekunder.
I den forbindelse var der interessante øjeblikke. For eksempel sagde jeg, at vi skulle fordele trafikken mellem de enkelte webservere afhængigt af indholdstypen.
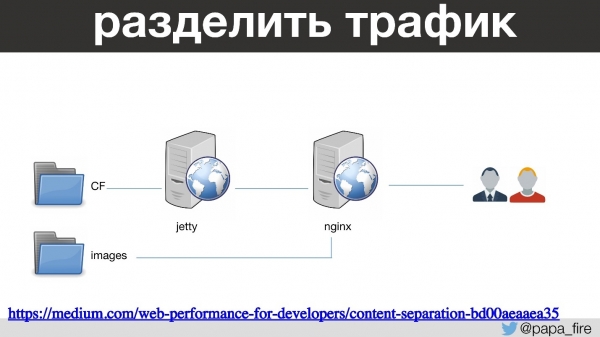
Det vil sige, at ColdFusion kører gennem Jetty og nginx og serverer siderne. Billeder, JS og CSS går gennem en separat nginx med sine egne konfigurationer. Dette er en ganske standardpraksis, som jeg endda for et par år siden. Som et resultat indlæses billederne meget hurtigere, og ... den gennemsnitlige indlæsningshastighed er steget med 200 ms.
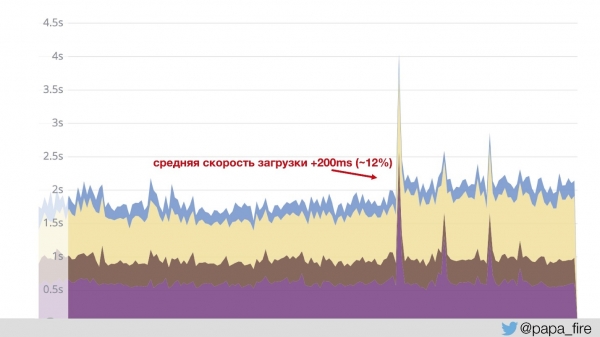
Dette skete, fordi grafen bygger på data, der kommer fra Jetty. Det vil sige, at hurtigt indhold ikke tælles med — det gennemsnitlige tal er steget. Det var vi klar over, vi grinede, men hvordan skal man forklare bestyrelsen, hvorfor vi gjorde noget, der gjorde, at det blev værre med 12 %?
Den femogtyvende dag
Mod slutningen af den tredje måned indså jeg, at der var én ting, jeg slet ikke havde regnet med — tiden. Alt, hvad jeg har nævnt, kræver tid.
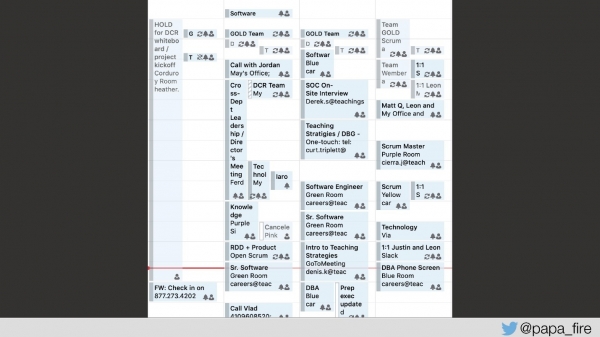
Dette er min ægte kalender for ugen — bare en arbejdsuge, ikke særlig travl. Der er ikke tid til alt. Derfor skal vi igen ansætte folk, som kan hjælpe med problemerne.
Konklusion
Det er slet ikke alt. I denne fortælling er jeg endnu ikke nået til, hvordan vi arbejdede med produktet og forsøgte at indstille os på samme bølgelængde, eller hvordan vi integrerede supporten, eller hvordan vi løste andre tekniske problemer. For eksempel fandt jeg helt tilfældigt ud af, at vi ikke bruger SEQUENCE. Vi har en egen udviklet funktion nextID, og den bruges ikke i en transaktion.
Der var en million lignende ting, som man kan tale om længe. Men det vigtigste, som man også bør nævne, er kulturen.
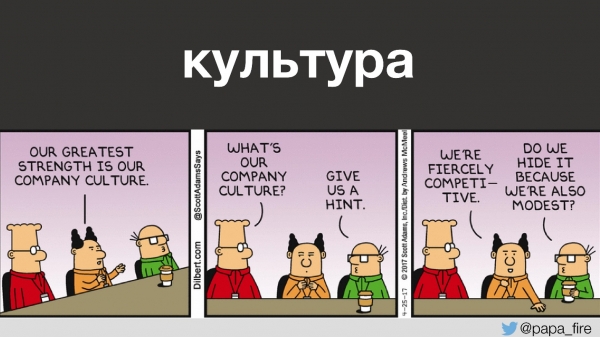
Det er netop kulturen eller mangel på samme, der fører til alle de andre problemer. Vi forsøger at skabe en kultur, hvor folk:
- ikke er bange for at fejle;
- lærer af deres fejl;
- samarbejder med andre teams;
- viser initiativ;
- tager ansvar;
- vælter resultatet som mål;
- fejrer succes.
Med dette vil alt det andet komme.
Leon Fier , og på .
Når det kommer til legacy, er der to strategier: at undgå at arbejde med det for enhver pris, eller tappert at overvinde de dertilhørende udfordringer. Vi går den anden vej og ændrer processer og tilgange. Deltag i vores , og , og lad os implementere DevOps-kulturen sammen.
Kilde: habr.com
