

Bland SRE-/DevOps-ingeniører er det ikke overraskende, at en kunde (eller et overvågningssystem) en dag dukker op og siger, at "alt er tabt": hjemmesiden virker ikke, betalinger går ikke igennem, livet er trist... Selvom man gerne vil hjælpe i en sådan situation, kan det være meget svært at gøre det uden et enkelt og klart værktøj. Ofte er problemet gemt i selve applikationens kode — man skal bare lokalisere det.
I både sorg og glæde...
Sådan er det, at vi for længe siden virkelig kom til at elske New Relic. Det har været og er stadig et fremragende redskab til overvågning af applikationsydelse, og det gør det muligt at instrumentere mikrotjenestearkitekturen (ved hjælp af sin agent) og meget, meget mere. Og alt kunne have været fantastisk, hvis ikke for ændringerne i serviceprisen: den prisen er steget med over 3 gange. Desuden kræver det nu kommunikation med en personlig manager for at få en trial-konto, hvilket besværliggør præsentationen af produktet til potentielle kunder.
En almindelig situation: New Relic er ikke nødvendigt 'på konstant basis', man husker kun på det, når problemerne begynder. Men man skal stadig betale regelmæssigt (140 USD per server per måned), og i en automatisk skalerende cloud-infrastruktur løber beløbene op. Selvom der er en 'Pay-As-You-Go'-mulighed, kræver det at genstarte applikationen for at aktivere New Relic, hvilket kan resultere i tab af den problematiske situation, som alt dette blev sat i gang for. For ikke så længe siden introducerede New Relic en ny tarifplan — , — som ved første øjekast ser ud til at være et fornuftigt alternativ til Professional... men ved en nærmere undersøgelse viste det sig, at nogle vigtige funktioner manglede (især er der ikke Key Transactions, Cross Application Tracing, Distributed Tracing).
Som resultat overvejede vi at finde en billigere alternativ, og vores valg faldt på to tjenester, Datadog og Atatus. Hvorfor netop dem?
Om konkurrenterne
Jeg vil straks understrege, at der findes andre løsninger på markedet. Vi overvejede endda Open Source-alternativer, men ikke alle kunder har frie ressourcer til at implementere løsninger af typen self-hosted... — desuden kræver de yderligere vedligeholdelse. Den par, vi valgte, viste sig at være tættest på vores behov:
- indbygget og udviklet support til PHP-applikationer (stakken hos vores kunder er meget varieret, men det er en klar leder i forhold til at finde alternativer til New Relic);
- overkommelig pris (mindre end 100 USD om måneden for hosting);
- automatisk instrumentering;
- integration med Kubernetes;
- ligheder med New Relic's interface — en mærkbar fordel (fordi vores ingeniører har vænnet sig til det).
Derfor har vi i den indledende udvælgelse udelukket flere andre populære løsninger, herunder:
- Tideways, AppDynamics og Dynatrace — på grund af prisen;
- Stackify — blokeret i Rusland og viser for få data.
Den følgende artikel er opbygget på en måde, hvor de betragtede løsninger først præsenteres kort, hvorefter jeg vil fortælle om vores typiske interaktion med New Relic samt erfaringer/impressioner fra udførelsen af lignende operationer i andre tjenester.
Præsentation af udvalgte konkurrenter
Om , har nok hverken hørt om? Denne tjeneste begyndte sin udvikling for over 10 år siden, i 2008. Vi har aktivt anvendt den siden 2012 og har ikke haft problemer med integration af et reelt stort antal applikationer på PHP, Ruby og Python, og vi har også erfaring med integration med C# og Go. Tjenestens skabere har løsninger til overvågning af applikationer, infrastruktur, sporing af mikroservice-infrastrukturer, der er lavet brugervenlige apps til kundeenheder og meget mere.
Men New Relic-agenten arbejder med proprietære protokoller, og der er ikke støtte for OpenTracing. For avanceret instrumentering kræves specifikke tilpasninger til New Relic. Endelig har Kubernetes-supporten i øjeblikket eksperimentel status.
Som begyndte sin udvikling i 2010 ser væsentligt mere interessant ud end New Relic, især i forhold til anvendelse i Kubernetes-miljøer. Det understøtter nemlig integration med NGINX Ingress, logindsamling, statsd og OpenTracing-protokoller, hvilket gør det muligt at spore brugerforespørgsler fra forbindelsen til afslutningen af arbejdet og også finde logge for denne anmodning (både på websiden og på forbrugerens side).
Ved brug af Datadog stødte vi på det faktum, at det nogle gange konstruerede kortet over mikroservices forkert, samt nogle tekniske mangler. For eksempel identificerede det forkert servicen som (opfattede Django som en caching-service) og forårsagede 500-fejl i PHP-applikationen, der brugte det populære bibliotek Predis.
— det yngste værktøj; servicen blev lanceret i 2014. Dens markedsføringsbudget er tydeligt mindre end de nævnte konkurrenter, og omtaler forekommer betydeligt sjældnere. Ikke desto mindre ligner værktøjet i sig selv New Relic meget, ikke kun i funktioner (APM, Browser monitoring osv.), men også i udseendet.
En betydelig ulempe er, at det kun understøtter Node.js og PHP. På den anden side er implementeringen betydeligt bedre end hos Datadog. I modsætning til sidstnævnte kræver Atatus ikke, at applikationerne ændres eller at der tilføjes ekstra etiketter i koden.
Sådan arbejder vi med New Relic
Lad os nu se på, hvordan vi typisk bruger New Relic. Lad os antage, at vi har et problem, der kræver løsning:
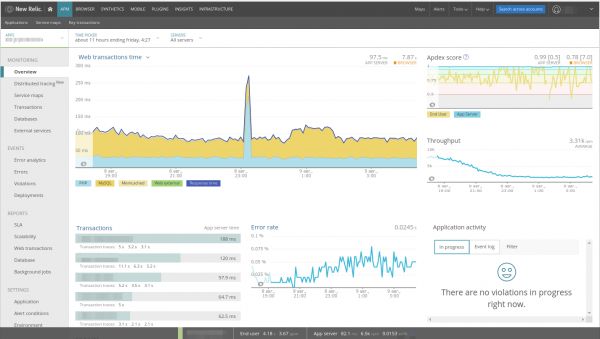
Det er let at bemærke et spike — lad os analysere det. I New Relic for webapplikationen er webtransaktioner straks valgt, i præstationsgrafen er alle komponenter angivet, og der er paneller for error-rate, request-rate… Det vigtigste er, at man direkte fra disse paneler kan navigere mellem forskellige dele af applikationen (for eksempel vil et klik på MySQL føre til databasedelen).
Da vi i dette eksempel ser et spike i aktiviteten PHP, klikker vi på denne graf og går automatisk til Transactions:
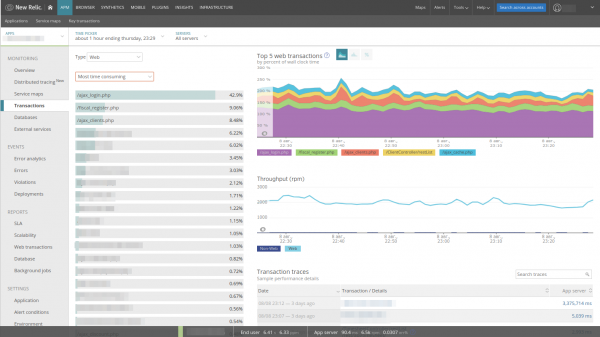
Listen over transaktioner, som i bund og grund er controllere fra MVC-modellen, er allerede sorteret efter Most time consuming, hvilket er meget praktisk: vi ser straks, hvad applikationen beskæftiger sig med. Her er der også eksempler på lange anmodninger, der automatisk indsamles af New Relic. Ved at skifte sortering er det let at finde:
- den mest belastede controller i applikationen;
- den mest anmodede controller;
- den langsomste af controllere.
Derudover kan man udvide hver transaktion og se, hvad applikationen beskæftigede sig med i øjeblikket for koden blev udført:
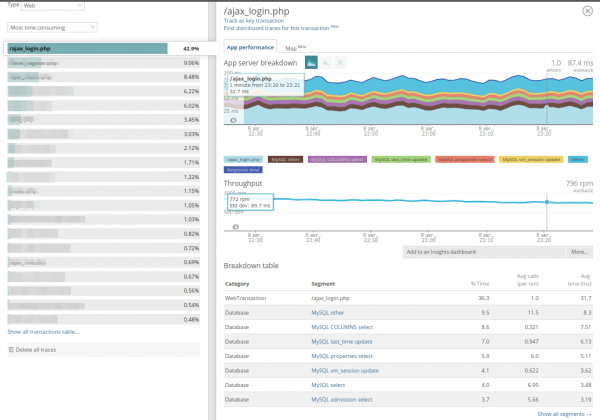
Endelig gemmes der eksempler på traces for lange anmodninger (der tager over 2 sekunder). Her er panelet for den lange transaktion:
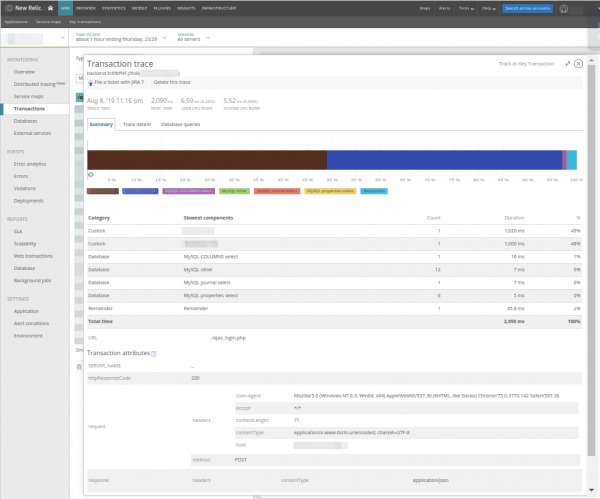
Det ses, at to metoder tager meget tid, og der vises også tidspunktet for anmodningen, dens URI og domæne. Dette hjælper ofte med at finde anmodningen i loggene. Ved at gå til Trace details, kan man se, hvor disse metoder bliver kaldt fra:
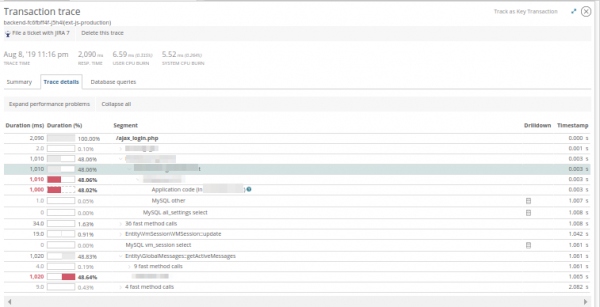
Og i Database queries — vurdere anmodninger til databaserne, som blev udført i løbet af applikationens drift:
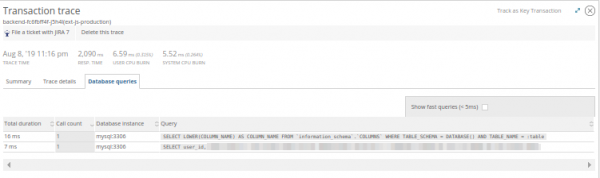
Med disse færdigheder kan vi vurdere årsagen til applikationens langsomhed og sammen med udvikleren udvikle en strategi for at løse problemet. I praksis giver New Relic dog ikke altid et klart billede, men det hjælper med at vælge retningen for efterforskningen:
- lang
PDO::Constructførte os til mærkelig funktionalitet i pgpoll; - ustabilitet over tid
Memcache::Getindikerede en forkert konfiguration af den virtuelle maskine; - den mistænkeligt forøgede behandlingstid for skabelonen førte til en indlejret løkke, der kontrollerede for 500 avatarer i objektlageret;
- og så videre…
Der kan også ske det, at der vokser noget relateret til ekstern datalagring i stedet for at køre koden på hovedskærmen — og det er ligegyldigt hvad det er: Redis eller PostgreSQL — de gemmer sig alle under fanen Databases.
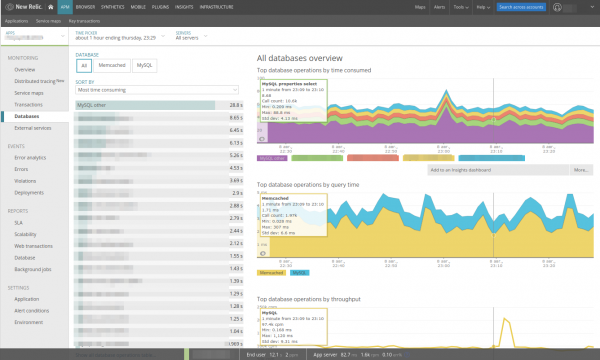
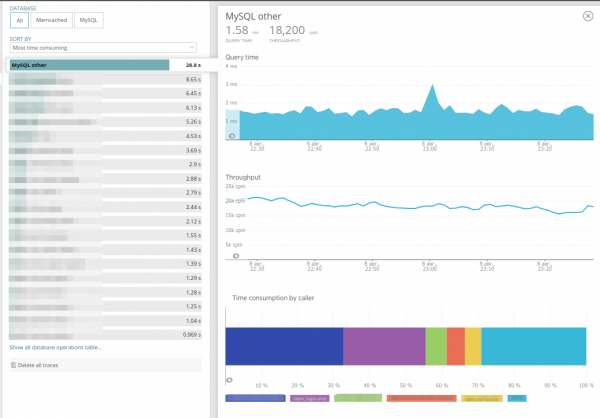
Du kan vælge en specifik database til undersøgelse og sortere forespørgslerne — ligesom det gøres i Transactions. Ved at gå til forespørgselsfanen kan man se, hvor ofte denne forespørgsel optræder i hver af applikationens controllere, samt vurdere, hvor ofte den kaldes. Det er meget praktisk:
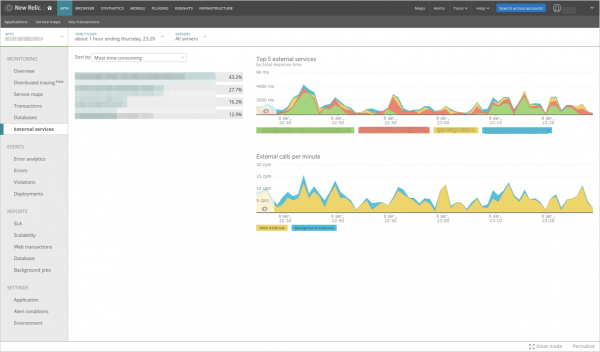
Tilsvarende data findes i fanen External Services, som skjuler forespørgsler til eksterne HTTP-tjenester, såsom anmodninger til objektlageret, sending af begivenheder til Sentry eller lignende. Indholdet af fanen er helt analoge til Databases:
Konkurrenter: muligheder og indtryk
Nu bliver det interessante — lad os sammenligne mulighederne i New Relic med dem, som konkurrenterne tilbyder. Desværre har vi ikke været i stand til at teste alle tre værktøjer med den samme version af en produktionsapplikation. Ikke desto mindre har vi forsøgt at sammenligne så ensartede situationer/konfigurationer som muligt.
1. Datadog
Datadog møder os med et panel som en væg af tjenester:
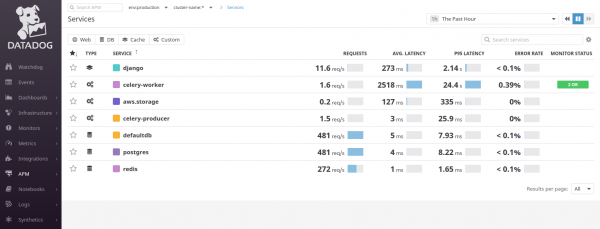
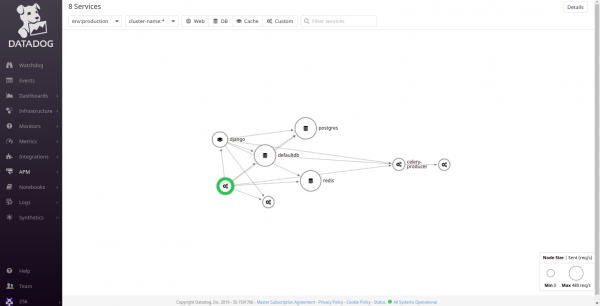
Det forsøger at opdele applikationer i komponenter/mikrotjenester, så i det angivne eksempel med en Django-applikation vil vi se to forbindelser til PostgreSQL (defaultdb og postgres), samt Celery og Redis. Arbejdet med Datadog kræver, at du har en vis viden om MVC-principperne: det er nødvendigt at forstå, hvor brugerens forespørgsler overhovedet kommer ind. Normalt hjælper tjenestekort:
For øvrigt er der noget lignende i New Relic:
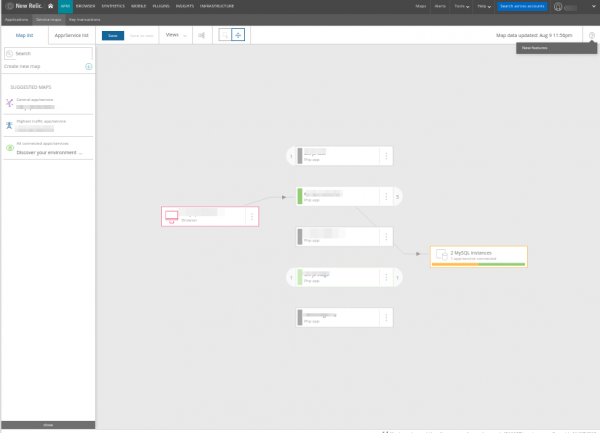
… jeg synes, kortet er lavet enklere og mere forståeligt: det viser ikke komponenterne i én applikation (hvilket ville gøre det for detaljeret som i tilfælde af Datadog), men kun specifikke tjenester eller mikrotjenester.
Lad os vende tilbage til Datadog: fra servicekortet kan vi se, at brugerforespørgslerne kommer ind i Django. Lad os gå ind i Django-tjenesten og endelig se det, vi forventede:
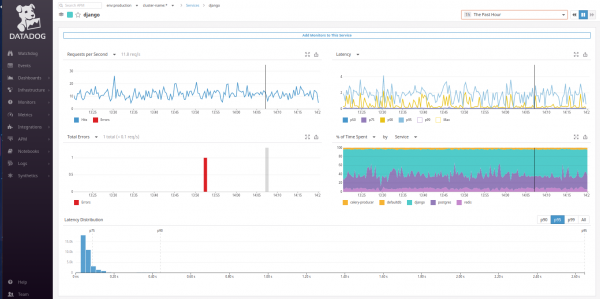
Desværre er der ikke et graf her som standard Webtransaktionstid, som ligner det, vi ser på hovedpanelet i New Relic. Men det kan tilpasses i stedet for grafen % af tid brugt. Det er bare at skifte til Gns. tid pr. anmodning efter type… og nu ser vi allerede den velkendte graf!
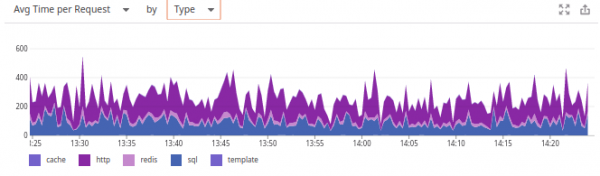
Hvorfor Datadog valgte en anden graf — er et mysterium for os. Det var også skuffende, at systemet ikke husker brugerens valg (i modsætning til begge konkurrenter), og derfor redder kun oprettelsen af brugerdefinerede panelet.
Men vi blev glade for muligheden i Datadog for at skifte fra disse grafer til metrikker for relaterede servere, læse logs og vurdere belastningen på webserverens behandlere (Gunicorn). Det er næsten som i New Relic… og endda lidt mere (logs)!
Under grafen findes transaktioner, der er fuldstændig analoge til New Relic:
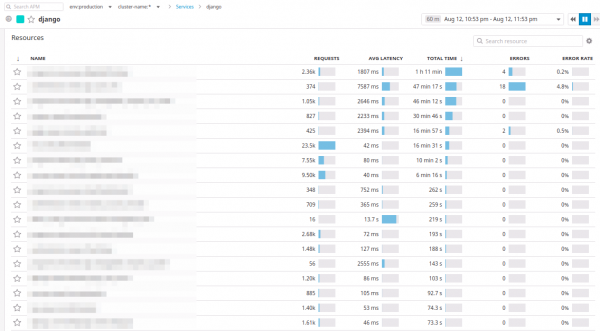
I Datadog kaldes transaktioner ressourcer. Kontrollerne kan sorteres efter antal forespørgsler, gennemsnitlig svartid, maksimalt brugt tid i den valgte periode.
En ressource kan udvides og vise alt det, vi allerede har observeret i New Relic:
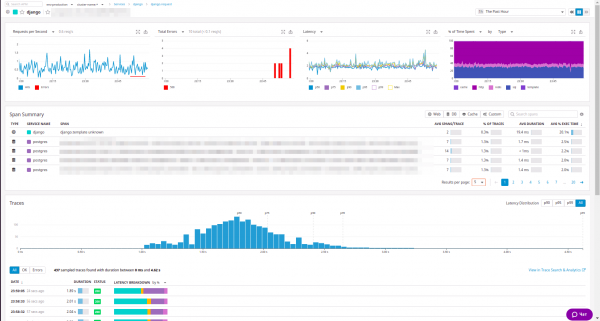
Der er både statistik over ressourcen, en sammenfattet liste over interne opkald og eksempler på anmodninger, som kan sorteres efter svarkode… For øvrigt fandt vores ingeniører denne sortering meget tilfredsstillende.
Enhver eksempelressource i Datadog kan åbnes og studeres:
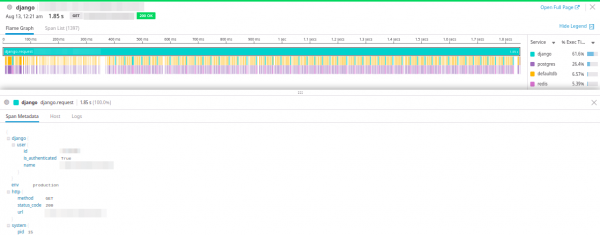
Der præsenteres anmodningsparametre, et opsummeringsdiagram over den tid brugt på hver af komponenterne og et waterfall-diagram, hvor sekvensen af opkald ses. Derudover er der mulighed for at skifte til en træstruktur-visualisering af waterfall-diagrammet:
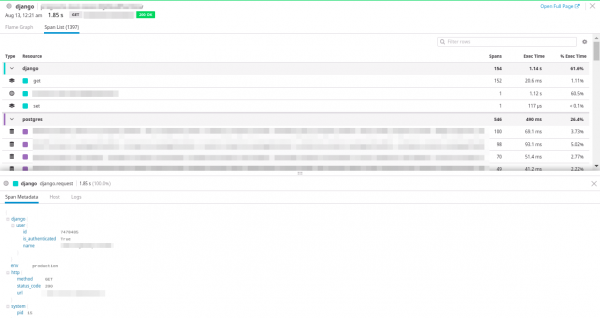
Og det mest interessante — visningen af belastningen på værten, hvor anmodningen blev udført, og visningen af anmodningsloggen.
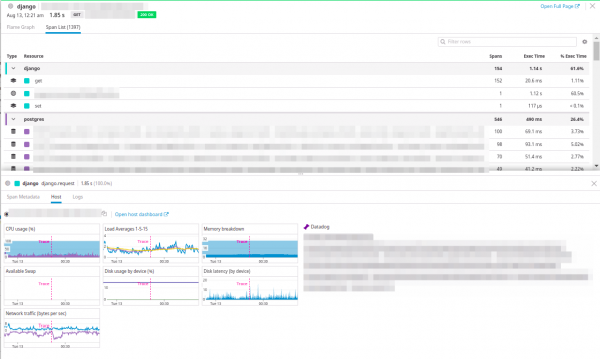
Fremragende integration!
Der kan opstå spørgsmål om, hvor fanerne Databases og External Services, som i New Relic. Her er de ikke: da Datadog opdeler applikationen i komponenter, vil PostgreSQL blive betragtet som en separat tjeneste, og i stedet for Eksterne tjenester skal der søges efter aws.storage (det samme gælder for enhver anden ekstern service, som applikationen måtte tilgå).
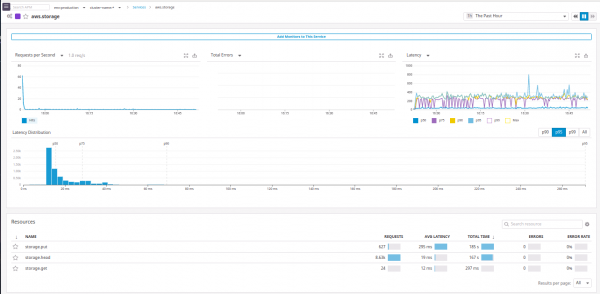
Her er et eksempel med postgres:
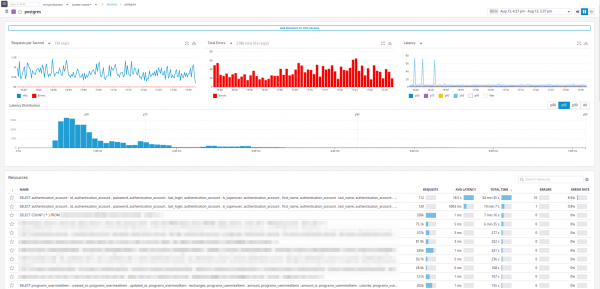
I princippet er der alt det, vi ønskede:
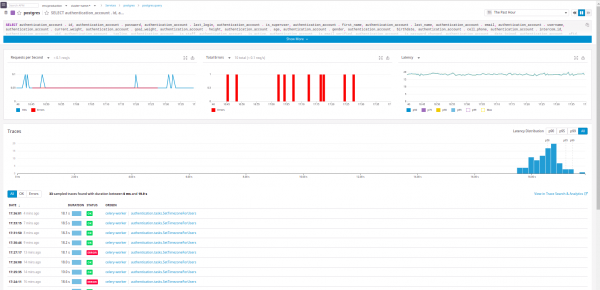
Det er tydeligt, hvilken «service» anmodningen kom fra.
Det skal nævnes, at Datadog integreres fremragende med NGINX Ingress og muliggør end-to-end tracing fra anmodningens ankomst til klyngen, samt modtagelse af statsd-metrics, indsamling af logs og host metrics.
En stor fordel ved Datadog er, at prisen består af infrastrukturmonitorering, APM, logstyring og syntetiske tests, dvs. man kan fleksibelt vælge en plan.
2. Atatus
Atatus-teamet hævder, at deres service er «ligesom New Relic, men bedre». Lad os se, om det virkelig er tilfældet.
Oversigtspanelet ser virkelig ens ud, men det var ikke muligt at identificere, hvilken Redis og memcached der anvendes i applikationen.
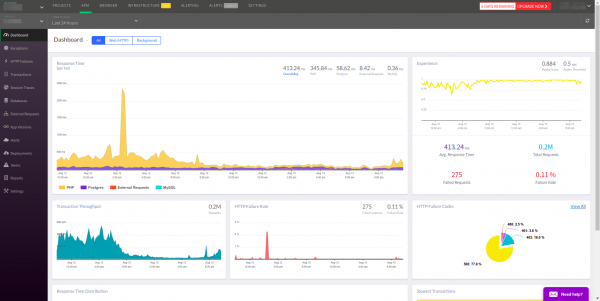
APM vælger som standard alle transaktioner, selvom man som regel kun har brug for Web. Som i Datadog er der ikke mulighed for at gå til den ønskede service fra hovedpanelet. Desuden vises transaktioner i listen efter fejl, hvilket ikke virker særlig logisk for APM.
I transaktionerne ligner Atatus meget New Relic. Ulempen er, at man ikke straks kan se dynamikken for hver controller. Denne skal findes i controller-tabellen, sorteret efter Most Time Consumed:
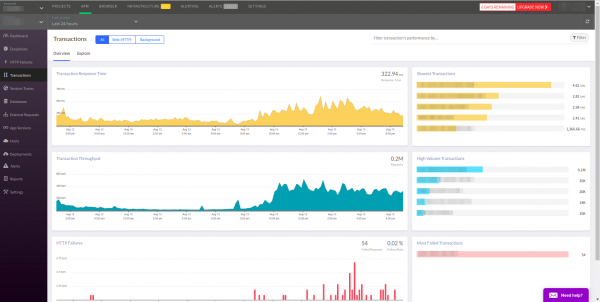
Den velkendte liste over controllere er tilgængelig under fanen Explore:
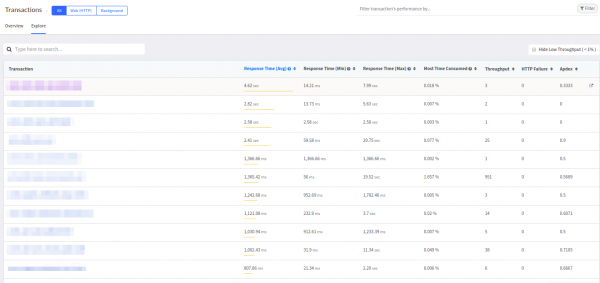
Denne tabel minder faktisk om Datadog og er mere tiltalende end den tilsvarende i New Relic.
Hver transaktion kan udvides for at se, hvad applikationen har foretaget sig:
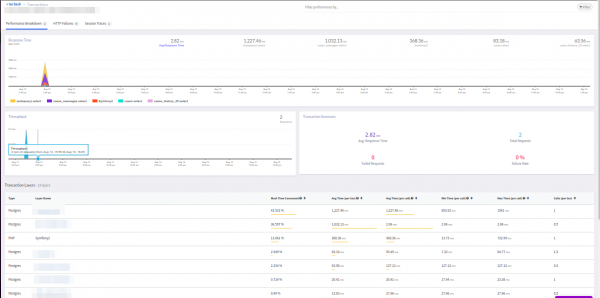
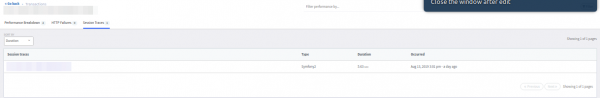
Panelet minder også mere om Datadog: der er antal anmodninger, et overblik over kald. Den øverste panel tilbyder en fane med fejl HTTP Failures og eksempler på langsomme anmodninger Session Traces:
Hvis man går ind i en transaktion, vises et eksempel på tracing, man kan få en liste over databaseanmodninger og se anmodningsoverskrifterne. Alt er ligesom New Relic:
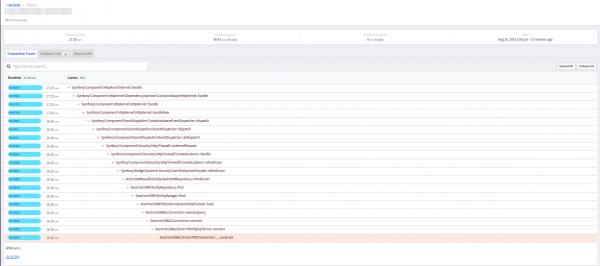
Generelt har Atatus imponeret med detaljerede traces — uden de typiske sammenslutninger af kald i reminder-blokken som i New Relic:
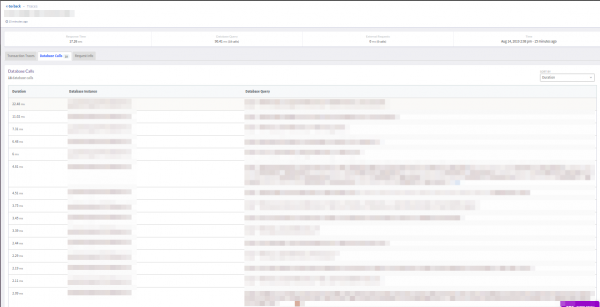
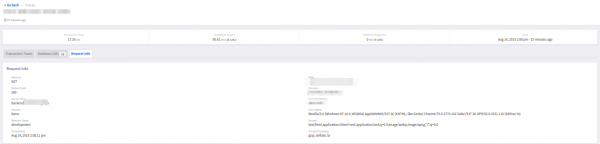
Men her mangler en filter, der (som i New Relic) udelukker super hurtige anmodninger (<5ms). På den anden side var visningen af den endelige respons på transaktionen (succes eller fejl) tilfredsstillende.
Panel Databases vil hjælpe med at undersøge anmodninger til de eksterne databaser, som applikationen foretager. Jeg vil minde om, at Atatus kun fandt PostgreSQL og MySQL, selvom der også anvendes Redis og memcached i projektet.
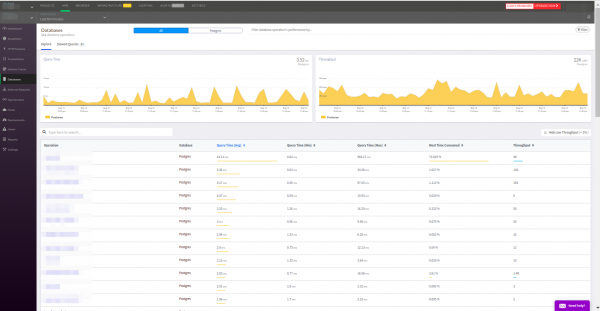
Anmodninger sorteres efter kendte kriterier: hyppighed af udløsning, gennemsnitlig svartid osv. Især vil jeg understrege fanen med de langsomste anmodninger - det er meget praktisk. Desuden stemmer dataene i denne fane for PostgreSQL overens med dataene fra udvidelsen. — et fantastisk resultat!
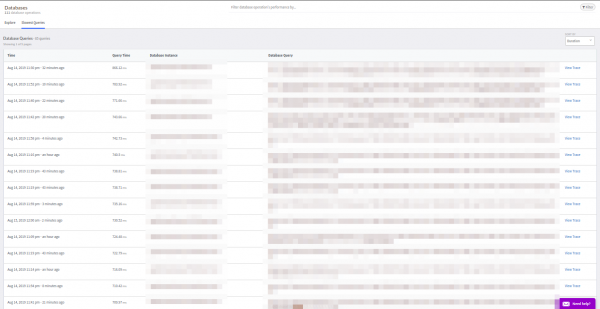
Fanen Eksterne anmodninger er fuldstændig identisk med Databaser.
Konklusioner
Begge præsenterede værktøjer har gjort det godt som APM. Enhver af dem kan tilbyde det nødvendige minimum. Kort opsummeret vores indtryk kan såldes:
Datadog
Fordele:
- praktisk prisstruktur (APM koster 31 USD pr. host);
- har fungeret fremragende med Python;
- mulighed for integration med OpenTracing
- integration med Kubernetes;
- integration med NGINX Ingress.
Ulemper:
- den eneste APM, der forårsagede utilgængelighed af applikationen på grund af en modulfri (predis);
- svag automatisk instrumentering af PHP;
- delvist underlig definition af tjenester og deres formål.
Atatus
Fordele:
- dyb instrumentering af PHP;
- ligner New Relic i brugergrænsefladen.
Ulemper:
- fungerer ikke på ældre operativsystemer (Ubuntu 12.05, CentOS 5);
- svag automatisk instrumentering;
- understøtter kun to programmeringssprog (Node.js og PHP);
- langsom betjening af grænsefladen.
I betragtning af prisen for Atatus på 69 USD om måneden pr. server, ville vi hellere bruge Datadog, som integreres perfekt til vores behov (webapplikationer i K8s) og har mange nyttige funktioner.
P.S.
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
