

De dage, hvor man ikke behøvede at bekymre sig om optimering af databaseydelse, er forbi. Tiden står ikke stille. Hver ny iværksætter inden for teknologi ønsker at skabe det næste Facebook og stræber efter at indsamle alle de data, de kan få fat i. Disse data er afgørende for at forbedre modellerne, som hjælper med at generere indtægter. Under sådanne forhold er det nødvendigt for udviklere at skabe API'er, der gør det muligt at arbejde hurtigt og pålideligt med store mængder information.
Hvis du i et stykke tid har arbejdet med design af serverkomponenter til applikationer eller databaser, har du sikkert skrevet kode til at udføre forespørgsler med paginering. For eksempel sådan her:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Er det rigtigt?
Men hvis du har udført paginering på netop den måde, må jeg desværre sige, at du ikke har gjort det på den mest effektive måde.
Vil du udfordre mig? . , og bruger allerede de teknikker, jeg vil tale om i dag.
Nævn bare én backend-udvikler, der aldrig har brugt OFFSET og LIMIT til at udføre forespørgsler med paginering. I et MVP (Minimum Viable Product) og i projekter, hvor der bruges små datamængder, er denne tilgang helt anvendelig. Den, så at sige, "bare virker".
Men hvis du skal skabe pålidelige og effektive systemer fra bunden, er det vigtigt at tænke på effektiviteten af forespørgsler til de databaser, der bruges i sådanne systemer.
I dag vil vi tale om de problemer, der er forbundet med de udbredte (desværre) implementeringer af mekanismer til at udføre forespørgsler med paginering, og hvordan man kan opnå høj ydeevne, når man udfører sådanne forespørgsler.
Hvad er galt med OFFSET og LIMIT?
Som allerede nævnt, OFFSET og LIMIT fungerer glimrende i projekter, hvor man ikke skal arbejde med store datamængder.
Problemet opstår, når databasen vokser til en sådan størrelse, at den ikke længere kan rumme i serverens hukommelse. Men samtidig er det nødvendigt at bruge forespørgsler med paginering for at arbejde med denne database.
For this problem to manifest, a situation must arise where the DBMS resorts to inefficient full table scan operations when executing each paginated query (at the same time, there may be operations for inserting and deleting data, and we do not need outdated data!).
What is a "full table scan" (or "sequential table scan")? This is an operation where the DBMS sequentially reads each row of the table, that is, the data contained within it, and checks it against specified conditions. It is known that this type of table scanning is the slowest. The reason is that it involves a lot of input/output operations affecting the server's disk subsystem. The situation is worsened by the delays associated with working with data stored on disks and the fact that transferring data from disk to memory is a resource-intensive operation.
For example, you have records of 100,000,000 users, and you execute a query with the clause OFFSET 50,000,000. This means that the DBMS will have to load all these records (which we do not even need!), place them in memory, and only after that retrieve, say, 20 results as stated in the LIMIT.
Let's say it might look like this: "select rows from 50,000 to 50,020 out of 100,000". So, the system will first need to load 50,000 rows to execute the query. Do you see how much unnecessary work it has to perform?
If you don't believe it, take a look at the example I created using the capabilities of .
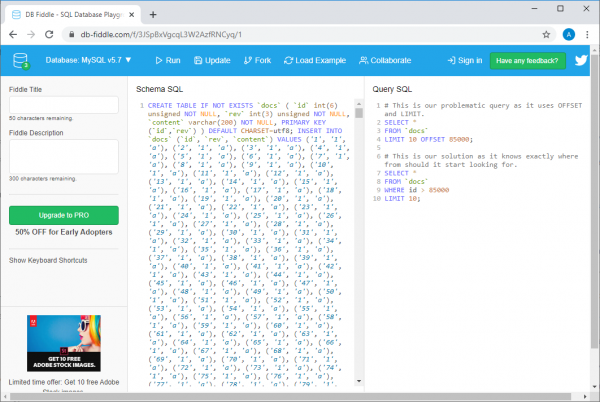
Example on db-fiddle.com
There, on the left, in the Schema SQL, there is code that inserts 100,000 rows into the database, and on the right, in the Query SQL, two queries are shown. The first, slow one, looks like this:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85,000;
And the second, which represents an efficient solution to the same task, looks like this:
SELECT *
FROM `docs`
WHERE id > 85,000
LIMIT 10;
To execute these queries, it is enough to click the button Kør øverst på siden. Når det er gjort, sammenligner vi oplysningerne om forespørgsels execution tid. Det viser sig, at en ineffektiv forespørgsel tager mindst 30 gange længere tid end at udføre den anden (fra kørsel til kørsel varierer denne tid, for eksempel kan systemet rapportere, at den første forespørgsel tog 37 ms, mens den anden tog 1 ms).
Og hvis dataene bliver større, vil det se endnu værre ud (for at overbevise dig selv — se på min med 10 millioner rækker).
Det, vi lige har diskuteret, skal give dig en vis forståelse af, hvordan forespørgsler til databaser faktisk bliver behandlet.
Tænk på, at jo større værdien er, OFFSET jo længere tid vil forespørgslen tage.
Hvad skal man i stedet bruge for kombinationen OFFSET og LIMIT?
I stedet for kombinationen OFFSET og LIMIT skal du bruge en konstruktion bygget efter denne skabelon:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Dette er en udførelse af forespørgslen med paginering baseret på en cursor (Cursor based pagination).
I stedet for at gemme de aktuelle OFFSET og LIMIT og overføre dem med hver forespørgsel, skal du gemme den sidst modtagne primære nøgle (normalt er dette ID) og LIMIT, hvilket resulterer i forespørgsler, der ligner den ovenfor nævnte.
Hvorfor? Sagen er, at når du eksplicit angiver identifieren for den sidst læste række, fortæller du din DBMS, hvor den skal begynde at søge efter de nødvendige data. Og søgningen vil, takket være brugen af nøglen, blive udført effektivt, systemet skal ikke forstyrres af rækker uden for det angivne interval.
Lad os tage et kig på følgende sammenligning af ydeevnen af forskellige forespørgsler. Her er en ineffektiv forespørgsel.
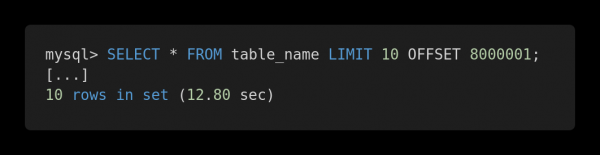
Langsom forespørgsel
Og her er en optimeret version af denne forespørgsel.
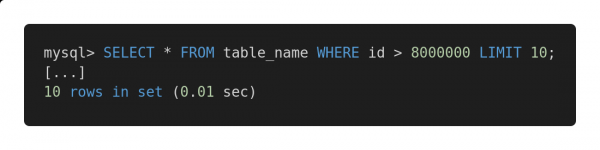
Hurtig forespørgsel
Begge forespørgsler returnerer præcist det samme datavolumen. Men den første tager 12,80 sekunder, mens den anden tager 0,01 sekunder. Kan du mærke forskellen?
Mulige problemer
For the proposed method of executing queries to work effectively, the table must have a column (or columns) containing unique, sequentially arranged indices, such as an integer identifier. In some specific cases, this can determine the success of such queries aimed at enhancing database performance.
Naturally, when constructing queries, one must consider the characteristics of the table's architecture and choose mechanisms that will perform best with the existing tables. For example, if you need to work with large volumes of related data in queries, you might find this interesting article.
If we are faced with the problem of lacking a primary key, for instance, if there is a table with a many-to-many relationship, then the traditional approach involving OFFSET og LIMIT, will certainly suit us. However, its application may lead to potentially slow queries. In such cases, I would recommend using a primary key with auto-increment, even if it is only needed for organizing paginated query execution.
If you are interested in this topic — , og — here are several useful materials.
Resumé
The main conclusion we can draw is that, regardless of the size of the databases in question, it is essential to analyze query execution speed. In our time, the scalability of solutions is extremely important, and if everything is designed correctly from the very beginning of building a system, it can save developers from many headaches in the future.
How do you analyze and optimize database queries?
Kilde: habr.com
