

Hello, Habr!
Vi minder om, at i takt med bogen om har vi udgivet et mindst lige så interessant værk om biblioteket .
Mens samfundet netop er ved at udforske grænserne for mulighederne med dette kraftfulde værktøj, er der for nylig udgivet en artikel, som vi gerne vil introducere jer for. På egen erfaring beskriver forfatteren, hvordan man kan skabe et distribueret datalager med Kafka Streams. God læsning!
Biblioteket Apache bruges over hele verden i erhvervslivet til distribueret streambehandling oven på Apache Kafka. En af de undervurderede aspekter ved dette framework er, at det tillader opbevaring af lokal tilstand genereret ud fra streambehandling.
I denne artikel vil jeg fortælle, hvordan vi i vores virksomhed har haft fordel af denne mulighed i udviklingen af et produkt til sikkerhed i skyapplikationer. Ved hjælp af Kafka Streams har vi skabt mikrotjenester med delt tilstand, som hver især fungerer som en redundant og højt tilgængelig kilde til pålidelig information om tilstanden af objekterne i systemet. For os er dette et skridt fremad hvad angår pålidelighed samt vedligeholdelsesvenlighed.
Hvis du er interesseret i en alternativ tilgang, der gør det muligt at anvende en central database til at understøtte den formelle tilstand af dine objekter - læs videre, det vil være interessant…
Hvorfor vi mente, det var tid til at ændre vores tilgang til arbejde med delt tilstand
Vi havde brug for at opretholde tilstanden af forskellige objekter baseret på rapporter fra agenter (for eksempel: var hjemmesiden blevet angrebet?). Inden vi skiftede til Kafka Streams stolede vi ofte på at administrere tilstanden med en central database (+ service API). Denne tilgang har sine ulemper: i bliver opretholdelse af konsistens og synkronisering en reel udfordring. Databasen kan blive flaskehals eller ende i og lide under uforudsigelighed.
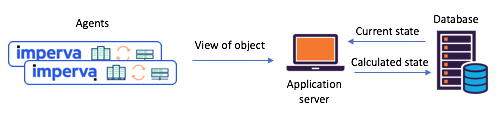
Illustration 1: typisk scenario med opdeling af tilstand, der blev mødt før skiftet til
Kafka og Kafka Streams: agenterne rapporterer deres opfattelser via API, den opdaterede tilstand beregnes gennem den centrale database.
Bliv bekendt med Kafka Streams – det er nu blevet nemt at skabe mikrotjenester med delt tilstand.
For about a year now, we have thoroughly reviewed our scenarios for working with shared state to tackle various issues. We immediately decided to try Kafka Streams—it's well-known for its scalability, high availability, and fault tolerance, as well as its rich streaming functionality (including transformations, with state preservation). This was exactly what we needed, not to mention how mature and reliable the messaging system in Kafka has become.
Each of the stateful microservices we created was based on an instance of Kafka Streams with a rather simple topology. It consisted of 1) a source 2) a processor with a persistent key-value store 3) a sink:
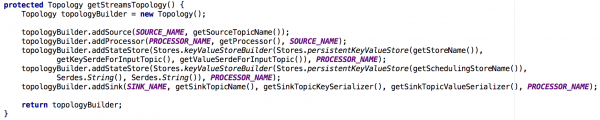
Illustration 2: the default topology of our streaming instances for stateful microservices. Note: there is also a store here that contains metadata about scheduling.
With this new approach, agents compose messages submitted to the initial topic, while consumers—say, a mail notification service—receive the computed shared state through the sink (output topic).
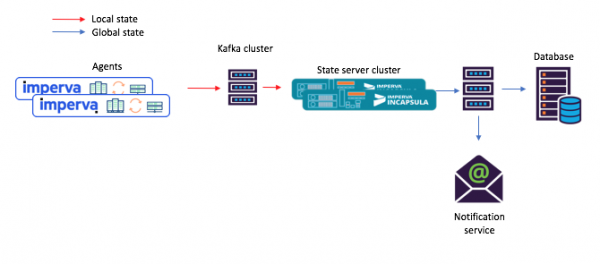
Illustration 3: a new example of a task stream for a scenario with shared microservices: 1) an agent generates a message that goes to the initial Kafka topic; 2) the stateful microservice (using Kafka Streams) processes it and writes the computed state to the final Kafka topic; after which 3) consumers accept the new state.
Hey, this built-in key-value store is actually very useful!
As mentioned above, our stateful topology contains a key-value store. We found several use cases for it, two of which are described below.
Option #1: using the key-value store in computations
Vores første nøgle-værdi-lager indeholdt hjælpeoplysninger, som vi havde brug for til vores beregninger. For eksempel blev den delte tilstand i nogle tilfælde bestemt ud fra princippet om "flertallets stemme". I lageret kunne vi holde alle de seneste rapporter fra agenter om tilstanden af et bestemt objekt. Derefter, når vi modtog en ny rapport fra en hvilken som helst agent, kunne vi gemme den, hente rapporterne fra alle de andre agenter om tilstanden af det samme objekt og gentage beregningen.
Nedenfor i illustration 4 vises, hvordan vi åbnede adgangen til nøgle-værdi-lageret for den behandlende metode af processoren, så vi derefter kunne behandle en ny besked.
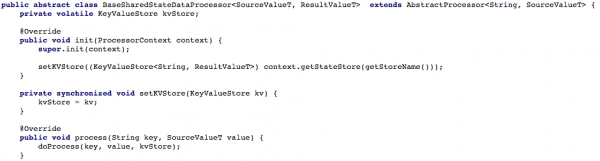
Illustration 4: Åbning af adgangen til nøgle-værdi-lageret for den behandlende metode af processoren (herefter skal der implementeres en metode i hvert scenarie, der arbejder med delt tilstand doProcess)
Mulighed #2: Oprettelse af CRUD API over Kafka Streams
Efter at have etableret vores grundlæggende opgaveflow begyndte vi at prøve at skrive et RESTful CRUD API til vores mikrotjenester med delt tilstand. Vi ønskede at kunne hente tilstanden af nogle eller alle objekter samt oprette eller slette tilstanden af et objekt (det er nyttigt til server-side support).
For at understøtte alle API'er til at hente tilstand, hver gang vi havde brug for at rekonstruere tilstanden under behandlingen, gemte vi den i det indbyggede nøgle-værdi-lager i lang tid. I så fald bliver det ganske enkelt at implementere et sådant API ved hjælp af en enkelt instans af Kafka Streams, som vist i den følgende kode:
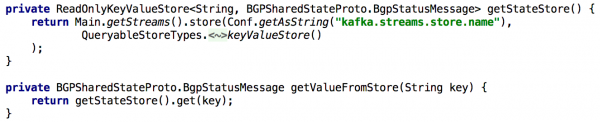
Illustration 5: Brug af det indbyggede nøgle-værdi-lager til at hente den forudberegnede tilstand af objektet
Opdatering af objektets tilstand via API er heller ikke svært at implementere. Grundlæggende kræver det kun at oprette en Kafka-producent, og med denne lave en skrivning, der indeholder den nye tilstand. Dette sikrer, at alle beskeder genereret gennem API'en behandles på samme måde som dem, der kommer fra andre producenter (f.eks. agenter).
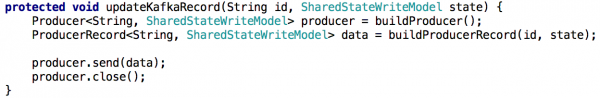
Illustration 6: Objektets tilstand kan angives ved hjælp af en Kafka-producent
En lille komplikation: Kafka har mange partitioner
Dernæst ønskede vi at fordele belastningen relateret til behandlingen og forbedre tilgængeligheden ved at give hver scenarie et cluster af mikrotjenester med delt tilstand. Opsætningen var lettere end forventet: efter at vi konfigurerede alle instanser til at arbejde med den samme app-ID (og de samme opstartservere), blev stort set alt andet udført automatisk. Vi angav også, at hvert oprindeligt emne skulle bestå af flere partitioner, så hver instans kunne tildeles et delmængde af disse partitioner.
Jeg vil også nævne, at det er almindeligt her at tage backup af tilstandsopbevaringen, så man f.eks. nemt kan overføre denne backup til en anden instans i tilfælde af gendannelse efter en fejl. For hver tilstandsopbevaring i Kafka Streams oprettes der et replikerbart emne med en ændringslog (hvor lokale opdateringer registreres). På den måde sikrer Kafka altid tilstandsopbevaringen. Derfor kan tilstandsopbevaringen i Kafka Streams hurtigt gendannes på en anden instans i tilfælde af en fejl i en specifik instans, hvor de relevante partitioner overføres. Vores tests viste, at dette kan gøres på få sekunder, selv når der er millioner af poster i opbevaringen.
At gå fra en mikrotjeneste med delt tilstand til et cluster af mikrotjenester gør det ikke så trivielt at implementere Get State API. I den nye situation indeholder tilstandsopbevaringen i hver mikrotjeneste kun en del af det samlede billede (de objekter, hvis nøgler blev vist på en bestemt partition). Vi måtte afgøre, hvilken instans der havde tilstanden af det objekt, vi havde brug for, og dette gjorde vi baseret på metadata fra strømmene, som vist nedenfor:
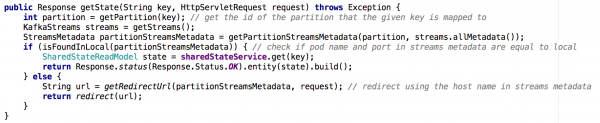
Illustration 7: ved hjælp af metadatastrømme bestemmer vi, hvilken instans vi skal anmode om tilstanden af det ønskede objekt; en lignende tilgang blev anvendt med GET ALL API
Hovedelementer
Tilstandsopbevaringer i Kafka Streams kan de facto fungere som en distribueret database,
- konstant replikeret i Kafka
- Oven på et sådant system er det nemt at opbygge et CRUD API
- Behandlingen af flere partitioner viser sig at være lidt mere kompleks
- Det er også muligt at tilføje et eller flere tilstandsopbevaringssystemer til den streamingtopologi til opbevaring af hjælpeoplysninger. Denne løsning kan anvendes til:
- Langtidsopbevaring af data, der er nødvendige for beregninger under streamingbehandling
- Langtidsopbevaring af data, som kan være nyttige ved næste initialisering af streaminginstansen
- mange andre ting…
Takket være disse og andre fordele er Kafka Streams fremragende til at støtte global tilstand i et sådant distribueret system som vores. Kafka Streams har vist sig at være meget pålidelig i produktion (siden dens implementering har vi næsten ikke mistet meddelelser), og vi er overbeviste om, at dens muligheder ikke stopper her!
Kilde: habr.com
