

Forord
Brugere, udviklere og administratorer af MS SQL Server møder ofte performanceproblemer med databaser eller databasesystemet generelt, derfor er overvågning af MS SQL Server meget relevant.
Denne artikel supplerer artiklen og vil dække nogle aspekter af overvågning af MS SQL Server, specifikt: hvordan man hurtigt identificerer, hvilke ressourcer der mangler, samt anbefalinger til konfiguration af tracer flags.
For at arbejde med de følgende scripts skal du oprette skemaet inf i den relevante database som følger:
Oprettelse af skemaet inf
use ;
go
create schema inf;
Metode til at identificere mangel på RAM
Det første tegn på mangel på RAM er, når instansen af MS SQL Server bruger al den tildelte RAM.
For dette formål opretter vi følgende udsigt inf.vRAM:
Oprettelse af udsigten inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						-- hvor meget RAM der er ledig på serveren i MB
		 , a.[RAM_Avail_Percent]					-- procent af ledig RAM på serveren
		 , a.[Server_physical_memory_Mb]				-- hvor meget RAM der er i alt på serveren i MB
		 , a.[SQL_server_committed_target_Mb]			-- hvor meget RAM der er tildelt til MS SQL Server i MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		-- hvor meget RAM MS SQL Server bruger lige nu i MB
		 , a.[SQL_RAM_Avail_Percent]				-- procent af ledig RAM for MS SQL Server i forhold til den samlede tildelte RAM til MS SQL Server
		 , a.[StateMemorySQL]						-- er der nok RAM til MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				-- procent af den tildelte RAM til MS SQL Server i forhold til den samlede RAM på serveren
		 -- er der nok RAM til serveren
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Advarsel' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Farligt' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/cast(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/cast(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/cast(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Advarsel' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Derefter kan man med følgende forespørgsel fastslå, at instansen af MS SQL Server bruger al den tildelte hukommelse:
select SQL_server_physical_memory_in_use_Mb, SQL_server_committed_target_Mb
from [inf].[vRAM];
Hvis værdien for SQL_server_physical_memory_in_use_Mb konstant er mindre end SQL_server_committed_target_Mb, bør man kontrollere ventestatistikken.
For at afgøre, om der er utilstrækkelig RAM via ventestatistikken, opretter vi visningen inf.vWaits:
Oprettelse af visningen inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --typenavn for venting
        [wait_time_ms] / 1000.0 AS [WaitS],--Den samlede ventetid for denne type i millisekunder. Denne tid inkluderer signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Den samlede ventetid for denne type i millisekunder uden signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Forskellen mellem signaleringstiden for den ventende tråd og tidspunkten for dens udførelse
        [waiting_tasks_count] AS [WaitCount],--Antal ventninger for denne type. Denne tæller øges hver gang der startes en ventning
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Den samlede ventetid for denne type i millisekunder. Denne tid inkluderer signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Den samlede ventetid for denne type i millisekunder uden signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Forskellen mellem signaleringstiden for den ventende tråd og tidspunkten for dens udførelse
	    [W1].[WaitCount] AS [WaitCount],--Antal ventninger for denne type. Denne tæller øges hver gang der startes en ventning
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- procent grænse
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
I dette tilfælde kan manglen på RAM bestemmes med følgende forespørgsel:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Her skal man være opmærksom på værdierne Percentage og AvgWait_S. Hvis de samlet set er betydelige, er der en meget stor sandsynlighed for, at RAM ikke er tilstrækkeligt for MS SQL Server-instansen. Betydelige værdier bestemmes individuelt for hvert system. Dog kan man starte med følgende kriterier: Percentage>=1 og AvgWait_S>=0.005.
For at vise indikatorerne i overvågningssystemet (f.eks. Zabbix) kan man oprette følgende to forespørgsler:
- hvor mange procent de forskellige ventetypes RAM optager (summen af alle sådanne ventetyper):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - hvor mange millisekunder de forskellige ventetypes RAM optager (det maksimale gennemsnit af alle sådanne ventetyper):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
            'PAGEIOLATCH_XX',
            'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Baseret på dynamikken i de opnåede værdier for disse to indikatorer kan man drage konklusioner om, hvorvidt RAM er tilstrækkeligt for MS SQL Server-instansen.
Metode til at identificere overbelastning på CPU
For at identificere en mangel på CPU-tid er det tilstrækkeligt at benytte systemvisningen sys.dm_os_schedulers. Her, hvis værdien runnable_tasks_count konstant er større end 1, er der en stor sandsynlighed for, at antallet af kerner ikke er tilstrækkeligt for MS SQL Server-instansen.
For at vise indikatoren i overvågningssystemet (f.eks. Zabbix) kan man oprette følgende forespørgsel:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
Baseret på dynamikken i de opnåede værdier for denne indikator kan man drage konklusioner om, hvorvidt CPU-tid (antallet af CPU-kerner) er tilstrækkeligt for MS SQL Server-instansen.
Det er dog vigtigt at huske, at forespørgsler kan anmode om flere tråde på én gang. Nogle gange kan optimereren ikke korrekt vurdere kompleksiteten af selve forespørgslen. Så kan der tildeles for mange tråde til forespørgslen, som ikke kan behandles samtidigt på det nuværende tidspunkt. Dette medfører også en type ventetid relateret til mangel på CPU-tid og en vækst i køen til planlæggere, der bruger specifikke CPU-kerner, dvs. vil antallet af runnable_tasks_count under sådanne forhold stige.
I så fald, før du øger antallet af CPU-kerner, er det nødvendigt korrekt at konfigurere egenskaberne for parallelisme for selve MS SQL Server-instansen, og fra version 2016 korrekt at justere egenskaberne for parallelisme for de nødvendige databaser:
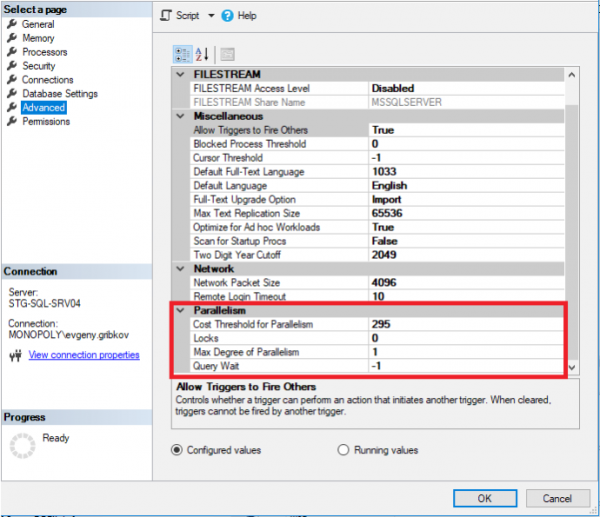
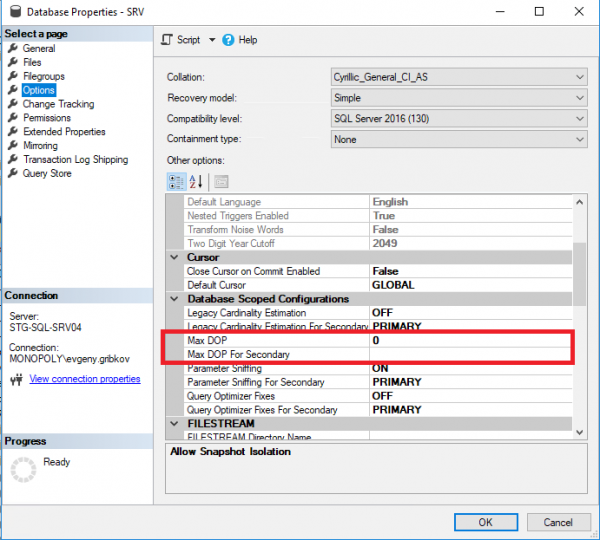
Her er det vigtigt at være opmærksom på følgende parametre:
- Max Degree of Parallelism - angiver det maksimale antal tråde, der kan tildeles hver forespørgsel (som standard er det 0 - kun begrænsningerne fra operativsystemet og MS SQL Server-versionen).
- Cost Threshold for Parallelism - vurderingsomkostningen for parallelisme (som standard er det 5).
- Max DOP - angiver det maksimale antal tråde, der kan tildeles hver forespørgsel på databaseniveau (men ikke mere end værdien af egenskaben «Max Degree of Parallelism») (som standard er det 0 - kun begrænsningerne fra operativsystemet og MS SQL Server-versionen samt begrænsningen i egenskaben «Max Degree of Parallelism» for den samlede MS SQL Server-instans).
Her er det umuligt at give en lige så god opskrift til alle tilfælde, dvs. det er nødvendigt at analysere tunge forespørgsler.
Af egen erfaring anbefaler jeg følgende handlingsforløb til OLTP-systemer for at konfigurere egenskaberne for parallelisme:
- først at forbyde parallelisme ved at indstille Max Degree of Parallelism til 1 for hele instansen.
- analysere de tungeste forespørgsler og vælge det optimale antal tråde til dem.
- indstille Max Degree of Parallelism til det optimalt valgte antal tråde fra punkt 2, samt for specifikke databaser indstille Max DOP-værdien, der er opnået fra punkt 2 for hver database.
- analysere de tungeste forespørgsler og identificere negative effekter fra multitrådning. Hvis der er nogen, skal Cost Threshold for Parallelism hæves.
For systemer såsom 1C, Microsoft CRM og Microsoft NAV er det i de fleste tilfælde passende at forbyde multitrådning.
Hvis Standard-udgaven er installeret, vil det i de fleste tilfælde være tilstrækkeligt at forbyde multitrådning, da denne udgave er begrænset i antallet af CPU-kerner.
Den ovenfor beskrevne algoritme er ikke egnet til OLAP-systemer.
Ud fra egen erfaring anbefaler jeg følgende handlingsalgoritme for OLAP-systemer til indstilling af egenskaber for parallelisme:
- analysere de tungeste forespørgsler og vælge det optimale antal tråde til dem.
- Sæt Max Degree of Parallelism til det optimale antal tråde, som er fundet fra punkt 1, og indstil Max DOP-værdien, fundet fra punkt 1, for hver specifik database.
- Analyser de mest krævende forespørgsler og identificer den negative effekt af begrænsning af parallelisme. Hvis der er en, skal du enten nedsætte værdien af Cost Threshold for Parallelism eller gentage trin 1-2 i denne algoritme.
Så for OLTP-systemer bevæger vi os fra enkelttrådning til multitrådning, mens vi for OLAP-systemer bevæger os fra multitrådning til enkelttrådning. På denne måde kan optimale indstillinger for parallelisme findes både for den specifikke database og for hele MS SQL Server-instansen.
Det er også vigtigt at forstå, at indstillingerne for egenskaber for parallelisme skal ændres over tid baseret på resultaterne af overvågning af ydeevnen i MS SQL Server.
Anbefalinger til indstilling af sporingsflager
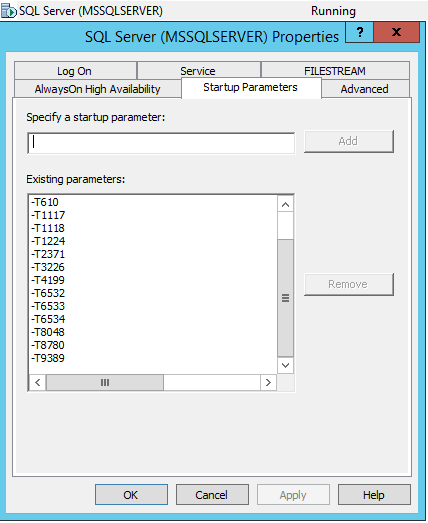
Ud fra egen erfaring og mine kollegers erfaring anbefaler jeg at indstille følgende sporingsflager ved opstart af MS SQL Server-tjenesten for versionerne 2008-2016:
- 610 — Reducering af loggen ved indsættelse i indekserede tabeller. Kan være hjælpsom ved indsættelse i tabeller med et stort antal poster og mange transaktioner, samt ved hyppige lange ventetider på WRITELOG ved ændringer i indeksene.
- 1117 — Hvis filen i filgruppen opfylder kravene til den automatiske vækstgrænse, vil alle filer i filgruppen blive forstørret.
- 1118 — Tvinger alle objekter til at ligge i forskellige extent (forbud mod blandede extent), hvilket minimerer behovet for at scanne SGAM-siden, som bruges til at spore blandede extent.
- 1224 — Deaktiverer samling af låse baseret på antallet af låse. Dog kan for aktiv brug af hukommelsen aktivere samling af låse.
- 2371 — Ændrer tærsklen for fast automatisk opdatering af statistik til tærsklen for dynamisk automatisk opdatering af statistik. Vigtigt for opdatering af forespørgselsplaner med store tabeller, hvor en forkert bestemmelse af antallet af poster fører til fejlslagne udførelsesplaner.
- 3226 — Undertrykker meddelelser om vellykket gennemførelse af backup i fejljournalen.
- 4199 — Aktiverer ændringer i forespørgselsoptimeringssystemet, der er udgivet i kumulative opdateringspakker og opdateringspakker til SQL Server.
- 6532-6534 — Aktiverer forbedret ydeevne ved forespørgselsoperationer med rumlige datatyper.
- 8048 — Omformer hukommelsesobjekter, der er partitioneret efter NUMA, til at være partitioneret efter CPU.
- 8780 — Aktiverer en ekstra tidsallokering til at generere en forespørgselsplan. Nogle forespørgsler uden denne flag kan blive afvist, da de ikke har en forespørgselsplan (meget sjældent problem).
- 8780 — 9389 — Aktiverer en ekstra dynamisk midlertidigt tildelt hukommelsesbuffer til batch-operationer, hvilket gør det muligt for batch-operatoren at anmode om ekstra hukommelse og undgå at flytte data til tempdb, hvis ekstra hukommelse er tilgængelig.
Det er også nyttigt at aktivere sporingsflag 2301 før version 2016, som aktiverer optimering af udvidet beslutningssupport og dermed hjælper med at vælge mere præcise forespørgselsplaner. Men siden version 2016 har det ofte en negativ indvirkning på den samlede udførelsestid for forespørgsler.
For systemer med meget mange indekser (f.eks. for 1C databaser) anbefaler jeg også at aktivere sporingsflag 2330, som deaktiverer indsamling af indeksernes brug, hvilket generelt har en positiv effekt på systemet.
Læs mere om sporingsflagene.
Det er vigtigt også at overveje versioner og builds af MS SQL Server i det ovenstående link, da for nyere versioner nogle sporingsflag er aktiveret som standard eller ikke giver nogen effekt.
Sporingsflag kan aktiveres og deaktiveres ved hjælp af kommandoerne DBCC TRACEON og DBCC TRACEOFF henholdsvis. Se mere detaljeret.
For at få status på sporingsflagene kan kommandoen DBCC TRACESTATUS bruges:
For trace flags to be enabled on the startup of the MS SQL Server service, you need to access the SQL Server Configuration Manager and add the trace flag data through -T in the service properties.
Resumé
This article has discussed some aspects of monitoring MS SQL Server that can promptly identify a lack of RAM and free CPU time, as well as several other less obvious issues. The most commonly used trace flags were reviewed.
Kilder:
»
»
»
»
»
»
»
Kilde: habr.com
