

LINQ blev en del af .NET som et nyt kraftfuldt sprog til datamanipulation. LINQ to SQL tillader, som en del af det, en bekvem kommunikation med databaser, for eksempel ved hjælp af Entity Framework. Dog glemmer udviklere ofte at tjekke, hvilken SQL-forespørgsel der vil blive genereret af den queryable provider, i dit tilfælde — Entity Framework.
Lad os se på to hovedpunkter med et eksempel.
For dette opretter vi en database kaldet Test i SQL Server, og vi opretter to tabeller ved hjælp af følgende forespørgsel:
Oprettelse af tabeller
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Nu fylder vi tabellen Ref ved at køre følgende script:
Udfyldning af tabellen Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Tilsvarende fylder vi tabellen Customer ved hjælp af følgende script:
Udfyldning af tabellen Customer
BRUG [TEST]
GÅ

DEKLARER @ind INT=1;
DEKLARER @ind_ref INT=1;

MENS(@ind<=12000000)
BEGIN
	HVIS(@ind%3=0) SÆT @ind_ref=1;
	ELLER HVIS (@ind%5=0) SÆT @ind_ref=2;
	ELLER HVIS (@ind%7=0) SÆT @ind_ref=3;
	ELLER HVIS (@ind=0) SÆT @ind_ref=4;
	ELLER HVIS (@ind=0) SÆT @ind_ref=5;
	ELLER HVIS (@ind=0) SÆT @ind_ref=6;
	ELLER HVIS (@ind=0) SÆT @ind_ref=7;
	ELLER HVIS (@ind=0) SÆT @ind_ref=8;
	ELLER HVIS (@ind=0) SÆT @ind_ref=9;
	ELLER HVIS (@ind=0) SÆT @ind_ref=10;
	ELLER HVIS (@ind=0) SÆT @ind_ref=11;
	ELLER SÆT @ind_ref=@ind90000;

	INDSTIK [dbo].[Customer]
	 ([ID]
	 ,[Navn]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 VÆLG
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SÆT @ind=@ind+1;
END
GÅ
Dermed har vi fået to tabeller, hvoraf den ene indeholder mere end 1 million datarækker, og den anden over 10 millioner datarækker.
Nu skal der oprettes et testprojekt i Visual Studio: Visual C# Console App (.NET Framework):
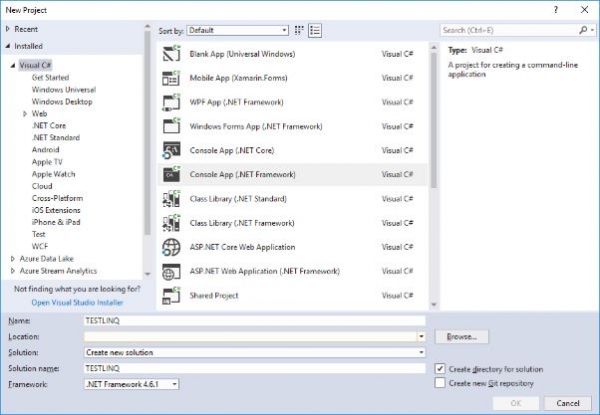
Dernæst skal der tilføjes et bibliotek til Entity Framework for at interagere med databasen.
For at tilføje det, højreklik på projektet og vælg 'Administrer NuGet-pakker' i kontekstmenuen:
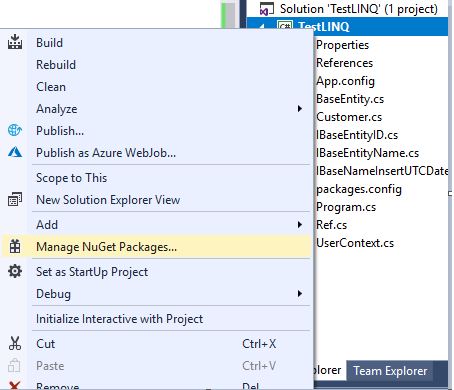
Skriv derefter 'Entity Framework' i søgefeltet i det åbne NuGet-pakkehåndteringsvindue, vælg pakken Entity Framework og installer den:
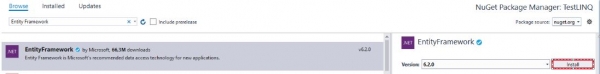
Derefter, i App.config-filen, efter at have lukket elementet configSections, skal du tilføje følgende blok:
I connectionString skal forbindelsesstrengen skrives ind.
Lad os nu oprette tre grænseflader i separate filer:
- Implementering af grænsefladen IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementering af grænsefladen IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementering af grænsefladen IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Og i en separat fil opretter vi grundklassen BaseEntity for vores to enheder, som vil inkludere fælles felter:
Implementering af grundklassen BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Derefter, i separate filer, opretter vi vores to enheder:
- Implementering af klassen Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementering af klassen Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer : BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Lad os nu oprette konteksten UserContext i en separat fil:
Implementering af klassen UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Vi har nu en klar løsning til at udføre tests for optimering med LINQ til SQL via EF for MS SQL Server:
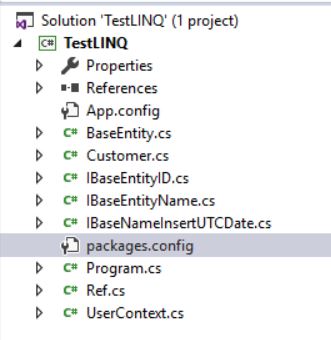
Lad os nu indsætte følgende kode i Program.cs-filen:
Fil Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Lad os køre vores projekt.
Ved afslutningen af arbejdet vil der blive vist:
Den genererede SQL-forespørgsel
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Det vil sige, at LINQ-forespørgslen genererede en ret acceptabel SQL-forespørgsel til MS SQL Server.
Lad os nu ændre betingelsen fra OG til ELLER i LINQ-forespørgslen:
LINQ-forespørgsel
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Og lad os igen køre vores applikation.
Udførelsen vil fejle med en fejl relateret til overskridelse af timeout for kommandoen på 30 sekunder:
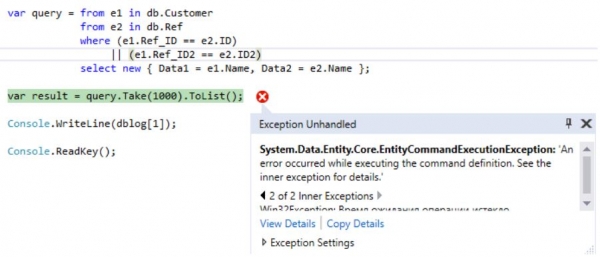
Hvis vi ser på hvilken forespørgsel der blev genereret af LINQ:
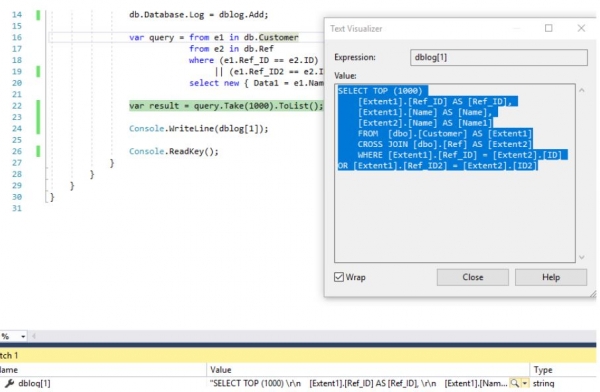
, kan vi bekræfte, at udtrækningen sker gennem den cartesisk produkt af to mængder (tabeller):
Den genererede SQL-forespørgsel
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Lad os omskrive LINQ-forespørgslen som følger:
Optimeret LINQ-forespørgsel
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Så vil vi få følgende SQL-forespørgsel:
SQL-forespørgsel
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Desværre kan der kun være én betingelse for sammenkobling i LINQ-forespørgsler, så det er muligt at lave en ækvivalent forespørgsel gennem to forespørgsler for hver betingelse med efterfølgende sammenføjning via Union for at fjerne dubletter blandt rækkerne.
Ja, forespørgslerne vil generelt set være ikke-ækvivalente, da der kan returneres fuldstændige dubletter af rækker. I virkeligheden er fuldstændige dublerende rækker dog ikke nødvendige, og man forsøger at slippe af med dem.
Lad os nu sammenligne udførelsesplanerne for disse to forespørgsler:
- for CROSS JOIN er den gennemsnitlige udførelsestid 195 sekunder:

- for INNER JOIN-UNION er den gennemsnitlige udførelsestid mindre end 24 sekunder:

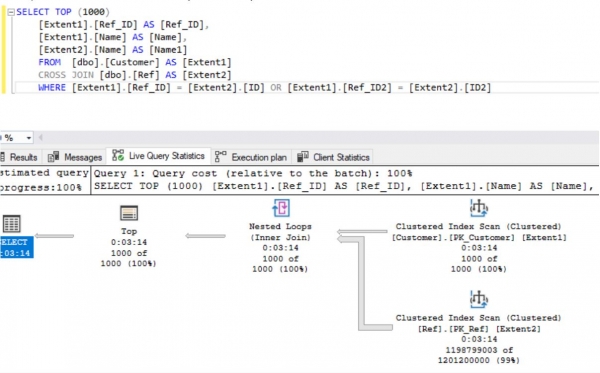
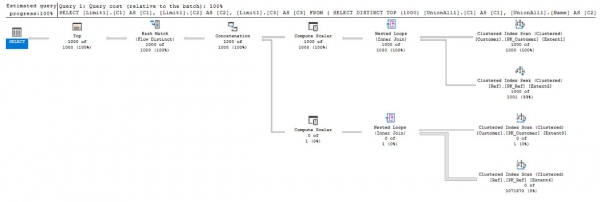
Som det fremgår af resultaterne, fungerer den optimerede LINQ-forespørgsel med to tabeller med millioner af poster betydeligt hurtigere end den ikke-optimerede.
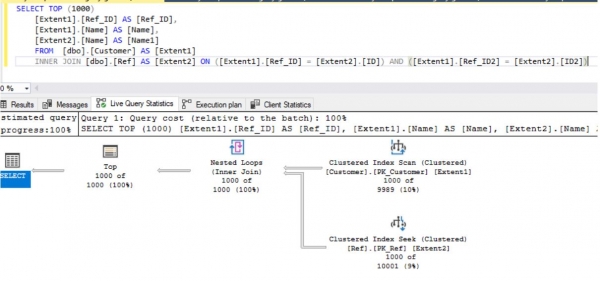
For varianten med AND i betingelserne for LINQ-forespørgslen:
LINQ-forespørgsel
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
vil næsten altid generere den korrekte SQL-forespørgsel, som i gennemsnit vil blive udført på cirka 1 sekund:
Også for manipulationer af LINQ til objekter i stedet for forespørgslen:
LINQ-forespørgsel (1. variant)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kan man bruge forespørgslen:
LINQ-forespørgsel (2. variant)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
hvor:
Definition af to arrays
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, og typen Para defineres som følger:
Definition af typen Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Dermed har vi set nogle aspekter af optimering af LINQ-forespørgsler til MS SQL Server.
Desværre glemmer selv erfarne og førende .NET-udviklere, at de skal forstå, hvad der sker bag kulisserne i de instruktioner, de bruger. Ellers bliver de konfigurerere og kan lægge en tidsindstillet bombe til fremtidige problemer, både ved skalering af softwareløsningen og ved mindre ændringer i miljøets ydre forhold.
Der blev også udført en lille gennemgang og .
Kildematerialerne til test-projektet, oprettelsen af tabeller i databasen TEST, samt udfyldningen af disse tabeller findes .
I dette repo i mappen Plans findes planer for udførelse af forespørgsler med betingelser ELLER.
Kilde: habr.com
