

Vi udviklede DevOps så godt, vi kunne. Vi var 8 personer, og Vasha var den bedste til Windows. Pludselig forlod Vasha, og jeg fik ansvaret for at føre et nyt projekt, der skulle levere Windows-udvikling. Da jeg spredte hele stakken af Windows-udvikling ud på bordet, indså jeg, at situationen var problematisk…
Sådan begynder historien Alexander Sinchivnov og få en fungerende kommando. . Da virksomhedens førende specialist i Windows forlod, stillede Alexander sig selv spørgsmålet, hvad han nu skulle gøre. Selvfølgelig skulle han overgå til Linux! Alexander vil fortælle, hvordan han lykkedes med at skabe et præcedens og overføre en del af Windows-udviklingen til Linux ved hjælp af et projekt med 100.000 slutbrugere.
Hvordan kan man nemt og ubesværet levere et projekt i RPM ved brug af TFS, Puppet, Linux .NET core? Hvordan kan man opretholde versionering af projektets database, hvis udviklingen aldrig har hørt om Postgres og Flyway, og deadline er i overmorgen? Hvordan integreres man med Docker? Hvordan motiverer man .NET-udviklere til at give afkald på Windows og smoothies til fordel for Puppet og Linux? Hvordan løser man ideologiske konflikter, hvis man ikke har hverken kræfter, vilje eller ressourcer til at vedligeholde Windows i produktionen? Om dette, samt Web Deploy, test, CI, brugen af TFS i eksisterende projekter, og selvfølgelig om de ødelagte støttepiller og fungerende løsninger, tales der i transkriptionen af Alexanders præsentation.
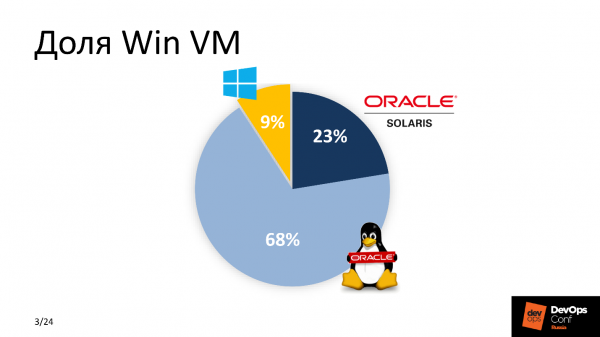
Så Vasha forlod, opgaven lå på mig, udviklerne ventede utålmodigt. Da jeg endelig indså, at jeg ikke kunne få Vasha tilbage, gik jeg i gang. Først vurderede jeg procentdelen af Windows VM i vores park. Resultatet var ikke til fordel for Windows.
Da vi aktivt udvikler DevOps, indså jeg, at jeg måtte ændre tilgangen til udskiftningen af den nye applikation. Der var kun én løsning - at overføre alt muligt til Linux. Google hjalp mig - på det tidspunkt var .Net allerede blevet porteret til Linux, og jeg indså, at det var løsningen!
Hvorfor .NET core i forbindelse med Linux?
Der var flere grunde til det. Mellem at «betale penge» og «ikke betale» vil de fleste vælge det andet - ligesom jeg. Licensen til MSDB koster omkring 1.000 $, og vedligeholdelse af parken af Windows virtuelle maskiner koster hundredvis af dollars. For en stor virksomhed er det store omkostninger. Derfor besparelser — er den første grund. Ikke den vigtigste, men en af de væsentlige.
Windows virtuelle maskiner kræver flere ressourcer end deres Linux-brødre - de er tunge. I betragtning af skalaen af en stor virksomhed valgte vi Linux.
Systemet integreres nemt i den eksisterende CI. Vi betragter os som progressive DevOps'ere, bruger Bamboo, Jenkins og GitLab CI, så størstedelen af vores arbejde kører på Linux.
Den sidste årsag er bekvem vedligeholdelse. Vi havde brug for at sænke indgangsbarriererne for "vedligeholdere" - folk, der forstår den tekniske del, sikrer driften og vedligeholder tjenesterne fra anden linje. De var allerede bekendte med Linux-stakken, så det var meget nemmere for dem at forstå det nye produkt, vedligeholde og supportere det, end at bruge ekstra ressourcer på at sætte sig ind i tilsvarende funktionalitet for Windows-platforme.
Krav
Først og fremmest er bekvemmeligheden ved den nye løsning for udviklerne. Ikke alle af dem var klar til ændringer, især efter at have hørt ordet Linux. Udviklerne ønsker deres elskede Visual Studio, TFS med automatiserede tests til builds og smoothies. Hvordan leveringen til produktionen sker, er ikke vigtigt for dem. Derfor besluttede vi at bevare den velkendte proces og lade Windows-udviklingen forblive uændret.
Det nye projekt skal integreres i den eksisterende CI. Railsene var allerede på plads, og alt arbejde skulle udføres med hensyntagen til konfigurationsstyringssystemets parametre, de vedtagne leveringsstandarder og overvågningssystemerne.
Simplicitet i vedligeholdelse og drift, som en betingelse for den minimale indgangsbarriere for alle nye deltagere fra forskellige afdelinger og supportafdelingen.
Deadline - i går.
Windows-udviklingsgruppen
Hvad arbejdede Windows-teamet så med?
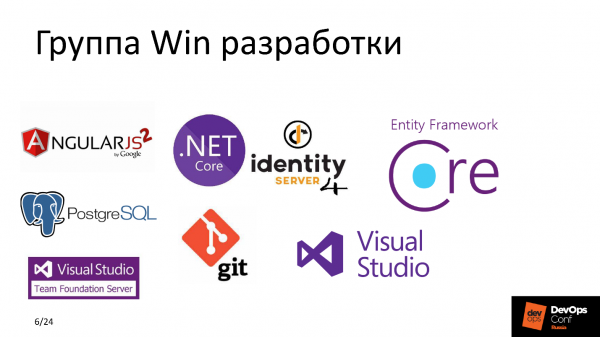
Nu kan jeg med sikkerhed sige, at IdentityServer4 — det er et fantastisk gratis alternativ til ADFS med lignende funktionalitet, eller at Entity Framework Core — er et paradis for udvikleren, hvor du ikke behøver at bekymre dig om at skrive SQL-scripts, men i stedet kan beskrive databaseforespørgsler i OOP-termer. Men dengang, under diskussionen af handlingsplanen, så jeg på dette stak som på sumerisk kileskrift og genkendte kun PostgreSQL og Git.
På det tidspunkt brugte vi aktivt Puppet som konfigurationsstyringssystem. I de fleste af vores projekter anvendte vi GitLab CI, Elastic, balancerede højbelastede tjenester ved hjælp af HAProxy, holdt øje med alt ved hjælp af Zabbix, sættet Grafana og Prometheus, Jaeger, og alt dette kørte på hardware HP c ESXi og få en fungerende kommando. VMware. Alle kender det - klassikeren i genren.
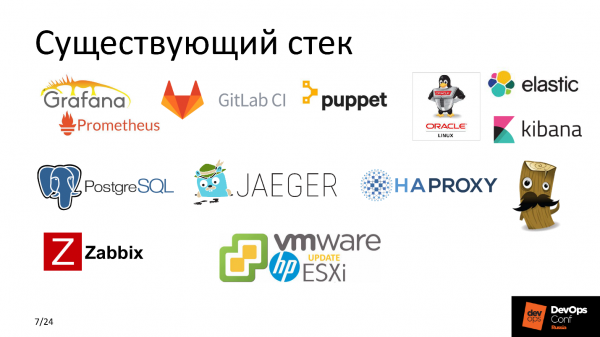
Lad os se og forsøge at forstå, hvad der skete, før vi begyndte med alle disse indgreb.
Hvad der skete
TFS er et ret kraftfuldt system, der ikke kun leverer kode fra udvikleren til den endelige produktionsmaskine, men også har et sæt til meget fleksibel integration med forskellige tjenester - for at sikre CI på tværplatformsniveau.
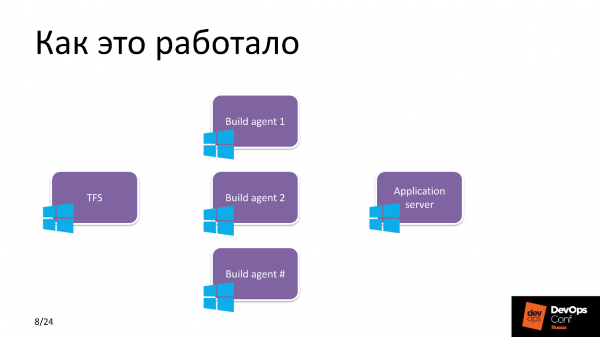
Tidligere var det blot et hav af vinduer. TFS brugte flere build-agenter, hvor mange projekter blev samlet. I hver agent var der 3-4 workere for at parallellisere opgaverne og optimere processen. Derefter, i henhold til udgivelsesplanerne, leverede TFS den friskbagte build til Windows-applikationsserveren.
Hvor vi ønskede at komme hen
Til levering og udvikling bruger vi TFS, og vi kører applikationen på Linux-applikationsserveren, og mellem dem er der en slags magi. Denne Magic Box er essensen af det kommende arbejde. Før jeg går videre med at dele det op, vil jeg tage et skridt til siden og sige et par ord om applikationen.
Projekt
Applikationen giver funktionalitet til at håndtere forudbetalte kort.
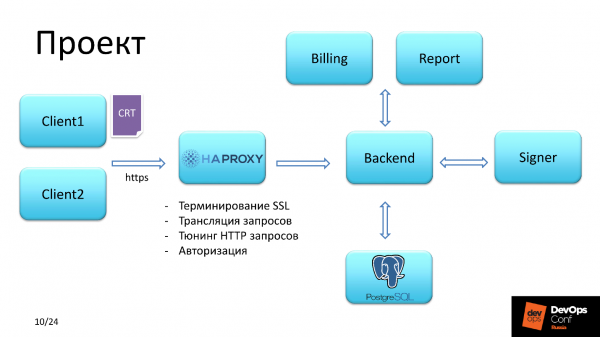
Client
Der var to typer brugere. Første fik adgang ved at autentificere sig med et SSL SHA-2 certifikat. Den den anden hadde adgang via login og adgangskode.
HAProxy
Derefter blev klientens anmodning sendt til HAProxy, som havde følgende opgaver:
- primær autorisering;
- terminering af SSL;
- tuning af HTTP-anmodninger;
- oversættelse af anmodninger.
Kontrol af klientens certifikat foregik i kæden. Vi - myndighed og vi kan tillade os det, da vi selv udsteder certifikater til servicekunderne.
Bemærk den tredje punkt, vi vil vende tilbage til det om lidt.
Backend
Backend blev planlagt til at blive lavet på Linux. Backend interagerer med databasen, henter den nødvendige liste over privilegier, og derefter, afhængigt af hvilke privilegier den autoriserede bruger har, giver adgang til at underskrive finansielle dokumenter og sende dem til udførelse, eller generere en eller anden rapport.
Besparelser med HAProxy
Udover de to kontekster, som hver af klienterne bevægede sig igennem, var der også konteksten identity. IdentityServer4 som netop tillader autentificering, det er et gratis og kraftfuldt alternativ til ADFS — Active Directory Federation Services.
Anmodningen i identity blev behandlet i flere trin. Det første trin - client blev sendt til backend, som udvekslede data med denne server og kontrollerede for tilstedeværelsen af en token for klienten. Hvis den ikke blev fundet, blev forespørgslen sendt tilbage til den sammenhæng, som den kom fra, men allerede med en omdirigering, og med omdirigeringen gik den til identity.
Det andet skridt var, at forespørgslen kom til login-siden i IdentityServer, hvor klienten registrerede sig, og i IdentityServer-databasen blev den eftertragtede token oprettet.
Det tredje skridt var, at klienten blev omdirigeret tilbage til den sammenhæng, som den kom fra.
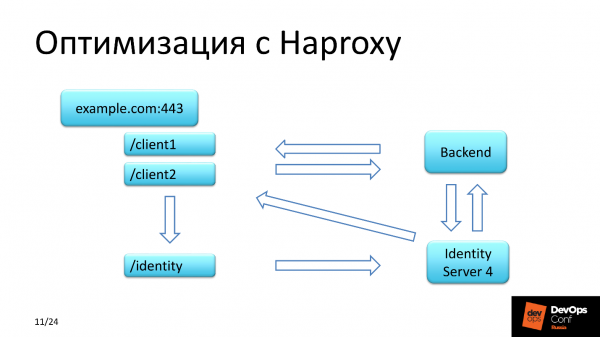
IdentityServer4 har en funktion: svaret på den omvendte forespørgsel returneres via HTTP. Uanset hvor meget vi kæmpede med serverkonfigurationen, hvor meget vi studerede dokumentationen, fik vi hver gang den oprindelige klientforespørgsel med en URL, der kom via HTTPS, og IdentityServer returnerede den samme sammenhæng, men med HTTP. Vi var chokerede! Og vi mappede alt dette gennem identity-sammenhængen på HAProxy, hvor vi i headere måtte ændre protokollen fra HTTP til HTTPS.
Hvad er forbedringen, og hvor sparede vi?
Vi sparede penge ved at bruge en gratis løsning til godkendelse af en gruppe brugere, ressourcer, da vi ikke kørte IdentityServer4 som en separat node i et separat segment, men brugte det sammen med backend'en på den samme server, hvor applikationens backend kører.
Hvordan det skal fungere
Så, som jeg lovede - Magic Box. Vi forstår allerede, at vi garanteret bevæger os mod Linux. Lad os formulere de specifikke opgaver, der krævede løsning.
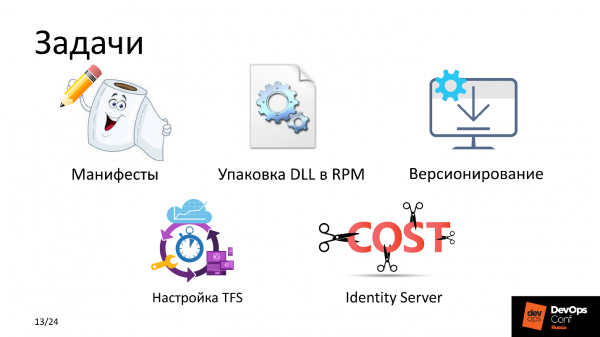
Puppet-manifest. For at levere og administrere konfigurationen af tjenesten og applikationen var det nødvendigt at skrive fede opskrifter. Ruller med en blyant viser tydeligt, hvor hurtigt og effektivt dette blev gjort.
Leveringsmetode. Standarden er RPM. Alle forstår, at man ikke kan undvære det i Linux, men selve projektet efter kompilering bestod af et sæt kørbare DLL-filer. Der var omkring 150, projektet var ret tungt. Den eneste harmoniske løsning var at pakke dette binære i et RPM og derfra implementere applikationen.
Versionering. Vi skulle udgive meget ofte, og derfor skulle vi finde ud af, hvordan vi skulle danne pakke-navnet. Dette er et integrationsspørgsmål med TFS. Vores Build-agent var på Linux. Når TFS sender en opgave til behandleren - worker - på Build-agenten, sender den også et bånd af variabler, som kommer ind i miljøet af behandlingsprocessen. I disse miljøvariabler overføres navnet på Build, versionsnavnet og andre variabler. Læs mere om dette i afsnittet "opbygning af RPM-pakke".
TFS-opsætning bestod i opsætning af Pipeline. Tidligere samlede vi alle Windows-projekter på Windows-agenter, men nu kommer Linux-agenten - Build-agenten - som skal inkluderes i byggegruppen, beriges med nogle artefakter og specificeres hvilken type projekter der skal samles på denne Build-agent, og hvordan man modifiserer Pipeline.
IdentityServer. ADFS er ikke vores vej, vi støtter Open Source.
Lad os se nærmere på komponenterne.
Magic Box
Den består af fire dele.
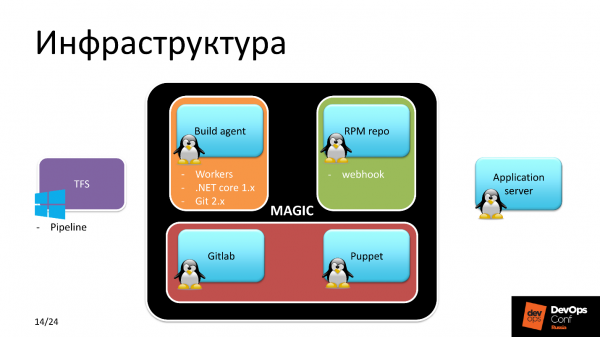
Linux Build-agent. Linux, fordi vi udvikler til det - logisk. Denne del blev udført i tre trin.
- Konfigurer workerne og ikke kun én, da der var planlagt distribueret arbejde på projektet.
- Installer .NET Core 1.x. Hvorfor netop 1.x, når 2.0 allerede er tilgængelig i det standardrepository? Fordi, da vi startede udviklingen, var den stabile version 1.09, og projektet blev besluttet at blive lavet til det.
- Git 2.x.
RPM-repository. RPM-pakkerne skulle opbevares et sted. Det var meningen, at vi skulle bruge det samme virksomhedsRPM-repository, som var tilgængeligt for alle Linux-hosts. Sådan gjorde vi det. På serveren hvor repository'en er oprettet webhook som downloader den nødvendige RPM-pakke fra det angivne sted. Versionen af pakken blev meddelt webhook'en af Build-agenten.
GitLab. Opmærksomhed! GitLab bruges her ikke af udviklerne, men af driftstabellen til versionskontrol af applikationen, versionerne af pakkerne, overvågning af tilstanden på alle Linux-maskiner, og her opbevares opskriften - alle Puppet-manifestationer.
Puppet —— håndterer alle tvister og leverer netop den konfiguration, vi ønsker, fra Gitlab.
Lad os dykke ned. Hvordan sker leveringen af DLL til RPM?
Levering af DLL til RPM
Lad os sige, at vi har en rockstjerne udvikler på .NET. Han bruger Visual Studio og opretter en release-gren. Derefter uploader han den til Git, og Git her er en TFS-enhed, det vil sige, at det er repository'et for applikationen, som udvikleren arbejder med.
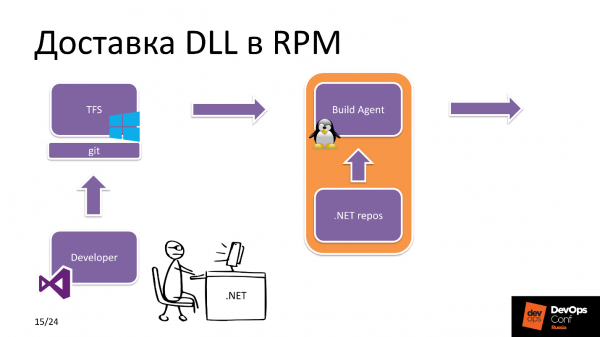
Hereafter, TFS sees that a new commit has arrived. Which application? In the TFS settings, there is a label indicating what resources a particular Build agent has. In this case, it sees that we are building a .NET Core project and selects a Linux Build agent from the pool.
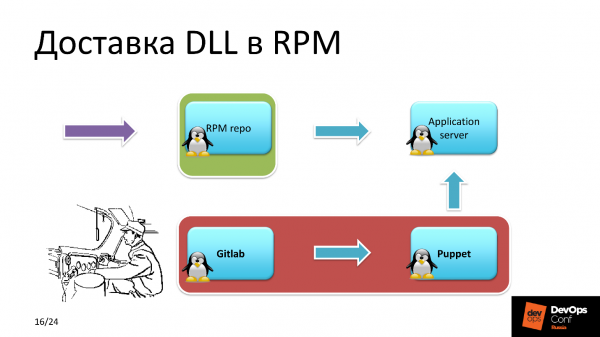
The Build agent receives the sources, fetches the necessary dependencies from the .NET repository, npm, etc., and after building the application and subsequent packaging, sends the RPM package to the RPM repository.
On the other hand, the following occurs. An engineer from the operations department is directly involved in deploying the project: changing package versions in Hiera in the repository where the application recipe is stored, after which Puppet triggers Yum, retrieves the new package from the repository, and the new version of the application is ready for use.
In theory, it all sounds simple, but what happens inside on the Build agent?
Packaging DLL RPM
The project sources have been received, and a build task from TFS is assigned. The Build agent starts building the project from the sources.The assembled project becomes available in the form of multiple DLL files, which are packed into a zip archive to reduce the load on the file system.
The ZIP archive is thrown into the RPM package build directory. Next, a Bash script initializes environment variables, finds the Build version, the project version, the path to the build directory, and launches RPM-build. Upon completion of the build, the package is published to the local repository, which is located on the Build agent.
Next, from the Build agent to the server in the RPM repository a JSON request is sent indicating the version name and build. The webhook I mentioned earlier fetches this package from the local repository on the Build agent and makes the new build available for installation.
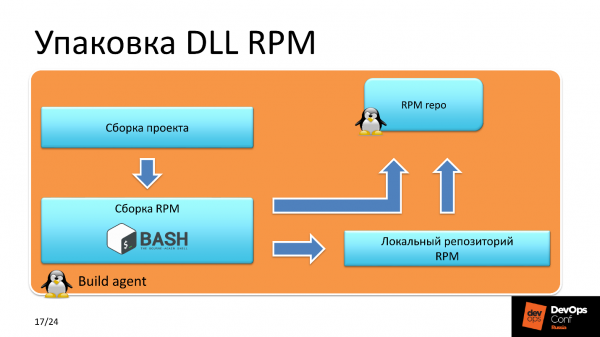
Why this specific package delivery scheme to the RPM repository? Why can’t we immediately send the built package to the repository? The point is that this condition ensures security. This scenario limits the possibility of unauthorized uploads of RPM packages by outsiders to the server, which is accessible to all Linux machines.
Database versioning
At a meeting with development, it turned out that the guys preferred MS SQL, but in most non-Windows projects, we had already been using PostgreSQL extensively. Since we decided to move away from all paid options, we started using PostgreSQL here as well.
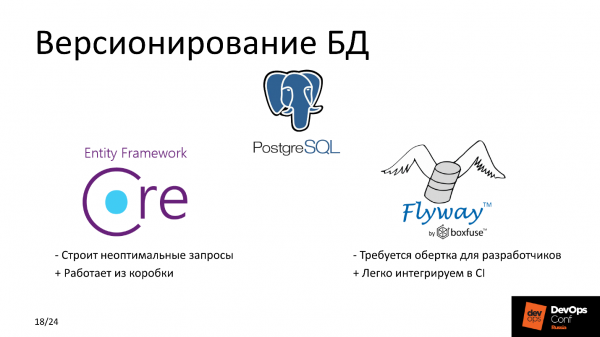
I denne del vil jeg fortælle, hvordan vi implementerede versionering af databaser og hvordan vi valgte mellem Flyway og Entity Framework Core. Lad os se på deres fordele og ulemper.
Ulemper
Flyway fungerer kun i en retning, vi kan ikke rulle tilbage — det er en betydelig ulempe. Man kan sammenligne med Entity Framework Core på andre parametre — set fra udviklerens perspektiv. Du husker jo, at vi satte dette i højsædet, og det primære kriterium var ikke at ændre noget for Windows-udvikling.
For Flyway krævede vi en eller anden wrapper, så folk ikke skulle skrive SQL-forespørgsler. De har det meget nemmere med at operere i termer af OOP. Vi skrev instruktioner til arbejdet med databaseobjekter, dannede SQL-forespørgslen og fik den udført. Den nye databaseversion er klar, den har kørt — alt er godt, alt fungerer.
Entity Framework Core har en ulempe — under høj belastning genererer den ikke optimale SQL-forespørgsler, og faldet i databasen kan være betydeligt. Men da vi ikke har en højtydende tjeneste, måler vi ikke belastningen i hundreder af RPS, vi accepterede disse risici og delegerede problemet til fremtiden.
Fordele
Entity Framework Core den fungerer ud af boksen og er praktisk for udviklere, mens Flyway nemt integreres i eksisterende CI. Men vi ønsker jo at gøre det nemt for udviklerne :)
Proceduren for deployment
Puppet ser, at der kommer en ændring i versionen af pakkerne, herunder den, der ansvarer for migration. Først installeres pakken, som indeholder migrationsscripts og funktionalitet knyttet til databasen. Derefter genstarter applikationen, der arbejder med databasen. Dernæst installeres de resterende komponenter. Rækkefølgen af pakkeinstallationer og applikationsstart er beskrevet i Puppet-manifestet.
Applikationerne bruger følsomme data, såsom token, adgangskoder til databasen, alt dette hentes i konfigurationen fra Puppet master, hvor de opbevares i krypteret form.
Problemer med TFS
Efter at vi havde fastslået og forstået, at alt faktisk fungerede, besluttede jeg at se, hvad der skete med bygningerne i TFS generelt for afdelingen for Windows-udvikling på andre projekter — om vi hurtigt kan bygge/release, og jeg opdagede betydelige problemer med hastigheden.
Et af hovedprojekterne bygger på 12-15 minutter — det er lang tid, så kan vi ikke leve sådan. En hurtig analyse viste en skrækkelig fald i I/O, og det var på arrays.
Ved at analysere komponent for komponent, identificerede jeg tre brændpunkter. Den første — «Kaspersky antivirus», der scanner kildekoden på alle Windows Build-agenter. Den anden - Windows Indexer. Den blev ikke deaktiveret, og alt blev indekseret i realtid på Build-agenterne under implementeringen.
Den tredje - Npm install. Det viste sig, at vi i de fleste pipelines brugte netop dette script. Hvad er problemet? Npm install-proceduren køres under opbygningen af afhængighedstræet i package-lock.json, hvor versionerne af de pakker, der skal anvendes til opbygning af projektet, bliver dokumenteret. Ulempen er, at Npm install hver gang henter de nyeste versioner af pakkerne fra internettet, hvilket kan tage lang tid i tilfælde af et stort projekt.
Udviklere eksperimenterer nogle gange på deres lokale maskiner for at teste en bestemt del eller hele projektet. Nogle gange viste det sig, at alt fungerede fint lokalt, men når vi buildede og implementerede - så fungerede ingenting. Vi begynder at finde ud af, hvad problemet er - aha, forskellige versioner af pakker med afhængigheder.
Løsning
- Kildekoden i AV-udsagn.
- Deaktivering af indeksering.
- Overgang til npm ci.
Fordelene ved npm ci er, at vi bygger afhængighedstræet én gang, og får muligheden for at give udvikleren en opdateret liste over pakker, som han kan eksperimentere med lokalt så meget som han vil. Dette spare tid for udviklere, der skriver kode.
Konfiguration
Lad os nu tales lidt om konfigurationen af repository'et. Historisk set bruger vi Nexus til styring af repositories, herunder Internal REPO. I dette interne repository leveres alle komponenter, som vi bruger til interne formål, f.eks. brugerdefinerede overvågninger.
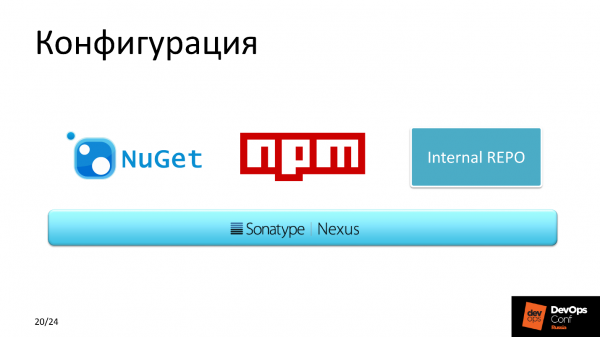
Vi bruger også NuGet, da det bedre cache'er sammenlignet med andre pakkeforvaltere.
Resultat
Efter vi har optimeret Build-agenterne, er den gennemsnitlige opbygningstid reduceret fra 12 minutter til 7.
Hvis man tager højde for alle de maskiner, vi kunne have brugt til Windows, men i stedet valgte at bruge Linux i dette projekt, har vi sparet omkring $10.000. Og det er kun for licenser, og hvis man tager vedligeholdelsen med, så er det endnu mere.
Planer
For det næste kvartal har vi planlagt arbejde med optimisering af kodeleveringen.
Overgang til prebuild Docker-billede. TFS er et fantastisk værktøj med mange plugins, der muliggør integration i pipeline, herunder bygning ved trigger, for eksempel Docker-billede. Denne trigger ønsker vi at lave på netop den package-lock.json. Hvis sammensætningen af komponenter, der bruges til at samle projektet, ændres på nogen måde, så oprettes der et nyt Docker-billede. Dette billede bruges fremadrettet til at implementere en container med den samlede applikation. Dette er ikke aktuelt nu, men vi planlægger at skifte til en mikrotjenestearkitektur i Kubernetes, som aktivt udvikles i vores virksomhed og længe har betjent produktionsløsninger.
CV
Jeg opfordrer alle til at kaste Windows væk, men det er ikke, fordi jeg ikke kan lave den. Årsagen er, at størstedelen af opensource-løsningerne er Linux-stakken. I skal spare godt på ressourcer. Efter min mening er fremtiden i open source-løsninger på Linux med et stærkt community.
Profilen af taleren Alexander Sinchinov .
— det er en konference om integration af udviklings-, test- og driftsprocesser for fagfolk af fagfolk. Derfor er projektet, som Alexander fortalte om, blevet realiseret og fungerer, og der er blevet gennemført to succesfulde udgivelser på dagen for præsentationen. den 27. og 28. maj vil der være endnu flere sådanne casestudier fra praktikere. Du kan stadig nå at komme med i sidste øjeblik og eller tage det roligt billet. Vi ses i Skolkovo!
Kilde: habr.com
