

I overgangen fra en monolitisk applikation til en mikrotjenestearkitektur støder vi på nye udfordringer.
I en monolitisk applikation er det normalt tilstrækkeligt blot at identificere, hvor i systemet fejlen opstod. Problemet ligger sandsynligvis i selve monolitens kode eller i databasen. Men når vi begynder at lede efter problemer i en mikrotjenestearkitektur, er det ikke så indlysende. Vi skal finde hele den vej, som forespørgslen har taget fra start til slut, og isolere den blandt hundreder af mikrotjenester. Mange af disse har også deres egne lagre, hvor der kan opstå både logiske fejl samt problemer med ydeevne og fejltolerance.
Jeg har længe ledt efter et værktøj, der kunne hjælpe med at tackle sådanne problemer (jeg skrev om dette på Habr: , ), men endte med at lave en egen open source-løsning. I artiklen fortæller jeg om fordelene ved service mesh-tilgangen og deler et nyt værktøj til dets implementering.
Distribueret tracing er en almindelig løsning på problemet med at finde fejl i distribuerede systemer. Men hvad hvis et sådant tilgang til indsamling af information om netværk interaktioner endnu ikke er implementeret i systemet, eller, hvad der er værre, i en del af systemet fungerer det allerede korrekt, mens det i en anden del ikke er tilføjet, da det ikke er implementeret i de ældre tjenester? For at bestemme den præcise rodårsag til problemet er det nødvendigt at have et klart billede af, hvad der sker i systemet. Det er især vigtigt at forstå, hvilke mikrotjenester der deltager i de primære forretningskritiske veje.
Her kan service mesh-tilgangen komme os til hjælp, som tager sig af hele maskineriet til indsamling af netværksinformation på et niveau, der er lavere end der, hvor selve tjenesterne opererer. Denne tilgang giver os mulighed for at interceptere al trafik og analysere den i realtid. Desuden behøver applikationerne slet ikke at vide noget om det.
Service mesh-tilgangen
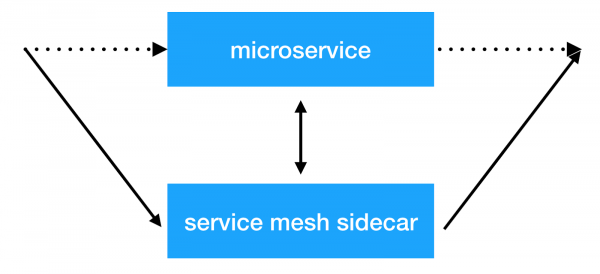
Den primære idé bag service mesh-tilgangen er at tilføje et ekstra infrastrukturlag over netværket, som gør det muligt for os at udføre forskellige opgaver med inter-service interaktion. De fleste implementeringer fungerer ved, at der tilføjes en yderligere sidecar-container med en gennemsigtig proxy til hver mikrotjeneste, som al indgående og udgående trafik til tjenesten passerer igennem. Og det er her, vi kan udføre klientbalancering, anvende sikkerhedspolitikker, sætte begrænsninger for antallet af forespørgsler og indsamle vigtig information om serviceinteraktioner i produktion.
Løsninger
Der er allerede flere implementeringer af denne tilgang: og . De tilbyder mange funktioner ud af boksen. Men samtidig med dette kommer der også en stor overhead på ressourcer. Jo større klyngen er, hvor et sådant system opererer, desto flere ressourcer kræves der for at opretholde den nye infrastruktur. Hos Avito udnytter vi Kubernetes-klynger, hvor der er tusindvis af tjenesteeksemplarer (og antallet fortsætter med at vokse hurtigt). I den nuværende implementering bruger Istio ~300Mb RAM pr. tjenesteeksemplar. På grund af det store antal funktioner påvirker den gennemsigtige balancering også den samlede svartid for tjenesterne (op til 10 ms).
I sidste ende så vi på, hvilke præcise muligheder vi har brug for lige nu, og besluttede, at hovedårsagen til, at vi begyndte at implementere sådanne løsninger, var muligheden for gennemsigtigt at indsamle tracing-information fra hele systemet. Vi ønskede også at have kontrol over serviceinteraktioner og udføre forskellige manipulationer med de overskrifter, der sendes mellem tjenesterne.
Som resultat kom vi frem til vores løsning: .
Netramesh
— en letvægts service mesh-løsning med mulighed for uendelig skalering, uanset antallet af tjenester i systemet.
De primære mål for den nye løsning var lav overhead på ressourcer og høj ydeevne. Af de grundlæggende funktioner ønskede vi straks at have muligheden for gennemsigtigt at sende tracing spans til vores Jaeger-system.
I dag implementeres de fleste cloud-løsninger på Golang. Og selvfølgelig er der gode grunde til det. At skrive netværksapplikationer i Golang, som arbejder asynkront med input-output og skalerer efter behov på kerner, er både praktisk og relativt enkelt. Og hvad der også er meget vigtigt, er, at ydeevnen er tilstrækkelig til at løse denne opgave. Derfor har vi også valgt Golang.
Ydeevne
Vi har fokuseret vores bestræbelser på at opnå maksimal ydeevne. For en løsning, der implementeres tæt på hver tjenesteinstans, er det nødvendigt med et lavt forbrug af RAM og processor-tid. Og selvfølgelig bør forsinkelsen i svaret også være minimal.
Lad os se på, hvilke resultater vi har opnået.
RAM
Netramesh bruger ~10Mb uden trafik og 50Mb maksimalt under belastning op til 10000 RPS på én instans.
Istio envoy proxy bruger altid ~300Mb i vores klynger med tusindvis af instanser. Dette gør det umuligt at skalere det til hele klyngen.
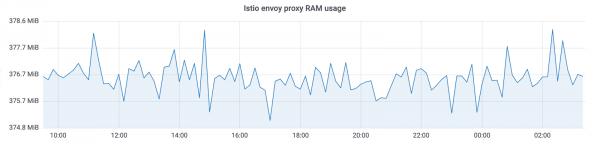
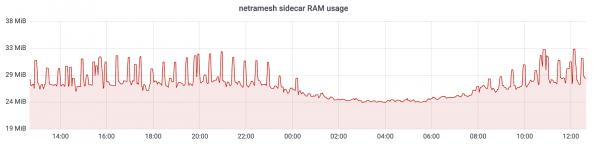
Med Netramesh har vi opnået en reduktion i hukommelsesforbruget på ~10 gange.
CPU
CPU-brugen er relativt ligeligt fordelt under belastning. Den afhænger af antallet af forespørgsler pr. tidsenhed til sidecar. Værdierne ved 3000 forespørgsler pr. sekund ved topniveau:
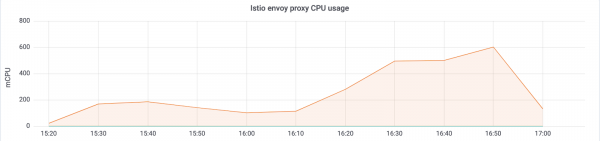
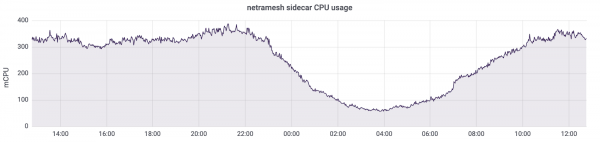
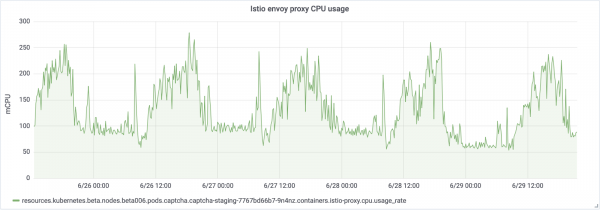
Der er endnu en vigtig pointe: Netramesh er en løsning uden kontrolplan, og uden belastning bruger den ikke processor-tid. I Istio opdaterer sidecar altid endpoint'erne for tjenesterne. Resultatet er, at vi kan se sådan et billede uden belastning:
Vi bruger HTTP/1 til interaktionen mellem tjenester. Forøgelsen i svartid hos Istio ved proxyering gennem envoy var op til 5-10ms, hvilket er ret meget for tjenester, der er klar til at svare på millisekunder. Med Netramesh blev denne tid reduceret til 0.5-2ms.
Skalering
Det lille antal ressourcer, som hver proxy bruger, giver mulighed for at placere den tæt på hver tjeneste. Netramesh blev bevidst designet uden komponenten kontrollplan for at opretholde letvægten af hver sidecar. Ofte i service mesh-løsninger spreder kontrolplanen information om serviceopdagelse til hver sidecar. Sammen med dette kommer også information om timeout og belastningsindstillinger. Alt dette muliggør mange nyttige funktioner, men desværre opblæser det størrelsen på sidecars.
Serviceopdagelse

Netramesh tilføjer ikke nogen ekstra mekanismer til serviceopdagelse. Al trafik proxieres transparent gennem netra sidecar.
Netramesh understøtter HTTP/1 applikationsprotokollen. Til dens definition anvendes en konfigurerbar liste over porte. Normalt er der flere porte i systemet, som interagerer via HTTP. For eksempel bruger vi 80, 8890, 8080 til interaktion mellem tjenester og eksterne forespørgsler. I så fald kan de angives ved hjælp af en miljøvariabel. NETRA_HTTP_PORTS.
Hvis du bruger Kubernetes som orkestrator og dens Service-mekanismer til intern clusterinteraktion mellem tjenester, forbliver mekanismen lige sådan. Først får mikrotjenesten en service IP-adresse via kube-dns og åbner en ny forbindelse til den. Denne forbindelse etableres først med den lokale netra-sidecar og alle TCP-pakker kommer oprindeligt til netra. Derefter etablerer netra-sidecar forbindelsen til den oprindelige destinationspunkt. NAT på pod IP på noden forbliver præcis som uden netra.
Distribueret tracing og kontekstgennemtræk
Netramesh leverer funktionaliteten nødvendig for at sende tracing spans om HTTP-interaktion. Netra-sidecar parser HTTP-protokollen, måler forespørgselsforsinkelser, henter nødvendig information fra HTTP-headere. I sidste ende opnår vi alle traces i et enhedligt Jaeger-system. For finjustering kan der også bruges miljøvariabler, som den officielle biblioteksleverandør giver. .
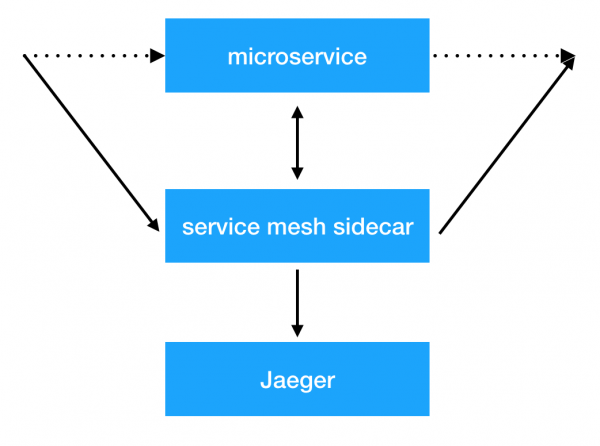
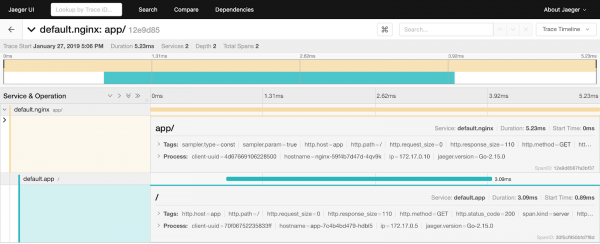
Men der er et problem. Indtil tjenesterne genererer og overfører en særlig uber-header, vil vi ikke se de sammenkoblede tracing spans i systemet. Og det er det, vi har brug for til hurtig fejlfinding. Her har Netramesh endnu en løsning. Proxyer læser HTTP-headere, og hvis de ikke har uber trace id, genererer de det. Netramesh opbevarer også information om indgående og udgående forespørgsler i sidecar og matcher dem ved at berige de nødvendige headere for udgående forespørgsler. Alt, hvad der skal gøres i tjenesterne, er at overføre kun én header. X-Request-Id, som kan konfigureres med en miljøvariabel. NETRA_HTTP_REQUEST_ID_HEADER_NAME. For at styre størrelsen af konteksten i Netramesh kan du angive følgende miljøvariabler: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (tiden, i hvilken konteksten vil blive opbevaret) og NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (hyppigheden af oprydning af konteksten).
Det er også muligt at kombinere flere stier i dit system ved at mærke dem med en særlig sessionsmarker. Netra gør det muligt at oprette HTTP_HEADER_TAG_MAP for at omdanne HTTP-overskrifter til de relevante tracing span-tags. Dette kan især være nyttigt ved testning. Efter at have gennemført en funktionel test kan man se, hvilken del af systemet der blev berørt ved at filtrere efter den relevante sessionsnøgle.
Bestemmelse af anmodningskilden
For at bestemme, hvor anmodningen kom fra, kan man bruge funktionen til automatisk at tilføje en header med kilden. Ved hjælp af miljøvariablen NETRA_HTTP_X_SOURCE_HEADER_NAME kan man angive navnet på headeren, der automatisk vil blive indstillet. Med NETRA_HTTP_X_SOURCE_VALUE kan man angive værdien, som X-Source-headeren vil blive sat til på alle udgående anmodninger.
Dette gør det muligt at ensartet sprede denne nyttige header på tværs af netværket. Herefter kan den anvendes i tjenester og tilføjes til logs og metrics.
Routing af trafik og indre funktioner i Netramesh
Netramesh består af to hovedkomponenter. Den første, netra-init, opsætter netværksregler for at opsnappe trafik. Den anvender til at opsnappe al eller en del af trafikken til sidecar, som er den anden hovedkomponent i Netramesh. Det er muligt at konfigurere, hvilke specifikke porte der skal opsnappes for indgående og udgående TCP-sessioner: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Derudover har værktøjet en interessant funktion – sandsynlighedsbaseret routing. Hvis Netramesh kun bruges til at indsamle tracing spans, kan man spare ressourcer i et production-miljø ved at aktivere sandsynlighedsbaseret routing ved hjælp af variablerne NETRA_INBOUND_PROBABILITY og NETRA_OUTBOUND_PROBABILITY (fra 0 til 1). Standardværdien er 1 (al trafik opsnappes).
Efter en vellykket opsnapning accepterer netra sidecar en ny forbindelse og bruger SO_ORIGINAL_DST socketmuligheden til at få den oprindelige destinationsadresse. Derefter åbner Netra en ny forbindelse til den oprindelige IP-adresse og etablerer en tovej TCP-kommunikation mellem parterne, mens den lytter til al den passerende trafik. Hvis porten er angivet som HTTP, forsøger Netra at analysere den og trace det. Hvis HTTP-analyse mislykkes, falder Netra tilbage til TCP og proxyer bytes gennemsigtigt.
Opbygning af afhængighedsgraf
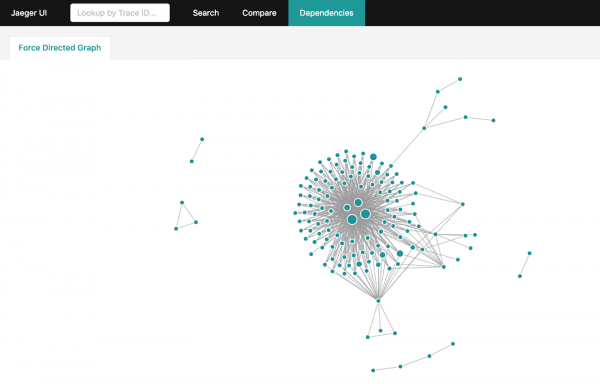
Efter at have modtaget en stor mængde tracing-information i Jaeger, ønsker man at få det fulde interaktionsgraf i systemet. Men hvis dit system er tilstrækkeligt belastet, og der opsamles milliarder af tracing spans på en dag, bliver aggregering af dem ikke så enkel. Der er en officiel metode til dette: . Alligevel vil det tage timer at opbygge det fulde graf og kræve, at du downloader hele datasættet fra Jaeger for de sidste 24 timer.
Hvis du bruger Elasticsearch til at gemme tracing spans, kan du udnytte , som kan opbygge et tilsvarende graf på få minutter ved at anvende funktionerne og mulighederne i Elasticsearch.
Hvordan man bruger Netramesh
Netra kan nemt tilføjes til enhver tjeneste, der kører under en hvilken som helst orkestrator. Du kan se et eksempel .
På nuværende tidspunkt har Netra ikke muligheden for automatisk at implementere en sidecar til tjenester, men der er planer om implementering.
Fremtiden for Netramesh
Hovedmålet er at opnå minimale ressourceomkostninger og høj ydeevne, samtidig med at de grundlæggende muligheder for observabilitet og kontrol af tjenesteinteraktioner tilbydes.
I fremtiden vil Netramesh få støtte til andre applikationslag-protokoller ud over HTTP. Snart vil muligheden for L7-routing være tilgængelig.
Brug Netramesh, hvis du oplever lignende problemer, og send os spørgsmål og forslag.
Kilde: habr.com
