

Indtil for nylig opbevarede Odnoklassniki omkring 50 TB data, der blev behandlet i realtid, i SQL Server. At sikre hurtig, pålidelig og fejltolerant adgang til datacenteret for en så stor mængde data ved hjælp af en SQL-database er praktisk talt umuligt. I sådanne tilfælde bruger man typisk et af NoSQL-lagringssystemerne, men ikke alt kan overføres til NoSQL: nogle enheder kræver garantier for ACID-transaktioner.
Dette førte os til at bruge et NewSQL-lagringssystem, dvs. en database, der tilbyder fejltolerance, skalerbarhed og hastighed fra NoSQL-systemer, men samtidig bevarer de klassiske systems ACID-garantier. Der er ikke mange fungerende industrielle systemer af denne nye klasse, så vi har selv implementeret et sådant system og taget det i drift.
Hvordan det fungerer, og hvad vi har opnået – læs videre.
I dag har «Odnoklassniki» mere end 70 millioner unikke besøgende om måneden. Vi største sociale netværk i verden og i top tyve over de websites, hvor brugerne bruger mest tid. Infrastrukturene i «OK» behandler meget høje belastninger: mere end en million HTTP-anmodninger/sekund til fronten. Delene af serverparken, som tæller over 8000 enheder, er placeret tæt på hinanden – i fire datacentre i Moskva, hvilket gør det muligt at opretholde en netværksforsinkelse på mindre end 1 ms mellem dem.
Vi har brugt Cassandra siden 2010, startende med version 0.6. I dag er der flere dusin klynger i drift. Den hurtigste klynge håndterer mere end 4 millioner operationer i sekundet, og den største gemmer 260 TB.
Men alt dette er almindelige NoSQL-klynger, der bruges til lagring af data. Vi ønskede derimod at erstatte det primære konsistente lager, Microsoft SQL Server, som har været brugt siden Odnoklassniki's grundlæggelse. Lagringen bestod af mere end 300 SQL Server Standard Edition-maskiner, der indeholdt 50 TB data – forretningsenheder. Disse data modificeres inden for ACID-transaktioner og kræver .
For at fordele dataene mellem noderne i SQL Server brugte vi både vertikal og horisontal (sharding). Historisk har vi brugt en simpel skema for sharding af data: hver enhed fik tildelt en token — en funktion af enhedens ID. Enheder med samme token blev placeret på den samme SQL-server. Master-detail-forholdet blev implementeret, så tokens for hoved- og afledte optegnelser altid stemte overens og befandt sig på den samme server. I sociale netværk bliver næsten alle optegnelser genereret på vegne af brugeren — hvilket betyder, at al brugerens data inden for et funktionelt subsystem opbevares på den samme server. Det vil sige, at der næsten altid var involveret tabeller fra den samme SQL-server i forretningstransaktioner, hvilket gjorde det muligt at sikre datakonsistens ved hjælp af lokale ACID-transaktioner, uden behov for at bruge fordelte ACID-transaktioner.
Takket være sharding og for at fremskynde SQL-operationer:
- Bruger ikke foreign key constraints, da enhedens ID ved sharding kan befinde sig på en anden server.
- Bruger ikke lagrede procedurer og triggers på grund af den ekstra belastning på CPU'en i databasen.
- Bruger ikke JOINs på grund af alt det ovenstående og mange tilfældige læsninger fra disk.
- Uden for transaktioner bruger vi isolationsniveauet Read Uncommitted for at reducere deadlocks.
- Udfører kun korte transaktioner (i gennemsnit kortere end 100 ms).
- Bruger ikke multi-row UPDATE og DELETE på grund af det store antal deadlocks — opdaterer kun én post ad gangen.
- Forespørgsler udføres altid kun baseret på indekser — en forespørgsel med en plan for fuld tabelscanning betyder for os en overbelastning af databasen og dens nedbrud.
Disse skridt har gjort det muligt at presse næsten maksimal ydeevne ud af SQL-serverne. Men problemerne blev gradvist flere. Lad os se på dem.
Problemer med SQL
- Da vi brugte en brugerdefineret sharding, blev tilføjelse af nye shards udført af administratorer manuelt. I hele denne tid har skalerbare datakopier ikke betjent forespørgsler.
- Efterhånden som antallet af poster i tabellen voksede, faldt hastigheden for indsættelse og ændring, og når der tilføjedes indekser til den eksisterende tabel, faldt hastigheden dramatisk, oprettelse og genoprettelse af indekser skete med downtime.
- Tilstedeværelsen af et lille antal Windows-servere til SQL Server i produktion vanskeliggør håndteringen af infrastrukturen.
Men det største problem er —
Fejltolerance
En klassisk SQL-server har dårlig fejltolerance. Antag, at du kun har én database, og den fejler én gang hvert tredje år. I den tid er hjemmesiden nede i 20 minutter, hvilket kan accepteres. Hvis du har 64 servere, er hjemmesiden nede hver tredje uge. Og hvis du har 200 servere, er hjemmesiden nede hver uge. Det er et problem.
Hvad kan der gøres for at forbedre fejltolerance for SQL-serveren? Wikipedia foreslår, at vi opstiller : hvor der er duplikerende komponenter i tilfælde af fejl i nogen af dem.
Dette kræver en park af dyrt udstyr: omfattende duplication, fiberoptik, fælles lagre, og det at aktivere reservedele er ikke pålideligt: omkring 10% af aktiveringerne ender med fejl i den redundant node efter den primære node.
Men hovednævnet ved et sådant højtilgængeligt cluster er - nul tilgængelighed ved fejl i datacentret, hvor det står. »Odnoklassniki« har fire datacentre, og vi skal sikre drift i tilfælde af en totalfejl i et af dem.
Til dette kunne vi anvende replikation, som er indbygget i SQL Server. Denne løsning er meget dyrere på grund af softwareomkostningerne og lider af velkendte problemer med replikation - uforudsigelige transaktionsforsinkelser ved synkron replikation og forsinkelser i anvendelsen af replikationer (og som følge heraf, tabte ændringer) ved asynkron. Det underforståede gør denne mulighed helt uanvendelig for os.
Alle disse problemer krævede en radikal løsning, og vi begyndte at analysere dem grundigt. Her skal vi gøre os bekendt med, hvad SQL Server primært beskæftiger sig med - transaktioner.
En simpel transaktion
Lad os overveje den enkleste transaktion fra en applikations-SQL-programmørs perspektiv: tilføjelse af et billede til et album. Albummet og billederne gemmes i forskellige tabeller. Et album har en tæller for offentlige billeder. Sådan en transaktion opdeles i følgende trin:
- Vi låser albummet efter nøgle.
- Vi opretter en post i billedtabellen.
- Hvis billedet har offentlig status, så tæller vi op i albummets tæller for offentlige billeder, opdaterer posten og committer transaktionen.
Eller i form af pseudokode:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vi ser, at det mest udbredte scenarie for en forretningstransaktion er at læse data fra databasen til applikationsserverens hukommelse, ændre noget og gemme de nye værdier tilbage i databasen. Normalt opdaterer vi i en sådan transaktion flere enheder, flere tabeller.
Under udførelsen af en transaktion kan der ske konkurrerende ændringer af de samme data fra et andet system. For eksempel kan Antispam beslutte, at en bruger er mistænkelig og derfor ikke længere ønsker, at alle brugerens billeder skal være offentlige; de skal sendes til moderation, hvilket betyder, at photo.status skal ændres til en anden værdi, og de relevante tællere skulle justeres. Det er åbenlyst, at hvis denne operation finder sted uden garantier for atomaritet og isolering af konkurrerende ændringer, som i , vil resultatet ikke være det ønskede - enten vil foto-tælleren vise en forkert værdi, eller også vil ikke alle billeder blive sendt til moderation.
Der er skrevet meget kode, der manipulerer med forskellige forretningsenheder inden for en enkelt transaktion i løbet af Odnoklassnikis eksistens. Ud fra erfaringerne med migrationer til NoSQL fra ved vi, at de største udfordringer (og tidsomkostninger) skyldes nødvendigheden af at udvikle kode, der sigter mod at opretholde datakonsistens. Derfor anså vi, at det vigtigste krav til det nye lager var at sikre ægte ACID-transaktioner for den applikationslogik.
Andre, ikke mindre vigtige krav var:
- I tilfælde af datacenterfejl skal både læsning og skrivning i det nye lager være tilgængelige.
- Bevarelse af den nuværende udviklingshastighed. Det vil sige, at mængden af kode, der arbejdes med i det nye lager, skal være omtrent den samme, og der må ikke være behov for at skrive noget ekstra i lageret, udvikle algoritmer til konfliktløsning, vedligeholdelse af sekundære indekser osv.
- Hastigheden på det nye lager skal være tilstrækkeligt høj både ved læsning af data og ved behandling af transaktioner, hvilket effektivt betød, at akademisk strenge, universelle, men langsomme løsninger, såsom .
- Automatisk skalering under drift.
- Brug af almindelige billige servere uden behov for at købe eksotisk hardware.
- Mulighed for udvikling af lagring gennem virksomhedens udviklere. Med andre ord blev der givet prioritet til interne eller open-source løsninger, helst i Java.
Løsninger, løsninger
Ved at analysere de mulige løsninger kom vi frem til to mulige arkitekturvalg:
Det første var at tage en hvilken som helst SQL-server og implementere den nødvendige fejltolerance, skalering, fejltolerant klynge, konfliktløsning og distribuerede, pålidelige og hurtige ACID-transaktioner. Vi vurderede denne mulighed som temmelig ikke-triviel og arbejdsintensiv.
Den anden mulighed var at tage et færdigt NoSQL-lager med implementeret skalering, fejltolerant klynge og konfliktløsning og selv implementere transaktioner og SQL. Ved første øjekast virker selv opgaven med at implementere SQL, for ikke at nævne ACID-transaktioner, som en opgave, der tager år. Men senere indså vi, at det sæt af SQL-muligheder, vi bruger i praksis, er langt fra ANSI SQL lige så langt som er langt fra ANSI SQL. Da vi kiggede nærmere på CQL, indså vi, at det er tilstrækkeligt nært, hvad vi har brug for.
Cassandra og CQL
Så hvad er det interessante ved Cassandra, hvilke funktioner har den?
For det første kan man oprette tabeller med understøttelse af forskellige datatyper, man kan udføre SELECT eller UPDATE ved hjælp af den primære nøgle.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
For at sikre konsistens af datareplikker anvender Cassandra I de enkleste tilfælde betyder det, at når man placerer tre replikaer af den samme række på forskellige noder i klyngen, anses skrivningen for at være succesfuld, hvis flertallet af noderne (dvs. to ud af tre) har bekræftet, at operationen er gennemført. Dataene i rækken anses for at være konsistente, hvis flertallet af noderne blev forespurgt ved læsning og bekræftede dem. Dermed garanterer tilstedeværelsen af tre replikaer fuld og øjeblikkelig datakonsistens, hvis en node svigter. Denne tilgang har gjort det muligt for os at implementere en endnu mere pålidelig ordning: altid at sende forespørgsler til alle tre replikaer og vente på svar fra de to hurtigste. Det forsinkede svar fra den tredje replika bliver i dette tilfælde forkastet. Den forsinkede node kan have alvorlige problemer — forsinkelser, affaldssamling i JVM, direct memory reclaim i Linux-kernen, hardwarefejl, frakobling fra netværket. Men dette påvirker hverken klientoperationen eller dataene.
Den tilgang, hvor vi henvender os til tre noder og får svar fra to, kaldes : forespørgslen til de overskydende replikaer sendes, før man 'falder fra'.
En anden fordel ved Cassandra er Batchlog — en mekanisme, der garanterer, at enten hele pakken anvendes eller slet ikke. Dette gør det muligt for os at løse A i ACID — atomaritet lige ud af boksen.
Det, der er tættest på transaktioner i Cassandra, er såkaldte "". Men de er langt fra 'ægte' ACID-transaktioner: i virkeligheden er det en mulighed for at foretage på dataene kun for én post ved at bruge konsensus gennem den tunge protokol Paxos. Derfor er hastigheden på sådanne transaktioner ikke høj.
Hvad vi savnede i Cassandra
Så vi skulle implementere ægte ACID-transaktioner i Cassandra. Med brug af hvilke vi nemt kunne implementere to andre praktiske funktioner fra klassiske DBMS: konsistente hurtige indekser, der ville gøre det muligt for os at udføre dataudtræk ikke kun efter den primære nøgle og en almindelig generator af monotont autoincrement ID.
C*One
Sådan blev den nye DBMS født C*One, bestående af tre typer servernoder:
- Opbevaring — (næsten) standard Cassandra-servere, der er ansvarlige for at gemme data på lokale diske. I takt med at belastningen og datamængden vokser, kan deres antal let skaleres til dusinvis og hundreder.
- Transaktionskoordinatorer sikrer gennemførelsen af transaktioner.
- Klienter er applikationsservere, der udfører forretningsoperationer og initierer transaktioner. Der kan være tusindvis af sådanne klienter.
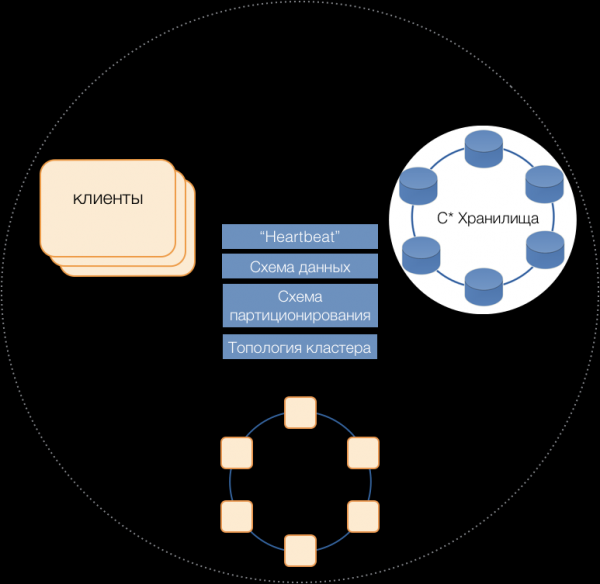
Servere af alle typer er en del af et fælles klynge, bruger den interne beskedprotokol Cassandra til at kommunikere med hinanden og til at udveksle klyngeinformation. Ved hjælp af Heartbeat bliver serverne opmærksomme på gensidige fejlfunktioner, opretholder et ensartet dataskema - tabeller, deres struktur og replikation; partitionsskema, klyngetopologi osv.
Klienter
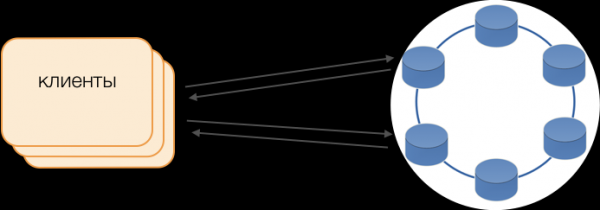
I stedet for standarddrivere bruges Fat Client-tilstand. Denne node gemmer ikke data, men kan fungere som koordinator for udførelsen af anmodninger, hvilket betyder, at klienten selv udfører funktionen som koordinator for sine anmodninger: den forespørger lagringsreplikater og løser konflikter. Dette er ikke kun mere pålideligt og hurtigere end den standarddriver, der kræver kommunikation med en fjernkoordinator, men giver også mulighed for at styre overførsel af anmodninger. Uden for en åben transaktion på klienten sendes anmodningerne til lagrene. Hvis klienten åbner en transaktion, sendes alle anmodninger inden for transaktionen til transaktionskoordinatoren.
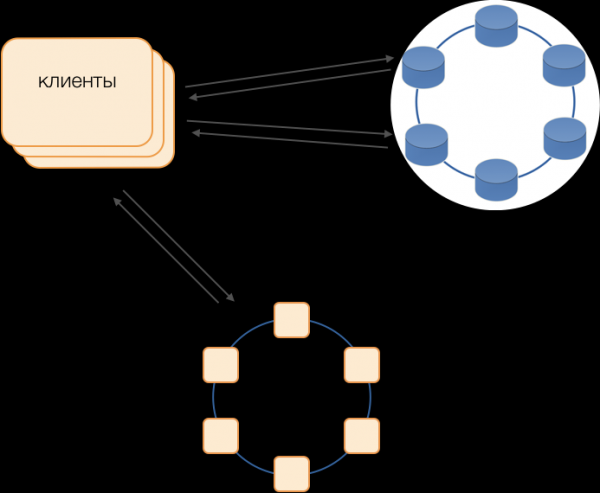
Transaktionskoordinator C*One
Koordinatoren er det, vi har implementeret for C*One fra bunden. Den er ansvarlig for styringen af transaktioner, låsninger og rækkefølgen for anvendelsen af transaktioner.
For hver håndteret transaktion genererer koordinatoren et tidsstempel: hvert efterfølgende er større end det for den tidligere transaktion. Da konfliktløsning i Cassandra-systemet er baseret på tidsstempler (blandt to konfliktende poster betragtes den med det seneste tidsstempel som gældende), vil konflikten altid blive løst til fordel for den efterfølgende transaktion. På den måde har vi implementeret — en billig metode til konfliktløsning i et distribueret system.
Låse
For at sikre isolering besluttede vi at bruge den simpleste metode — pessimistiske låse baseret på den primære nøgle til posten. Med andre ord skal posten låses i transaktionen, inden den læses, modificeres og gemmes. Først efter en vellykket commit kan posten låses op, så konkurrerende transaktioner kan bruge den.
Implementeringen af en sådan lås er enkel i et ikke-distribueret miljø. I et distribueret system er der to hovedmetoder: enten at implementere en distribueret lås i klyngen eller at distribuere transaktioner, så transaktioner, der involverer den samme post, altid betjenes af den samme koordinator.
Da vores data allerede er fordelt på grupper af lokale transaktioner i SQL, blev det besluttet at tildele koordinatorer til grupperne af lokale transaktioner: én koordinator udfører alle transaktioner med token fra 0 til 9, den anden fra 10 til 19, og så videre. Som et resultat bliver hver af koordinatorerne chef for gruppen af transaktioner.
Så låsene kan implementeres som en simpel HashMap i hukommelsen hos koordinatoren.
Koordinatorernes fejl
Da en koordinator udelukkende betjener en gruppe transaktioner, er det meget vigtigt hurtigt at kunne identificere dens fejl, så genprøvningen af transaktionen kan ske inden for tidsgrænsen. For at gøre dette hurtigt og pålideligt anvendte vi en fuldt forbundet quorum heartbeat-protokol:
I hver datacenter placeres der mindst to koordinator-noder. Periodisk sender hver koordinator et heartbeat-besked til de andre koordinatorer og informerer dem om sin funktionalitet samt hvilke heartbeat-beskeder fra hvilke koordinatorer i klyngen, den har modtaget sidst.
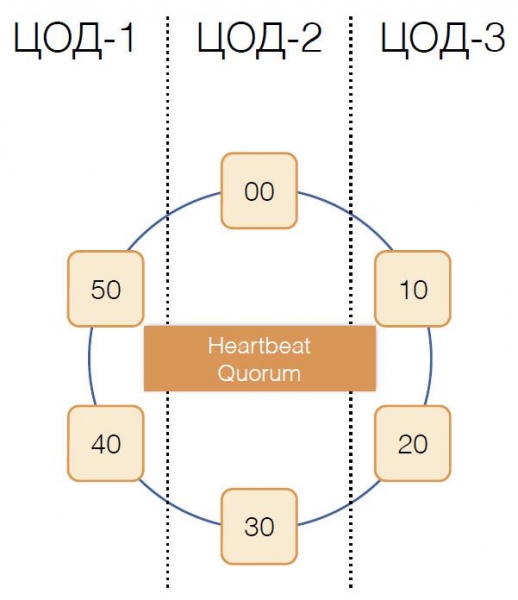
Ved at modtage lignende information fra de andre i deres heartbeat-beskeder, beslutter hver koordinator for sig selv, hvilke noder i klyngen der fungerer, og hvilke der ikke gør, baseret på quorum-princippet: hvis node X har modtaget information om normal modtagelse af beskeder fra node Y fra flertallet af noderne i klyngen, så fungerer Y. Omvendt, så snart flertallet meddeler, at de ikke modtager beskeder fra node Y, så er Y failed. Interessant nok, hvis quorum informerer node X om, at den ikke længere modtager beskeder fra den, vil node X selv betragte sig som failed.
Heartbeat-beskeder sendes med høj frekvens, omkring 20 gange i sekundet, med et interval på 50 ms. I Java er det svært at garantere applikationens respons inden for 50 ms på grund af de sammenlignelige varigheder af pauserne forårsaget af affaldsamleren. Vi har formået at opnå en sådan responstid ved at bruge G1-affaldsamleren, som tillader at angive et mål for varigheden af GC-pauser. Dog, nogle gange, ganske sjældent, overskrider affaldssamlerens pauser 50 ms, hvilket kan føre til falsk detektion af fejl. For at undgå dette, rapporterer koordinatoren ikke om fejl fra den fjerne node ved tab af det første heartbeat-besked fra den, kun hvis flere går tabt i træk. På den måde har vi formået at detektere fejl hos koordinators noden inden for 200 ms.
Men det er ikke nok bare at forstå hurtigt, hvilken node der er stoppet med at fungere. Vi skal gøre noget ved det.
Redundans
Den klassiske ordning indebærer, at der i tilfælde af masterfejl indkaldes valg af en ny ved hjælp af en af algoritmer. Men sådanne algoritmer har velkendte problemer med konvergens i tiden og varigheden af selve valgprocessen. Disse ekstra forsinkelser har vi været i stand til at undgå med en ordning for udskiftning af koordinatorer i et fuld forbindelse netværk:
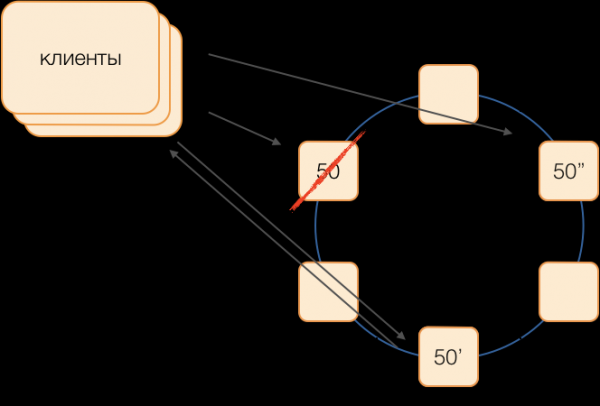
Lad os sige, at vi ønsker at udføre en transaktion i gruppe 50. Vi vil på forhånd definere udskiftningsordningen, dvs. hvilke noder der vil udføre transaktionerne i gruppe 50 i tilfælde af fejl hos den primære koordinator. Vores mål er at opretholde systemets funktionalitet ved fejl i datacenteret. Vi bestemmer, at den første reserve vil være en node fra et andet datacenter, og den anden reserve vil være en node fra et tredje. Denne ordning vælges én gang og ændres ikke, medmindre topologi i klyngen ændres, dvs. så længe nye noder ikke tilføjes (hvilket sjældent sker). Rækkefølgen for valg af en ny aktiv master ved fejl hos den gamle vil altid være den samme: den aktive master bliver den første reserve, og hvis den også er stoppet med at fungere - den anden reserve.
Denne ordning er mere pålidelig end den universelle algoritme, da det for at aktivere en ny master kun kræver fastlæggelse af, at den gamle er fejlet.
Men hvordan skal kunderne forstå, hvilken af mestre der arbejder i øjeblikket? Det er umuligt at sende information til tusindvis af kunder på 50 ms. Der kan opstå en situation, hvor en kunde sender en anmodning om at åbne en transaktion, uden at vide at den pågældende mester allerede ikke fungerer, og anmodningen hænger i timeout. For at undgå dette sender kunderne spekulativt anmodningen til den gruppe mester samt begge hans reserver, men kun den, der er den aktive mester i øjeblikket, vil svare på anmodningen. Al efterfølgende kommunikation i forbindelse med transaktionen vil kunden kun føre med den aktive mester.
Reserve mestre placerer de modtagne anmodninger om ikke deres egne transaktioner i køen for ufødt transaktioner, hvor de opbevares i nogen tid. Hvis den aktive mester dør, vil den nye mester håndtere anmodningerne om at åbne transaktioner fra sin kø og svare kunden. Hvis kunden allerede har åbnet en transaktion med den gamle mester, ignoreres det andet svar (og åbenlyst vil en sådan transaktion ikke blive afsluttet og vil blive gentaget af kunden).
Hvordan fungerer en transaktion
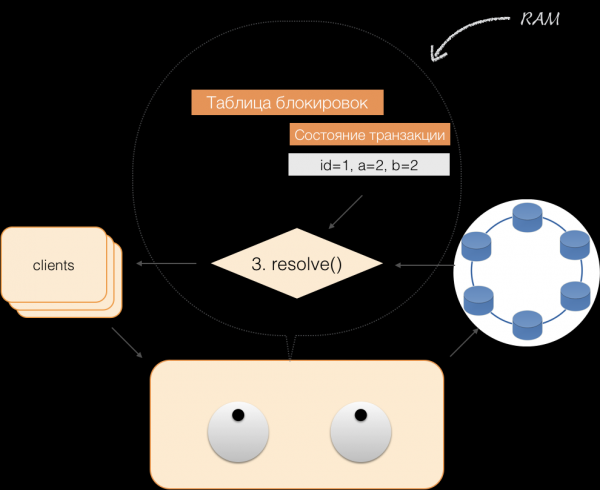
Lad os sige, at kunden har sendt en anmodning til koordinatoren om at åbne en transaktion for en bestemt enhed med en bestemt primær nøgle. Koordinatoren låser denne enhed og placerer den i blokeringstabellen i hukommelsen. Om nødvendigt læser koordinatoren denne enhed fra lageret og gemmer de modtagne data i transaktionens tilstand i koordinatorens hukommelse.
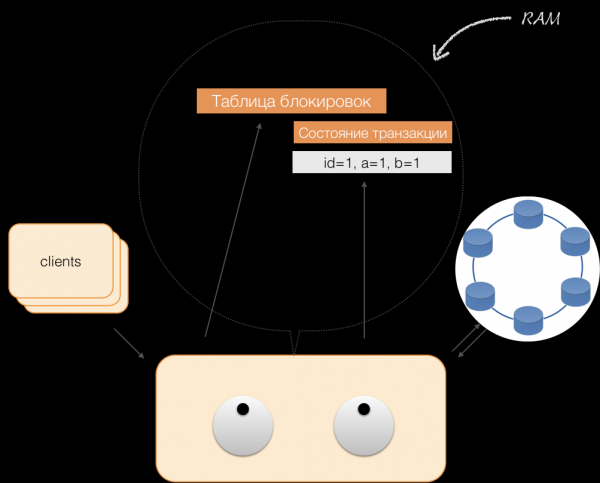
Når kunden ønsker at ændre data i transaktionen, sender han en anmodning til koordinatoren om at ændre enheden, og denne placerer de nye data i tilstandstabellen for transaktionerne i hukommelsen. På dette tidspunkt er optagelsen afsluttet — der laves ikke nogen optagelse i lageret.
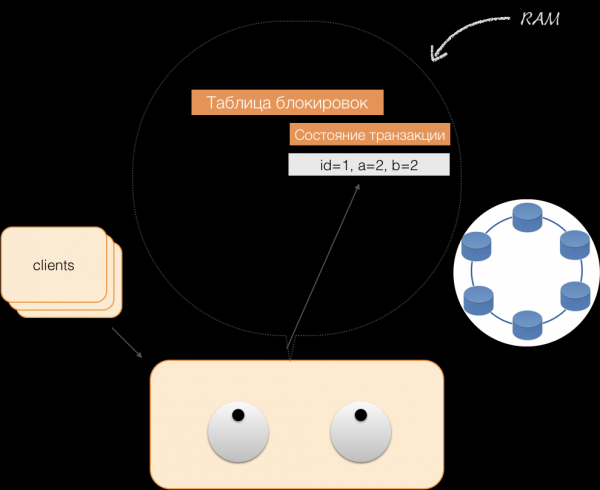
Når kunden anmoder om sine ændrede data inden for en aktiv transaktion, handler koordinatoren således:
- hvis ID allerede findes i transaktionen, tages data fra hukommelsen;
- hvis ID ikke findes i hukommelsen, læses de manglende data fra node-lagre, samles med de allerede eksisterende i hukommelsen, og resultatet gives til kunden.
Således kan kunden læse sine egne ændringer, mens andre kunder ikke ser disse ændringer, fordi de kun opbevares i koordinatorens hukommelse, de findes endnu ikke i Cassandra-noderne.
Når en klient sender et commit, gemmer koordinatoren den tilstand, der var i hukommelsen hos tjenesten, i et logged batch, som derefter sendes til Cassandra-lagrene. Lagrene gør alt nødvendigt for, at dette batch bliver anvendt atomart (fuldstændigt), og returnerer et svar til koordinatoren, som derefter frigiver låsene og bekræfter transaktionens succes til klienten.
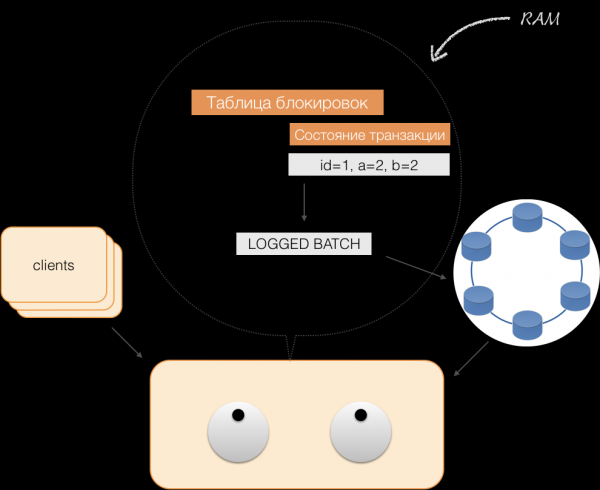
Og for at rulle tilbage skal koordinatoren blot frigive den hukommelse, der er optaget af transaktionens tilstand.
Som et resultat af de ovenfor beskrevne forbedringer har vi implementeret ACID-principperne:
- Atomaritet. Dette er garantien for, at ingen transaktion vil blive registreret delvist i systemet; enten udføres alle dens underoperationer, eller ingen af dem udføres. Vi overholder dette princip ved hjælp af logged batch i Cassandra.
- Konsistens. Hver vellykket transaktion registrerer pr. definition kun gyldige resultater. Hvis det efter åbningen af transaktionen og udførelsen af nogle operationer opdages, at resultatet er ugyldigt, udføres der en tilbageførsel.
- Isolering. Under udførelsen af en transaktion må parallelle transaktioner ikke påvirke dens resultat. Konkurrerende transaktioner isoleres ved hjælp af pessimistische låse hos koordinatoren. For læsninger uden for transaktionen overholdes isolationsprincippet på niveauet Read Committed.
- Holdbarhed. Uanset problemer på de lavere niveauer — strømafbrydelser, hardwarefejl — skal ændringer foretaget af en succesfuld transaktion forblive gemt efter genoptagelsen af driften.
Læsning efter indekser
Lad os tage et simpelt tabel:
CREATE TABLE photos (
id bigint primary key,
ejer bigint,
ændret timestamp,
…)
Den har et ID (primær nøgle), ejer og ændringsdato. Vi skal lave en meget simpel forespørgsel — hente data efter ejer med ændringsdatoen "i de seneste 24 timer".
SELECT *
WHERE owner=?
AND modified>?
For at en sådan forespørgsel skal køre hurtigt, skal der i en klassisk SQL-database bygges et indeks over kolonnerne (ejer, ændret). Dette kan vi gøre forholdsvis enkelt, da vi nu har ACID-garantier!
Indekser i C*One
Der er en original tabel med billeder, hvor ID'et for posten er den primære nøgle.
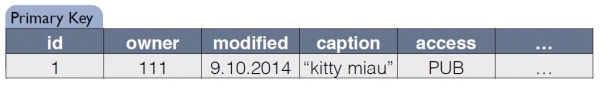
For the index, C*One creates a new table that is a copy of the original. The key matches the index expression, which also includes the primary key of the record from the original table:
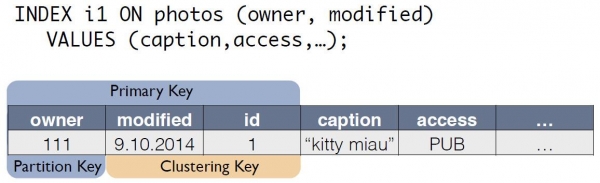
Now the query for "the owner for the last day" can be rewritten as a select from another table:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
The data consistency of the original photos table and the index i1 is maintained automatically by the coordinator. Based only on the data schema, when changes are received, the coordinator generates and remembers changes not only for the main table but also for copies. No additional actions are performed with the index table, logs are not read, and locks are not used. This means that adding indexes consumes almost no resources and has practically no impact on the speed of applying modifications.
With the help of ACID, we managed to implement indexes "as in SQL." They have consistency, can scale, work quickly, can be composite, and are embedded in the CQL query language. No changes to the application code are needed to support indexes. It’s as simple as in SQL. And most importantly, indexes do not affect the speed of executing modifications to the transactions of the original table.
What we achieved
We developed C*One three years ago and launched it into production.
So what did we achieve in the end? Let's evaluate it using the example of the subsystem for processing and storing photos, one of the most important data types in a social network. It’s not about the actual images, but the various metadata. Currently, there are about 20 billion such records in "Odnoklassniki", the system processes 80,000 read requests per second, and up to 8,000 ACID transactions per second related to data modification.
When we used SQL with a replication factor of 1 (but in RAID 10), the metadata for photos was stored on a highly available cluster of 32 machines with Microsoft SQL Server (plus 11 backups). Additionally, 10 servers were allocated for backup storage. In total, 50 expensive machines. Meanwhile, the system operated under nominal load, without spare capacity.
Efter migrationen til det nye system har vi opnået en replikeringsfaktor på 3 – én kopi i hvert datacenter. Systemet består af 63 Cassandra-lagringsnoder og 6 koordineringsmaskiner, i alt 69 servere. Men disse maskiner er betydeligt billigere, da deres samlede omkostning udgør cirka 30 % af omkostningerne ved SQL-systemet. Belastningen ligger samtidig på et niveau på 30 %.
Med implementeringen af C*One er latensen også blevet reduceret: i SQL tog en skriveoperation cirka 4,5 ms. I C*One er det omkring 1,6 ms. Transaktionens varighed er i gennemsnit mindre end 40 ms, commit udføres på 2 ms, og læse- og skrivevarigheden ligger i gennemsnit på 2 ms. 99. percentilen er kun 3-3,1 ms, og antallet af timeouts er reduceret med 100 gange – alt sammen takket være den brede anvendelse af spekulationer.
Indtil nu er den største del af SQL Server-noderne taget ud af drift, og nye produkter udvikles kun ved hjælp af C*One. Vi har tilpasset C*One til at fungere i vores cloud. , hvilket har gjort det muligt at fremskynde implementeringen af nye klynger, forenkle konfigurationen og automatisere driften. Uden kildekoden ville det have været betydeligt mere kompliceret og klodset.
Vi arbejder nu på at migrere vores andre lagre til skyen – men det er en helt anden historie.
Kilde: habr.com
