

En anden bruger ønsker at gemme en ny mængde data på harddisken, men der er ikke nok ledig plads til det. Der er heller ikke lyst til at slette noget, da "alt er meget vigtigt og nødvendigt". Hvad skal vi så gøre med det?
Dette problem opstår ikke kun for ham. Der ligger terabyte af information på vores harddiske, og mængden falder ikke. Men hvor unik er den? I sidste ende er alle filer blot sekvenser af bits af en bestemt længde, og den nye adskiller sig sandsynligvis ikke meget fra den, der allerede er gemt.
Det er klart, at det er en opgave, hvis ikke umulig, så i det mindste ineffektiv, at lede efter allerede gemte stykker information på harddisken. På den anden side, hvis forskellen er lille, så kan man tilpasse det lidt...
TL;DR — et andet forsøg på at fortælle om en mærkelig metode til dataoptimering ved hjælp af JPEG-filer, nu i en mere forståelig form.
Om bits og forskelle
Hvis man tager to helt tilfældige stykker data, vil der i gennemsnit være halvdelen af de indeholdte bits, der stemmer overens. Og faktisk, blandt mulige kombinationer for hvert par ('00, 01, 10, 11') har halvdelen ens værdier; dette er ret enkelt.
Men selvfølgelig, hvis vi bare tager to filer og tilpasser den ene til den anden, vil vi miste en af dem. Hvis vi derimod gemmer ændringer, vil vi blot genopfinde , som allerede eksisterer glimrende uden os, selvom det normalt ikke bruges til de samme formål. Man kan forsøge at indpasse en mindre sekvens i en større, men selv i så tilfælde risikerer vi at miste kritiske segmenter af data ved ubetænksom anvendelse af det til alt muligt.
Mellem hvad og hvad kan vi så eliminere forskellen? Jeg mener, den nye fil, som brugeren ønsker at gemme, er blot en sekvens af bits, som vi ikke kan gøre noget med alene. Vi skal derfor blot finde bits på harddisken, som kan ændres uden behov for at gemme forskellen, så vi kan overleve et tab uden alvorlige konsekvenser. Og det giver også mening at ændre ikke bare selve filen på filsystemet, men også nogle mindre følsomme oplysninger indeni den. Men hvilke og hvordan?
Metoder til tilpasning
Her kommer filerne til undsætning, der er komprimeret med tab. Alle disse jpeg, mp3 og andre, selvom de er tabskomprimerede, indeholder en masse bits, der er tilgængelige for sikker ændring. Avancerede teknikker kan bruges til diskret at modificere deres komponenter på forskellige kodningssteder. Vent. Avancerede teknikker… diskret ændring… nogle bits til andre… det er nærmest !
Og ja, at indlejre én information i en anden ligner virkelig deres metoder. Det er også imponerende, hvor usynlige de ændringer, der er foretaget, er for menneskelige sanser. Her adskiller vejene sig — det er i hemmeligheden: vores opgave er at tillade brugeren at tilføje ekstra information til sin harddisk, hvilket kun vil skade ham. Han vil ende med at glemme det.
Derfor kan vi, selvom vi kan bruge dem, være nødt til at lave nogle ændringer. Og længere fremme vil jeg forklare og vise dem med eksemplet af en af de eksisterende metoder og et populært filformat.
Om sjakaler
Hvis man skal komprimere, så skal man komprimere det mest komprimerbare i verden. Det handler selvfølgelig om JPEG-filer. Der findes ikke bare en masse værktøjer og metoder til at indlejre data i dem, men det er også det mest populære grafiske format på denne planet.
Men for ikke at blive hundetræner, skal man begrænse sit arbejdsområde til filer af dette format. Ingen kan lide ensfarvede firkanter, der opstår på grund af overdreven komprimering, så man skal begrænse sig til at arbejde med allerede komprimerede filer, og undgå rekodning. Mere specifikt — med heltalskoefficienter, der forbliver efter processerne, der står for datatab — DCT og kvantisering, hvilket er tydeligt vist i kodningsskemaet (tak til Bauman National Library wiki):
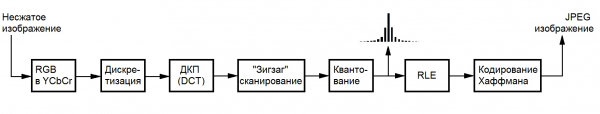
Der findes mange mulige metoder til optimering af jpeg-filer. Der er tabsfri optimering (jpegtran), der findes optimering ““, som faktisk også medfører ændringer, men det vedrører os ikke. For hvis brugeren er villig til at indlejre én information i en anden for at øge den ledige plads på disken, så har han enten allerede optimeret sine billeder, eller han vil slet ikke gøre det af frygt for at miste kvalitet.
F5
Der sådan betingelser passer til en hel familie af algoritmer, som man kan læse om . Den mest avancerede af dem er algoritmen af Andreas Westfeld, der arbejder med lysstyrkekomponenter, da det menneskelige øje er mindst følsomt over for dets ændringer. Desuden bruger den en indlejringsmetode baseret på matrixkodning, hvilket gør det muligt at foretage færre ændringer, når man indlejrer den samme mængde information, jo større størrelsen på den anvendte beholder.
De ændringer, der foretages, reduceres til at mindske den absolutte værdi af koefficienterne med en enhed under bestemte betingelser (dvs. ikke altid), hvilket giver mulighed for at bruge F5 til at optimere dataopbevaring på harddisken. Faktisk vil koefficienten efter sådan en ændring sandsynligvis tage færre bits efter Huffman-kodning på grund af den statistiske fordeling af værdier i JPEG, og de nye nuller vil give fordel ved kodning med RLE.
De nødvendige modifikationer reduceres til at fjerne den del, der svarer til hemmelighed (adgangskode permutering), hvilket sparer ressourcer og eksekveringstid, og tilføje en mekanisme til at håndtere flere filer i stedet for én ad gangen. Processen for ændringen vil næppe være interessant for læseren, så lad os gå videre til beskrivelsen af implementeringen.
Høj teknologi
For at demonstrere effektiviteten af denne tilgang har jeg implementeret metoden i ren C og udarbejdet en række optimeringer både i udførelseshastighed og hukommelse (du vil ikke tro, hvor meget disse billeder vejer uden komprimering selv efter DCT). Platform-uafhængighed er opnået ved at bruge en kombination af biblioteker , og , for hvilket jeg takker dem. Alt dette samles med 'make', så Windows-brugere skal installere Cygwin eller håndtere Visual Studio og bibliotekerne selv.
Implementeringen er tilgængelig som et konsolværktøj og et bibliotek. Flere oplysninger om brugen af sidstnævnte kan interesserede finde i readme-filen i repository på GitHub, hvor jeg vil vedlægge et link i slutningen af indlægget.
Hvordan bruger man det?
Med forsigtighed. De billeder, der bruges til pakning, vælges gennem et søgning ved hjælp af regulære udtryk i den angivne rodkatalog. Når det er afsluttet, kan filer flyttes, omdøbes og kopieres efter ønske inden for det, ændre fil- og operativsystemer, osv. Dog skal man være ekstremt omhyggelig og absolut ikke ændre det umiddelbare indhold. Tab af selv én bit kan føre til, at informationen ikke kan gendannes.
Når programmet er færdigt, efterlader det en speciel arkivfil, der indeholder alle nødvendige oplysninger til udpakkning, inklusive data om de anvendte billeder. Selve filen vejer omkring et par kilobyte og har ikke med nogen væsentlig indflydelse på det optagne diskplads.
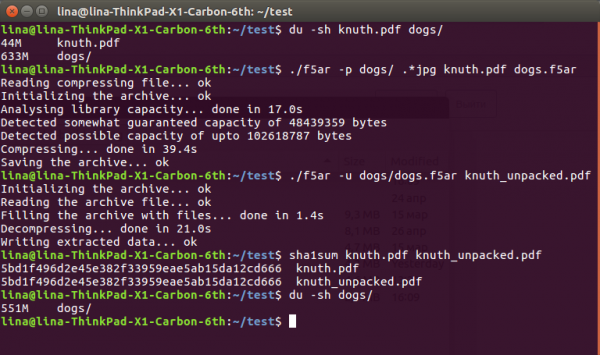
Man kan analysere mulig kapacitet ved hjælp af flaget ‘-a’: ‘./f5ar -a [søgefolder] [Perl-kompatibelt regulært udtryk]’. Pakning udføres med kommandoen ‘./f5ar -p [søgefolder] [Perl-kompatibelt regulært udtryk] [pakket fil] [arkivnavn]’, og udpakkning med ‘./f5ar -u [arkivfil] [navn på gendannet fil]’.
Demonstration af funktionaliteten
For at vise effektiviteten af metoden har jeg uploadet en samling af 225 helt gratis hundefotografier fra tjenesten og fandt en stor pdf-fil på 45 meter af anden bind af Knuth.
Sekvensen er ret simpel:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Læser komprimeringsfilen... ok
Initialiserer arkivet... ok
Analyserer bibliotekskapacitet... færdig på 17.0s
Registreret nogenlunde garanteret kapacitet på 48439359 bytes
Registreret mulig kapacitet på op til 102618787 bytes
Komprimering... færdig på 39.4s
Gemmer arkivet... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Initialiserer arkivet... ok
Læser arkivfilen... ok
Fylder arkivet med filer... færdig på 1.4s
Udpakning... færdig på 21.0s
Skriver udtrukne data... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Screenshots for entusiaster
Den udpakkede fil kan stadig læses, og bør stadig læses:
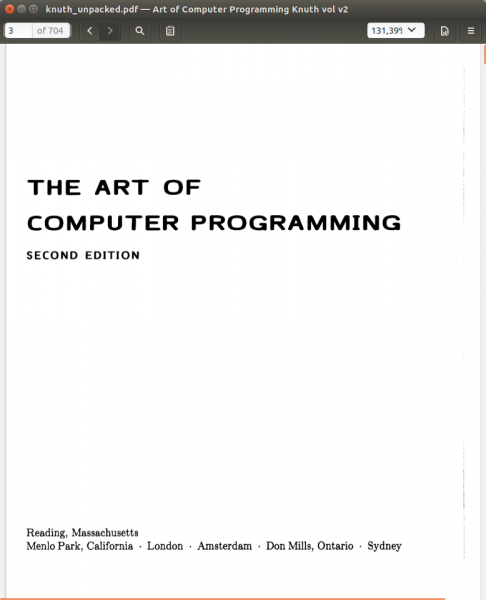
Som det fremgår, er vi fra de oprindelige 633 + 36 == 669 megabyte data på harddisken kommet ned til mere behagelige 551. Sådan en radikal forskel kan forklares med den nævnte reduktion af koefficientværdierne, der påvirker den efterfølgende tabsløse kompression: en reduktion på bare én enhed kan nemt "skære" et par byte fra den endelige fil. Alligevel er dette stadig datatab, omend meget minimalt, som man må leve med.
Heldigvis er de ikke synlige for øjet overhovedet. Under spoileren (da habrastorage ikke kan håndtere store filer) kan læseren vurdere forskellen både visuelt og deres intensitet, opnået ved at trække værdierne for den ændrede komponent fra den originale: , , (jo mere matte farven er, jo mindre forskel i blokken).
Afslutning
Når man ser på alle disse komplikationer, kan det virke meget nemmere at købe en harddisk eller uploade alt til skyen for at løse problemet. Men selvom vi lever i en vidunderlig tid, er der ingen garantier for, at man i morgen stadig vil kunne gå online og uploade sine overskydende data. Eller gå i butikken og købe en ny harddisk på tusind terabyte. Men man kan altid bruge det, man allerede har liggende derhjemme.
->
Kilde: habr.com
