

Den første prototype af objektlagre så dagens lys i 1996. Ti år senere lancerede Amazon Web Services Amazon S3, og verden begyndte langsomt at blive vanvittig over det flade adresseområde. Takket være arbejdet med metadata og evnen til at skalere uden at falde over belastningen, blev objektlagre hurtigt standarden for de fleste cloud-datalagringsservices, og ikke kun det. En anden vigtig egenskab er den gode tilpasning til opbevaring af arkiver og lignende sjældent brugte filer. Alle, der har været involveret i datalagring, jublede og bar den nye teknologi på hænderne.
Men rygterne gik, at objektlagre kun handlede om store cloud-løsninger, og at det ville være meget svært at lave sine egne, hvis man ikke ønskede løsninger fra de forbandede kapitalister. Der er skrevet meget om at sætte sit eget cloud op, men der er ikke meget information om at lave såkaldte S3-kompatible løsninger.
Derfor vil vi i dag se på, hvilke muligheder der findes for 'at have det som de store, og ikke CEPH med værktøjskassen', vi vil opsætte en af dem, og kontrollere, at alt fungerer ved hjælp af Veeam Backup & Replication. Der er annonceret støtte til arbejde med S3-kompatible lagre, og dette vil vi teste.
Hvordan er det hos andre?
Jeg foreslår, at vi starter med et kort overblik over markedet og mulighederne for objektlagre. Den anerkendte leder og standard er Amazon S3. De to nærmeste konkurrenter er Microsoft Azure Blob Storage og IBM Cloud Object Storage.
Er det virkelig alt? Er der ikke andre konkurrenter? Selvfølgelig er der konkurrenter, men nogle går deres egne veje, som Google Cloud eller Oracle Cloud Object Storage, med ufuldstændig støtte til S3 API. Nogle bruger ældre versioner af API'et, som Baidu Cloud. Og nogle, som Hitachi Cloud, kræver anvendelse af særlige logikker, hvilket unægteligt vil skabe sine udfordringer. Under alle omstændigheder sammenlignes alle med Amazon, som man kan betragte som industristandarden.
Men i on-premise løsninger er der langt flere valg, så lad os definere de kriterier, der er vigtige for os. I princippet er det nok med to: støtte til S3 API og brug af v4 signatur. Ærligt talt er det kun interface til interaktion, der interesserer os som kommende kunder, mens den indre funktionalitet af selve lageret ikke interesserer os så meget.
Under these simple conditions, there are many solutions available. For example, the classic corporate heavyweights:
- DellEMC ECS
- NetApp S3 StorageGrid
- Nutanix Buckets
- Pure Storage FlashBlade and StorReduce
- Huawei FusionStorage
There is a niche for purely software solutions that work out of the box:
- Red Hat Ceph
- SUSE Enterprise Storage
- Cloudian
And even those who prefer to carefully refine things after assembly aren't left out:
- CEPH in its purest form
- Minio (Linux version, as the Windows version raises many questions)
The list is far from complete; it can be discussed in the comments. Just remember to check not only API compatibility but also system performance before implementing. The last thing you need is to lose terabytes of data due to hanging requests. So don't hesitate with load testing. Generally, all serious software working with large volumes of data has at least compatibility reports. In the case of Veeam er for mutual testing that allows us to confidently declare full compatibility of our products with specific hardware. This is already a two-way effort, not always quick, but we are constantly expanding our tested solutions.
Let's assemble our stand
I want to talk a bit about choosing a candidate.
First of all, I wanted to find an option that would work out of the box immediately. Or at least with a high probability that it would work without the need for unnecessary maneuvers. Dancing with a tambourine and fiddling with the console at night is very captivating, but sometimes you just want things to work right away. And the overall reliability of such solutions is usually higher. And yes, we have lost our adventurous spirit; we stopped climbing through windows to see our beloved ones, etc. (c).
Secondly, to be honest, the need to work with object storage arises for quite large companies, so this is precisely the case when looking towards enterprise-level solutions is not only not shameful but even encouraged. At least, I don’t know any examples of someone being fired for purchasing such solutions.
Based on all of the above, my choice fell on Dell EMC ECS Community Edition. This is a very interesting project, and I think it’s necessary to tell you about it.
The first thing that comes to mind when seeing the addition Community Edition — det er ikke bare en kopi af den fulde ECS med nogle begrænsninger, der fjernes ved at købe en licens. Sådan er det ikke!
Husk:
!!!Community Edition er et separat projekt, skabt til testformål, og uden support fra Dell!!
Og det kan ikke omdannes til en fuld ECS, selvom man virkelig ønsker det.
Lad os finde ud af det
Mange mener, at Dell EMC ECS er næsten den bedste løsning, hvis du har brug for en objektlager. Alle projekter under ECS-mærket, inklusive kommercielle og virksomhedsløsninger, ligger på . Det er en udsøgt gestus fra Dell. Udover softwaren, der kører på deres brandede hardware, findes der en open source-version, som kan installeres hvor som helst, enten i skyen, på en virtuel maskine, i en container eller på dit eget udstyr. Bare så I ved det — der findes endda en OVA-version, som vi vil benytte os af.
Selve DELL ECS Community Edition er en mini-version af den fulde software, der kører på brandede servere fra Dell EMC ECS.
Jeg har fremhævet fire hovedforskelle:
- Ingen krypteringssupport. Trist, men ikke kritisk.
- Fravær af Fabric Layer. Denne funktion er ansvarlig for at opbygge klynger, ressourcestyring, opdateringer, overvågning og lagring af Docker-billeder. Her bliver det virkelig ærgerligt, men Dell kan også forstås.
- Den mest ubehagelige konsekvens af det foregående punkt: node-størrelsen kan ikke udvides efter installationen er afsluttet.
- Ingen support. Dette er et testprodukt, som er tilladt at bruge i små installationer, men personlig ville jeg ikke tørre at lægge petabytes af vigtige data der. Men teknisk set kan ingen forhindre dig i at gøre det.
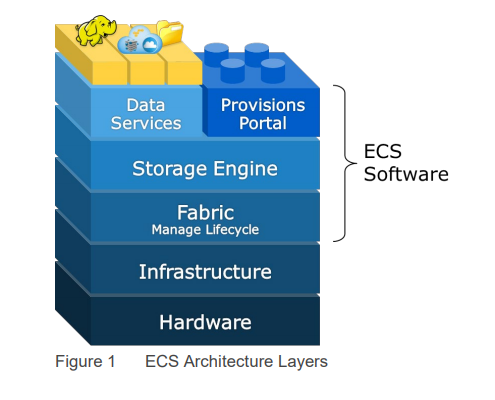
Hvad med den store version?
Lad os hastigt gennemgå de hardwareløsninger for at få et mere fuldstændigt billede af økosystemet.
Jeg vil ikke bekræfte eller afkræfte påstanden om, at DELL ECS er det bedste on-prem objektlager, men hvis du har noget at sige om emnet, vil jeg gerne læse det i kommentarerne. I hvert fald ifølge Dell EMC er solidt placeret blandt de fem førende OBS-markeder. Selvom cloud-baserede løsninger ikke tages med i betragtning, men det er en anden samtale.
Fra et teknisk synspunkt er ECS et objektlager, der giver adgang til data via cloud storage-protokoller. Det understøtter AWS S3 og OpenStack Swift. For fil-aktiverede buckets understøtter ECS NFSv3 for filbaseret eksport.
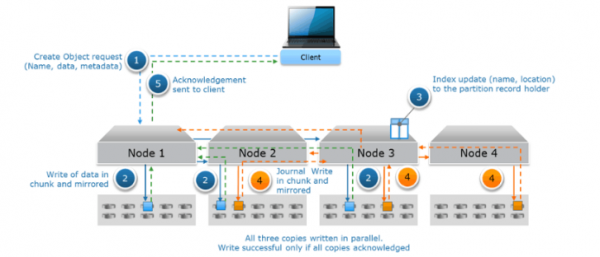
Processen med at optage information er ret usædvanlig, især sammenlignet med klassiske bloklagringssystemer.
- Når nye data ankommer, oprettes der et nyt objekt, som har et navn, selve dataene og metadata.
- Objekterne opdeles i chunks på 128 MB, og hver chunk skrives straks til tre noder.
- En opdatering af indeksfilen foretages, hvor identifikatorer og lagringssteder er skrevet.
- Logfilen opdateres (optagelseslog) og skrives også til tre noder.
- Klienten modtager en meddelelse om, at optagelsen var succesfuld.
Alle tre kopier af dataene skrives parallelt. Optagelsen betragtes som succesfuld, kun hvis alle tre kopier er blevet skrevet korrekt.
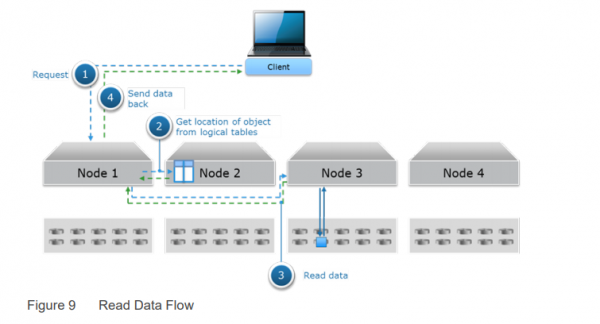
Læseprocessen er mere ligetil:
- Klienten anmoder om data.
- Der søges efter lagringsstedet i indekset.
- Data læses fra én node og sendes til klienten.
Der er mange servere, så lad os se på den mindste, Dell EMC ECS EX300. Den starter fra 60 TB og kan vokse op til 1,5 PB. Dens storebror, Dell EMC ECS EX3000, kan allerede lagre op til 8,6 PB pr. rack.
Deploy
Teknisk set kan Dell ECS CE implementeres i en hvilken som helst størrelse. Jeg har dog ikke fundet nogen åbenlyse begrænsninger. Men al skalering er praktisk at udføre ved at klone den første node, for hvilken vi har brug for:
- 8 vCPU
- 64 GB RAM
- 16 GB til operativsystemet
- 1 TB direkte til lagring
- Den seneste version af CentOS minimal
Dette er et valg, når du ønsker at installere alt selv fra begyndelsen. For os er dette valg ikke aktuelt, da jeg vil bruge en OVA-billed til deployment.
Men under alle omstændigheder er kravene ret strenge selv for én node, og hvis man strengt følger lovens bogstav, skal der være fire noder.
Dog lever udviklerne af ECS CE i den virkelige verden, og installationen forløber succesfuldt selv med én node, og de minimale krav er som følger:
- 4 vCPU
- 16 GB RAM
- 16 GB til operativsystemet
- 104 GB til selve lageret
Netop disse ressourcer er nødvendige for implementeringen af OVA-billedet. Meget mere rimeligt og realistisk.
Den installerende node kan hentes fra den officielle . Der findes også detaljeret dokumentation om alt-i-én deployment, men du kan også læse på den officielle . Derfor vil vi ikke gå i detaljer med OVA distribution, det er ret ligetil. Det vigtigste er, at du ikke glemmer at enten udvide disken til den nødvendige størrelse, eller tilslutte de nødvendige.
Vi starter maskinen, åbner konsollen og bruger de bedste standardoplysninger:
- brugernavn: admin
- adgangskode: ChangeMe
Derefter kører vi sudo nmtui og konfigurerer netværksinterfacet – IP/masker, DNS og gateway. Husk, at der i CentOS minimal ikke er net-tools, så tjek indstillingerne via ip addr.
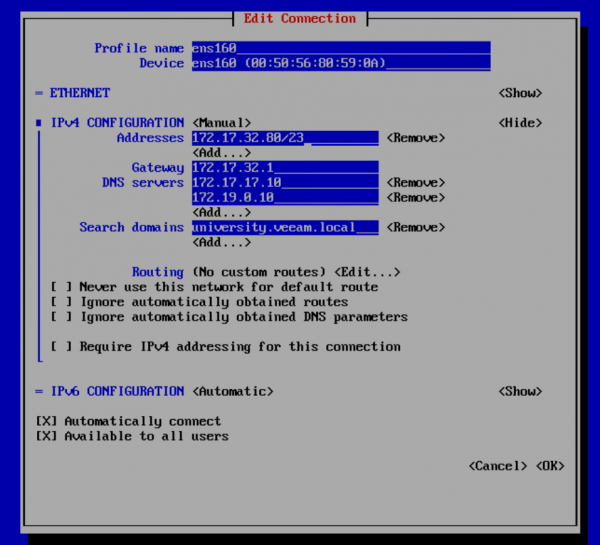
Og da det kun er de modige, der erobrer havene, laver vi en yum update og genstarter derefter. Faktisk er det ret sikkert, da hele distributionen foregår via playbooks, og alle vigtige Docker-pakker er låst til den nuværende version.
Det er nu tid til at redigere installationsscriptet. Ingen flotte vinduer eller pseudo UI – alt gøres via din yndlings teksteditor. Rent teknisk er der to måder: du kan køre hver kommando manuelt, eller du kan straks starte konfigurationsprogrammet videploy. Det åbner bare konfigurationen i vim, og når du afslutter, vil det køre en kontrol. Men det er ikke interessant at gøre livet lettere, så vi udfører to kommandoer mere. Selvom der ikke er nogen mening i det, har jeg advaret dig =)
Så vi laver vim ECS-CommunityEdition/deploy.xml og laver de optimalt minimale ændringer, så ECS kan aktiveres og fungere. Parameterlisten kan forkortes, men jeg gjorde det sådan her:
- licensed_accepted: true Du kan også lade være med at ændre det; ved deployment vil de klart bede dig om at acceptere det og vise en sød besked. Måske er det endda en påskeæg.

- Fjern kommenteringen på linjerne autonames: og custom: Indtast mindst ét ønsket navn til noden – værtsnavnet vil blive erstattet med det i installationsprocessen.
- install_node: 192.168.1.1 Angiv den reelle IP adresse for noden. I vores tilfælde angiver vi den samme som i nmtui
- dns_domain: indtast dit domæne.
- dns_servers: indtast din dns.
- ntp_servers: du kan angive en hvilken som helst. Jeg tog den første, jeg kunne finde fra puljen 0.pool.ntp.org (som blev 91.216.168.42)
- autonaming: custom Hvis jeg ikke fjerner kommentaren, så vil månen blive kaldt Luna.
- ecs_block_devices:
/dev/sdb
Af ukendte grunde kan der være en ikke-eksisterende bloklagringsenhed /dev/vda her - storage_pools:
members:
192.168.1.1 Her angiver vi igen den reelle IP adresse for noden - ecs_block_devices:
/dev/sdb Повторяем операцию вырезания несуществующих устройств.

Hele filen er meget detaljeret beskrevet i , men hvem vil læse den i så urolige tider? Der står jo, at minimumskravet er at angive IP-adresse og maske, men i mit lab fungerede den opsætning ikke særlig godt, så jeg måtte udvide den til det nævnte ovenfor.
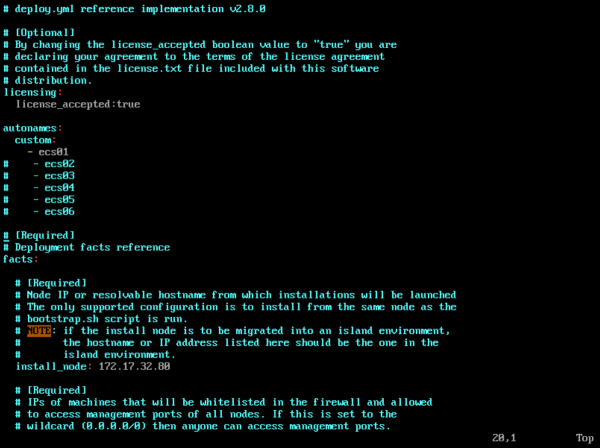
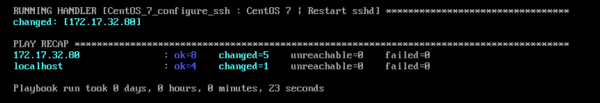
Efter at have forladt redaktøren skal du køre update_deploy /home/admin/ECS-CommunityEdition/deploy.yml, og hvis alt er udført korrekt, vil dette blive meldt tydeligt.
Derefter skal du stadig køre videploy, vente på, at miljøet opdateres, og så kan du starte installationen med kommandoen ova-step1, og efter dens vellykkede gennemførelse kommandoen ova-step2. Det er vigtigt: stop ikke scripts håndgribeligt! Nogle skridt kan tage betydelig tid, blive udført ikke ved første forsøg og se ud som om, at alting er brudt ned. Under alle omstændigheder skal du vente på, at scriptet afsluttes naturligt. Til sidst skal du se en besked, der ligner denne.
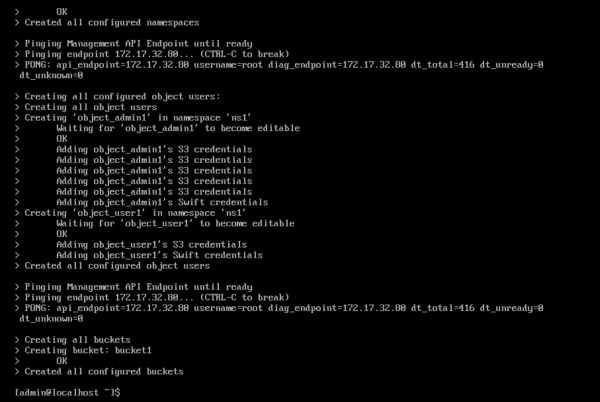
Nu kan vi endelig åbne WebUI kontrolpanelet på den IP-adresse, som vi kender. Hvis vi ikke ændrede noget under konfigurationen, vil den standard konto være root/ChangeMe. Du kan endda straks begynde at bruge vores S3-kompatible lagring. Den er tilgængelig på porte 9020 for HTTP og 9021 for HTTPS. Igen, hvis intet er ændret, vil access_key: object_admin1 og secret_key: ChangeMeChangeMeChangeMeChangeMeChangeMe.
Men lad os ikke komme for langt foran og starte i den rigtige rækkefølge.
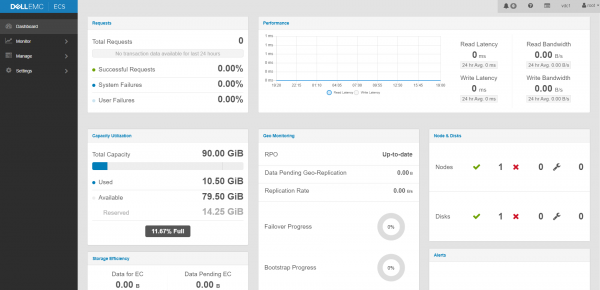
Ved første login vil du blive tvunget til at ændre din adgangskode til en mere anstændig, hvilket er helt korrekt. Hoveddashboardet er meget forståeligt, så lad os gøre noget mere interessant end at forklare åbenlyse målinger. For eksempel, lad os oprette en bruger, som vi vil bruge til at få adgang til lageret. I verdenen af serviceudbydere kaldes de sådan noget for tenant. Dette gøres i Manage > Users > New Object User
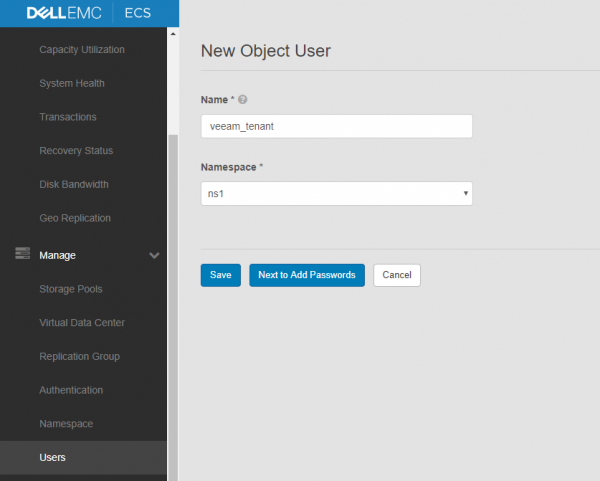
Når vi opretter en bruger, bliver vi bedt om at angive et namespace. Teknisk set er der intet, der forhindrer os i at oprette så mange, som der er brugere. Og omvendt. Dette muliggør uafhængig styring af ressourcer for hver tenant.
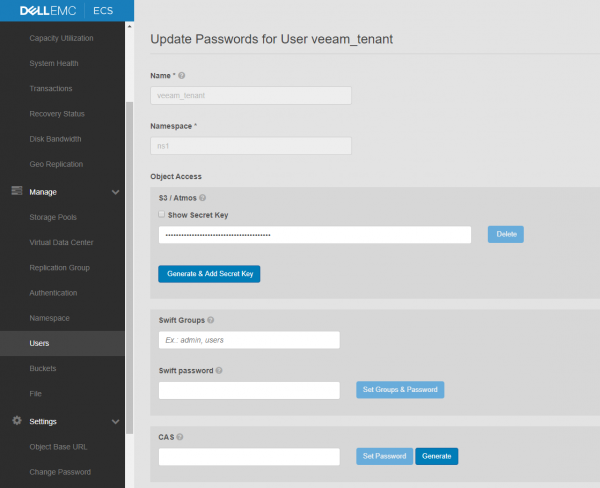
Vi vælger derfor de nødvendige funktioner og genererer brugerens nøgler. Jeg har brug for S3/Atmos. Og glem ikke at gemme nøglen 😉
Brugeren er oprettet, nu er det tid til at give ham en bucket. Vi går til Manage > Bucket og udfylder de nødvendige felter. Det er ret simpelt.
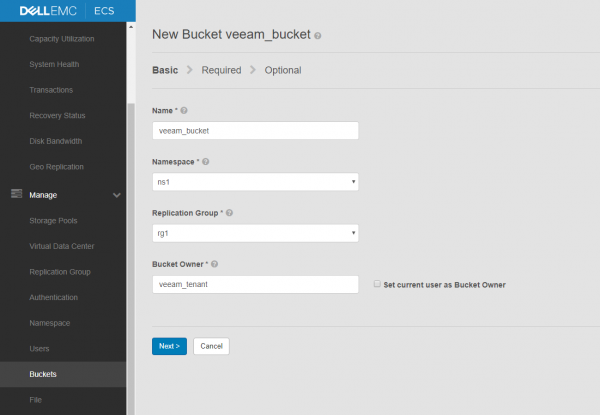
Nu er vi klar til at bruge vores S3-lagring i fuld størrelse.
Vi konfigurerer Veeam
Så, som vi husker, er en af de primære anvendelser af objektslagre langvarig opbevaring af oplysninger, som sjældent benyttes. Et ideelt eksempel er behovet for at opbevare backups på en ekstern placering. I Veeam Backup & Replication kaldes denne funktion Capacity Tier.
Lad os starte konfigurationen med at tilføje vores Dell ECS CE i Veeam-grænsefladen. På fanen Backup Infrastructure starter vi guiden til at tilføje et nyt repository og vælger objektlagring.
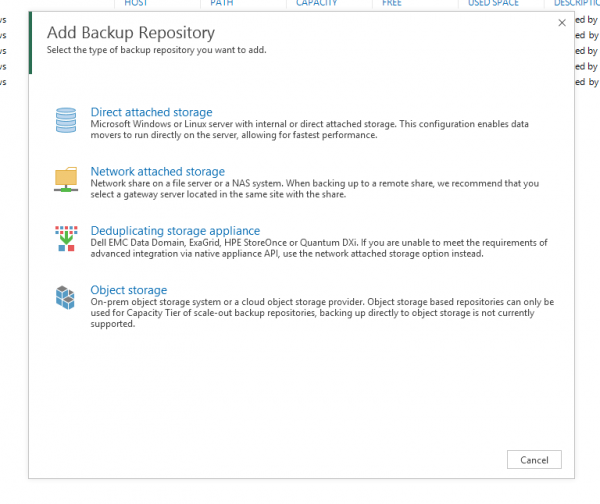
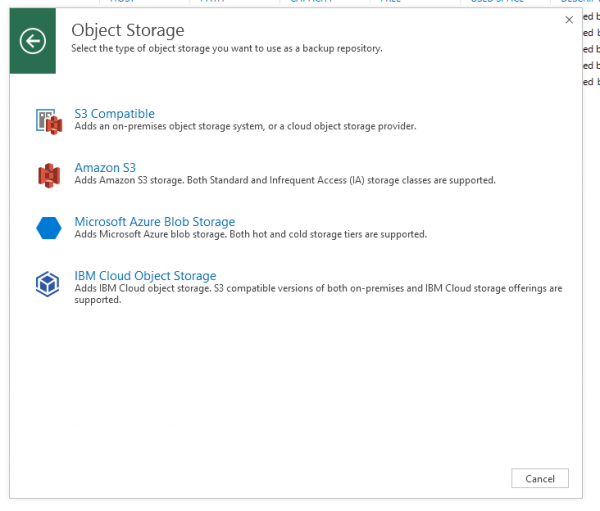
Vi vælger det, som hele formålet var — S3-kompatibel.
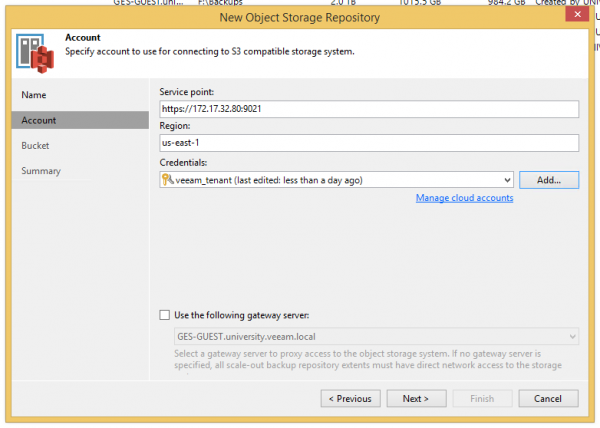
I det fremkomne vindue skriver vi det ønskede navn og går videre til trin Konto. Her skal vi angive Service point som , regionen kan forblive som den er, og tilføje den oprettede bruger. En gateway-server er nødvendig, hvis dit lager er placeret eksternt, men det er allerede et emne om optimering af infrastrukturen og en separat artikel, så det kan vi roligt springe over her.
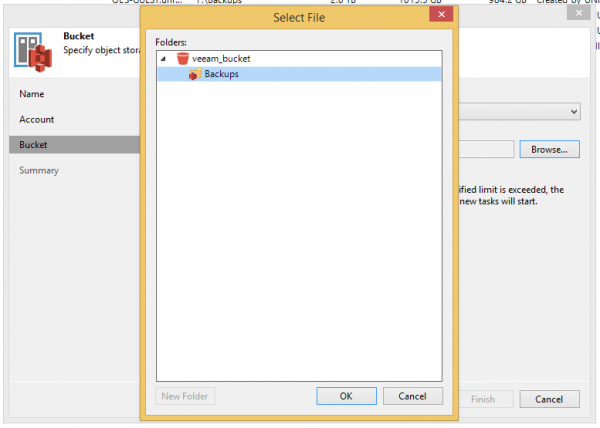
Hvis alt er angivet og konfigureret korrekt, vises en advarsel om certifikatet, og derefter et vindue med bucket, hvor du kan oprette en mappe til vores filer.
Vi gennemfører guiden til slut og nyder resultatet.
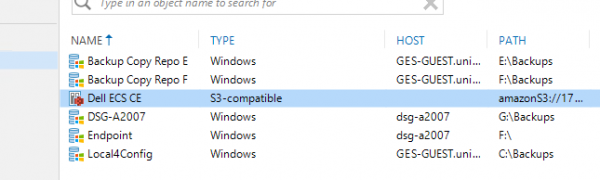
På næste trin skal du enten oprette et nyt Scale-out Backup Repository eller tilføje vores S3 til det eksisterende — det vil blive brugt som Capacity Tier til arkivopbevaring. I den nuværende release er der ikke funktioner til direkte at bruge S3-kompatible lagre som et almindeligt repository. Der er for mange ret uklar problemer, der skal løses, men alt kan lade sig gøre.
Gå ind i repository-indstillingerne og aktiver Capacity Tier. Alt er klart der, men der er en interessant nuance: hvis du vil have, at alle data skal sendes til objektslageret hurtigst muligt, så sæt blot til 0 dage.
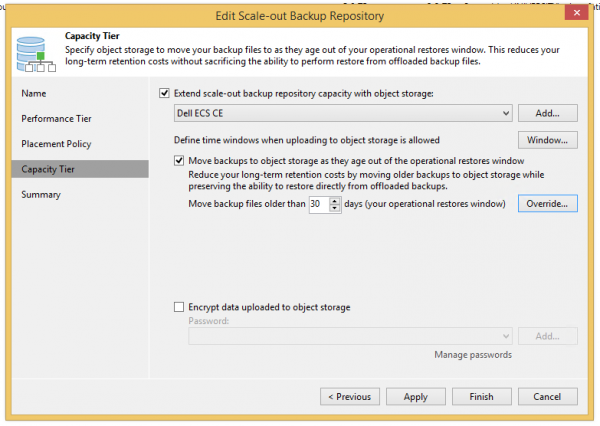
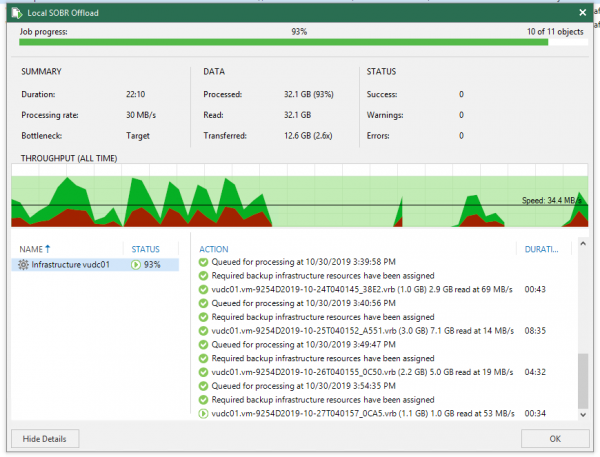
Efter at have gennemført guiden, hvis du ikke ønsker at vente, kan du trykke ctrl+MK på repositoryet, tvangs starte Tiering job og se, hvordan graferne begynder at stige.
Det er alt for nu. Jeg mener, at jeg har løst opgaven med at vise, at bloklagre ikke er så skræmmende, som man ofte tror. Ja, der er mange løsninger og udtryksformer, men det er ikke muligt at dække alt i en enkelt artikel. Så lad os dele erfaringer i kommentarerne.
Kilde: habr.com
