

Introduktion
Hej!
I denne artikel vil jeg dele erfaringer med at opbygge en mikrotjenestearkitektur til et projekt, der bruger neurale netværk.
Lad os tale om kravene til arkitekturen, se på forskellige strukturelle diagrammer, gennemgå hver af komponenterne i den færdige arkitektur, samt vurdere de tekniske metrikker for løsningen.
God læselyst!
Et par ord om opgaven og dens løsning
Hovedidéen er at vurdere en persons tiltrækningskraft baseret på billeder på en skala fra 1 til 10.
I denne artikel vil vi ikke komme ind på hverken de anvendte neurale netværk eller dataforberedelse og træning. Men i en af de kommende publikationer vil vi bestemt vende tilbage til en dybere gennemgang af vurderingspipelines.
Lige nu vil vi overordnet gennemgå vurderingspipelinen og fokusere på samspillet mellem mikrotjenesterne i konteksten af projektets samlede arkitektur.
Når man arbejder med vurderingspipelinen for tiltrækningskraft, blev opgaven opdelt i følgende komponenter:
- Ansigtsgenkendelse på billeder
- Vurdering af hvert ansigt
- Rendering af resultatet
Det første løses med en fortrænet . Til det andet blev en konvolutionel neurale netværk trænet i PyTorch, hvor blev brugt som backbone med fokus på "kvalitet / hastighed ved inference på CPU".
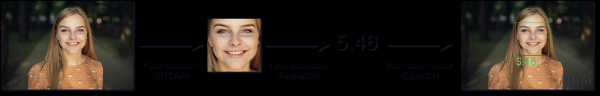
Funktionsdiagram for vurderingspipelinens struktur
Analyse af kravene til projektarkitekturen
I livscyklussen er faserne med at arbejde på arkitekturen og automatisering af implementeringen af modellen ofte de mest tid- og ressourcekrævende.
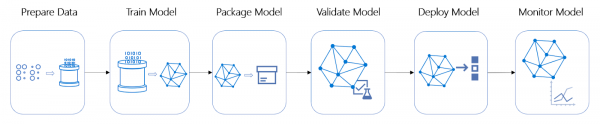
Livscyklussen for ML-projekter
Dette projekt er ingen undtagelse – der blev taget beslutning om at pakke vurderingspipelinen ind i en online service, hvilket krævede dybdegående forståelse af arkitekturen. De grundlæggende krav blev fastlagt:
- Et centralt logopbevaringssystem – alle tjenester skal skrive logfiler til ét sted, og disse skal være nemme at analysere.
- Mulighed for horisontal skalering af vurderingstjenesten — som den mest sandsynlige flaskehals.
- Der skal tildeles det samme antal CPU-ressourcer til vurderingen af hvert billede — for at undgå udsving i tidsfordelingen for inference.
- Hurtig (gen)implementering af både specifikke tjenester og stakken som helhed.
- Mulighed for, om nødvendigt, at anvende fælles objekter i forskellige tjenester.
Arkitektur
Efter analysen af krav blev det klart, at mikrotjenestearkitekturen passer næsten perfekt.
For at slippe for unødige hovedpiner blev Telegram API valgt som frontend.
Lad os først se på den strukturelle diagram over den færdige arkitektur, derefter går vi videre til beskrivelsen af hver komponent og formaliserer processen for succesfuld billedbehandling.
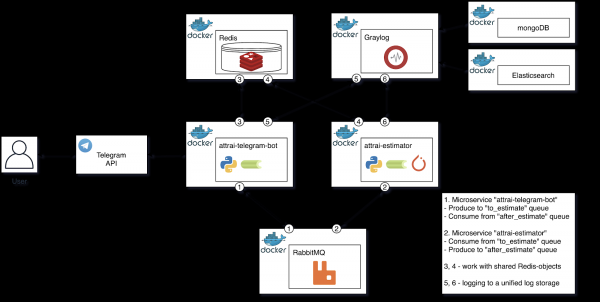
Strukturelt diagram over den færdige arkitektur
Lad os tale mere om hver komponent i diagrammet og definere deres Single Responsibility i vurderingsprocessen af billedet.
Mikrotjeneste «attrai-telegram-bot»
Denne mikrotjeneste inkapslerer al interaktion med Telegram API. Vi kan fremhæve to hovedscenarier – arbejde med brugerens billede og arbejde med resultatet fra vurderingspipen. Lad os gennemgå begge scenarier i al almindelighed.
Når et brugerbesked med billede modtages:
- Der udføres en filtrering bestående af følgende tjek:
- Tilstedeværelsen af det optimale billede størrelse
- Antallet af billeder fra brugeren, der allerede er i køen
- Ved bestået initial filtrering gemmes billedet i docker volume
- I køen “to_estimate” prodes en opgave, der blandt andet indeholder stien til billedet, der ligger i vores volume
- Hvis de tidligere nævnte trin er gennemført succesfuldt – vil brugeren modtage en meddelelse med et skøn over behandlingstiden for billedet, som beregnes ud fra antallet af opgaver i køen. I tilfælde af en fejl vil brugeren blive klart informeret om det – ved at sende en meddelelse med oplysninger om, hvad der kunne være gået galt.
Desuden lytter denne mikrotjeneste, som en celery worker, til køen «after_estimate», som er beregnet til opgaver, der har passeret vurderingspipen.
Når en ny opgave modtages fra “after_estimate”:
- Hvis billedet er blevet behandlet succesfuldt – sender vi resultatet til brugeren, hvis ikke – informerer vi om fejlen
- Fjerner billedet, der er resultatet fra vurderingspipen
Mikrotjenesten til vurdering «attrai-estimator»
Denne mikrotjeneste er en celery worker og inkapsler alt, hvad der har at gøre med vurderingspipen for billeder. Arbejdsalgoritmen her er entydig – lad os gennemgå den.
Når en ny opgave modtages fra “to_estimate”:
- Kører billedet gennem vurderingspipen:
- Indlæser billedet i hukommelsen
- Tilpasser billeder til den ønskede størrelse
- Finder alle ansigtstræk (MTCNN)
- Vurderer alle ansigtstræk (pakker ansigtstræk fundet i det tidligere punkt i en batch og udfører inferens med ResNet34)
- Renderer det endelige billede
- Tegner bounding boxes
- Tegner vurderinger
- Fjerner brugerens (oprindelige) billede
- Gemmer output fra vurderings-pipelinen
- Lægger opgaven i køen 'after_estimate', som den tidligere nævnte mikrotjeneste 'attrai-telegram-bot' lytter på
Graylog (+ mongoDB + Elasticsearch)
— er en løsning til centraliseret logstyring. I dette projekt blev den brugt til sit primære formål.
Valget faldt netop på den, og ikke den velkendte stak, på grund af bekvemmeligheden ved at arbejde med den fra Python. Alt, hvad der kræves for at logge til Graylog, er at tilføje GELFTCPHandler fra pakken til de øvrige root logger handlers i vores python-mikrotjeneste.
Som en person, der tidligere kun har arbejdet med ELK-stakken, havde jeg generelt en positiv oplevelse under arbejdet med Graylog. Det eneste, der skuffede, var Kibanas overlegenhed i funktioner i forhold til Graylogs webgrænseflade.
RabbitMQ
— er en beskedbroker baseret på AMQP-protokollen.
I dette projekt blev den brugt som broker for Celery og arbejdede i durable tilstand.
Redis
— er en NoSQL database, der arbejder med dataløsninger af typen 'nøgle-værdi'
Nogle gange er der behov for at bruge fælles objekter i forskellige python-mikrotjenester, der implementerer nogle dataløsninger.
For eksempel, i Redis gemmes der en hashmap i formatet 'telegram_user_id => antal aktive opgaver i køen', hvilket gør det muligt at begrænse antallet af anmodninger fra en bruger til et bestemt beløb og dermed forhindre DoS-angreb.
Formaliserer processen for succesfuld billedbehandling
- Brugeren sender et billede til Telegram-boten
- 'attrai-telegram-bot' modtager en besked fra Telegram API og analyserer den
- Opgaven med billedet tilføjes i den asynkrone kø 'to_estimate'
- Brugeren modtager en besked med den planlagte vurderingstid
- 'attrai-estimator' henter opgaven fra køen 'to_estimate', kører den gennem vurderingspipelinen og producerer opgaven til køen 'after_estimate'
- 'attrai-telegram-bot', der lytter på køen 'after_estimate', sender resultatet til brugeren
DevOps
Endelig, efter at have gennemgået arkitekturen, kan vi gå videre til den ikke mindre interessante del — DevOps
Docker Swarm
— et clustersystem, hvis funktionalitet er indbygget i Docker Engine og tilgængelig fra starten.
Ved hjælp af "swarm" kan alle noder i vores cluster opdeles i 2 typer – worker og manager. På maskiner af den første type køres grupper af containere (stacks), mens maskiner af den anden type er ansvarlige for skalering, belastningsfordeling og . Managere fungerer som standard også som workere.
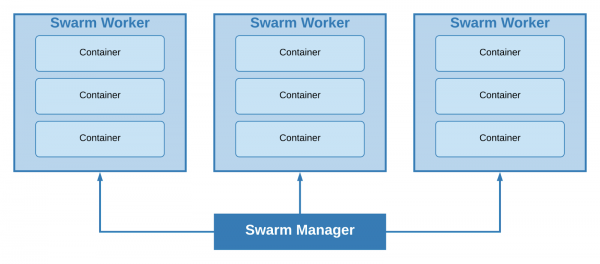
Et cluster med en leader manager og tre workere
Den mindste mulige størrelse på et cluster er 1 node, hvor den eneste maskine samtidig vil fungere som både leader manager og worker. Baseret på projektets størrelse og de minimale krav til fejltolerance blev beslutningen truffet om at anvende netop denne tilgang.
For at springe fremad kan jeg sige, at siden den første produktionsudrulning i midten af juni, har der ikke været problemer relateret til denne organisering af clustret (men det betyder ikke, at en sådan organisering på nogen måde er acceptabel i enhver mellem-til-stor størrelse projekter, der stiller krav til fejltolerance).
Docker Stack
I "swarm"-tilstand er det
der er ansvarlig for udrulning af stacks (sæt af docker services).
For eksempel blev ressourcerne for hver instans af vurderingsmikroservicen begrænset ved hjælp af disse parametre (vi tildeler N kerner til N instanser, i selve mikroservicen begrænser vi antallet af kerner, der bruges af PyTorch, til én)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Det er vigtigt at bemærke, at Redis, RabbitMQ og Graylog er stateful tjenester, og det vil ikke være så nemt at skalere dem som "attrai-estimator".
Forudseende spørgsmålet – hvorfor ikke Kubernetes?
Det virker som om brugen af Kubernetes i små og mellemstore projekter er en overkill; al nødvendig funktionalitet kan opnås fra Docker Swarm, som er ret brugervenlig som containerorkestrator og har en lav indgangsbarrière.
Infrastruktur
Dette blev udrullet på en VDS med følgende specifikationer:
- CPU: 4 kerner Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Efter lokale belastningstest så det ud til, at denne maskine ville være tilstrækkelig til at håndtere et stort antal brugere.
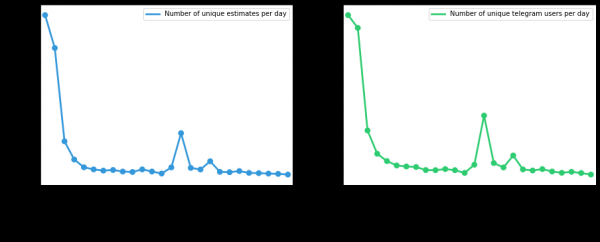
Men lige efter deployment postede jeg et link til en af de mest populære imageboards i СНГ (ja, den samme), hvorefter folk blev interesseret, og efter få timer havde tjenesten succesfuldt behandlet titusindvis af billeder. I spidserne blev CPU- og RAM-ressourcerne ikke engang brugt til halvdelen.
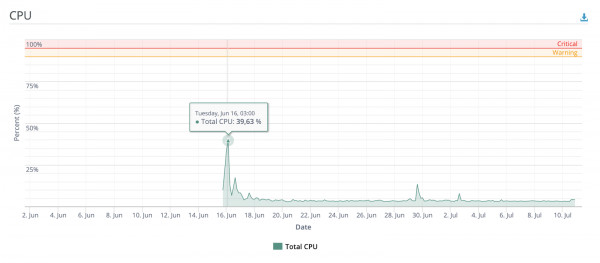
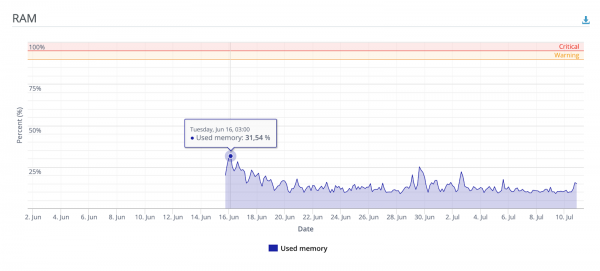
Lidt flere grafer
Antallet af unikke brugere og forespørgsler om vurdering siden deployment, afhængig af dagen
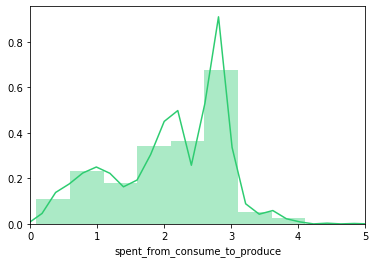
Fordelingen af inferencetid for vurderingspipeline
Konklusioner
For at opsummere kan jeg sige, at arkitekturen og tilgangen til orkestrering af containere fuldt ud har været værdifulde – selv i spidserne var der ingen nedbrud eller forsinkelser i behandlingstiden.
Jeg mener, at små og mellemstore projekter, der bruger realtidsinferens af neurale netværk på CPU i deres processer, med succes kan overtage de metoder, der er beskrevet i denne artikel.
Jeg vil tilføje, at artiklen oprindeligt var længere, men for ikke at poste en lang tekst besluttede jeg at udelade nogle punkter i denne artikel – vi vender tilbage til dem i følgende publikationer.
Du kan chatte med botten i Telegram – @AttraiBot, den vil fungere, i det mindste til slutningen af efteråret 2020. Jeg minder om – ingen brugerdata opbevares – hverken de originale billeder eller resultaterne fra vurderingspipen – alt slettes efter behandling.
Kilde: habr.com
