

I dag flytter flere og flere virksomheder deres infrastruktur fra fysiske servere og egne virtualiseringsløsninger til skyen. Denne løsning kan let forklares: der er ikke behov for at bekymre sig om hardware, og klyngen kan konfigureres på mange forskellige måder... og vigtigst af alt – de eksisterende teknologier (som Kubernetes) gør det muligt nemt at skalere beregningskraften afhængigt af belastningen.
Den finansielle aspekter er altid vigtige. Værktøjet, som vi vil tale om i denne artikel, er designet til at hjælpe med at reducere budgetterne ved brug af skyinfrastruktur med Kubernetes.
Introduktion
– en californisk startup grundlagt af tidligere Google-medarbejdere, der skaber en løsning til at måle omkostningerne ved infrastruktur i skytjenester (inden for Kubernetes-klyngen + fælles ressourcer), finde flaskehalse i klyngeindstillingerne og sende de relevante beskeder til Slack.
Vi har kunder med Kubernetes både i de velkendte skyer AWS og GCP samt i det mindre almindelige Azure for Linux-samfundet – generelt på alle platforme understøttet af Kubecost. For nogle af dem beregner vi omkostningerne til interne klyngetjenester selvstændigt (ved en metode, der ligner den, Kubecost bruger), og vi overvåger også omkostningerne til infrastrukturen og arbejder på at optimere dem. Derfor er det logisk, at vi blev interesseret i muligheden for at automatisere sådanne opgaver.
Kildekoden til hovedmodulet af Kubecost er åben på vilkår af Open Source-licens (Apache License 2.0). Den kan bruges frit, og de tilgængelige funktioner bør være tilstrækkelige til små projekter. Men forretning er forretning: den resterende del af produktet er lukket, og den kan bruges ved , som også indebærer kommerciel support. Derudover tilbyder forfatterne en gratis licens til små klynger (1 klynge med 10 noder – mens denne artikel blev skrevet, blev denne grænse udvidet til 20 noder) eller en prøveperiode med fulde muligheder i 1 måned.
Hvordan alt er arrangeret
Så den primære del af Kubecost er en applikation , skrevet i Go. Helm-diagrammet, der beskriver hele systemet, kaldes og er i sin essens en samling af cost-model med Prometheus, Grafana og flere dashboards.
Generelt har cost-model sin egen webgrænseflade, som viser diagrammer og detaljerede statistikker om omkostninger i tabelvisning samt selvfølgelig råd om optimering af udgifter. De dashboards, der præsenteres i Grafana, er en tidligere fase i udviklingen af Kubecost og indeholder delvist de samme data som cost-model, suppleret med den sædvanlige statistik om forbrug af CPU/memory/netværk/diskplads i klyngen og dens komponenter.
Hvordan fungerer Kubecost?
- Cost-model hentede priser på service via API'er fra cloud-udbydere.
- Derefter beregnes omkostningerne pr. knude afhængig af den fysiske knudetype og region.
- Baseret på driftsomkostningerne for knuderne tildeles hver enkelt pod omkostninger pr. time for brug af CPU, forbrug af gigabyte hukommelse og omkostninger pr. time for opbevaring af en gigabyte data - afhængigt af den knude, den har kørt på, eller typen af lager.
- Baseret på omkostningerne for de enkelte pods beregnes betalingen for navneområder, tjenester, deployments og statefulsets.
- Til beregning af statistikken anvendes metrikker, der leveres af kube-state-metrics og node-exporter.
Det er vigtigt at overveje, at Kubecost som standard kun tager højde for ressourcer, der er tilgængelige i Kubernetes. Eksterne databaser, GitLab-servere, S3-lagre og andre tjenester, der ikke findes i klyngen (selvom de er i samme cloud), er ikke synlige for det. Selvom man for GCP og AWS kan tilføje nøgler til sine servicekonti og beregne alt sammen.
Installation
For at Kubecost kan fungere, kræves der:
- Kubernetes version 1.8 og højere;
- kube-state-metrics;
- Prometheus;
- node-exporter.
Det viser sig, at i vores klynger blev alle disse betingelser opfyldt på forhånd, så det var tilstrækkeligt blot at angive den korrekte endpoint for adgang til Prometheus. Ikke desto mindre indeholder den officielle Helm-chart kubecost alt, hvad der er nødvendigt for at starte op i en 'ren' klynge.
Kubecost kan installeres på flere måder:
- Den standard installationsmetode, der er beskrevet i på udviklerens hjemmeside. Du skal tilføje cost-analyzer til Helm-repositoriet og derefter installere chartet. Du skal blot fritage dig selv et port og justere indstillingerne til den ønskede tilstand manuelt (via kubectl) og/eller ved hjælp af webgrænsefladen for cost-model.
Vi har faktisk ikke prøvet denne metode, da vi ikke bruger færdige tredjepartskonfigurationer, men den ser ud til at være et godt valg for "bare at prøve for sig selv". Hvis du allerede har installeret nogle af systemkomponenterne eller ønsker en mere finjusteret opsætning, er det bedre at overveje den anden vej.
- Bruge i bund og grund , men konfigurere og installere den selvstændigt på enhver ønskelig måde.
Som allerede nævnt indeholder denne chart, udover selve kubecost, også charts for Grafana og Prometheus, som også kan konfigureres efter eget ønske.
Den tilgængelige chart
values.yamlfor cost-analyzer gør det muligt at konfigurere:- listen over komponenter til cost-analyzer, der skal implementeres;
- din egen endpoint for Prometheus (hvis du allerede har en);
- domæner og andre indstillinger af ingress for cost-model og Grafana;
- annoteringer til pod'er;
- behovet for brug af permanente lagringsenheder og deres størrelse.
Den fulde liste over tilgængelige konfigurationsmuligheder med beskrivelser findes i .
Da kubecost i sin grundversion ikke kan begrænse adgangen, skal basic-auth for webpanelet konfigureres med det samme.
- Installer kun systemets kerne — cost-model. For dette kræves det, at Prometheus er installeret i klyngen, og det relevante værdi for dets adresse angives i variablen
prometheusEndpointtil Helm. Efter dette skal du anvende i klyngen.Igen skal Ingress med basic-auth tilføjes manuelt. Og endelig skal der tilføjes en sektion til indsamling af metrics fra cost-model i
extraScrapeConfigsi Prometheus-konfigurationen:- job_name: kubecost honor_labels: true scrape_interval: 1m scrape_timeout: 10s metrics_path: /metrics scheme: http dns_sd_configs: - names: - type: 'A' port: 9003
Hvad får vi?
Ved en fuld installation får vi adgang til kubecosts webpanel og Grafana med et sæt dashboards.
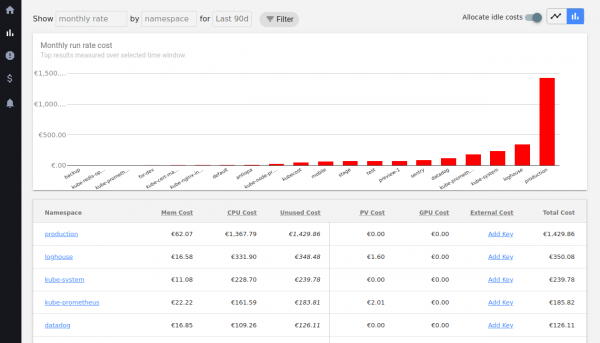
Total cost, der vises på hovedskærmen, viser faktisk den beregnede omkostning for ressourcer pr. måned. Dette er den forudsete pris, der viser omkostningerne ved brug af klyngen (pr. måned) ved det nuværende niveau af ressourceforbrug.
Denne metrik er mere til analyse af udgifter og deres optimering. Det er ikke særlig praktisk at se de samlede omkostninger for en abstrakt juli i kubecost: det må man gå til fakturering. Men man kan se udgifter opdelt efter navneområdet, labels, pods for 1/2/7/30/90 dage, hvilket faktureringen aldrig vil vise dig.
For resten om labels. Det er en god idé straks at gå ind i indstillingerne og angive navne på labels, som vil blive brugt som ekstra kategorier til at gruppere omkostninger:
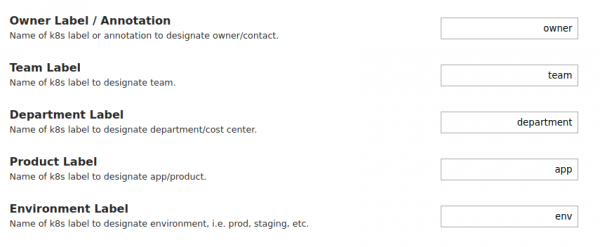
Du kan knytte alle mulige labels til dem - det er praktisk, hvis du allerede har dit eget mærkningssystem.
Derudover kan du ændre adressen til API endpoint'et, som cost-modelen tilslutter sig, indstille størrelsen på rabatten i GCP og angive dine egne priser på ressourcer og valuta til måling (denne funktion påvirker tilsyneladende ikke den samlede omkostning).
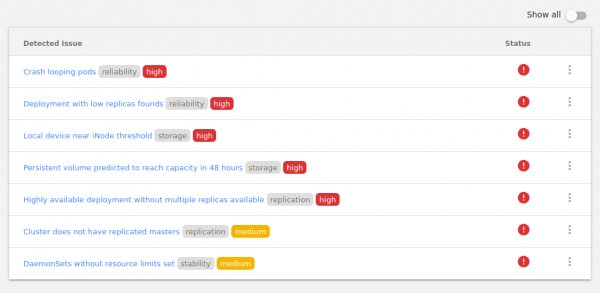
Kubecost kan vise forskellige problemer i klyngen (og endda sende advarsler i tilfælde af fare). Desværre kan denne mulighed ikke indstilles, og derfor - hvis du har udviklingsmiljøer, der anvendes, kan du konstant se noget lignende:
Et vigtigt værktøj er - Cluster Savings. Det måler aktiviteten hos pods (ressourceforbrug, inklusive netværk), samt beregner, hvor mange penge og på hvad der kan spares.
Det kan virke som om, at optimeringsrådene er ret åbenlyse, men erfaringen fortæller, at der alligevel er noget at kigge nærmere på. Især overvåges netværksaktiviteten hos pods (Kubecost foreslår at være opmærksom på inaktive), sammenlignes den anmodede og faktiske brug af hukommelse og CPU, såvel som CPU brugt af klyngeknuderne (det foreslår at samle flere knuder til én), diskbelastning og et par dusin andre parametre.
Som i enhver sag vedrørende optimering, skal man forholde sig med forsigtighed. For eksempel foreslår Cluster Savings at fjerne knuder, idet det hævder, at det er sikkert, men tager ikke hensyn til tilstedeværelsen af node-selectors og taints på de pods, der er deployeret på dem, som ikke findes på de andre knuder. Og generelt, selv produktets forfattere i deres (forresten, den kan være meget nyttig for dem, der er interesseret i projektets emne) anbefaler ikke at kaste sig hovedkulds ind i omkostningsoptimering, men at nærme sig spørgsmålet med omtanke.
Resumé
Efter at have brugt kubecost i en måned på et par projekter kan vi konkludere, at det er et interessant (og også let at lære og installere) værktøj til analyse og optimering af udgifter til cloud-udbydere, der bruges til Kubernetes-klynger. Beregningerne er ret præcise: i vores eksperimenter stemte de overens med, hvad udbyderne faktisk krævede.
Der er dog også ulemper: der er ikke-kritiske bugs, og funktionerne dækker på enkelte områder ikke de specifikke behov for nogle projekter. Men hvis man hurtigt ønsker at forstå, hvor pengene går hen, og hvad der kan "skæres væk" for stabilt at reducere regningen for cloud-tjenester med 5-30% (som det skete i vores tilfælde), er dette et fremragende valg.
P.S.
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
