

Aloha, folk! Mit navn er Oleg Anastasyev, og jeg arbejder i Odnoklassniki i Platform-teamet. Udover mig er der også et væld af hardware i Odnoklassniki. Vi har fire datacentre med omkring 500 racks og mere end 8.000 servere. På et tidspunkt indså vi, at implementering af et nyt administrationssystem ville gøre det lettere at udnytte vores udstyr mere effektivt, forenkle adgangsstyringen, automatisere (gen)fordelingen af computerressourcer, accelerere lanceringsprocessen af nye tjenester og forbedre reaktionerne på store nedbrud.
Hvad kom der ud af det?
Udover mig og en masse hardware er der også folk, der arbejder med dette udstyr: ingeniører, som befinder sig direkte i datacentrene; netværksspecialister, der konfigurerer netværksinfrastrukturen; administratorer eller SRE'er, der sikrer systemets pålidelighed; og udviklingsteams, hvor hvert team har ansvaret for bestemte funktioner på portalen. Den software, de udvikler, fungerer således:
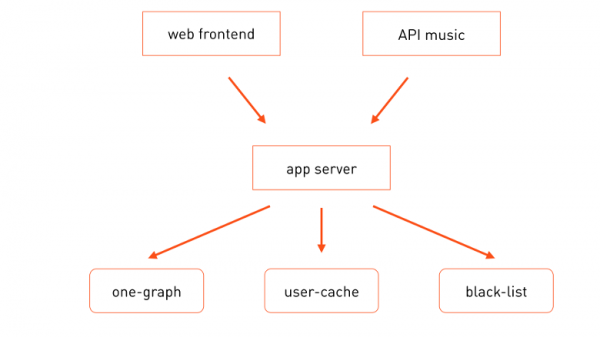
Brugerforespørgsler modtages både på fronten af hovedportalen , og på andre, såsom på fronten til musik API'en. For at håndtere forretningslogikken kalder de applikationsserveren, som under behandlingen af forespørgslen kalder de nødvendige specialiserede mikrotjenester — one-graph (graf over sociale forbindelser), user-cache (cache for brugerprofiler) osv.
Hver af disse tjenester er implementeret på mange maskiner, og hver har ansvarlige udviklere, der er ansvarlige for modulernes funktionalitet, drift og teknologiske udvikling. Alle disse tjenester kører på fysiske servere, og indtil for nylig kørte vi præcist én opgave på én server, hvilket betød, at den var specialiseret til en bestemt opgave.
Hvorfor er det sådan? Denne tilgang har haft flere fordele:
- Det gør det lettere at håndtere masseoperationer. Antag, at opgaven kræver bestemte biblioteker og konfigurationer. Så bliver serveren tildelt én bestemt gruppe, og der beskrives en cfengine-politik for denne gruppe (eller den er allerede beskrevet), og denne konfiguration rulles centralt og automatisk ud til alle servere i denne gruppe.
- Det forenkler diagnosticering. Antag at du ser på en høj belastning på centralprocessoren og forstår, at den belastning kun kunne være genereret af den opgave, der kører på denne fysiske processor. Søgningen efter den skyldige bliver hurtigt afsluttet.
- Det forenkler overvågning. Hvis der er noget galt med serveren, rapporterer monitoren det, og du ved præcist, hvem der er skyld i det.
En tjeneste bestående af flere kopier tildeles flere servere — en for hver. Så udnyttelsen af beregningsressourcer til tjenesten er meget enkel: jo flere servere tjenesten har, desto flere ressourcer kan den maksimalt forbruge. 'Enkel' her betyder ikke, at det er nemt at bruge, men at ressourcerne tildeles manuelt.
Denne tilgang gjorde det også muligt for os at lave specialiserede hardwarekonfigurationer til opgaven, der udføres på denne server. Hvis opgaven gemmer store mængder data, bruger vi en 4U-server med chassis til 38 harddiske. Hvis opgaven er rent beregningsmæssig, kan vi købe en billigere 1U-server. Dette er effektivt med hensyn til beregningsressourcer. Denne tilgang tillader os også at bruge fire gange færre maskiner ved en belastning, der svarer til en lokal social netværkstjeneste.
Denne effektivitet i udnyttelsen af beregningsressourcer bør også sikre økonomisk effektivitet, hvis vi tager udgangspunkt i præmissen om, at det dyreste er serverne. Længer var det egentligt hardware, der var dyrest, og vi har investeret mange ressourcer i at sænke omkostningerne til hardware ved at udvikle algoritmer til at sikre fejltolerance for at reducere kravene til udstyrets pålidelighed. Og i dag er vi nået til et punkt, hvor prisfaktoren for servere ikke længere er afgørende. Hvis vi ser bort fra den nyeste eksotiske teknologi, så har den specifikke konfiguration af servere i rack ikke længere betydning. Nu har vi et andet problem — prisen for den plads, serveren optager i datacenteret, dvs. pladsen i rakket.
Da vi indså, at det var tilfældet, besluttede vi at beregne, hvor effektivt vi bruger rackerne.
Vi tog prisen for den mest kraftfulde server, der er økonomisk forsvarlig, og beregnede, hvor mange af disse servere vi kunne placere i racks, hvilke opgaver vi ville køre på dem baseret på den gamle model 'én server = én opgave', og hvor meget udstyr disse opgaver ville kunne udnytte. Det viser sig, at vores effektivitet i brugen af racks er omkring 11 %. Den åbenlyse konklusion er, at vi skal øge effektiviteten i brugen af datacentre. Tilsyneladende er løsningen enkel: man skal køre flere opgaver på én server. Men her opstår der komplikationer.
Massekonfigurationen bliver pludselig langt mere kompliceret — det er nu umuligt at tildele serveren en bestemt gruppe. For nu kan der køre flere opgaver fra forskellige teams på én server. Derudover kan konfigurationen være konfliktfyldt for forskellige applikationer. Diagnosen bliver også mere vanskelig: hvis du ser et øget forbrug af CPU'er eller diske på serveren, ved du ikke, hvilken opgave der forårsager problemer.
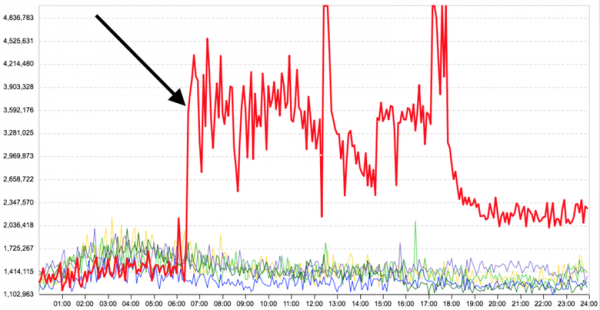
Men det vigtigste er, at der ikke er isolation mellem opgaverne, der kører på én maskine. For eksempel, grafen for den gennemsnitlige responstid for en serveropgave før og efter en anden, ikke-relateret beregningsapplikation blev kørt på samme server — responstiden for den primære opgave steg betydeligt.
Det er åbenlyst, at opgaverne skal køres enten i containere eller i virtuelle maskiner. Da næsten alle vores opgaver kører under én operativsystem (Linux) eller er tilpasset til det, har vi ikke brug for at understøtte mange forskellige operativsystemer. Derfor er virtualisering ikke nødvendig, da det vil være mindre effektivt end containerisering på grund af de ekstra omkostninger.
Som en implementering af containere til at køre opgaver direkte på servere er Docker en god kandidat: filsystembilleder løser problemer med konflikterende konfigurationer effektivt. Det faktum, at billeder kan sammensættes af flere lag, gør det muligt for os at reducere mængden af data, der er nødvendig for at implementere dem på infrastrukturen, ved at udskille de fælles dele i separate basislag. Så vil basislagene (og de største) hurtigt blive cachet på hele infrastrukturen, og for at levere mange forskellige typer applikationer og versioner, vil vi kun skulle overføre små lag.
Derudover giver det færdige register og taggning af billeder i Docker os færdige primitiv til versionsstyring og levering af kode til produktionen.
Docker, ligesom enhver anden lignende teknologi, giver os et vist niveau af isolation af containere out-of-the-box. For eksempel isolering af hukommelse — hver container tildeles en grænse for brugen af maskinens hukommelse, som den ikke kan overskride. Det er også muligt at isolere containere i forhold til CPU-forbrug. For os var den standardiserede isolation dog ikke tilstrækkelig. Men det er der mere om nedenfor.
Den direkte kørsel af containere på servere er kun en del af problemerne. En anden del handler om placeringen af containere på serverne. Man skal forstå, hvilken container der kan placeres på hvilken server. Dette er ikke en så simpel opgave, fordi containere skal placeres på servere så tæt som muligt uden at nedsætte deres ydeevne. Sådan placering kan være kompleks også med hensyn til failover. Ofte ønsker vi at placere reprikater af den samme service i forskellige racks eller endda i forskellige datacenterhaller, så vi ikke mister alle reprikater af servicen på én gang, hvis et rack eller en hal fejler.
At fordele containere manuelt er ikke en mulighed, når man har 8.000 servere og 8.000-16.000 containere.
Desuden ønskede vi at give udviklerne mere selvstændighed i fordelingen af ressourcer, så de selv kunne placere deres tjenester i produktion uden hjælp fra en administrator. På den måde ønskede vi at bevare kontrollen, så en sekundær service ikke optager alle ressourcerne i vores datacentre.
Det er åbenlyst, at der er brug for et administrationslag, der kan håndtere dette automatisk.
Her er vi kommet til et simpelt og klart billede, som alle arkitekter elsker: tre firkanter.
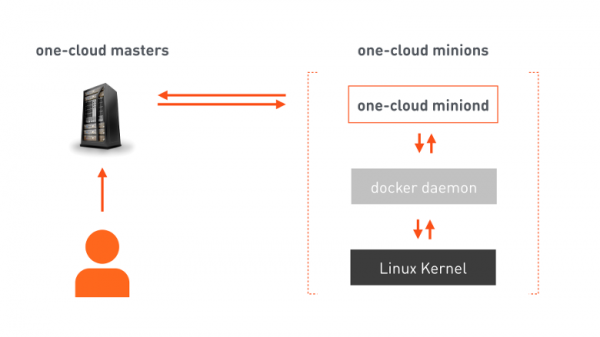
one-cloud masters – en fejltolerant klynge, der er ansvarlig for orkestrering af skyen. Udvikleren sender en manifest til masteren, som indeholder al nødvendig information til placering af tjenesten. Masteren giver ordre til udvalgte minions (maskiner, der er beregnet til at køre containere) baseret på dette. På minions er vores agent, der modtager ordren, afgiver allerede sine kommandoer til Docker, som konfigurerer Linux-kernen for at køre den relevante container. Udover at udføre ordrer rapporterer agenten kontinuerligt til masteren om ændringer i tilstanden af både minion-maskinerne og de containere, der kører på dem.
Ressourcefordeling
Lad os nu se på opgaven om mere kompleks ressourcefordeling for mange minions.
Computerressourcen i one-cloud er:
- Den computerkraft, som en specifik opgave kræver.
- Mængden af hukommelse, der er tilgængelig for opgaven.
- Netværkstrafik. Hver av minions har en specifik netværksgrænseflade med begrænset båndbredde, så opgaver kan ikke fordeles uden at tage højde for den mængde data, der sendes over netværket.
- Disker. Udover, åbenlyst, plads til data fra opgaven, tildeler vi også disktypen: HDD eller SSD. Diskene kan håndtere et begrænset antal anmodninger per sekund – IOPS. Derfor, for opgaver, der genererer flere IOPS, end en enkelt disk kan håndtere, tildeler vi også "spindler" – dvs. disk-enheder, der udelukkende skal reserveres til opgaven.
For en hvilken som helst tjeneste, for eksempel user-cache, kan vi angive de forbrugte ressourcer på denne måde: 400 CPU-kerner, 2,5 TB hukommelse, 50 Gbit/s trafik i begge retninger, 6 TB plads på HDD, placeret på 100 spindler. Eller i en mere velkendt form således:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Ressourcerne for user-cache-tjenesten forbruger kun en del af alle tilgængelige ressourcer i produktionsinfrastrukturen. Derfor ønsker vi at sikre, at user-cache ikke pludselig forbruger flere ressourcer, end det er tildelt, hverken på grund af en operatørfejl eller ej. Det vil sige, at vi skal begrænse ressourcerne. Men hvad kunne vi knytte kvoten til?
Lad os vende tilbage til vores stærkt forenklede diagram over komponenternes interaktion og tegne det om med flere detaljer — sådan her:
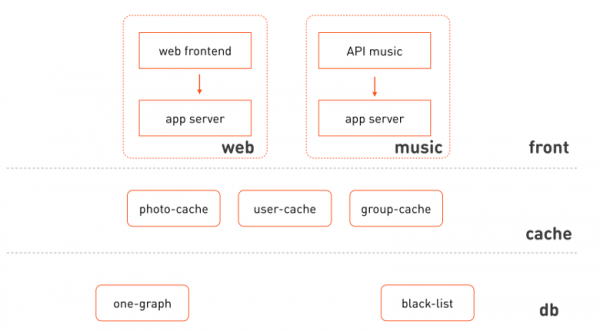
Hvad der springer i øjnene:
- Web-frontenden og musikken bruger isolerede klynger fra den samme applikationsserver.
- Vi kan identificere logiske lag, som disse klynger tilhører: front-end, caches, lagring og databehandlingslag.
- Frontenden er heterogen, det er forskellige funktionelle undersystemer.
- Caches kan også fordeles i henhold til det undersystem, hvis data de cacher.
Lad os tegne billedet om igen:
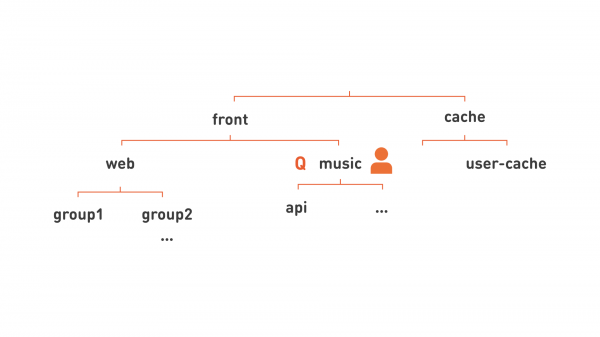
Nå! Vi ser hierarkiet! Det betyder, at vi kan fordele ressourcer i større mængder: tildele en ansvarlig udvikler til en knude i dette hierarki, som svarer til et funktionelt undersystem (som 'music' på billedet), og knytte en kvote til det samme hierarki. Dette hierarki gør det også muligt for os at organisere tjenesterne mere fleksibelt for at lette administrationen. For eksempel opdeler vi alle web, da det er en meget stor gruppe servere, i flere mindre grupper, der er vist på billedet som group1, group2.
Ved at fjerne unødvendige linjer kan vi skrive hver knude i vores billede på en mere flad måde: group1.web.front, api.music.front, user-cache.cache.
Så vi kommer til begrebet "hierarkisk kø". Den har et navn, som "group1.web.front". Der tildeles en kvote til ressourcer og brugerrettigheder. En person fra DevOps får rettigheder til at sende tjenesten til køen, og sådan en medarbejder kan starte noget i køen, mens en person fra OpsDev — får administratorrettigheder, og nu kan han styre køen, tildele folk til den, give disse folk rettigheder osv. Tjenester, der startes i denne kø, vil blive udført inden for køens kvote. Hvis den beregnede kvote for køen ikke er tilstrækkelig til samtidig udførelse af alle tjenester, vil de blive udført sekventielt, og dermed danne en faktisk kø.
Lad os se nærmere på tjenesterne. En tjeneste har et fuldt navn, som altid indeholder navnet på køen. Så web front-tjenesten vil have navnet ok-web.group1.web.front. Og tjenesten for applikationsserveren, som den henvender sig til, vil blive kaldt ok-app.group1.web.front. Hver tjeneste har et manifest, der angiver al nødvendig information for placeringen på specifikke maskiner: hvor mange ressourcer denne opgave bruger, hvilken konfiguration der er nødvendig, hvor mange replika der skal være, og egenskaberne for fejlhåndtering af denne tjeneste. Efter placeringen af tjenesten direkte på maskinerne opstår dens instanser. De navngives også entydigt — som instansnummeret og tjenestenavnet: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Dette er meget praktisk: ved kun at se på navnet på den kørende container kan vi straks finde ud af meget.
Lad os nu komme tættere på, hvad disse instanser faktisk udfører: opgaverne.
Klasser af opgaveisolering
Alle opgaver i OK (og sikkert også andre steder) kan deles op i grupper:
- Opgaver med kort forsinkelse — prod. For sådanne opgaver og tjenester er responstiden (latency) meget vigtig, hvor hurtigt hvert enkelt af anmodningerne vil blive behandlet af systemet. Eksempler på opgaver: webfront-end, cache, applikationsservere, OLTP-lagre osv.
- Beregningsopgaver — batch. Her er hastigheden for behandling af hver enkelt anmodning ikke vigtig. Det, der betyder noget, er, hvor mange beregninger denne opgave udfører i en given (stor) periode (throughput). Dette vil inkludere alle MapReduce-opgaver, Hadoop, maskinlæring, statistik.
- Baggrundsopgaver — idle. For sådanne opgaver er hverken latency eller throughput særlig vigtig. Herunder hører forskellige test, migrationer, genberegninger, konverteringer af data fra et format til et andet. På den ene side minder de om beregningsopgaver, men på den anden side er det ikke særlig vigtigt, hvor hurtigt de afsluttes.
Lad os se på, hvordan sådanne opgaver forbruger ressourcer, for eksempel CPU.
Opgaver med kort forsinkelse. En sådan opgave har et mønster for CPU-forbrug, der ligner dette:
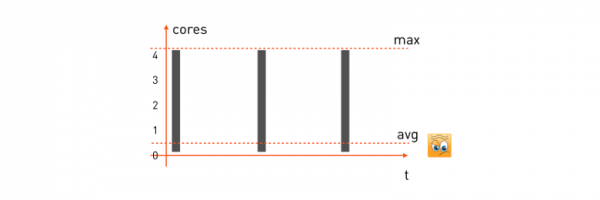
En anmodning fra brugeren behandles, opgaven begynder at bruge alle tilgængelige CPU-kerner, behandler, returnerer et svar, venter på næste anmodning og står stille. Den næste anmodning kommer ind — vi bruger igen alt, hvad vi har, behandler, venter på næste.
For at sikre minimal forsinkelse for en sådan opgave skal vi tage det maksimale af de ressourcer, den bruger, og reservere det nødvendige antal kerner på minionen (maskinen, der vil udføre opgaven). Så vores reservationsformel for denne opgave bliver:
alloc: cpu = 4 (max)Og hvis vi har en mini-maskine med 16 kerner, kan vi placere præcis fire af disse opgaver på den. Det er værd at bemærke, at den gennemsnitlige CPU-forbrug for sådanne opgaver ofte er meget lavt - hvilket er åbenlyst, da en væsentlig del af tiden opgaven er i venteposition og ikke laver noget.
Beregningsopgaver. De vil have et lidt anderledes mønster:
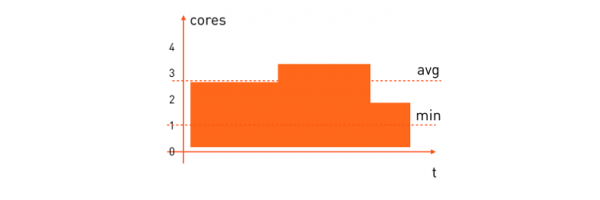
Det gennemsnitlige ressourceforbrug på CPU for sådanne opgaver er ret højt. Vi ønsker ofte, at beregningsopgaven udføres inden for en bestemt tidsramme, så vi skal reservere det minimale antal processorer, der kræves for at hele beregningen kan afsluttes inden for en acceptabel tid. Dens reservationsformel vil se således ud:
alloc: cpu = [1,*)„Placer venligst på mini-maskinen, hvor der er mindst én ledig kerne, og derefter vil den tage alt den kan få.“
Her er effektiviteten langt bedre end for opgaver med kort forsinkelse. Men gevinsten vil være meget større, hvis begge typer opgaver kombineres på én mini-maskine og dens ressourcer fordeles løbende. Når en opgave med kort forsinkelse har brug for CPU - får den den straks, og når ressourcerne ikke længere er nødvendige - gives de videre til beregningsopgaven, dvs. sådan:
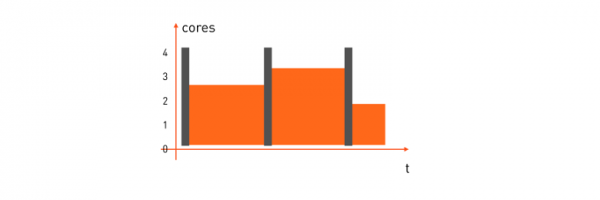
Men hvordan gør man det?
Lad os først se på prod og dens alloc: cpu = 4. Vi skal reservere fire kerner. I Docker run kan dette gøres på to måder:
- Ved at bruge muligheden
--cpuset=1-4, dvs. at tildele opgaven fire bestemte kerner på maskinen. - Brug
--cpuquota=400_000 --cpuperiod=100_000, tildele en kvote for CPU-tid, dvs. angive, at hver 100 ms i realtid bruger opgaven ikke mere end 400 ms CPU-tid. Det bliver de samme fire kerner.
Men hvilken af disse metoder er den rigtige?
Cpuset ser ganske attraktivt ud. Opgaven har fire dedikerede kerner, hvilket betyder, at processorcache kan fungere mest effektivt. Der er dog en bagside: vi ville skulle påtage os opgaven med at fordele beregningen på de ubelastede kerner i maskinen i stedet for OS, og det er en ret ikke-triviel opgave, især hvis vi forsøger at placere batch-opgaver på en sådan maskine. Tests har vist, at en variant med kvote passer bedre her: på den måde har operativsystemet mere frihed til at vælge en kerne til opgaven i det aktuelle øjeblik, og processorens tid fordeles mere effektivt.
Lad os finde ud af, hvordan man i Docker kan reservere et minimum af kerner. Kvote for batch-opgaver er ikke længere anvendelig, fordi det ikke er nødvendigt at begrænse maksimum, det er kun nødvendigt at garantere minimum. Og her passer indstillingen godt docker run --cpushares.
Vi har aftalt, at hvis batch kræver garanti for minimum på én kerne, så angiver vi --cpushares=1024, og hvis minimum er på to kerner, så angiver vi --cpushares=2048. Cpu shares påvirker ikke fordelingen af processorens tid, så længe der er tilstrækkeligt af det. Hvis prod i øjeblikket ikke bruger alle sine fire kerner, begrænser intet batch-opgaverne, og de kan bruge den ekstra processor tid. Men i en situation med mangel på processor, hvis prod har forbrugt alle sine fire kerner og rammer kvoten, vil den resterende processor tid blive fordelt proportionalt efter cpushares; dvs. i situationen med tre frie kerner vil én få opgaven med 1024 cpushares, og de andre to vil få opgaven med 2048 cpushares.
Men brugen af kvote og shares er ikke nok. Vi skal sørge for, at opgaver med kort forsinkelse får prioritet over batch-opgaverne ved fordelingen af processor tid. Uden sådan prioritering vil batch-opgaven tage al processor tid, når den er nødvendig for prod. I Docker run er der ingen prioriteringsmuligheder for containere, men CPU-scheduler politikerne i Linux træder til. Du kan læse mere om dem , men i denne artikel vil vi kort gennemgå dem:
- SCHED_OTHER
Som standard får alle almindelige brugerprocesser på en Linux-maskine. - SCHED_BATCH
Designet til ressourcekrævende processer. Når en opgave placeres i processoren, indføres der en såkaldt aktiveringsbøde: en sådan opgave vil have mindre sandsynlighed for at modtage processorressourcer, hvis den i øjeblikket bruges af en opgave med SCHED_OTHER. - SCHED_IDLE
Baggrundsprocessen med meget lav prioritet, endda lavere end nice -19. Vi bruger vores open source-bibliotek , for at angive den nødvendige politik ved opstart af containeren ved at kalde
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Men selv hvis du ikke programmerer i Java, kan det samme gøres med kommandoen chrt:
chrt -i 0 $pidLad os samle alle vores isolationsniveauer i en tabel for klarhed:
Isolationsklasse
Eksempel alloc
Docker run muligheder
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Hvis du bruger chrt indefra containeren, kan det være nødvendigt med capability sys_nice, fordi Docker som standard fjerner denne capability ved opstart af containeren.
Men opgaver bruger ikke kun processoren, men også trafik, som påvirker latenstiden for netværksopgaven endnu mere end forkert ressourcefordeling af processoren. Derfor vil vi naturligvis gerne have et præcist billede for trafikken. Det vil sige, når en prod-opgave sender nogle pakker til netværket, kvoterer vi den maksimale hastighed (formlen alloc: lan=[*,500mbps) ), som prod kan gøre dette. For batch garanterer vi kun minimums-båndbredden, men begrænser ikke maksimum (formlen alloc: lan=[10Mbps,*) ) I denne proces skal trafikken fra prod have prioritet over batch-opgaver.
Her har Docker ikke nogen primitive værktøjer, som vi kan bruge. Men vi får hjælp fra . Vi kunne opnå det ønskede resultat ved hjælp af disciplinen . Ved hjælp af dette skelner vi mellem to klasser af trafik: højprioriteret prod og lavprioriteret batch/idle. I sidste ende ser konfigurationen for udgående trafik sådan ud:
her 1:0 — „roottaktikken“ for disciplinen hsfc; 1:1 — underklasse hsfc med en samlet båndbreddebegrænsning på 8 Gbit/s, hvorunder der placeres underklasser for alle containere; 1:2 — en fælles hsfc underklasse for alle batch- og idle-opgaver med en „dynamisk“ grænse, som beskrevet nedenfor. De øvrige hsfc underklasser er dedikerede klasser for aktive prod-containere med begrænsninger svarende til deres manifester, — 450 og 400 Mbit/s. Hver hsfc klasse tildeles en qdisc kø fq eller fq_codel, afhængig af linux kernel version, for at undgå pakketab ved trafikspidser.
Typisk bruges tc disciplinerne til at prioritere kun udgående trafik. Men vi ønsker også at prioritere indgående trafik — en eller anden batch-opgave kan nemt tage hele den indgående kanal ved at modtage f.eks. et stort datapakke til map&reduce. Til dette bruger vi modulet , som skaber et virtuelt interface ifbX for hver netværksinterface og omdirigerer indgående trafik fra interfacet til udgående på ifbX. Derefter fungerer alle de samme discipliner for kontrol af udgående trafik for ifbX, hvor konfigurationen af hsfc vil være meget lig:
Under eksperimenterne fandt vi ud af, at hsfc giver de bedste resultater, når klassen 1:2 af ikke-prioriteret batch/idle trafik er begrænset på minion-maskinerne til maksimalt en vis ledig båndbredde. Ellers påvirker den ikke-prioriterede trafik for meget latens af prod-opgaverne. Den aktuelle størrelse af den ledige båndbredde fastlægges af miniond hver sekund ved at måle det gennemsnitlige trafikforbrug for alle prod-opgaver på den pågældende minion  og trække det fra netværksinterfacets båndbredde
 med et lille sikkerhedsniveau, dvs.

Båndbredderne defineres for indgående og udgående trafik uafhængigt. Og i henhold til de nye værdier rekonfigurerer miniond grænsen for den ikke-prioriterede klasse 1:2.
Dermed har vi implementeret alle tre isolationsklasser: prod, batch og idle. Disse klasser har stor indflydelse på opgaveudførelsens karakteristika. Derfor besluttede vi at placere dette kendetegn øverst i hierarkiet, så det straks er klart, hvad vi har med at gøre ved at se på navnet på den hierarkiske kø:
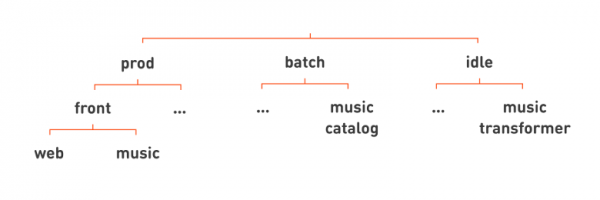
Alle vores kendte web og music frontende placeres dernæst i hierarkiet under prod. For eksempel lad os placere tjenesten music catalog under batch., som periodisk laver et katalog over spor fra samlingen af mp3-filer, der er blevet uploaded til "Odnoklassniki". Et eksempel på en service under idle kan være music transformer, der normaliserer lydniveauet på musikken.
Ved igen at fjerne unødvendige linjer kan vi skrive navnene på vores tjenester mere fladt ved at tilføje klassen for opgaveisolering til slutningen af det fulde navn på tjenesten: web.front.prod, catalog.music.batch, transformer.music.idle.
Og nu, når vi ser på navnet på tjenesten, forstår vi ikke kun, hvilken funktion den udfører, men også dens klasse for isolering, og dermed dens kritikalitet osv.
Alt er fantastisk, men der er en bitter sandhed. Det er umuligt at fuldstændig isolere opgaver, der kører på samme maskine.
Hvad vi har opnået: hvis batch'en forbruger intensivt kun processorressourcer, gør Linux' indbyggede CPU-planlægger et fremragende stykke arbejde, og der er næsten ingen indflydelse på prod-opgaven. Men hvis denne batch-opgave begynder at arbejde aktivt med hukommelsen, så viser den gensidige påvirkning sig allerede. Dette sker, fordi processorens caches for prod-opgaven 'udtømmes' - i sidste ende vokser målinger i cachen, og processoren behandler prod-opgaven langsommere. En sådan batch-opgave kan øge forsinkelsen af vores typiske prod-container med 10 %.
At isolere trafik er endnu sværere, fordi moderne netværkskort har en intern pakke-kø. Hvis en pakke fra batch-opgaven kom først ind, vil den også blive sendt først gennem kabelledningen, og der er ikke meget, man kan gøre ved det.
Derudover har vi kun formået at løse opgaven med prioritering af TCP-trafik indtil videre: til UDP virker tilgangen med hsfc ikke. Og selv i tilfælde af TCP-trafik, hvis batch-opgaven genererer meget trafik, resulterer det også i en øgning af forsinkelse for prod-opgaven på cirka 10 %.
Fejltolerance
Et af målene ved udviklingen af one-cloud var at forbedre redundans i Odnoklassniki. Derfor vil jeg gerne se nærmere på mulige fejlscenarier og nedbrud. Lad os starte med et enkelt scenarie — med et containerfejl.
En container kan fejle på flere måder. Det kan være et eksperiment, en fejl eller en fejl i manifestet, der gør, at en produkt-opgave begynder at forbruge flere ressourcer, end der er angivet i manifestet. Vi havde et tilfælde, hvor en udvikler implementerede en kompleks algoritme, tilbagerullede den mange gange og blev så forvirret, at opgaven endte med fornemt at køre i loop. Og da produkt-opgaven har højere prioritet end alle andre på de samme noder, begyndte den at forbruge alle tilgængelige CPU-ressourcer. I denne situation blev vi reddet af isolation, nærmere bestemt en kvote på CPU-tid. Hvis der er tildelt en kvote til opgaven, vil den ikke forbruge mere. Derfor bemærkede batch- og andre produkt-opgaver, der kørte på den samme maskine, ikke noget.
En anden potentiel udfordring er containerens nedbrud. Her hjælper genstartspolitikkerne os, som alle kender, og Docker håndterer det rigtig godt. Næsten alle produkt-opgaver har en genstartspolitik, der altid er aktiv. Af og til bruger vi on_failure til batch-opgaver eller til fejlfinding af produkt-containere.
Hvad kan man gøre, når en hel node er utilgængelig?
Åbenlyst kan man køre containeren på en anden maskine. Det mest interessante her er, hvad der sker med IP-adressen (adresserne) tildelt til containeren.
Vi kan tildele containere de samme IP-adresser som maskinerne, hvor disse containere kører. Så når containeren køres på en anden maskine, ændres dens IP-adresse, og alle klienter skal forstå, at containeren er flyttet, og nu skal der tilgås en anden adresse, hvilket kræver en separat Service Discovery-tjeneste.
Service Discovery er praktisk. Der findes mange løsninger på markedet i forskellige grader af fejltilgængelighed til organisering af tjenesteregistre. I sådanne løsninger implementeres der ofte logik til belastningsbalancering, lagring af ekstra konfiguration i form af KV-lager osv.
Men vi ønsker at undgå at implementere et separat register, da det ville betyde at introducere et kritisk system, der anvendes af alle tjenester i produktionen. Det betyder, at det er et potentielt fejlpunkt, og man skal vælge eller udvikle en meget fejltolerant løsning, hvilket åbenbart er meget kompliceret, langvarigt og kostbart.
Og endnu en stor ulempe: for at vores gamle infrastruktur kunne fungere med den nye, skulle vi genprogrammere alle opgaver til brug af et eller andet Service Discovery-system. Der er MEGET arbejde, og nogle steder er det umuligt, når det drejer sig om lavniveau enheder, der arbejder på niveau med OS-kernen eller direkte med hardwaren. Implementeringen af denne funktionalitet ved hjælp af etablerede løsningsmønstre, som f.eks. ville betyde, at der nogle steder kom ekstra belastning, og nogle steder — en komplicering af driften og ekstra fejlscenarier. Vi ønskede ikke at komplicere det, derfor besluttede vi at gøre brugen af Service Discovery valgfri.
I one-cloud følger IP'en med containeren, dvs. hver opgaveinstans har sin egen IP-adresse. Denne adresse er "statisk": den tildeles hver instans i det øjeblik, tjenesten sendes til skyen. Hvis tjenesten i løbet af sin livscyklus har haft et forskelligt antal instanser, vil der i sidste ende være tildelt så mange IP-adresser, som der har været instanser.
Senere ændres disse adresser ikke: de tildeles én gang og forbliver tilgængelige i hele tjenestens liv i produktionen. IP-adresserne følger containerne over netværket. Hvis en container flyttes til en anden minion, vil adressen også følge med.
Dermed ændres sammenkoblingen af tjenestens navn med listen over dens IP-adresser meget sjældent. Hvis vi ser på navne på tjenesteinstanser, som vi nævnte i begyndelsen af artiklen (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), kan vi se, at de ligner FQDN, der bruges i DNS. Det gør de, for at vise navnene på serviceinstanser i deres IP-adresser, bruger vi DNS-protokollen. Desuden returnerer denne DNS alle reserverede IP-adresser til alle containere - både dem, der kører, og dem, der er stoppet (lad os sige, at tre replikaer bruges, og vi har fem adresser reserveret - alle fem vil blive returneret). Kunderne, der får denne information, vil forsøge at oprette forbindelse til alle fem replikaer - og på den måde bestemme, hvilke der fungerer. Denne metode til at bestemme tilgængeligheden er betydeligt mere pålidelig, da den ikke involverer hverken DNS eller Service Discovery, hvilket betyder, at der ikke er problemer med at sikre opdateringsinformationen og systemernes fejltolerance. Desuden kan vi i kritiske tjenester, der er afgørende for hele portalens drift, end ikke bruge DNS, men blot angive IP-adresserne i konfigurationen.
Implementeringen af en sådan overførsel af IP adresser bag containere kan være ikke-triviel - og vi vil stoppe ved, hvordan det fungerer, i det næste eksempel:
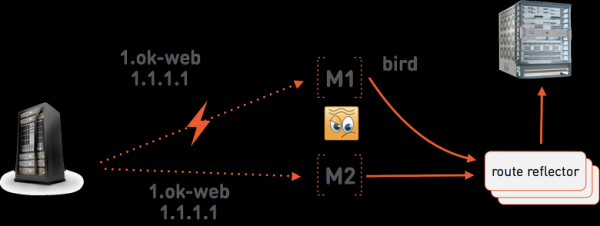
Antag, at one-cloud master beder minion M1 om at starte 1.ok-web.group1.web.front.prod med adressen 1.1.1.1. På minionen kører , som annoncerer denne adresse til særlige servere . Disse har en BGP-session med det netværksudstyr, hvor ruten til adressen 1.1.1.1 bliver transmitteret til M1. M1 router pakker ind i containeren ved hjælp af Linux. Der er tre route reflectorer, da dette er en meget kritisk del af one-cloud infrastrukturen - uden dem vil netværket i one-cloud ikke fungere. Vi placerer dem i forskellige racks, så vidt muligt beliggende i forskellige haller i datacentret, for at minimere risikoen for samtidig svigt af alle tre.
Lad os nu antage, at forbindelsen mellem one-cloud master og minion M1 er brudt. One-cloud master vil nu handle ud fra antagelsen om, at M1 er helt fejlet. Det vil sige, at det vil give ordre til minion M2 om at starte web.group1.web.front.prod med den samme IP-adresse 1.1.1.1. Nu har vi to konflikerende ruter i netværket for 1.1.1.1: på M1 og M2. For at løse sådanne konflikter bruger vi Multi Exit Discriminator, som angives i BGP-annonceringen. Dette tal angiver vægten af den annoncerede rute. Ruten med den laveste MED-værdi vælges blandt de konflikerende. Master one-cloud understøtter MED som en integreret del af container-IP-adresser. Ved første gang udstede adressen med en relativt høj MED = 1 000 000. I situationen med en sådan nød-overførsel af containeren reducerer masteren MED, og M2 vil allerede modtage en kommando om at annoncere adressen 1.1.1.1 med MED = 999 999. Instansen, der kører på M1, forbliver uden forbindelse, og dens videre skæbne interesserer os ikke meget, indtil forbindelsen til masteren er genoprettet, hvorefter den vil blive stoppet som en gammel dublet.
Nødsituationer
Alle datacenterstyringssystemer håndterer normalt små fejl. Udfald af en container er praktisk taget normen overalt.
Lad os se på, hvordan vi håndterer en nødsituation, for eksempel strømafbrydelse i et eller flere datacenterlokaler.
Hvad betyder en nødsituation for datacenterstyringssystemet? For det første betyder det en massiv samtidig nedbrud af mange maskiner, og systemet skal samtidig migrere mange containerer. Men hvis nødsituationen er meget stor, kan det ske, at alle opgaver ikke kan flyttes til andre minions, fordi datacenterets kapacitet falder under 100 % belastning.
Ofte ledsages nødsituationer af et nedbrud af styringslaget. Dette kan ske på grund af svigt af dets udstyr, men oftere fordi nødsituationer ikke testes, og styringslaget selv falder fra den øgede belastning.
Hvad kan der gøres ved alt dette?
Massiv migrering betyder, at der opstår et stort antal handlinger, migreringer og placeringer i infrastrukturen. Hver migrering kan tage noget tid, der er nødvendigt for at levere og udpakke containerbilleder til minions, starte og initialisere containerne osv. Derfor er det ønskeligt, at de vigtigste opgaver startes før de mindre vigtige.
Lad os igen se på den velkendte servicehierarki og forsøge at afgøre, hvilke opgaver vi ønsker at starte først.
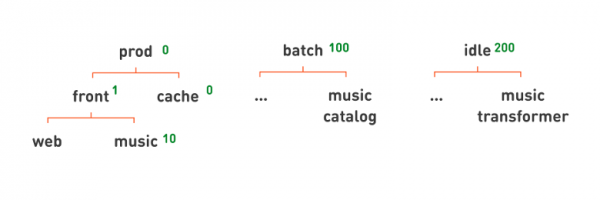
Selvfølgelig, det er de processer, der direkte deltager i behandlingen af brugernes forespørgsler, dvs. prod. Vi angiver dette med hjælp af placeringsprioritet — et tal, der kan tildeles til køen. Hvis en kø har en højere prioritet, placeres dens tjenester først.
På prod tildeler vi højere prioriteter, 0; på batch — lidt lavere, 100; på idle — endnu lavere, 200. Prioriteter anvendes hierarkisk. Alle opgaver lavere i hierarkiet vil have den tilsvarende prioritet. Hvis vi ønsker, at caches inde i prod starter før frontenderne, tildeler vi prioriteter til cache = 0 og front underkøer = 1. Hvis vi derimod vil have, at hovedportalen starter først blandt frontenderne, og musikfronten derefter, kan vi tildele den sidste lavere prioritet — 10.
Det næste problem er mangel på ressourcer. Så vi har haft mange maskiner, hele datacenterne er svigtet, og vi har startet så mange tjenester, at der nu ikke er ressourcer nok til alle. Vi skal beslutte, hvilke opgaver vi skal ofre, så de vigtigste kritiske tjenester kan fungere.
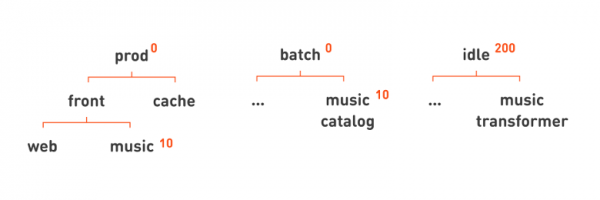
I modsætning til placeringsprioriteten kan vi ikke uforsigtigt ofre alle batch-opgaver, nogle af dem er vigtige for portalens drift. Derfor har vi særskilt выделили udskydningsprioritet opgaver. Ved placering kan en opgave med højere prioritet udskyde, dvs. stoppe en opgave med lavere prioritet, hvis der ikke længere er ledige minioner. Samtidig vil en opgave med lavere prioritet sandsynligvis forblive uplaceret, dvs. der vil ikke være en passende minion med tilstrækkelige frie ressourcer til den.
I vores hierarki er det meget enkelt at angive sådan en udskydningsprioritet, så prod- og batch-opgaver udskyder eller stopper idle-opgaver, men ikke hinanden, ved at angive en prioritet for idle, der er lig med 200. Ligesom i tilfælde af placeringsprioritet kan vi bruge vores hierarki til at beskrive mere komplekse regler. For eksempel vil vi angive, at musikfunktionen ofres, hvis vi mangler ressourcer til den primære webportal, ved at sætte en lavere prioritet for de relevante noder: 10.
Hele DC-nedbrud
Hvorfor kan hele datacenteret svigte? Naturkatastrofer. Der var et godt indlæg om, hvordan . Man kan betragte hjemløse som en trussel, da de en gang har sat ild til fiberoptikken i en kloak, og datacentret mistede helt forbindelsen til de øvrige steder. Årsagen til nedbruddet kan også være menneskelig fejl: operatøren kan give en kommando, der får hele datacentret til at falde ned. Dette kan ske på grund af en stor fejl. Generelt set falder datacentre — det er ikke ualmindeligt. Vi oplever dette en gang hver anden måned.
Og her er hvad vi gør, så ingen #oklevlive poster på Twitter.
Den første strategi er isolation. Hver instans af one-cloud er isoleret og kan kun styre maskinerne i ét datacenter. Det vil sige, at tabet af cloud-løsningen på grund af fejl eller en forkert kommando fra operatøren kun påvirker ét datacenter. Vi er forberedt på dette: der er en reserven politik, hvor replikaer af applikationer og data placeres i alle datacentre. Vi bruger fejlresistente databaser og tester periodisk for fejl.
Da vi i dag har fire datacentre, har vi også fire separate, helt isolerede instanser af one-cloud.
Denne tilgang beskytter ikke kun mod fysiske fejl, men kan også beskytte mod operatørfejl.
Hvad mere kan der gøres ved det menneskelige faktor? Når operatøren giver cloud'en en mærkelig eller potentielt farlig kommando, kan der pludselig blive bedt om at udføre en lille opgave for at teste, hvor godt han har tænkt over det. For eksempel, hvis det er en massiv nedlukning af mange replikaer eller blot en mærkelig kommando — at reducere antallet af replikaer eller ændre navnet på billedet, ikke kun versionsnummeret i den nye manifest.
Resumé
Kendetegn ved one-cloud:
- Hierarkisk og visuelt overskuelig navngivningsskema for tjenester og containere, som gør det meget hurtigt at finde ud af, hvad det er for en opgave, hvad den relaterer sig til, hvordan den fungerer, og hvem der er ansvarlig for den.
- Vi anvender vores teknik til at kombinere prod- og batch-opgaver på minions for at øge effektiviteten af maskinens deling. I stedet for cpuset bruger vi CPU-quotaer, shares, CPU-planlægningspolitikker og Linux QoS.
- Vi har endnu ikke formået at isolere containere, der kører på samme maskine, fuldstændigt, men deres indbyrdes indflydelse forbliver på op til 20%.
- Organisering af tjenester i et hierarki hjælper ved automatisk afløsning af nødsituationer gennem placering og udrykningsprioriteter..
FAQ
Hvorfor vi ikke valgte en færdig løsning.
- Forskellige klasser af opgaveisolering kræver forskellige logiktyper ved placering på minions. Hvis produktionsopgaver kan placeres med simpel ressource-reservering, skal batch- og idle-opgaver placeres ved at overvåge den faktiske ressourceudnyttelse på minion-maskinerne.
- Nødvendigheden af at tage højde for de ressourcer, som opgaverne forbruger, såsom:
- netværksbåndbredde;
- typer og "spindler" af diske.
- Nødvendigheden af at angive prioriteter for tjenester ved nødsituationer, rettigheder og kvoter for teams på ressourcer, hvilket løses ved hjælp af hierarkiske køer i one-cloud.
- Nødvendigheden af at have menneskelige navne til containere for at reducere reaktionstiden på nødsituationer og hændelser.
- Umuligheden af samtidig implementering af Service Discovery; behovet for at co-existere i lang tid med opgaver, der er placeret på fysiske værter — hvilket løses med "statiske" IP-adresser der følger containere, og som følge heraf nedskrevne unikke integrationer med det store netværksinfrastruktur.
Alle disse funktioner ville kræve betydelige ændringer af eksisterende løsninger for at tilpasse dem til os, og efter at have vurderet arbejdsbyrden indså vi, at vi kunne udvikle vores egen løsning med omtrent de samme arbejdsomkostninger. Men vores løsning vil være betydeligt lettere at vedligeholde og udvikle — det indeholder ingen unødvendige abstraktioner, der understøtter unødvendig funktionalitet for os.
Tak til dem, der læser de sidste linjer — tak for tålmodighed og opmærksomhed!
Kilde: habr.com
