

Hej alle sammen. Denne artikel er skrevet til dem, der stadig er i tvivl om valg af virtualiseringsplatform og efter at have læst artiklen i serien "Vi satte proxmox op, og alt kører fint, 6 års oppetid uden nedbrud". Men efter installation af en eller anden løsning, opstår spørgsmålet: hvordan kan vi justere her og der for at gøre overvågningen mere forståelig, og her for at kontrollere backups... Og så kommer tiden, hvor man indser, at man ønsker noget mere funktionelt, eller man ønsker, at alting inden for ens system skal være klart, i stedet for at det ligner en sort kasse, eller man ønsker at bruge noget, der er mere end en hypervisor med en masse virtuelle maskiner. I denne artikel vil der være lidt refleksioner og praksis baseret på platformen Opennebula — jeg har valgt den, da den ikke stiller store krav til ressourcerne, og arkitekturen ikke er så kompleks.
Så som vi ser, arbejder mange cloud-udbydere på KVM og laver eksterne bindings for at administrere maskiner. Det er klart, at store hostingfirmaer skriver deres bindings til cloud-infrastrukturen, som f.eks. YANDEX. Nogle bruger OpenStack og laver bindings baseret på det — SELECTEL, MAIL.RU. Men hvis du har dit eget udstyr og et lille team af specialister, vælger man typisk noget fra de færdige løsninger — VMWARE, HYPER-V, der er gratis og betalte licenser, men det handler ikke om det lige nu. Lad os tale om entusiaster — dem, der ikke er bange for at foreslå og prøve nye ting, på trods af at firmaet tydeligt har givet udtryk for: "Hvem skal så vedligeholde det efter dig?" "Skal vi virkelig implementere dette i produktion? Det lyder skræmmende." Men man kan jo starte med at anvende disse løsninger i testmiljøer, og hvis alle er tilfredse, kan man rejse spørgsmålet om videre udvikling og brug i mere seriøse omgivelser.
Her er også et link til oplægget fra en aktiv deltager i udviklingen af denne platform.
Måske vil der være noget overflødigt i denne artikel, som allerede er klart for en erfaren specialist, og i nogle tilfælde vil jeg ikke beskrive alt, da sådanne kommandoer og beskrivelser findes på nettet. Her er kun min erfaring med denne platform. Jeg håber, at aktive deltagere vil tilføje i kommentarerne, hvad der kan gøres bedre, og hvilke fejl jeg har begået. Alle handlinger blev udført under forholdene for et hjemmeopsæt, bestående af 3 pc'er med forskellige specifikationer. Jeg har desuden bevidst undladt at angive, hvordan denne software fungerer og hvordan man installerer den. Nej, kun erfaring med administration og de problemer, jeg har stødt på. Måske kan det være nyttigt for nogen i deres valg.
Så lad os komme i gang. For mig som systemadministrator er følgende punkter vigtige, uden hvilke jeg næppe vil bruge denne løsning.
1. Gentagelighed af installation
Der er masser af installationsvejledninger til OpenNebula, så der burde ikke opstå problemer. Fra version til version kommer der nye funktioner, som ikke altid kan fungere, når man opgraderer fra en version til en anden.
2. Overvågning
Vi vil overvåge selve noden, KVM og OpenNebula. Heldigvis er der allerede noget, der er klar. Der er mange muligheder for overvågning af Linux-hosts, for eksempel Zabbix eller Node Exporter — hvad der nu passer bedst til den enkelte — på nuværende tidspunkt definerer jeg, at overvågning af systemmetrikker (temperatur, hvor den kan måles, konsistens af diskarrayet), sker gennem Zabbix, mens hvad angår applikationer, bruges eksportøren i Prometheus. For overvågning af KVM kan du for eksempel tage projektet og sætte det op til at køre gennem systemd, det fungerer ganske godt og viser KVM-metrikker, der er også et færdigt dashboard. .
For eksempel, her er min fil:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
Så vi har 1 eksportør, vi har brug for en anden til overvågning af selve OpenNebula, jeg brugte sådan en
Det kan tilføjes til det almindelige til systemovervågning som følgende.
I filen for Node Exporter ændrer vi starten således:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorOpretter en mappe mkdir -p /var/lib/opennebula_exporter
bash-scriptet præsenteret ovenfor tester vi først funktionalitet via konsollen; hvis det viser, hvad det skal (hvis det giver en fejl, så installerer vi xmlstarlet), kopierer vi det til /usr/local/bin/opennebula_exporter.sh
Tilføjer en cron-job hvert minut:
*\/1 * * * * (\/usr\/local\/bin\/opennebula_exporter.sh > \/var\/lib\/opennebula_exporter\/textfile_collector\/opennebula.prom)Metrikkerne er begyndt at dukke op, man kan hente dem med Prometheus, opbygge grafer og lave alarmer. I Grafana kan man for eksempel lave et simpelt dashboard som dette.
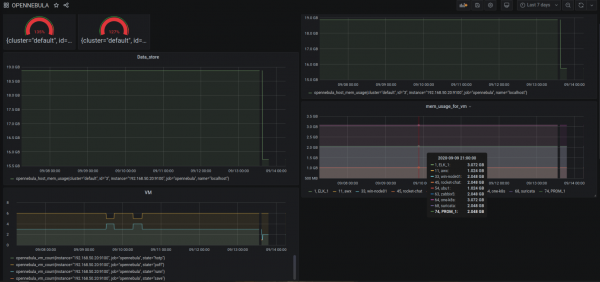
(det er klart, at jeg har lavet overcommit på cpu, ram)
For dem der elsker og bruger Zabbix, er der
Det er alt om overvågning, det vigtigste er, at det eksisterer. Selvfølgelig kan man supplere med de indbyggede værktøjer til overvågning af virtuelle maskiner og eksportere data til fakturering, her har alle deres egen opfattelse, jeg har endnu ikke dykket dybere ind i det.
Til logging er jeg ikke kommet så langt endnu. Som det enkleste alternativ er det at tilføje td-agent til at parse mappen \/var\/lib\/one med regulære udtryk. For eksempel passer filen sunstone.log til regexp nginx og andre filer, der viser historikken for anmodninger til platformen — hvad er fordelen ved dette? Ja, vi kan tydeligt følge antallet af "Error, error" og hurtigere finde ud af, hvor og på hvilket niveau der er en fejl.
3. Backup
Der er også betalte tilfredsstillende projekter — for eksempel sep :OpenNebula_Backup. Her skal vi forstå, at det ikke blot handler om at lave backup af maskinens billede, da vores virtuelle maskiner skal fungere med fuld integration (den samme kontekstfil, hvor netværksindstillinger, vm-navn og tilpassede indstillinger for dine applikationer beskrives). Derfor fastlægger vi, hvad og hvordan vi vil lave backup. I nogle tilfælde er det bedre at lave kopier af det, der findes i selve vm. Og det kan være nødvendigt kun at tage backup af én disk fra denne maskine.
For eksempel har vi fastlagt, at alle maskiner starter med persistente billeder, så vi har læst
det betyder, at vi først kan eksportere billedet fra vores vm:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Lad os se, hvilket navn det er gemt under

oneimage show 77
\/var\/lib\/one\/datastores\/100\/f9503161fe180658125a9b32433bf6e8

Og derefter kopierer vi det, hvor vi har brug for det. Selvfølgelig er det ikke den bedste metode. Jeg ville bare vise, at ved at bruge OpenNebula værktøjer kan man bygge lignende løsninger.
Jeg har også fundet og der er også , men her kun til qcow2 lager.
Men som vi alle ved, kommer der en tid, hvor man ønsker inkrementelle sikkerhedskopier. Det er sværere, og muligvis vil ledelsen bevilge penge til en betalt løsning, eller man kan gå en anden vej og forstå, at her bruger vi kun ressourcer, mens sikkerhedskopieringen foregår på applikationsniveau og ved at tilføje flere noder og virtuelle maskiner. Ja, her siger jeg, at man kun bruger cloud til at starte applikationsklustre, mens databaser køres på en anden platform eller tages fra en leverandør, hvis det er muligt.
4. Brugervenlighed
I dette afsnit vil jeg beskrive de problemer, jeg har stødt på. For eksempel, når det kommer til billeder, som vi ved er persistent — når dette billede er monteret til en VM, bliver alle data skrevet til dette billede. Men hvis det er non-persistent, kopieres billedet til lageret, og data skrives i det, der blev kopieret fra det oprindelige billede — sådan fungerer skabelonerne. Jeg har gentagne gange skabt problemer for mig selv ved at glemme at angive persistent, og 200 GB billedet blev kopieret; problemet er, at denne procedure med sikkerhed ikke kan annulleres, man skal gå til noden og stoppe den aktuelle proces 'cp'.
En af de væsentlige ulemper er, at man ikke kan annullere handlingerne blot ved at bruge GUIt. Faktisk vil du annullere dem og se, at intet sker, og så igen starte, annullere, hvorefter der i realiteten vil være 2 cp-processer, der kopierer billedet.
Og her kommer forståelsen af, hvorfor OpenNebula nummererer hver ny instans med et nyt ID. For eksempel, hvis jeg i Proxmox har oprettet en VM med ID 101, slettede den og derefter igen opretter den, vil ID være 101. I OpenNebula vil dette ikke ske, hver ny instans oprettes med et nyt ID, hvilket har sin egen logik — for eksempel rensning af gamle data eller mislykkede installationer.
Det samme gælder for lageret; denne platform er især rettet mod centraliseret lagring. Der er tilføjelsesprogrammer til brug af lokale ressourcer, men det handler ikke om dette. Jeg tror, at i fremtiden vil nogen skrive en artikel om, hvordan man har formået at bruge lokal lagring på noder og succesfuldt anvende det i produktion.
5. Maksimal enkelhed
Selvfølgelig, jo længere man går, desto færre bliver der, der virkelig forstår en.
Under my setup — 3 nodes with NFS storage — everything works fine. However, when conducting power-off experiments, for example during a snapshot launch and power-off of the node, we retain settings in the database indicating that there is a snapshot, but in reality, it doesn't exist (well, we all understand that initially, it recorded in the SQL database about this action, but the operation itself was unsuccessful). The plus side is that when creating a snapshot, a separate file is generated, and there is a "parent," so in case of problems, even if it doesn't work through the GUI, we can take the QCOW2 file and restore it separately.
When it comes to networks, unfortunately, it's not that simple. At least it's easier than in OpenStack; I only used VLAN (802.1Q) — it works quite well, but if you make changes to the settings from the template network, those settings will not apply to already running machines, so you have to delete and re-add the network card for the new settings to take effect.
If we want to compare it to OpenStack, we can say that in OpenNebula there's no clear definition of which technologies to use for data storage, network management, or resources — each administrator decides for themselves what is most convenient.
6. Additional plugins and installations
As we know, the cloud platform can manage not only KVM but also VMware ESXi. Unfortunately, I didn't have a pool with vCenter; if anyone has tried it, please let me know.
Support for other cloud providers has been stated.
AWS, AZURE.
I also tried to connect VMware Cloud from Selectel, but it didn't work out — in general, I gave up. There are too many factors, and there's no point in writing to the hosting provider's tech support.
Additionally, the new version now features Firecracker — this is launching microVMs, a type of KVM wrapping over Docker, which provides even more versatility, security, and performance because it doesn't waste resources on hardware emulation. I see only advantages compared to Docker in that it doesn't occupy additional processes and there are no occupied sockets when using this emulation, so it can quite well be used as a load balancer (but I suppose a separate article should be written about this; I haven't conducted all tests in full yet).
7. Positive experience using and debugging errors
Jeg ville dele mine observationer om arbejdet, jeg har beskrevet en del ovenfor, og jeg vil gerne skrive mere. Det er sandsynligvis ikke kun mig, der i starten tænker, at dette ikke er det rigtige system, og at alt her er klodset — hvordan arbejder man overhovedet med dette? Men så kommer forståelsen, og det bliver ganske logisk. Selvfølgelig kan man ikke tilfredsstille alle, og nogle punkter kræver forbedringer.
For eksempel en simpel operation til at kopiere et diskbillede fra en datastore til en anden. I mit tilfælde er der 2 noder med NFS, jeg sender billedet — kopieringen går gennem frontend OpenNebula, selvom vi alle er vant til, at data skal kopieres direkte mellem værterne — i VMware, Hyper-V er vi vant til dette, men her er det anderledes. Her er der en anden tilgang og ideologi, og i version 5.12 er knappen „migrate to datastore“ fjernet — det er kun selve maskinen, der flyttes, men ikke lageret, da der underforstås et centraliseret lager.
Yderligere en populær fejl med forskellige årsager: „Error deploying virtual machine: Could not create domain from /var/lib/one//datastores/103/10/deployment.5“ Nedenfor vil der være en liste over, hvad man skal se på.
- Retten til billedet for brugeren oneadmin;
- Rettigheder for brugeren oneadmin til at starte libvirtd;
- Er datastore korrekt monteret? Gå og tjek stien på selve noden, det er muligt, at noget er faldet af;
- Forkert konfigureret netværk, snarere står der i frontend-netværksindstillingerne, at br0 er den primære grænseflade for VLAN, men på noden står der — bridge0 — det skal være ens.
System datastore gemmer metadata for din VM, hvis du starter VM med et persistent image, skal VM have adgang til den oprindeligt oprettede konfiguration på det lager, hvor du har oprettet VM — dette er meget vigtigt. Derfor skal man dobbelttjekke alt, når man flytter VM til en anden datastore.
8. Dokumentation, community. Videre udvikling
Og resten, god dokumentation, et community, og vigtigst af alt, at projektet fortsat lever fremadrettet.
Her er det generelt, alt er ret godt dokumenteret, og selv med den officielle kilde vil det ikke være noget problem at installere og finde svar på spørgsmål.
Fællesskabet er aktivt. De offentliggør mange færdige løsninger, som du kan bruge i dine installationer.
På nuværende tidspunkt er nogle politikker ændret i virksomheden med version 5.12 Det vil være interessant at finde ud af, hvordan projektet udvikler sig. I begyndelsen nævnte jeg specifikt nogle leverandører, der bruger deres løsninger og det, som industrien tilbyder. Der er ikke et klart svar på, hvad du bør bruge. Men for små organisationer kan støtte til deres eget lille private sky ikke være så dyrt, som det synes. Det vigtigste er at vide præcist, hvad du har brug for.
Som konklusion, uanset hvad du vælger som sky system, bør du ikke stoppe ved ét produkt. Hvis du har tid, er det værd at se på nogle andre mere åbne løsninger.
Der er en god chatgruppe de hjælper aktivt og sender ikke dig hen for at finde løsningen på problemet i Google. Tilmeld dig.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish