

Præsentationen omhandler praktiske spørgsmål vedrørende udviklingen af operatører i Kubernetes, design af deres arkitektur og grundlæggende driftsprincipper.
I den første del af præsentationen vil vi diskutere:
- hvad en operator i Kubernetes er, og hvorfor den er nødvendig;
- hvordan en operator forenkler administrationen af komplekse systemer;
- hvad en operator kan, og hvad en operator ikke kan.
Derefter vil vi gå videre til at diskutere den indre struktur af operatøren. Vi vil se på arkitektur og funktionalitet af operatøren trin for trin. Vi vil detaljeret gennemgå:
- interaktionen mellem operatøren og Kubernetes;
- hvilke funktioner operatøren påtager sig, og hvad den delegerer til Kubernetes.
Vi vil se på håndtering af shards og replikaer af databaser i Kubernetes.
Derefter vil vi diskutere spørgsmål om datalagring:
- hvordan man arbejder med Persistent Storage set fra operatørens synspunkt;
- faldgruber ved brug af Local Storage.
I den afsluttende del af præsentationen vil vi se på praktiske eksempler på anvendelse af med Amazon eller Google Cloud Service. Præsentationen er bygget på eksemplet med udviklingen og driften af en operatør til ClickHouse.
Video:
Mit navn er Vladislav Klimenko. Jeg vil i dag fortælle om vores erfaring med at udvikle og drive en operatør, som er en specialiseret operatør til at styre databaser. For eksempel til styring af et ClickHouse-klasse.
Hvorfor har vi mulighed for at tale om operatøren og ClickHouse?
- Vi arbejder med support og udvikling af ClickHouse.
- I øjeblikket forsøger vi langsomt at bidrage til udviklingen af ClickHouse. Vi er de næststørste efter Yandex i forhold til det antal ændringer, der er foretaget i ClickHouse.
- Vi forsøger at lave yderligere projekter til ClickHouse-økosystemet.
Om et af disse projekter vil jeg gerne fortælle. Det handler om ClickHouse-operatoren til Kubernetes.
I min præsentation vil jeg berøre to emner:
- Det første emne er, hvordan vores operatør til styring af ClickHouse-databaser i Kubernetes fungerer.
- Det andet emne er, hvordan enhver operatør fungerer, dvs. hvordan den interagerer med Kubernetes.
Disse to spørgsmål vil krydse hinanden hele vejen igennem min præsentation.
Hvem vil finde det interessant at høre om det, jeg prøver at fortælle?
- Det vil især være interessant for dem, der driver operatører.
- Eller til dem, der ønsker at lave deres egen, for at forstå, hvordan det fungerer internt, hvordan operatøren interagerer med Kubernetes, og hvilke faldgruber der kan opstå.
For bedre at forstå det, vi skal diskutere i dag, ville det være godt at vide, hvordan Kubernetes fungerer og have en grundlæggende viden om cloud-teknologier.
Hvad er ClickHouse? Det er en kolonnebaseret database med fokus på online behandling af analytiske forespørgsler. Og den er helt open source.
Og vi skal kun vide to ting. Vi skal vide, at det er en database, så alt, hvad jeg vil fortælle, vil være anvendeligt for praktisk talt enhver database. Og at databasesystemet ClickHouse skalerer meget godt, hvilket giver næsten lineær skalerbarhed. Og derfor er tilstanden i klyngen en naturlig tilstand for ClickHouse. Vi er især interesserede i at diskutere, hvordan man vedligeholder ClickHouse-klyngen i Kubernetes.
Hvorfor er det nødvendigt der? Hvorfor kan vi ikke fortsætte med at køre det selv? Og svarene er delvist tekniske og delvist organisatoriske.
- I praksis ser vi oftere og oftere en situation, hvor næsten alle komponenter i store virksomheder allerede er i Kubernetes. Databasekomponenterne forbliver udenfor.
- Og spørgsmålet stilles oftere: "Kan dette bringes ind?". Derfor forsøger store virksomheder at skabe maksimal ensartethed i administrationen for hurtigt at kunne håndtere deres datalagre.
- Og det hjælper især, hvis der er brug for maksimal mulighed for at gentage det samme et nyt sted, dvs. maksimal bærbarhed.
Hvor nemt eller svært er det? Det kan selvfølgelig gøres manuelt. Men det er ikke så simpelt, fordi vi får kompleksiteten ved at administrere Kubernetes blandet ind med ClickHouse's specifik.
Og alt dette giver et ret stort sæt teknologier, som det bliver ret svært at håndtere, fordi Kubernetes bringer sine daglige driftsspørgsmål, mens ClickHouse bringer sine spørgsmål til daglig drift. Især hvis vi har flere ClickHouse-instanser, og vi konstant skal gøre noget med dem.
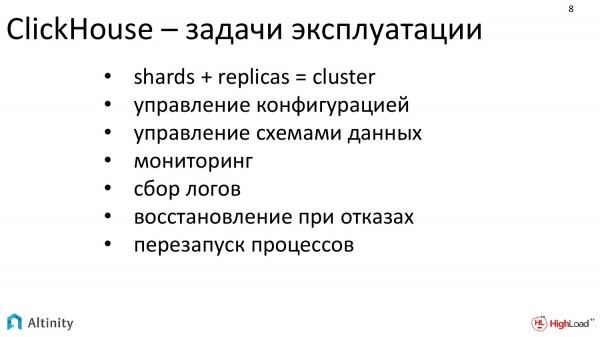
I ClickHouse er der en betydelig mængde spørgsmål vedrørende dynamisk konfiguration, som konstant belaster DevOps:
- Når vi ønsker at ændre noget i ClickHouse, for eksempel at tilføje en replika eller en shard, skal vi gennemføre konfigurationsstyring.
- Dernæst skal vi ændre dataskemaet, fordi ClickHouse har en speciel måde at shardere på. Vi skal fordele dataskemaet og konfigurationerne.
- Vi skal indstille overvågning.
- Indsamling af logs for nye shards og nye replikaer.
- Sørge for genopretning.
- Og genstart.
Det er sådanne rutineopgaver, som vi gerne vil lette i driftsmiljøet.
Selv Kubernetes hjælper godt i driften, men kun med de grundlæggende systemrelatede opgaver.
Kubernetes gør det nemmere og automatiserer opgaver som:
- Genopretning.
- Genstart.
- Styring af opbevaringssystemet.
Det er godt, det er den rigtige retning, men det har ikke en fuldstændig forståelse af, hvordan man driver en databasekluster.
Vi ønsker mere, vi vil have, at hele databasen kører i Kubernetes.
Vi vil have noget, der ligner en stor magisk rød knap, som du trykker på, og så får du udrullet og vedligeholdt et kluster med daglige opgaver, der skal løses. Et ClickHouse kluster i Kubernetes.
Og vi har forsøgt at lave en løsning, der ville lette arbejdet. Det er ClickHouse-operatoren til Kubernetes fra firmaet Altinity.
En operator er et program, hvis hovedopgave er at styre andre programmer, dvs. det er en manager.
Og den indeholder adfærdsmønstre. Man kan kalde det kodificerede viden om det relevante område.
Og dens primære opgave er at lette livet for DevOps og reducere mikrostyring, så DevOps kan tænke i højere niveauer, dvs. at de ikke skal beskæftige sig med mikrostyring og manuelt indstille alle detaljer.
Og netop operatoren er en robotassistent, der kæmper med mikrouppgaver og hjælper DevOps.
Hvorfor har vi brug for en operator? Den er især effektiv i to spørgsmål:
- Når en specialist, der arbejder med ClickHouse, har utilstrækkelig erfaring, men ClickHouse alligevel skal anvendes, letter operatøren driften og gør det muligt at køre et ClickHouse-klynge med en ret kompleks konfiguration, uden at man behøver at dykke for meget ned i detaljerne om, hvordan det hele fungerer indeni. Man giver dem bare opgaver på et overordnet niveau, og det fungerer.
- Og den anden opgave, hvor han klarer sig bedst, er, når der skal automatiseres et stort antal standardopgaver. Han fjerner mikrouppgaver fra systemadministratorerne.
Det er mest nødvendigt for dem, der lige er begyndt deres rejse, eller for dem, der har meget at gøre med automatisering.
Hvad er forskellen mellem den operatørbaserede tilgang og andre systemer? Der findes også Helm. Det hjælper også med at installere ClickHouse, man kan tegne helm charts, som endda kan opsætte en hel ClickHouse-klynge. Hvad er så forskellen mellem operatøren og for eksempel Helm?
Den vigtigste fundamentale forskel er, at Helm er pakkeadministration, mens operatøren går videre. Det handler om at støtte hele livscyklussen. Det er ikke kun installationen, men også daglige opgaver, der inkluderer skalering, sharding, altså alt det, der skal udføres i løbet af livscyklussen (hvis nødvendigt også sletning) – det hele løses af operatøren. Han forsøger at automatisere og vedligeholde hele livscyklussen for softwaren. Det er hans fundamentale forskel i forhold til de øvrige løsninger, der findes.
Dette var det indledende afsnit, lad os komme videre.
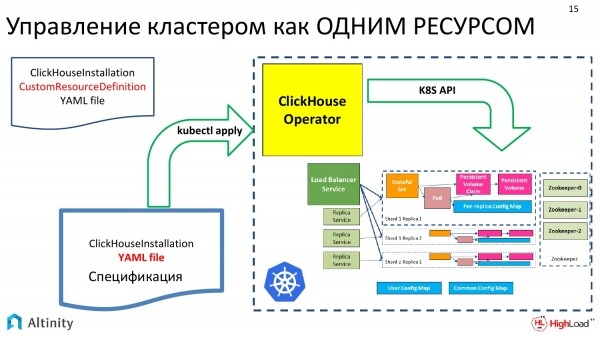
Hvordan bygger vi vores operatør? Vi forsøger at tage fat på spørgsmålet om at administrere ClickHouse-klyngen som en enkelt ressource.
Her til venstre er dataene. Det er YAML med specifikationen af klyngen, som klassisk overføres til Kubernetes via kubectl. Her griber operatøren ind, udfører sin magi, og vi ender med en skema. Det er implementeringen af ClickHouse i Kubernetes.
Og videre vil vi langsomt se på, hvordan operatøren fungerer, hvilke standardopgaver man kan løse. Vi vil kun se på standardopgaverne, fordi vi har begrænset tid. Og der vil blive fortalt om ikke alt, hvad operatøren kan løse.
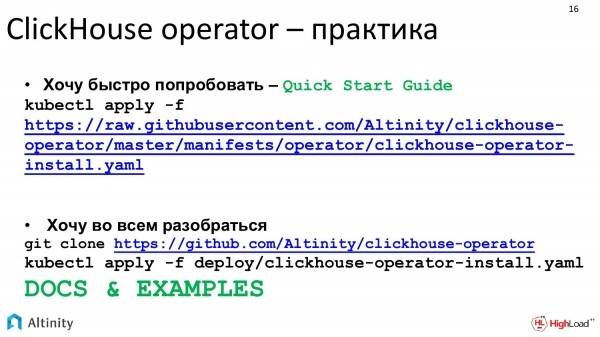
Lad os tage udgangspunkt i praksis. Vores projekt er helt open source, så man kan se på GitHub, hvordan det fungerer. Og man kan tage udgangspunkt i, hvis man blot ønsker at komme i gang, at man kan starte med Quick Start Guide.
Hvis man ønsker at dykke ned i detaljerne, forsøger vi at holde dokumentationen i nogenlunde god stand.
Lad os starte med en praktisk opgave. Den første opgave, som vi alle ønsker at starte med, er at få det første eksempel op at køre på en eller anden måde. Hvordan kan man starte ClickHouse ved hjælp af operatøren, selv uden at vide præcis, hvordan det fungerer? Vi skriver et manifest, da al kommunikation med k8s er gennem manifester.
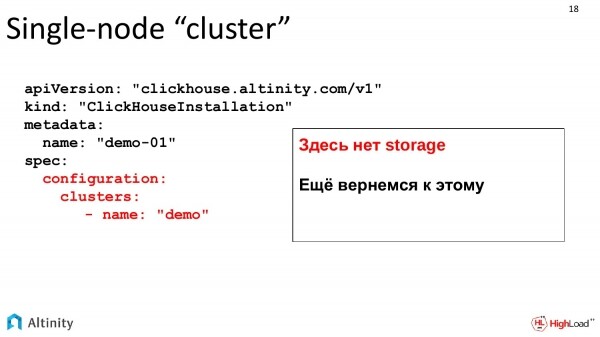
Her er et komplekst manifest. Det, vi har markeret med rødt, er det, vi skal fokusere på. Vi beder operatøren om at oprette et cluster med navnet demo.
Indtil videre er dette grundlæggende eksempler. Storage er endnu ikke beskrevet, men vi vender tilbage til storage lidt senere. Indtil videre vil vi følge udviklingen af clustret dynamisk.
Vi har oprettet dette manifest. Vi giver det til vores operatør. Han har arbejdet, og lavet sin magi.
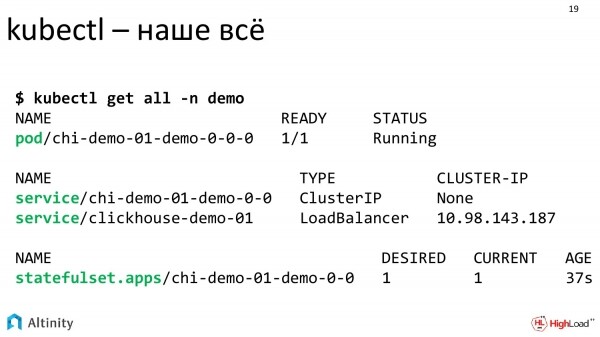
Vi kigger i konsollen. Tre komponenter vækker interesse - det er Pod, to Services, StatefulSet.
Operatøren har arbejdet, og vi kan se, hvad han har oprettet.
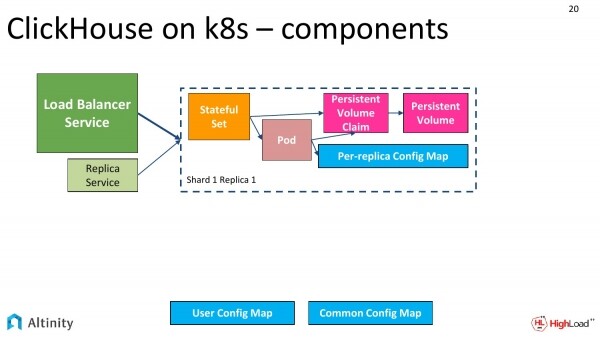
Han skaber omtrent et sådant schema. Vi har en StatefulSet, Pod, ConfigMap for hver replika, ConfigMap for hele clustret. Der skal naturligvis være services som indgangspunkter til clustret.
Services er den centrale Load Balancer Service, og man kan også have en for hver replika, for hver shard.
Her ser vores grundlæggende cluster ud nogenlunde således. Det består af én enkelt node.
Lad os gå videre og gøre det mere komplekst. Vi skal shardere clustret.
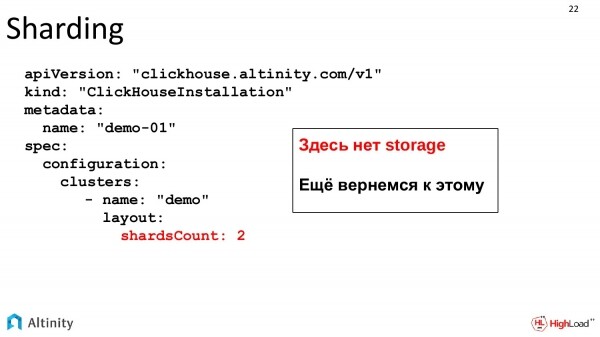
Vores opgaver vokser, dynamikken begynder. Vi ønsker at tilføje en shard. Vi følger udviklingen. Vi ændrer vores specifikation. Vi angiver, at vi ønsker to shards.
Dette er den samme fil, som dynamisk udvikler sig i takt med systemets vækst. Storage er ikke til stede, det vil blive betragtet senere, det er et separat emne.
Vi giver YAML-operatøren og ser, hvad der sker.
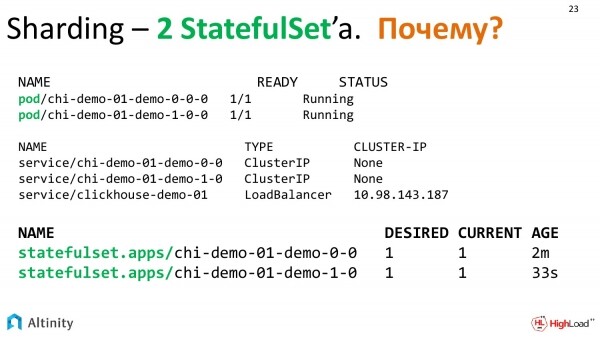
Operatøren overvejede og skabte følgende enheder. Vi har allerede to Pods, tre Services og, overraskende, 2 StatefulSets. Hvorfor 2 StatefulSets?
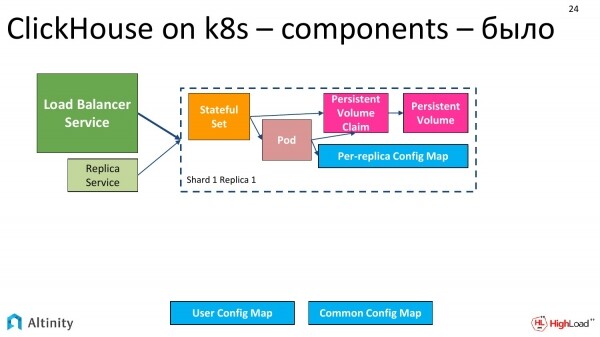
I diagrammet var det sådan her - dette var vores initiale tilstand, da vi havde én pod.
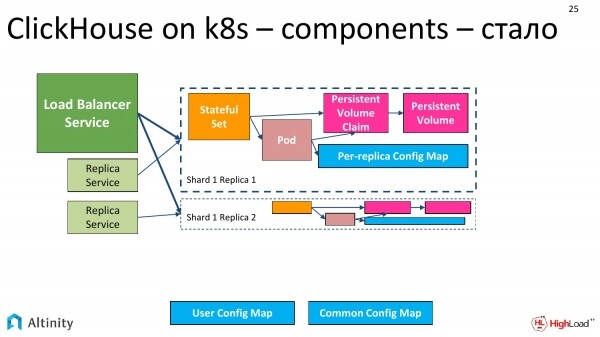
Det er nu blevet sådan her. Indtil videre er alt enkelt, det har blot duplikeret.
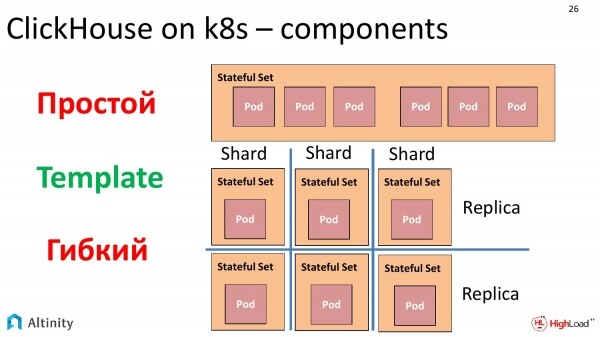
Og hvorfor er StatefulSet nu blevet to? Her må vi afbryde os selv og diskutere spørgsmålet om, hvordan Kubernetes håndterer Pods.
Der findes et objekt kaldet StatefulSet, som gør det muligt at oprette en samling af Pods fra en skabelon. Den nøglefaktor her er skabelonen. Og man kan i et StatefulSet køre mange Pods ud fra en enkelt skabelon. Den centrale sætning her er "mange Pods ud fra en enkelt skabelon".
Der var en stor fristelse til at lave hele klyngen pakket ind i ét StatefulSet. Det ville fungere, der er ingen problemer med det. Men der er en nuance. Hvis vi ønsker at samle en heterogen klynge, altså fra flere versioner af ClickHouse, så begynder vi at få spørgsmål. Ja, StatefulSet kan lave rolling updates, og her kan man rulle en ny version ud, men man skal forklare, at man ikke bør opdatere mere end et vist antal noder ad gangen.
Men hvis vi ekstrapolerer opgaven og siger, at vi ønsker at lave en helt heterogen klynge, og vi ikke ønsker at skifte fra den gamle version til den nye ved hjælp af rolling updates, men simpelthen vil skabe en heterogen klynge både hvad angår forskellige versioner af ClickHouse og forskellige lagringsmetoder. Vi ønsker for eksempel at opsætte nogle replikaer på separate diske, på langsomme diske, i det hele taget bygge en helt heterogen klynge. Og fordi StatefulSet laver et standardiseret resultat ud fra én skabelon, er der ikke mulighed for at gøre dette.
Efter lidt overvejelse blev det besluttet, at vi gør det på denne måde. Hver replika har sit eget StatefulSet. Der er nogle ulemper ved denne løsning, men i praksis indkapsler det fuldstændig operatøren. Og der er mange fordele. Vi kan bygge en helt sådan klynge, som vi vil, for eksempel en helt heterogen en. Derfor, i en klynge hvor vi har to shards med én replika hver, vil vi have 2 StatefulSets og 2 Pods netop fordi vi har valgt denne tilgang af de nævnte grunde for at muliggøre opbygningen af en heterogen klynge.
Lad os vende tilbage til praktiske opgaver. I vores klynge skal vi konfigurere brugere, altså vi skal udføre en form for konfiguration af ClickHouse i Kubernetes. Operatøren giver alle muligheder for dette.
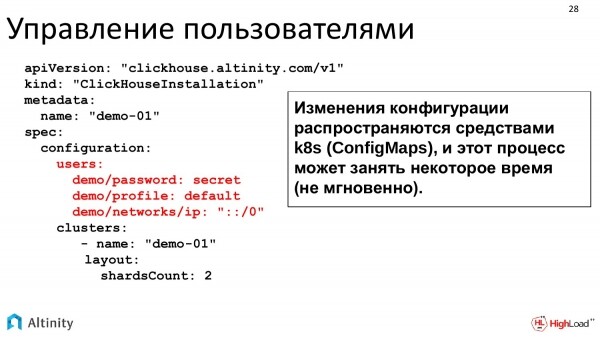
Man kan direkte i YAML skrive det, vi ønsker. Alle konfigurationsmuligheder kortlægges direkte fra denne YAML til ClickHouse-konfigurationer, som derefter distribueres i hele klyngen.
Det er muligt at skrive sådan her. Dette er et eksempel. Adgangskoden kan gøres krypteret. Alle konfigurationsmuligheder for ClickHouse understøttes. Dette er kun et eksempel.
Konfigurationen for klyngen distribueres som ConfigMap. I praksis opdateres ConfigMap ikke øjeblikkeligt, så hvis der er en stor klynge, kan processen med at implementere konfigurationen tage noget tid. Men alt dette er meget praktisk i drift.
Vi komplicerer opgaven. Klyngen udvikler sig. Vi ønsker at replikere data. Det vil sige, vi har allerede to shards med én replik, og brugerne er konfigureret. Vi vokser og ønsker at håndtere replikationen.
Hvad har vi brug for til replikation?
Vi har brug for ZooKeeper. I ClickHouse er replikation bygget ved hjælp af ZooKeeper. ZooKeeper er nødvendigt for, at de forskellige replikker i ClickHouse har enighed om, hvilke datablokke der er tilgængelige i hvilken ClickHouse.
Du kan bruge enhver ZooKeeper. Hvis virksomheden har en ekstern ZooKeeper, kan den bruges. Hvis ikke, kan vi installere en fra vores repository. Der er en installer, der gør dette lettere.
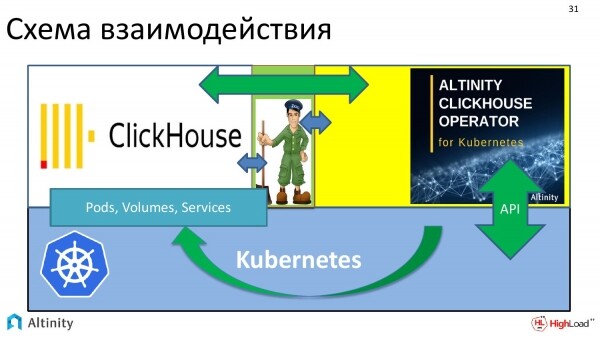
Og interaktionsskemaet for hele systemet ser således ud. Vi har Kubernetes som platform. ClickHouse-operatoren kører på den. ZooKeeper er tegnet her. Og operatoren interagerer både med ClickHouse og med ZooKeeper. Det vil sige, der opstår interaktion.
Og alt dette er nødvendigt, for at ClickHouse effektivt kan replikere data i k8s.
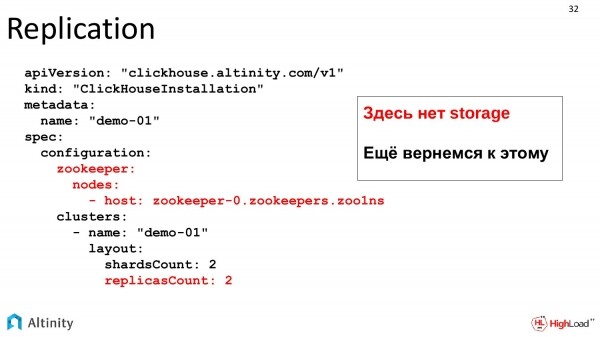
Lad os nu se på selve opgaven, hvordan manifestet til replikation vil se ud.
Vi tilføjer to sektioner til vores manifest. Den første er, hvor vi skal tage ZooKeeper fra, som kan være internt i Kubernetes eller eksternt. Dette er blot en beskrivelse. Og vi bestiller replikker. Det vil sige, vi ønsker to replikker. I alt skal vi have 4 pods. Om storage husker vi, det kommer lidt senere. Storage er et eget kapitel.
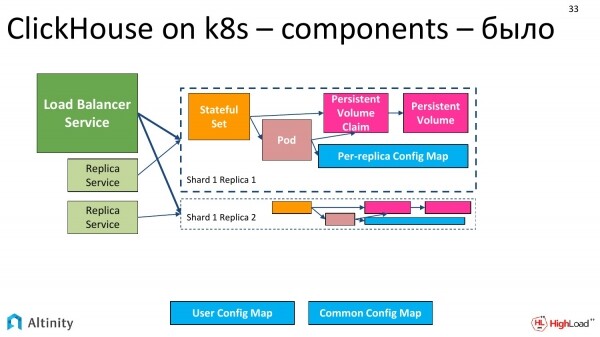
Det var sådan her.
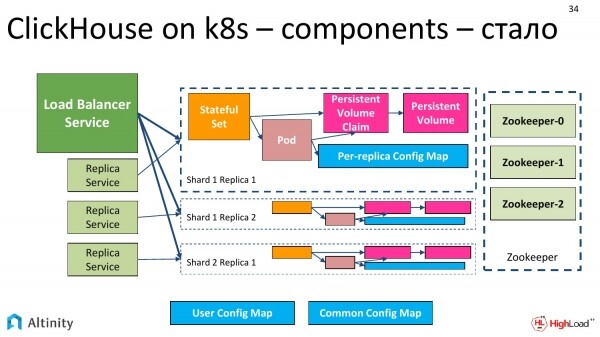
Det bliver sådan her. Replikker tilføjes. Den 4. kunne ikke være der, vi tror, at der kan være mange af dem. Og ZooKeeper tilføjes fra siden. Skemaerne bliver mere komplicerede.
Og tiden er kommet til at tilføje den næste opgave. Vi vil tilføje Persistent Storage.
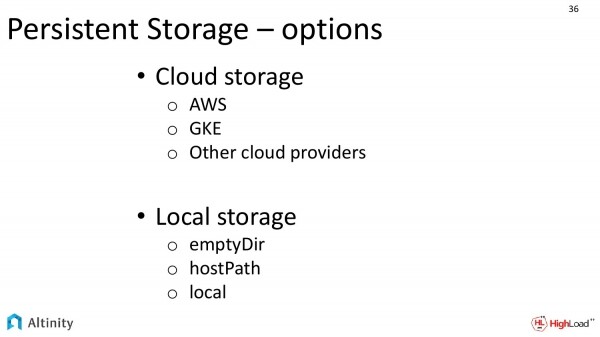 For Persistent Storage har vi forskellige implementeringsmuligheder.
I tilfælde af, at vi kører i en cloud-udbyder, som for eksempel Amazon eller Google, er der en stor fristelse til at benytte sig af cloud storage. Det er meget praktisk, det er godt.
Der er en anden mulighed. Dette er til local storage, når vi har lokale diske på hver node. Denne mulighed er meget sværere at implementere, men samtidig er den mere effektiv.
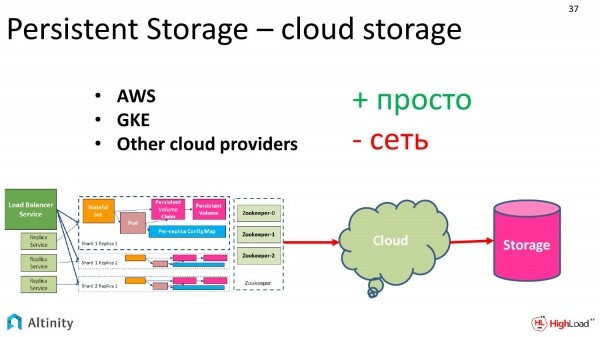
Lad os se på, hvad vi har i forhold til cloud storage.
Der er fordele. Det er meget nemt at konfigurere. Vi bestiller blot fra en cloud-udbyder, og beder om, at få given storage med en bestemt kapacitet og klasse. Klasserne er beskrevet af udbyderne selv.
Og der er en ulempe. For nogen er dette en ikke-kritisk ulempe. Der vil selvfølgelig være nogle nedsættelser i præstationen. Det er meget praktisk at arbejde med, pålideligt, men der er nogle potentielle fald i præstationen.
Da ClickHouse fokuserer på præstation, kan man endda sige, at det udnytter alt, hvad der er muligt, så mange kunder forsøger at maksimere præstationen.
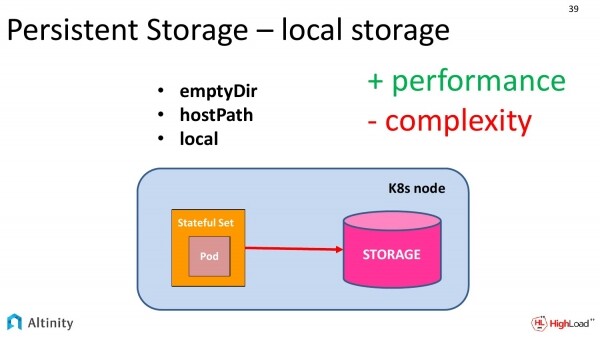
For at maksimere præstationen har vi brug for local storage.
Kubernetes tilvejebringer tre abstraktioner til brug af local storage i Kubernetes. Det er:
- EmptyDir
- HostPath.
- Local
Lad os se på, hvad der adskiller dem, og hvad der er ens.
For det første, i alle tre tilgange har vi storage – det er lokale diske, der ligger på den samme fysiske k8s-node. Men de har nogle forskelle.
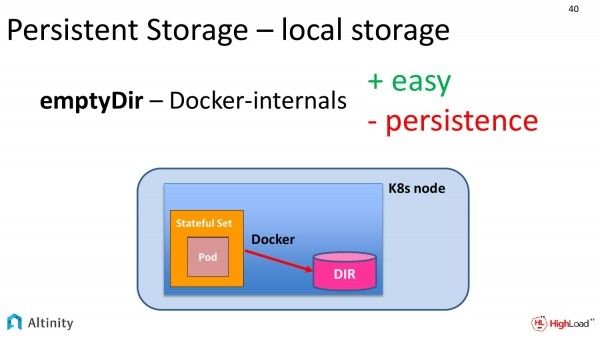
Lad os starte med den enkleste, dvs. emptyDir. Hvad er det i praksis? Det er, når vi beder vores specifikation om at give systemet til containerisering (oftest er det Docker) adgang til en mappe på den lokale disk.
I praksis opretter Docker et sted i sine egne stier en midlertidig mappe, kalder den et langt hash. Og giver adgangsgrænsefladen til det.
Hvordan vil det fungere med hensyn til præstation? Det vil fungere med hastigheden af den lokale disk, dvs. det er fuldstændig adgang til sin egen disk.
Men denne metode har sin ulempe. Persistent i denne sammenhæng er ret tvivlsom. Ved den første bevægelse af Docker med containere går Persistent tabt. Hvis Kubernetes af en eller anden grund vil flytte denne Pod til en anden disk, bliver dataene tabt.
Denne tilgang er god til tests, fordi hastigheden er acceptabel, men til noget seriøst er denne mulighed ikke egnet.
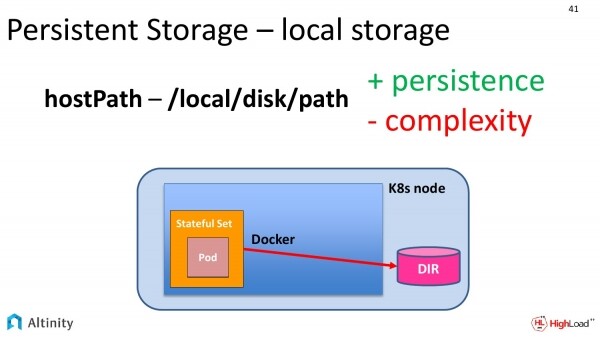
Derfor findes der en anden tilgang. Dette er hostPath. Hvis vi ser på den tidligere slide og denne, kan vi bemærke én forskel. Vores mappe er flyttet fra Docker direkte til Kubernetes noden. Her er det lidt enklere. Vi angiver blot stien til det lokale filsystem, hvor vi ønsker at gemme vores data.
Der er fordele ved denne metode. Dette er allerede en ægte Persistent, en klassisk en. Vores data vil blive gemt på disken et bestemt sted.
Der er også ulemper. Det er vanskeligt at administrere. Vores Kubernetes kan beslutte at flytte en Pod til en anden fysisk node. Og her træder DevOps ind. De skal korrekt kommunikere til hele systemet, at disse pod'er kun kan flyttes til mandder, hvor der er noget monteret som angivet, og kun én node ad gangen. Det er ret komplekst.
Specielt til dette formål har vi i vores operatør lavet skabeloner for at skjule al denne kompleksitet. Og man kunne simpelthen sige: «Jeg vil have, at der er én instans af ClickHouse på hver fysisk node og på den angivne sti».
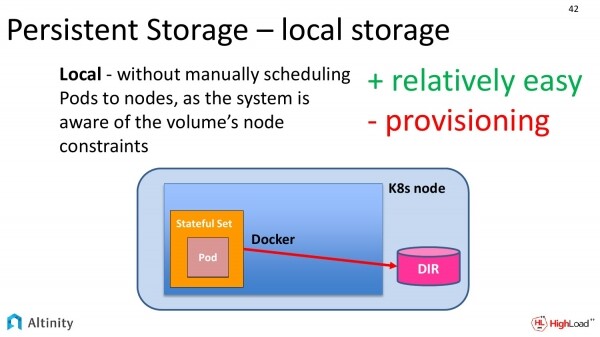
Men dette behov gælder ikke kun os, derfor forstår herrerne fra Kubernetes også, at folk gerne vil have adgang til fysiske diske, og derfor tilbyder de et tredje niveau.
Det kaldes local. Der er stort set ingen forskel fra den tidligere slide. Tidligere skulle vi manuelt sørge for, at vi ikke kunne flytte disse pod'er fra node til node, fordi de skulle være knyttet til den specifikke sti til den lokale fysiske disk, men nu er al denne viden indkapslet i selve Kubernetes. Og det bliver meget nemmere at konfigurere.
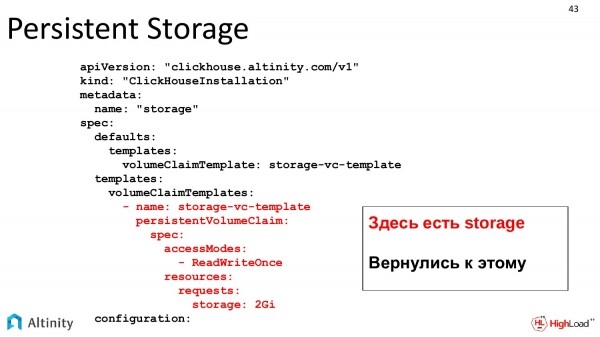
Lad os vende tilbage til vores praktiske opgave. Vi vender tilbage til YAML skabelonen. Her har vi fået en ægte storage. Vi er tilbage til dette. Vi angiver en klassisk VolumeClaim skabelon som i k8s. Og beskriver, hvilken storage vi ønsker.
Derefter vil k8s anmode om storage. Den vil tildele os det i StatefulSet. Og i sidste ende vil det være til rådighed for ClickHouse.
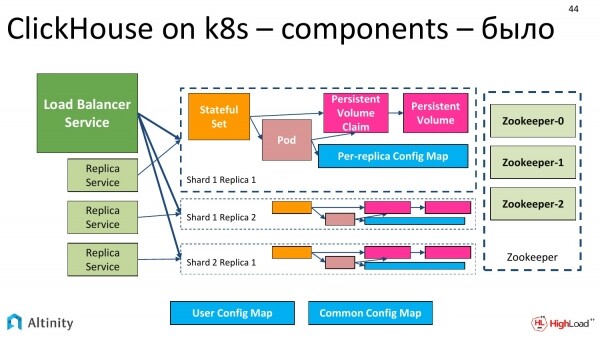
Vi havde en sådan ordning. Vores Persistent Storage var rød, hvilket ligesom antydede, at det burde gøres.
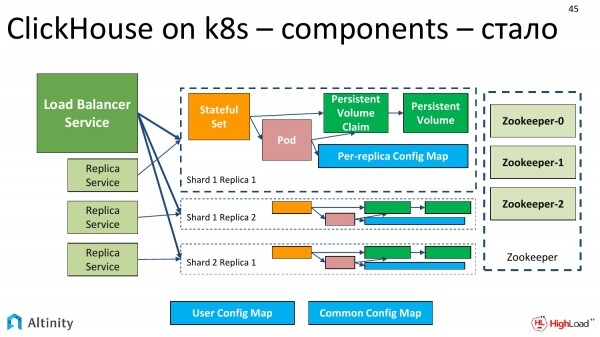
Og den bliver grøn. Nu er diagrammet for ClickHouse på k8s helt finaliseret. Vi har shards, replikaer, ZooKeeper, der er en ægte Persistent, der er implementeret på den ene eller anden måde. Diagrammet er allerede fuldt operationelt.
Vi fortsætter med at leve videre. Vores klynge udvikler sig. Og Alexey gør en indsats og udsender en ny version af ClickHouse.
Der opstår en praktisk opgave – at teste den nye version af ClickHouse på vores klynge. Og selvfølgelig ønsker vi ikke at opdatere hele klyngen; vi vil helst placere den nye version et sted i et afsides hjørne, og måske ikke bare én ny version, men to, fordi de ofte bliver udgivet.
Hvad kan vi sige om dette emne?
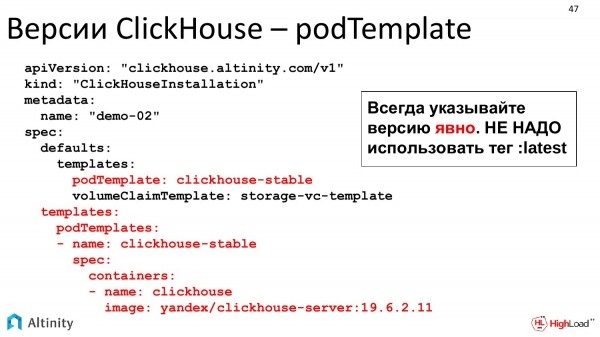
Her har vi netop muligheden for det. Det er pod-skabeloner. Vi kan beskrive det, vores operator giver os mulighed for at opbygge en heterogen klynge. Dvs. at konfigurere fra alle repliker samlet, til hver individuel replika, hvilken version af ClickHouse vi ønsker, hvilken version af storage vi ønsker. Vi kan fuldt ud konfigurere en klynge af den konfiguration, som vi ønsker.
Vi vil nu dykke lidt dybere. Tidligere har vi talt om, hvordan ClickHouse-operatøren fungerer i forhold til specifikationerne for ClickHouse.
Nu vil jeg gerne sige et par ord om, hvordan enhver operatør generelt fungerer, samt hvordan den interagerer med K8s.
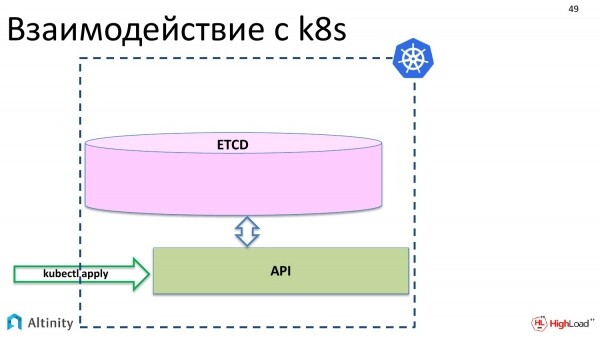
Lad os først se på interaktionen med K8s. Hvad sker der, når vi kører kubectl apply? Vores objekter vises gennem API i etcd.
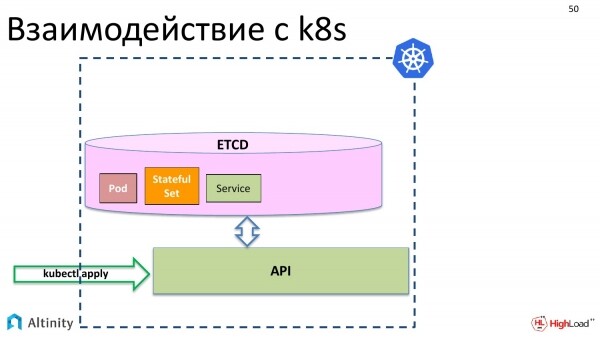
For eksempel de grundlæggende Kubernetes-objekter: pod, StatefulSet, service og så videre i rækkefølgen.
Men intet fysisk sker endnu. Disse objekter skal materialiseres i klyngen.
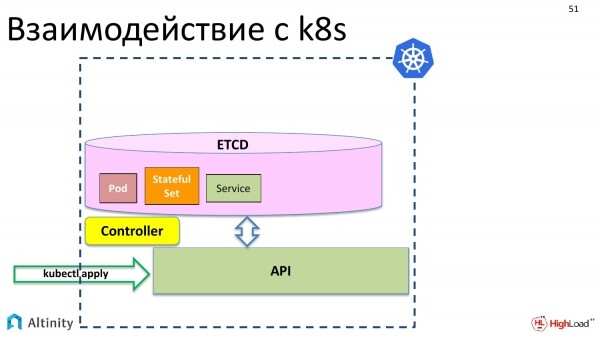
For dette opstår en controller. Controlleren er en speciel komponent i K8s, som kan materialisere disse beskrivelser. Den ved, hvordan og hvad der skal gøres fysisk. Den ved, hvordan man starter containere, og hvad der skal konfigureres for at få serveren til at køre.
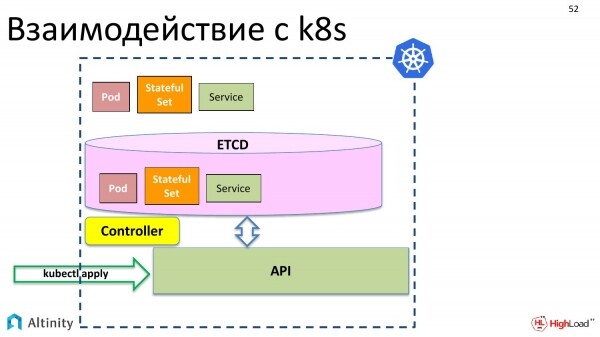
Og den materialiserer vores objekter i K8s.
Men vi ønsker ikke kun at operere med pod-der og StatefulSet-der, vi ønsker at oprette en ClickHouseInstallation, dvs. et objekt af typen ClickHouse, så vi kan operere med det som én helhed. I øjeblikket er der ikke sådan en mulighed.
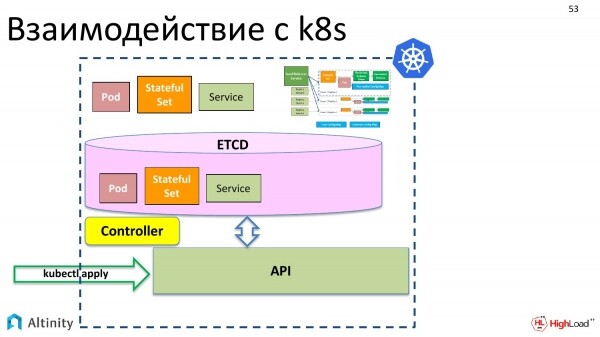
Men K8s har en anden rar funktion. Vi ønsker, at der skal opstå en kompleks enhed, som ville være samlet af pod-der og StatefulSet, vores klynge.
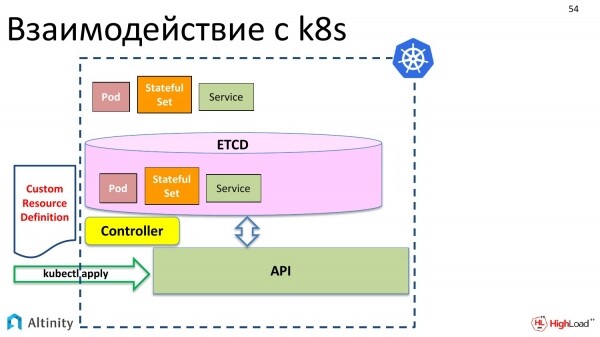
Og hvad skal der til for dette? For det første kommer Custom Resource Definition på scenen. Hvad er det? Det er en beskrivelse for K8s, som angiver, at du får en ny datatype, som vi ønsker at tilføje en brugerdefineret ressource til pod, StatefulSet, der vil være kompleks indeni. Det er en beskrivelse af datakonstruktionen.
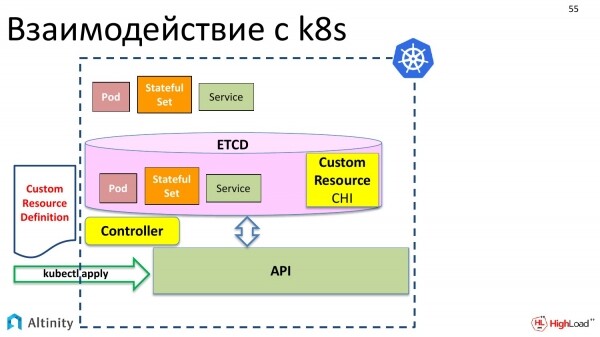
Vi sender det også derhen via kubectl apply. Kubernetes har glædeligt taget det til sig.
Og nu har vi i lageret, for objektet i etcd, mulighed for at registrere en brugerdefineret ressource kaldet ClickHouseInstallation.
Men indtil nu vil der ikke ske mere. Det vil sige, hvis vi nu opretter en YAML-fil, som vi har gennemgået med beskrivelsen af shard, replikaer og siger "kubectl apply", så vil Kubernetes acceptere den, placere den i etcd og sige: "Fint, men jeg ved ikke, hvad jeg skal gøre med den. Hvordan jeg skal håndtere ClickHouseInstallation, ved jeg ikke."
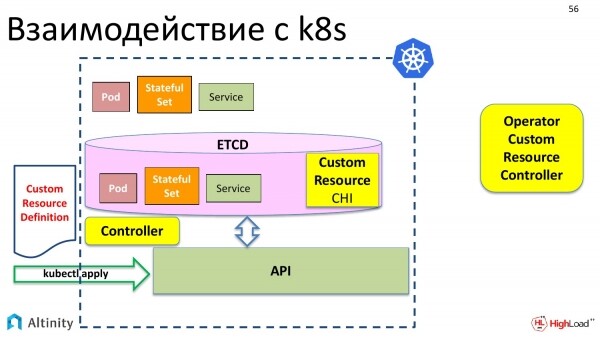
Derfor har vi brug for nogen, der kan hjælpe Kubernetes med at håndtere den nye datatype. Til venstre har vi den indbyggede controller i Kubernetes, som arbejder med de indbyggede datatyper. Og til højre skal vi have en brugerdefineret controller, der kan arbejde med brugerdefinerede datatyper.
Og på en anden måde kaldes den en operator. Jeg har bevidst flyttet den uden for Kubernetes, fordi den kan køre uden for K8s. Ofte, selvfølgelig, kører alle operatører i Kubernetes, men der er intet til hinder for, at den står udenfor, så derfor er den her bevidst flyttet udenfor.
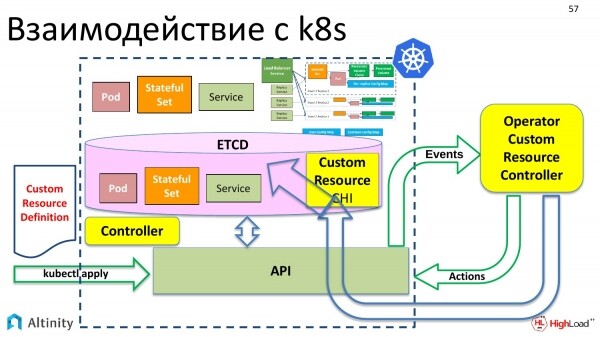
Og i sin tur interagerer den brugerdefinerede controller, det vil sige operatoren, med Kubernetes gennem API'et. Den kan allerede interagere med API'et. Og den ved allerede, hvordan man materialiserer en kompleks struktur fra den brugerdefinerede ressource, som vi ønsker at skabe. Det er netop det, operatoren gør.
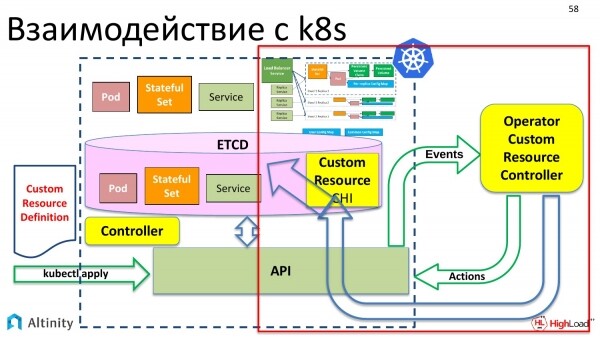
Hvordan fungerer operatoren? Lad os kigge til højre for at finde ud af, hvordan den gør det. Vi vil lære, hvordan operatoren materialiserer alt dette, og hvordan interaktionen med K8s derefter foregår.
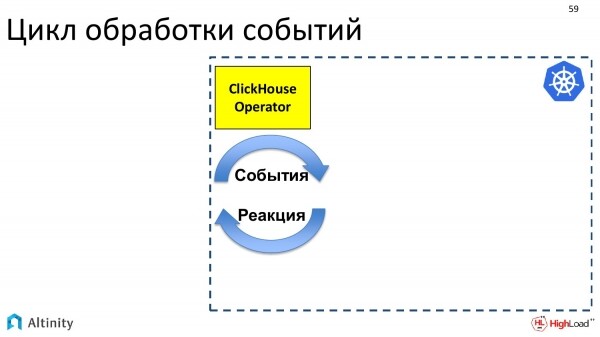
Operatoren er et program. Den er begivenhedsorienteret. Operatoren abonnerer ved hjælp af Kubernetes API på begivenheder. I Kubernetes API'er er der indgange, hvor man kan abonnere på begivenheder. Og hvis noget ændrer sig i K8s, sender Kubernetes begivenheder til alle, der ønsker det, det vil sige, den der har abonneret på denne API-punkt, vil modtage meddelelser.
Operatoren abonnerer på begivenheder og skal reagere. Dens opgave er at reagere på de fremkomne begivenheder.
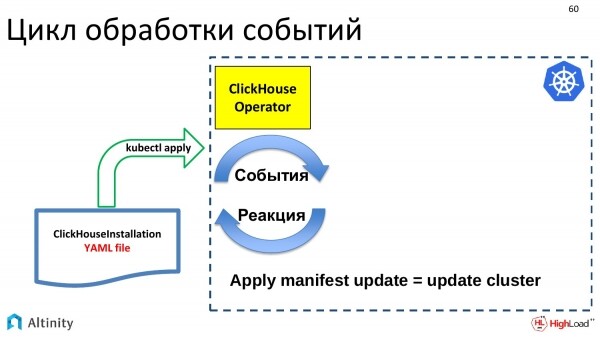
Begivenheder genereres af visse opdateringer. Vores YAML-fil med beskrivelsen af ClickHouseInstallation kommer ind. Den blev sendt til etcd via kubectl apply. Der blev udløst en event, og denne event blev sendt til ClickHouse-operatøren. Operatøren modtog denne beskrivelse, og han skal gøre noget. Hvis der er kommet en opdatering på objektet ClickHouseInstallation, skal klyngen opdateres. Operatørens opgave er at opdatere klyngen.
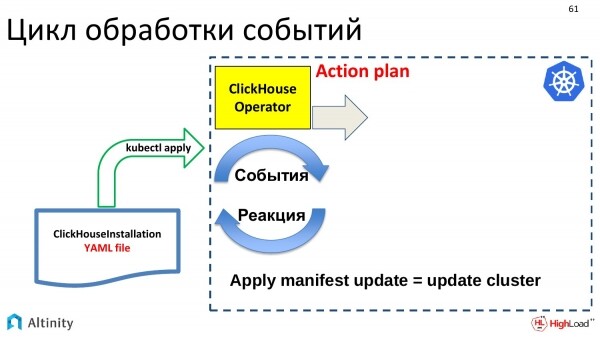
Hvad gør han? For det første skal der udarbejdes en handlingsplan for, hvad vi vil gøre med denne opdatering. Opdateringer kan være meget små, det vil sige små i YAML-udførelsen, men de kan medføre meget store ændringer i klyngen. Derfor skaber operatøren en plan, og så holder han sig til den.
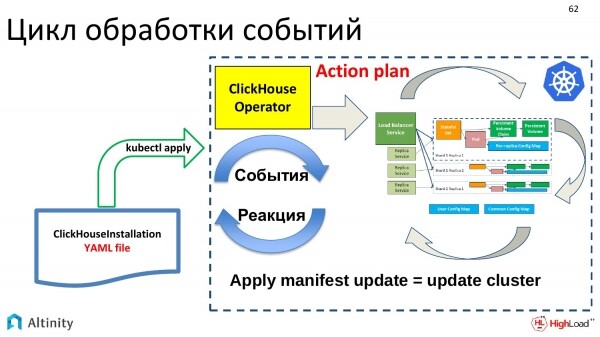
Han begynder i henhold til denne plan at fremstille strukturen internt for at materialisere pods, tjenester osv., det vil sige at gøre det, som er hans hovedopgave. Det er som at bygge en ClickHouse-klynge i Kubernetes.
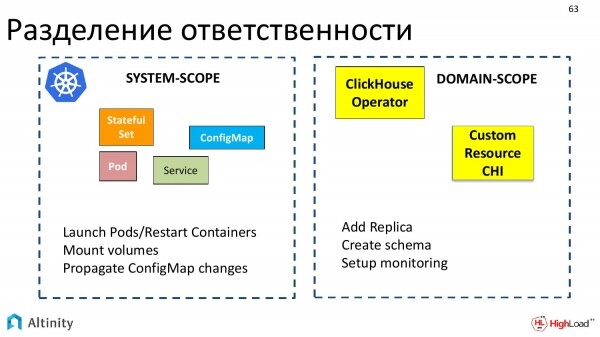
Lad os nu berøre en interessant ting. Det er ansvarsdelingen mellem Kubernetes og operatøren, det vil sige hvad Kubernetes gør, hvad operatøren gør, og hvordan de interagerer med hinanden.
Kubernetes står for systemiske ting, det vil sige et grundlæggende sæt objekter, der kan fortolkes som system-omfang. Kubernetes ved, hvordan man starter pods, hvordan man genstarter containere, hvordan man mount'er volumener, hvordan man arbejder med ConfigMap, det vil sige alt, hvad man kan kalde systemet.
Operatører arbejder inden for specifikke domæner. Hver operatør laves til sit specifikke domæne. Vi har lavet en til ClickHouse.
Og operatøren interagerer netop i termer fra det specifikke domæne, som at tilføje en replika, oprette et skema, konfigurere overvågning. Der opstår et sådant skel.
Lad os se på et praktisk eksempel på, hvordan denne ansvarsdeling finder sted, når vi udfører handlingen "tilføje en replika".
Operatøren får opgaven – at tilføje en replika. Hvad gør operatøren? Operatøren beregner, at der skal oprettes en ny StatefulSet, i hvilken der skal beskrives visse skabeloner og volumenklausuler.
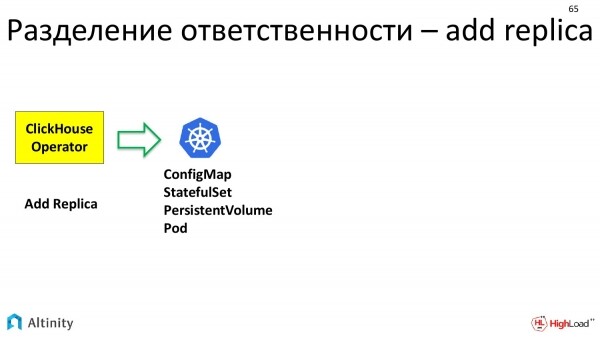
Han har forberedt det hele og sender det videre til K8s. Han siger, at han har brug for ConfigMap, StatefulSet og Volume. Kubernetes arbejder videre. Han materialiserer de grundlæggende enheder, som han opererer med.
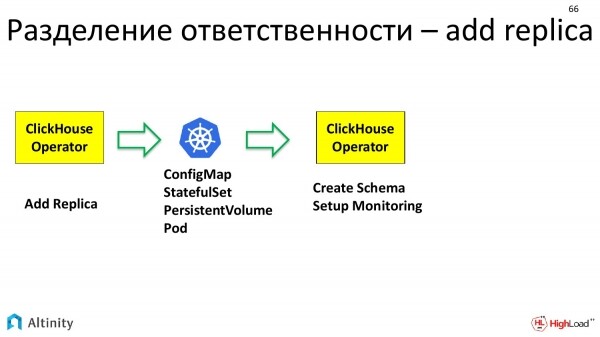
Og så kommer ClickHouse-operatøren ind i billedet igen. Han har allerede en fysisk pod, hvor man kan begynde at arbejde. Og ClickHouse-operatøren opererer igen i termer af domænet. Det vil sige, for specifikt at inkludere en replika i klyngen, skal der for det første konfigureres et dataskema, som findes i denne klynge. Og for det andet skal denne replika inkluderes i overvågningen, så den kan følges ordentligt. Det er allerede operatøren, der sætter dette op.
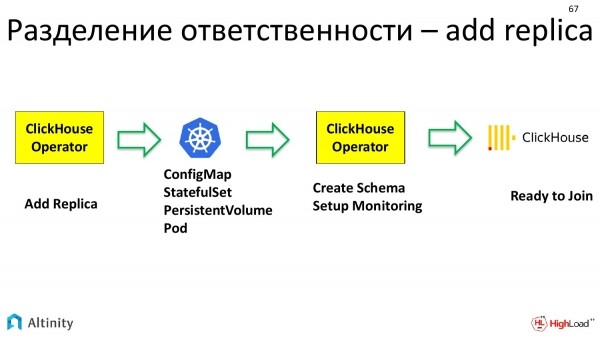
Og først derefter træder selve ClickHouse ind i billedet, det vil sige en endnu mere overordnet enhed. Det er allerede databasen. Den har sin egen instans, en ny konfigureret replika, der er klar til at komme ind i klyngen.
Det viser sig, at kæden af opgaver og ansvarsfordeling ved tilføjelse af en replika er ret lang.
Lad os fortsætte med vores praktiske opgaver. Hvis klyngen allerede eksisterer, er det muligt at foretage en migrationskonfiguration.
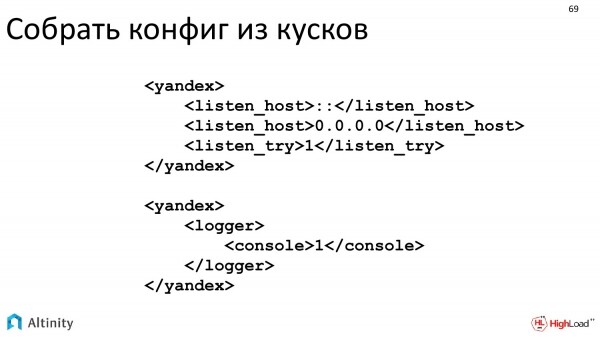
Vi har gjort det muligt at flytte gennem den eksisterende xml, som ClickHouse forstår.
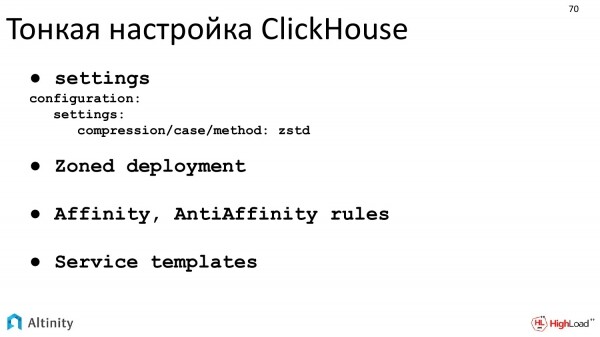
Man kan foretage finjusteringer af ClickHouse. Netop zoned deployment – det er, hvad jeg talte om i forbindelse med forklaringen af hostPath, lokal lagring. Det handler om, hvordan man korrekt laver zoned deployment.
Den næste praktiske opgave er overvågning.
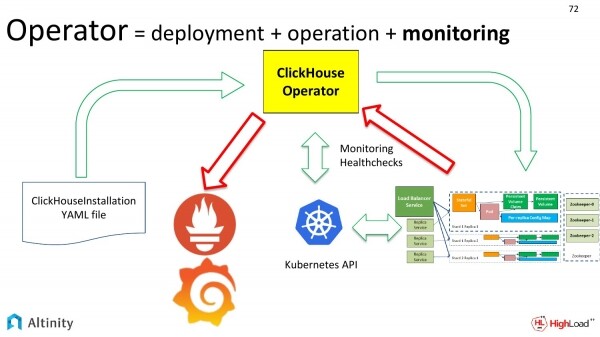
Hvis vi ændrer vores klynge, skal overvågningen jævnligt tilpasses.
Lad os se på skemaet. De grønne pile har vi allerede set på. Nu lad os se på de røde pile. Det er, hvordan vi ønsker at overvåge vores klynge. Hvordan metrikker fra ClickHouse-klyngen går til Prometheus og derefter til Grafana.
Hvad er udfordringen med overvågning? Hvorfor betragtes det som en præstation? Udfordringen er netop i dynamikken. Når vi har én klynge, og den er statisk, kan man indstille overvågningen én gang og så lade den være.
Men hvis vi har mange klynger, eller hvis der konstant sker ændringer, så er processen dynamisk. Og at skulle beskæftige sig med at justere overvågningen konstant er en spild af ressourcer og tid, det vil sige, det kan også være ligegyldigt. Det skal automatiseres. Udfordringen ligger netop i dynamikken i processen. Og operatøren automatiserer det rigtig godt.
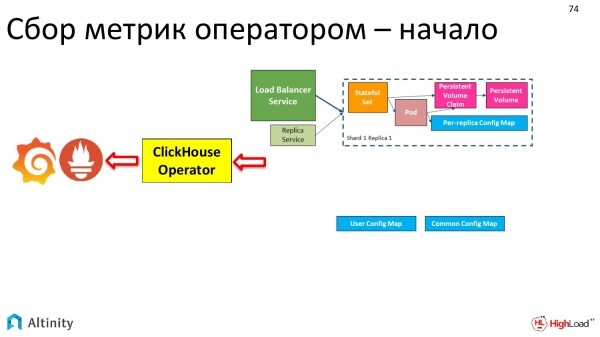
Hvordan udviklede vores klynge sig? I begyndelsen var den sådan her.
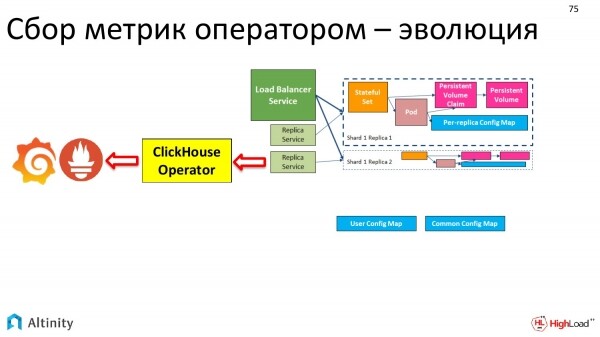
Så blev den sådan her.
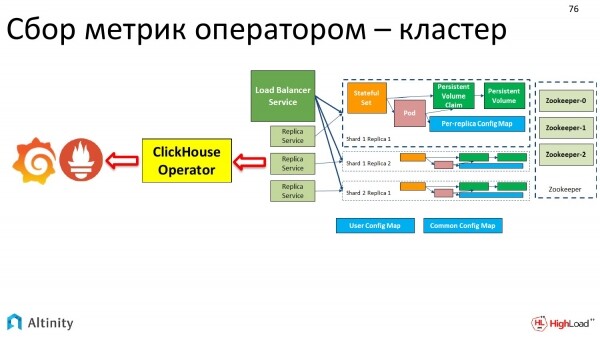
Som resultat blev den sådan her.
Og overvågningen udføres automatisk af operatøren. En enhedlig indgangspunkt.
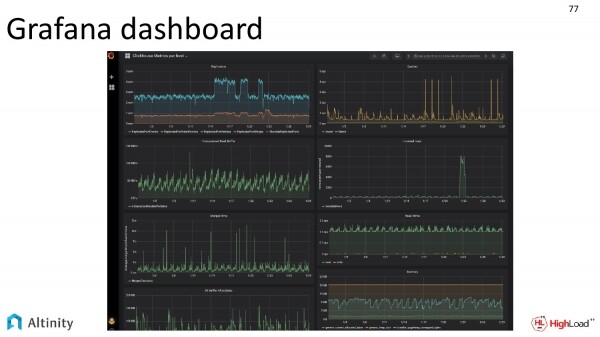
Og vi ser blot på Grafana-dashboardet for at se, hvordan vores klynge fungerer.
For resten distribueres Grafana-dashboardet også med vores operator direkte i kildekoderne. Det kan tilsluttes og bruges. Dette screenshot fik jeg fra vores DevOps.
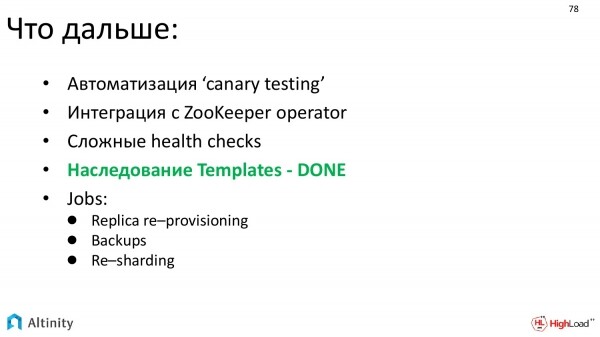
Hvor ønsker vi at bevæge os hen herfra? Det er:
- At udvikle automatisering af test. Hovedopgaven er automatiseret test af nye versioner.
- Vi ønsker også meget at automatisere integrationen med ZooKeeper. Og vi planlægger at integrere med ZooKeeper-operatoren. Altså, der er skrevet en operator til ZooKeeper, og det er logisk, at de to operatorer begynder at integrere sig for at skabe en mere bekvem løsning.
- Vi ønsker at lave mere avancerede sundhedstjek.
- Jeg har markeret det, vi har på vej, arver Templates – DONE, så med den næste release af operatoren vil vi allerede have skabelonarv. Dette er et stærkt værktøj, der gør det muligt at bygge komplekse konfigurationer fra små dele.
- Og vi ønsker automatisering af komplekse opgaver. Den vigtigste af disse er Re-sharding.
Lad os lave en midtvejsevaluering.
Hvad får vi ud af det? Og er det værd at gøre, eller ej? Skal vi overhovedet forsøge at bringe databasen ind i Kubernetes og anvende operatoren generelt, og Alitnity-operatoren specifikt?
Udgangen er:
- Betydelig forenkling og automatisering af konfiguration, udrulning samt vedligeholdelse.
- Indbygget overvågning fra starten.
- Og kodede skabeloner klar til brug til komplekse situationer. Allerede handlinger som at tilføje en replika skal ikke gøres manuelt. Det klarer operatoren.
Der er kun ét sidste spørgsmål. Vi har allerede databasen i Kubernetes, virtualisering. Hvordan står det til med ydeevnen af den løsning, især i lyset af, at ClickHouse er optimeret til ydeevne?
Svaret er – alt er fint! Jeg vil ikke gå i detaljer, det er emnet for et separat foredrag.
Men der er et projekt kaldet TSBS. Hvad er dets hovedopgave? Det er at teste databaser for ydeevne. Det er et forsøg på at sammenligne varme med varme, blødt med blødt.
Hvordan fungerer det? Der genereres et datasæt. Derefter køres dette datasæt på en ensartet række tests på forskellige databaser. Og hver database løser en opgave på sin egen måde. Derefter kan resultaterne sammenlignes.
Det understøtter allerede en stor mængde databaser. Jeg har fremhævet tre hovedtyper. De er:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
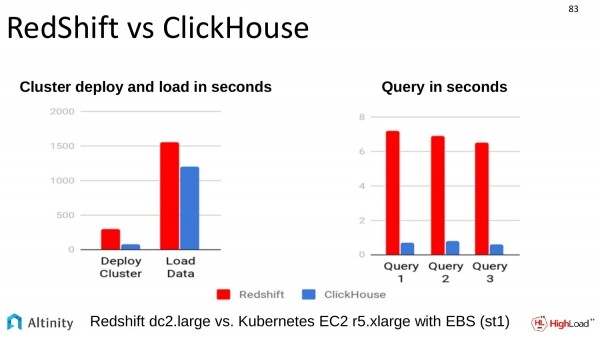
Der er også blevet lavet en sammenligning med en anden lignende løsning. Sammenligningen med RedShift. Sammenligningen blev udført på Amazon. ClickHouse overgår også alle i denne sammenhæng.
Hvad kan vi konkludere ud fra det, jeg har fortalt?
- DB i Kubernetes er muligt. Det er nok muligt med alle, men generelt ser det ud til at være muligt. ClickHouse i Kubernetes kan helt sikkert implementeres af vores operator.
- Operatoren hjælper med at automatisere processerne og gør virkelig livet lettere.
- Ydelsen er acceptabel.
- Og vi mener, at det kan og bør bruges.
Open source – kom og vær med!
Som jeg allerede har sagt, er operatoren et helt open source-produkt, så det ville være rigtig godt, hvis så mange som muligt ville bruge det. Kom og vær med! Vi ser frem til at se jer alle!
Tak for alle!
Spørgsmål
Tak for præsentationen! Mit navn er Anton. Jeg er fra virksomheden SEMrush. Jeg er interesseret i, hvad angår logningen. Vi hører om overvågning, men intet om logning, hvis vi taler om hele klyngen. For eksempel har vi sat en klynge op på hardware. Vi bruger centraliseret logning, hvor vi samler det med standardværktøjer i en samlet mængde. Og så trækker vi de interessante data derfra.
Et godt spørgsmål, dvs. logning er på todo-listen. Vores operator automatiserer stadig ikke det. Den er stadig under udvikling, projektet er stadig relativt ungt. Vi forstår nødvendigheden af logning. Det er også et meget vigtigt emne, som måske er ligeså vigtigt som overvågning. Men overvågning var først på listen til implementering. Logning vil komme. Vi stræber naturligvis efter at automatisere alle aspekter af klyngens livscyklus. Så svaret er – på nuværende tidspunkt kan operatoren desværre ikke dette, men det er på vores planer, og vi vil gøre det. Hvis der er lyst til at deltage, er pull request velkommen.
Hej! Tak for præsentationen! Jeg har et standardspørgsmål relateret til Persistent Volumes. Når vi opretter en konfiguration med denne operator, hvordan bestemmer operatoren, hvilken node vi har monteret en disk eller mappe på? Skal vi på forhånd forklare den, at den skal placere vores ClickHouse på de noder, der har disken?
Så vidt jeg forstår, er dette spørgsmål en fortsættelse af local storage, især den del, der omhandler hostPath. Det er som at forklare hele systemet, hvad der er nødvendigt for, at pod'en skal køre på en bestemt node, hvor vi har en fysisk tilsluttet disk, der er monteret på en bestemt sti. Det er en hel sektion, som jeg har berørt meget overfladisk, fordi svaret er ret omfattende.
Kort sagt ser det sådan ud. Vi skal selvfølgelig foretage provisioning af disse volumes. På nuværende tidspunkt mangler der dynamisk provisionering i local storage, så DevOps skal selv oprette diske, disse volumes. Og de skal informere Kubernetes provisioneringen om, at der vil være Persistent volumes af en bestemt klasse, som findes på bestemte noder. Derefter skal det forklares for Kubernetes, at pod'e, som kræver en bestemt klasse local storage, kun skal planlægges på de noder, der har de nødvendige labels. Til dette formål er der i operatoren mulighed for at tildele en bestemt label og én pr. host-forekomst. Og resultatet bliver, at pod'ene vil blive rutet af Kubernetes til at køre kun på noder, som opfylder kravene til labels, sagt på en enkel måde. Administratorer tildeler labels og foretager provisioning af diske manuelt. Og så kan det skaleres.
Og netop den tredje mulighed for local storage hjælper med at lette dette lidt. Som jeg allerede har påpeget, er det et omhyggeligt stykke arbejde at konfigurere, som hjælper med at opnå maksimal ydelse i sidste ende.
Jeg har et spørgsmål mere, der hænger sammen med dette. Kubernetes er designet således, at det ikke er vigtigt for os, om vi mister en node eller ej. Hvad skal vi gøre, hvis vi har mistet den node, hvor vores shard er placeret?
Ja, Kubernetes er oprindeligt positioneret sådan, at vores forhold til vores pod'e er som kvæg, men her bliver hver disk noget, der minder mere om et kæledyr. Der er et problem, at vi ikke bare kan kaste dem væk. Udviklingen af Kubernetes går i den retning, at man ikke helt kan forholde sig til dette filosofisk som til fuldstændig udskiftelige ressourcer.
Nu til et praktisk spørgsmål. Hvad skal man gøre, hvis en node, hvor disken var, er blevet tabt? Det problem løses allerede på et højere niveau. I tilfælde af ClickHouse har vi replikaer, der arbejder på et niveau over, dvs. på ClickHouse-niveau.
Hvad er fordelingen? DevOps er ansvarlig for, at ingen data går tabt. Han skal korrekt konfigurere replikationen og overvåge, at replikationen udføres. Dataene skal være duplikeret i replikatet på ClickHouse-niveau. Det er ikke en opgave, som operatøren løser. Og det er ikke en opgave, som Kubernetes selv løser. Det er på ClickHouse-niveau.
Hvad skal man gøre, hvis jernnoden svigter? Og så skal man sætte en anden op, korrekt provisionere en disk, påføre labels. Og derefter vil den opfylde kravene, så Kubernetes kan starte en instans af pod'en på den. Kubernetes vil starte den. I har jo ikke nok pods til det angivne antal. Den vil gennemgå den cyklus, som jeg viste. Og på det øverste niveau vil ClickHouse forstå, at der er kommet en replik, den er stadig tom, og data skal begynde at flydes over til den. Altså, denne proces er stadig dårligt automatiseret.
Tak for oplægget! Når der sker forskellige problemer, og operatøren falder og genstarter, mens begivenhederne fortsætter med at komme, hvordan håndterer I det?
Hvad sker der, hvis operatøren falder og genstarter, ikke?
Ja. Og på det tidspunkt kom der begivenheder.
Opgaven om, hvad der skal gøres i dette tilfælde, er delvist opdelt mellem operatøren og Kubernetes. Kubernetes har mulighed for at afspille de indtrufne begivenheder igen. Han afspiller dem. Og operatørens opgave er at sikre, at når loggen med begivenhederne bliver afspillet til ham, så er disse begivenheder idempotente. Og at en gentagelse af den samme begivenhed ikke ødelægger vores system. Og vores operatør klarer denne opgave.
Hej! Tak for oplægget! Dmitry Zavyalov, selskab Smedova. Er der planer om at tilføje mulighed for konfiguration med haproxy i operatøren? Jeg er interesseret i en anden balancerer udover den standard, så den er smart og forstår, at der faktisk er ClickHouse der.
Taler du om Ingress?
Ja, erstat Ingress med haproxy. I haproxy kan man angive topologien for klyngen, hvor dens replikater befinder sig.
Vi har ikke tænkt over det endnu. Hvis du har brug for det og kan forklare, hvorfor det er nødvendigt, kan vi overveje at implementere det, især hvis du ønsker at deltage. Vi vil med glæde se på muligheden. Kort sagt – nej, vi har ikke denne funktionalitet i øjeblikket. Tak for tippet, vi vil kigge på det. Hvis du også kan forklare use case og hvorfor det er nødvendigt i praksis, for eksempel ved at oprette issues på GitHub, ville det være fremragende.
Der er allerede noget.
Godt. Vi er åbne for enhver forslag. Og haproxy er på todo-listen. Todo-listen vokser, men falder ikke endnu. Men det er godt, det betyder, at produktet er efterspurgt.
Kilde: habr.com
