

Hej, Habr! Mit navn er Maksim Vasiljev, jeg arbejder som analytiker og projektleder hos FINCH. I dag vil jeg gerne fortælle, hvordan vi ved hjælp af ElasticSearch kunne behandle 15 millioner forespørgsler på 6 minutter og optimere de daglige belastninger på en af vores kunders websteder. Desværre må vi undvære navne, da vi har NDA, men vi håber, at indholdet af artiklen ikke lider under dette. Lad os komme i gang.
Hvordan projektet er sat op
På vores backend opretter vi tjenester, der sikrer, at vores kundes websteder og mobilapplikation fungerer. Den overordnede struktur kan ses i diagrammet:
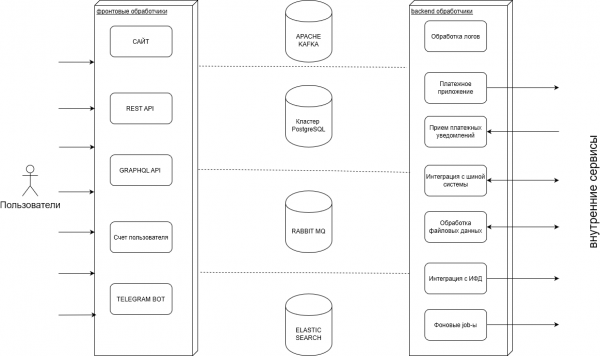
I løbet af arbejdet behandler vi et stort antal transaktioner: køb, udbetalinger, operationer med brugernes konti, for hvilke vi opbevarer mange logs, og vi importerer og eksporterer også disse data til eksterne systemer.
Der er også omvendte processer, hvor vi modtager data fra kunden og sender dem til brugerne. Derudover findes der også processer til håndtering af betalinger og bonusprogrammer.
Kort baggrunds historie
Oprindeligt brugte vi PostgreSQL som det eneste datalager. Dets standardfortrin som DBMS: tilstedeværelsen af transaktioner, et avanceret datavælgingssprog, et bredt værktøjssæt til integration; i kombination med god ydeevne tilfredsstillede det vores behov i lang tid.
Vi opbevarede alle data i Postgres: fra transaktioner til nyheder. Men antallet af brugere voksede, og det samme gjorde antallet af forespørgsler.
Til sammenligning var det årlige antal sessioner i 2017 kun på desktopwebstedet - 131 millioner. I 2018 - 125 millioner. 2019 igen 130 millioner. Tilføj yderligere 100-200 millioner fra mobilversionen af webstedet og mobilapplikationen, og du får et kolossalt antal forespørgsler.
Med væksten af projektet kunne Postgres ikke håndtere belastningen, vi kunne ikke følge med - der kom et stort antal forskellige forespørgsler, for hvilke vi ikke kunne oprette tilstrækkeligt med indekser.
Vi indså, at der var behov for andre datalagre, der kunne imødekomme vores behov og aflaste PostgreSQL. Vi overvejede som muligheder Elasticsearch og MongoDB. Den sidstnævnte tabte på følgende punkter:
- Langsom indekseringshastighed med stigende mængde data i indeksene. Hos Elastic afhænger hastigheden ikke af datamængden.
- Ingen fuldtekst søgning
Så vi valgte Elastic til os selv og forberedte os på overgangen.
Overgang til Elastic
1. Vi begyndte overgangen med søgetjenesten for salgssteder. Vores kunde har i alt omkring 70.000 salgssteder, og der kræves flere typer søgning på hjemmesiden og i appen:
- Tekstsøgning efter navn på by
- Geosøgning inden for en bestemt radius fra et punkt. For eksempel, hvis brugeren ønsker at se, hvilke salgssteder der ligger tættest på hans hjem.
- Søgning inden for et specificeret kvadrat – brugeren tegner et kvadrat på kortet, og han får vist alle punkter inden for denne radius.
- Søgning efter yderligere filtre. Salgsstederne adskiller sig fra hinanden efter sortiment.
Når det kommer til organisationen, så har vi i Postgres kilden til data både til kort og nyheder, mens der i Elastic laves snapshots fra de originale data. Det er fordi, at Postgres oprindeligt ikke kunne håndtere søgning på alle kriterier. Der var ikke blot mange indekser, de kunne også krydse hinanden, så planlæggeren i Postgres blev forvirret og vidste ikke, hvilken indeks han skulle bruge.
2. Næste afdeling var nyhedssektionen. Hjemmesiden får hver dag nye publikationer, så brugeren ikke går tabt i informationsstrømmen, skal dataene sorteres før udlevering. Derfor er der brug for søgning: på hjemmesiden kan man søge ved tekstmæssig overensstemmelse, og samtidig kunne tilføje yderligere filtre, da de også er bygget via Elastic.
3. Derefter flyttede vi behandlingen af transaktioner. Brugerne kan købe bestemte varer på hjemmesiden og deltage i lodtrækninger om præmier. Efter sådanne køb behandler vi en stor mængde data, især i weekender og på helligdage. Til sammenligning, hvis antallet af køb på almindelige dage ligger på omkring 1,5-2 millioner, kan tallet på helligdage nå op til 53 millioner.
Samtidig skal dataene behandles på minimal tid — brugerne kan ikke lide at vente flere dage på resultaterne. Gennem Postgres kan man ikke opnå sådanne tider — vi fik ofte låsninger, og mens vi behandlede alle anmodninger, kunne brugerne ikke kontrollere, om de havde vundet præmier eller ej. Det er ikke særlig behageligt for forretningen, så vi flyttede behandlingen til Elasticsearch.
Frekvens
Opdateringer er i øjeblikket sat op til at ske baseret på følgende betingelser:
- Salgssteder. Så snart vi modtager data fra en ekstern kilde, starter vi straks opdateringen.
- Nyheder. Når der redigeres en nyhed på siden, sendes den automatisk til Elastic.
Her er det værd at nævne fordelene ved Elastic. I Postgres skal man vente på, at systemet behandler alle poster, når en forespørgsel sendes. I Elastic kan man sende 10.000 poster og straks begynde at arbejde uden at vente på, at posterne distribueres til alle Shards. Naturligvis kan en eller anden Shard eller Replica muligvis ikke se dataene med det samme, men snart vil alt være tilgængeligt.
Integrationsmetoder
Der er 2 måder at integrere med Elastic:
- Gennem den native klient via TCP. Den native driver er gradvist ved at uddø: den får ikke længere støtte, og dens syntaks er meget uhåndterlig. Derfor bruger vi den næsten ikke og stræber efter helt at undgå den.
- Gennem HTTP-grænsefladen, hvor man kan bruge både JSON-forespørgsler og Lucene-syntaks. Sidstnævnte er en tekstmotor, der bruger Elastic. På denne måde får vi Batch-mulighed gennem JSON-forespørgsler via HTTP. Det er denne metode, vi stræber efter at bruge.
Takket være HTTP-grænsefladen kan vi bruge biblioteker, der tilbyder asynkron udførelse af HTTP-klienten. Vi kan udnytte Batch og den asynkrone API, hvilket i sidste ende giver høj ydeevne, som har hjulpet meget under store kampagner (mere om dette nedenfor)
Nogle tal til sammenligning:
- Gemmes brugere, der modtog præmier i Postgres, i 20 tråde uden gruppere: 460713 poster på 42 sekunder
- Elastic + reaktiv klient på 10 tråde + batch med 1000 elementer: 596749 poster på 11 sekunder
- Elastic + reaktiv klient på 10 tråde + batch med 1000 elementer: 23801684 poster på 4 minutter
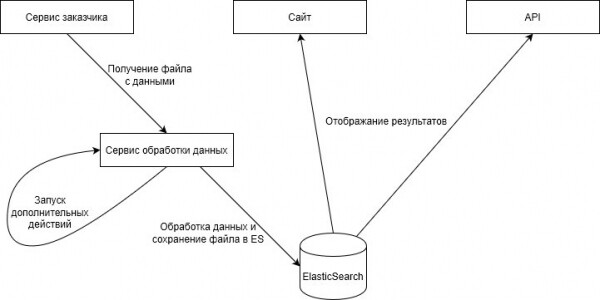
Vi har nu skrevet en HTTP-forespørgselsmanager, der opbygger JSON, hvad enten det er Batch/ikke Batch, og sender det gennem enhver HTTP-klient uanset bibliotek. Det er også muligt at vælge synkront eller asynkront at sende forespørgsler.
I nogle integrationer bruger vi stadig den officielle transportklient, men det er kun et spørgsmål om den nærmeste refaktorering. Desuden bruges en egen klient bygget på Spring WebClient til behandlingen.
Stor kampagne
En gang om året afholdes der en stor kampagne for brugerne - det er den såkaldte Highload, da vi i denne periode arbejder med titusindvis af brugere samtidigt.
Normalt forekommer belastningstop i helligdage, men denne kampagne er på en helt anden niveau. I forrige år solgte vi 27.580.890 enheder på kampagnedagen. Dataene blev behandlet i mere end en halv time, hvilket forårsagede ubehag for brugerne. Brugerne modtog præmier for deres deltagelse, men det blev klart, at processen skulle fremskyndes.
I begyndelsen af 2019 besluttede vi, at vi havde brug for ElasticSearch. Et helt år arbejdede vi med at organisere behandlingen af de indkomne data i Elastic og deres levering til API'en i mobilapplikationen og på hjemmesiden. Resultatet var, at vi året efter under kampagnen behandlede 15.131.783 poster på 6 minutter.
Da vi har mange, der ønsker at købe produkter og deltage i præmietrekningerne i kampagnerne, er dette en midlertidig foranstaltning. Lige nu sender vi aktuel information til Elastic, men i fremtiden planlægger vi at flytte arkivinformation fra de tidligere måneder til Postgres som permanent opbevaring. For ikke at tilstoppe Elastic-indekset, som også har sine begrænsninger.
Konklusioner
I øjeblikket har vi overført alle de tjenester, vi ønskede, til Elastic, og vi har taget en pause her. Lige nu bygger vi et indeks i Elastic oven på det primære vedholdende lagringssystem i Postgres, som håndterer belastningen fra brugerne.
I fremtiden planlægger vi at overføre tjenester, hvis vi forstår, at forespørgslen på data bliver for mangfoldig og søges på et ubegribelig antal kolonner. Dette er allerede ikke en opgave for Postgres.
Hvis vi får brug for fuldtekstsøgning i funktionaliteten, eller hvis vi får mange forskellige søgekriterier, så ved vi allerede, at det skal overføres til Elastic.
⌘⌘⌘
Tak fordi du læste med! Hvis din virksomhed også bruger ElasticSearch og har egne implementeringscases, så fortæl os om dem. Det ville være interessant at høre, hvordan andre gør det 🙂
Kilde: habr.com
