

Hvordan kan man vokse med 10 gange antallet af forespørgsler til databasen uden at flytte til en mere kraftfuld server og samtidig opretholde systemets funktionalitet? Jeg vil fortælle, hvordan vi kæmpede med faldet i ydeevnen for vores database, hvordan vi optimerede SQL-forespørgsler for at betjene så mange brugere som muligt uden at øge omkostningerne til beregningsressourcer.
Jeg laver en service til at styre forretningsprocesser i byggevirksomheder. Vi arbejder med omkring 3.000 virksomheder. Mere end 10.000 mennesker arbejder hver dag med vores system i 4-10 timer. Det løser forskellige planlægnings-, varslings-, advarsels- og valideringsopgaver... Vi bruger PostgreSQL 9.6. I databasen har vi omkring 300 tabeller, og hver dag modtager vi op til 200 millioner forespørgsler (10.000 forskellige). I gennemsnit har vi 3-4.000 forespørgsler pr. sekund, og på de mest aktive tidspunkter over 10.000 forespørgsler pr. sekund. Størstedelen af forespørgslerne er OLAP. Tilføjelser, modificeringer og sletninger er meget færre, dvs. OLTP-belastningen er relativt lille. Alle disse tal nævnte jeg for at give dig et indtryk af omfanget af vores projekt og forstå, hvor nyttig vores erfaring kan være for dig.
Billede ét. Lyrisk
Da vi begyndte udviklingen, tænkte vi ikke meget over, hvor meget belastning der ville være på databasen, og hvad vi ville gøre, hvis serveren ikke længere kunne klare det. Ved design af databasen fulgte vi generelle anbefalinger og prøvede ikke at træde os selv over tæerne, men længere end de generelle råd som ‘brug ikke mønsteret kom vi ikke. Vi designede baseret på normaliseringsprincipper og undgik dataduplicering, og vi bekymrede os ikke om at fremskynde bestemte forespørgsler. Så snart de første brugere kom, stødte vi på et ytelsesproblem. Som vanligt var vi helt uforberedte på dette. De første problemer var enkle. Som regel blev det løst ved at tilføje et nyt indeks. Men der kom et tidspunkt, hvor de enkle løsninger ikke længere virkede. Indså, at vi ikke havde nok erfaring, og at det blev sværere at forstå, hvad årsagen til problemerne var, ansatte vi specialister, der hjalp os med at konfigurere serveren korrekt, tilslutte overvågningen, og viste os, hvor vi skulle kigge for at få .
Billede to. Statistisk
Så vi har omkring 10.000 forskellige forespørgsler, der kører på vores database hver dag. Blandt disse 10.000 er der monstre, der udføres 2-3 millioner gange med en gennemsnitlig udførelsestid på 0,1-0,3 ms, og der er forespørgsler med en gennemsnitlig udførelsestid på 30 sekunder, der kaldes 100 gange om dagen.
Det var ikke muligt at optimere alle 10.000 forespørgsler, så vi besluttede at finde ud af, hvor vi skulle rette vores indsats for at øge databaseydelsen korrekt. Efter flere iterationer begyndte vi at opdele forespørgslerne i typer.
TOP forespørgsler
Dette er de mest ressourcekrævende forespørgsler, der bruger mest tid (total tid). Det er forespørgsler, der enten kaldes meget ofte, eller forespørgsler, der tager meget lang tid at udføre (lange og hyppige forespørgsler blev optimeret allerede i de første iterationer i kampen for hastigheden). I sidste ende bruger serveren mest tid på deres udførelse. Det er vigtigt at adskille topforespørgsler efter samlet udførelsestid og separat efter IO-tid. Metoderne til optimering af sådanne forespørgsler er lidt forskellige.
Det er almindelig praksis blandt alle virksomheder at arbejde med TOP forespørgsler. Der er ikke mange af dem, og optimering af selv én forespørgsel kan spare 5-10% af ressourcerne. Men efterhånden som projektet "modnes", bliver optimeringen af TOP forespørgsler en mere og mere ikke-trivial opgave. Alle de enkle metoder er allerede blevet anvendt, og den "tungere" forespørgsel bruger "kun" 3-5% af ressourcerne. Hvis TOP forespørgsler samlet set tager mindre end 30-40% af tiden, har du sandsynligvis allerede gjort en indsats for at få dem til at køre hurtigt, og det er tid til at gå videre til optimering af forespørgslerne i den næste gruppe.
Det er tilbage at besvare spørgsmålet om, hvor mange topforespørgsler der skal inkluderes i denne gruppe. Jeg tager normalt ikke mindre end 10, men ikke mere end 20. Jeg prøver at sikre, at tiden for den første og den sidste i TOP-gruppen ikke adskiller sig mere end 10 gange. Så hvis udførelsestiden for forespørgslerne falder pludseligt fra 1. plads til 10. plads, tager jeg TOP-10; hvis faldet er mere gradvist, øger jeg gruppens størrelse til 15 eller 20.
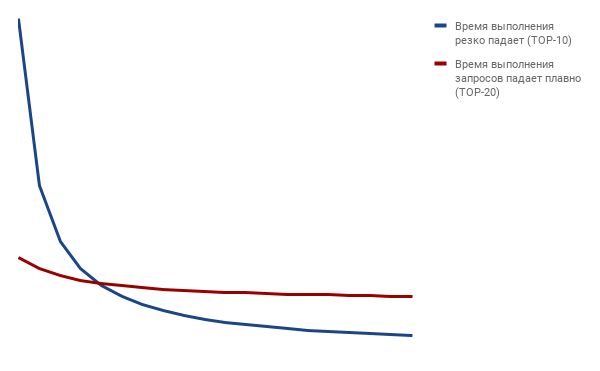
Mellemforskelle (medium)
Dette er alle forespørgsler, der følger lige efter TOP, med undtagelse af de sidste 5-10%. Normalt er det i optimeringen af disse forespørgsler, at muligheden for alvorligt at øge serverens ydeevne ligger. Disse forespørgsler kan "veje op til 80%." Men selv hvis deres andel overstiger 50%, er det tid til at se nærmere på dem.
Haleforføgelser (tail)
Som nævnt går disse forespørgsler til slutningen, og de tager 5-10% af tiden. Man kan glemme dem, medmindre man bruger automatiske analysesoftware til forespørgsler, så kan optimeringen også være billig.
Hvordan vurderer man hver gruppe?
Jeg bruger en SQL-forespørgsel, som hjælper med at lave sådan en vurdering for PostgreSQL (jeg er sikker på, at man kan skrive en lignende forespørgsel for mange andre databaser).
SQL-forespørgsel til vurdering af størrelsen på TOP-MEDIUM-TAIL grupper
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail)
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800 THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
Resultatet af forespørgslen - tre kolonner, hver indeholdende procentdelen af tiden, der bruges på at behandle forespørgsler fra denne gruppe. Inden i forespørgslen er der to tal (i mit tilfælde 20 og 800), som adskiller forespørgslerne fra den ene gruppe til den anden.
Her er forholdet mellem andelene af forespørgsler ved begyndelsen af optimeringsarbejdet og nu.
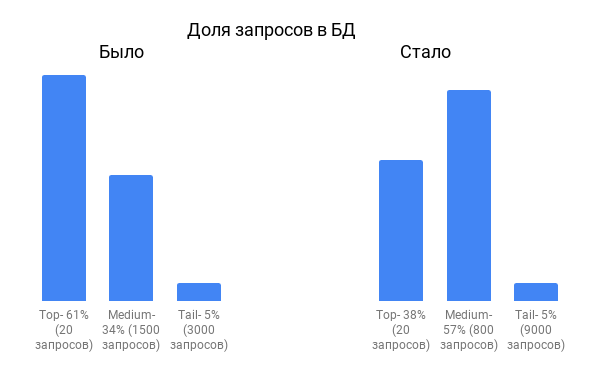
Diagrammet viser, at andelen af TOP-forespørgsler er faldet kraftigt, mens 'mellemstore' forespørgsler er steget.
I starten var der åbenlyse fejl i TOP-forespørgslerne. Over tid forsvandt de barne sygdomme, andelen af TOP-forespørgsler faldt, og der skulle lægges mere og mere arbejde i at accelerere de tunge forespørgsler.
For at få teksten af forespørgslerne bruger vi en sådan forespørgsel
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Her er listen over de mest brugte metoder, der har hjulpet os med at accelerere TOP-forespørgslerne:
- Redesign af systemet, for eksempel redesign af logikken for meddelelser til message broker i stedet for periodiske forespørgsler til databasen.
- Tilføjelse eller ændring af indekser.
- Omskrivning af ORM-forespørgsler til ren SQL.
- Omskrivning af logikken for lazy indlæsning af data.
- Caching gennem denormalisering af data. For eksempel har vi en forbindelse mellem tabellerne Levering -> Faktura -> Forespørgsel -> Ansøgning. Det vil sige, at hver levering er knyttet til en ansøgning gennem andre tabeller. For ikke at skulle forbinde alle tabellerne i hver forespørgsel har vi duplikeret referencen til ansøgningen i tabellen Levering.
- Caching of static tables with reference data and rarely changing tables in program memory.
Sometimes changes led to significant redesigns, but they provided a 5-10% load reduction and were justified. Over time, the output decreased, and more serious redesigns were needed.
Then we turned our attention to the second group of queries - the mid-range group. It contained many more queries, and it seemed that analyzing the entire group would take a lot of time. However, most queries turned out to be very easy to optimize, and many problems repeated themselves in dozens of different variations. Here are examples of some typical optimizations that we applied to dozens of similar queries, with each group of optimized queries reducing the database load by 3-5%.
- Instead of checking the existence of records using COUNT and performing a full table scan, we started using EXISTS.
- We eliminated DISTINCT (there's no universal recipe, but sometimes it can be easily removed, speeding up the query by 10-100 times).
For example, instead of a query to select all drivers from a large delivery table (DELIVERY)
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
we made a query on a comparatively small PERSON table.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
It seemed that we were using a correlating subquery, but it provided a speedup of more than 10 times.
- In many cases, we completely abandoned COUNT and
- i stedet for
UPPER(s) LIKE JOHN%bruger vi
s ILIKE “John%”
Each specific query was sometimes sped up by 3-1000 times. Despite the impressive numbers, at first, we thought there was no point in optimizing a query that executes in 10 ms, ranks in the top 300 most resource-intensive queries, and occupies mere fractions of a percent of the overall database load time. However, by applying the same recipe to a group of identical queries, we regained several percent. To avoid spending time manually reviewing all hundreds of queries, we wrote several simple scripts that used regular expressions to find similar queries. As a result, the automated search for groups of queries allowed us to further improve our performance with modest effort.
I fire at the same hardware for three years now. The average daily load is around 30%, peaking at 70%. The number of requests and users has increased approximately tenfold. All this is thanks to constant monitoring of the TOP-MEDIUM request groups. As soon as a new request appears in the TOP group, we analyze it immediately and try to speed it up. We review the MEDIUM group weekly using request analysis scripts. If new requests show up that we already know how to optimize, we change them quickly. Sometimes we find new optimization methods that can be applied immediately to several requests.
According to our forecasts, the current server can handle an increase in users by another 3-5 times. However, we still have one ace up our sleeve—we have not yet translated SELECT queries to a mirror, as is recommended. But we consciously avoid this, as we want to fully exhaust the possibilities of 'smart' optimization before deploying 'heavy artillery.'
A critical view of the completed work can suggest the use of vertical scaling. Buying a more powerful server, instead of wasting specialists' time. A server may not cost that much, especially since we haven't exhausted the limits of vertical scaling yet. However, the number of requests has only increased tenfold. Over the years, the system's functionality has expanded, leading to a greater variety of requests. The existing functionality now performs with fewer requests, thanks to caching, and those are more efficient requests. This means we can safely multiply by another 5 to get the real acceleration factor. Thus, according to the most modest calculations, we can say that the acceleration has reached 50 times or more. Vertically scaling the server by 50 times would cost more. Especially considering that once optimized, the process works all the time, while the bill for the rented server comes every month.
Kilde: habr.com
